4: Propotional Share Scheduler
Propotional Share Scheduler
지금까지 배운 scheduler는 turnaround time과 response time을 최소화하기 위한 scheduler였다. 하지만 Proportional Share Scheduler는 전혀 다른 성격을 지닌다.
Proportional Share Scheduler는 오직 모든 process가 공평한 기회를 가질 수 있도록 하는 것에 집중한다.
Lottery Scheduling
Lottery scheduling은 Proportional share의 성격을 잘 보여준다. 가장 기본적인 아이디어는 필요한 시간이 긴 process는 더 많은 로또 티켓을 주어 로또에 당첨되는 확률을 높여주는 것이다.
즉, ticket 수는 자원을 얼마동안 써야하는지에 따라 달라지는 것이다. 만약 100개의 ticket이 있는데 A는 75개, B는 25개 있다면 A가 75%의 시간동안 자원을 받고 B가 나머지 25%의 시간동안 자원을 받게 하는 것이다.
Lottery scheduling이 수행되기 위해서는 Scheduler는 전체 ticket 수를 알고 있어야 하며 매 interrupt마다 당첨 ticket을 뽑아 당첨 번호가 적힌 ticket을 가지고 있는 process가 다음에 실행될 process가 되는 것이다.
Lottery scheduling은 ticket currrency라는 개념도 사용한다. User A와 B 모두 100개의 ticket을 갖고있는데 User A는 2개의 job을 실행시켜야 하기에 자기의 ticket을 1000개로 만들어서 각 job에게 500개씩 주었다고 하자. 이렇게 ticket 수를 늘리더라도 결국 User A는 ticket의 가치를 $\frac {1} {10}$으로 줄인 것이기 때문에 최종 scheduling을 할 때는 A의 각 job은 50의 ticket을 가진 것과 동일하다.
$\rightarrow$ Ticket currency의 유용성은 각 job가 갖게 될 비율을 더 세분화할 수 있다는 점이다.
Ticket Transfer: Process끼리 합의 하에 ticket을 주고 받는 행위를 의미한다. 이는 client server paradigm을 생각하면 편하다. Client가 server에 요청을 했을 때, client는 server가 빨리 CPU을 받아서 자기의 요청을 처리해줬으면 좋으므로 자기의 ticket을 빌려줄 수 있게 되는 것이다.
Ticket inflation: 특정 process가 현재 많이 중요하다는 가정 하에 그 process가 가진 가치를 증폭시켜서 CPU의 할당을 받을 가능성을 높일 수 있다.
Lottery scheduling을 구현할 때 가장 중요한 것은 ticket이 가장 많은 사람의부터 가장 적은 사람 순서대로 정렬을 한 뒤, winner ticket을 갖고있는지 확인하는 것이다
Lottery Scheduling Fairness
Lottery Scheduling의 fairness, 즉 얼마나 proportional share한 scheduler인지 알아내기 위해서 실험을 해보았다.
두 jobs에게 동일한 수의 ticket을 주고 run time이 동일하도록 하였다.
얼마나 fair한지 알아내기 위해서 unfairness metric U를 사용하였다. U는 첫 번째로 끝난 job의 시간 / 두 번째로 끝난 job의 시간이며 이 값이 1일 때 가장 fair한 scheduler인 것이다.
job의 run time을 늘리면서 U의 변화를 관찰하였다.
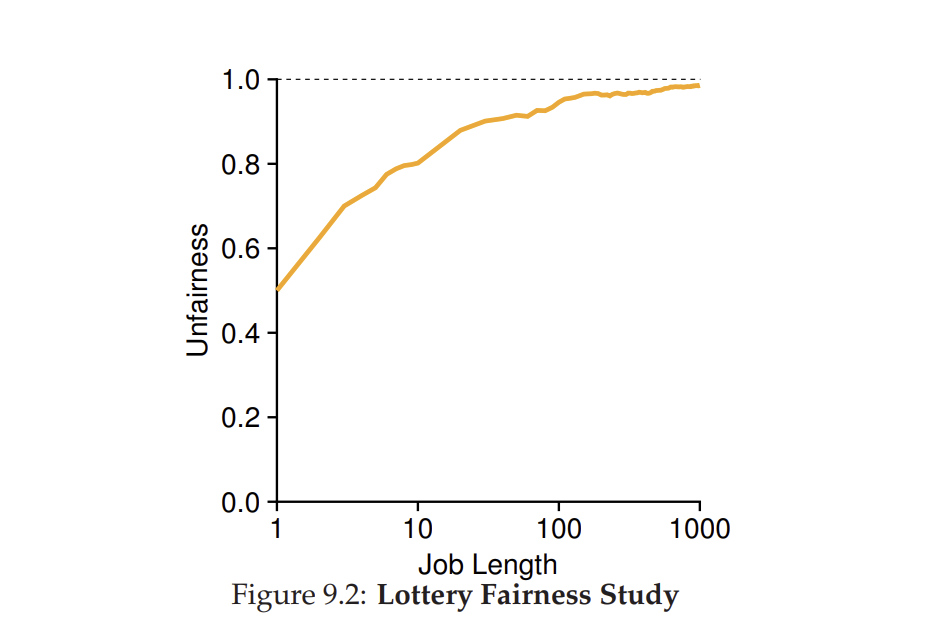
Run time이 짧을 때는 U 값이 1보다 많이 작다는 것을 통해 lottery scheduler는 긴 시간이 지나야지만 fair한 scheduler임을 알 수 있다. 이것은 lottery scheduler의 randomness 때문에 결과가 not deterministic하게 나오는 것이다. 즉, lottery scheduler의 randomness는 장점이자 단점이 되는 것이다.
Stride Scheduling
Stride Scheduling은 lottery scheduling과 반대로 randomness을 없앤 deterministic fair share scheduler이다.
각 job은 stride라는 값을 가지고 이 값은 가지고 있는 ticket 수와 반비례한다. 즉, stride 값이 낮을수록 우선순위가 높아지는 것이다.
Stride scheduling에서는 stride 값이 낮을수록 먼저 실행될 가능성이 높아지면서 각 process가 실행되는 횟수는 stride 값으로 확정적으로 정해진다. 그래서 deterministic한 scheduler라고 보는 것이다.
예를 들어 job A,B,C가 ticket 100, 50, 250을 가지고 있다면 각 ticket 수를 10000에 나눴다고 했을 때, job A,B,C의 stride 값은 각각 100, 200, 40이 되는 것이다.
각 process의 진행 상황을 pass 값으로 추적하고 이 pass 값은 항상 0으로 시작한다. 각 process가 time slice만큼 실행될 때마다 stride의 값만큼 pass 값이 증가하고 다음 실행할 process을 정할 때, pass 값이 가장 낮은 process가 선택된다.
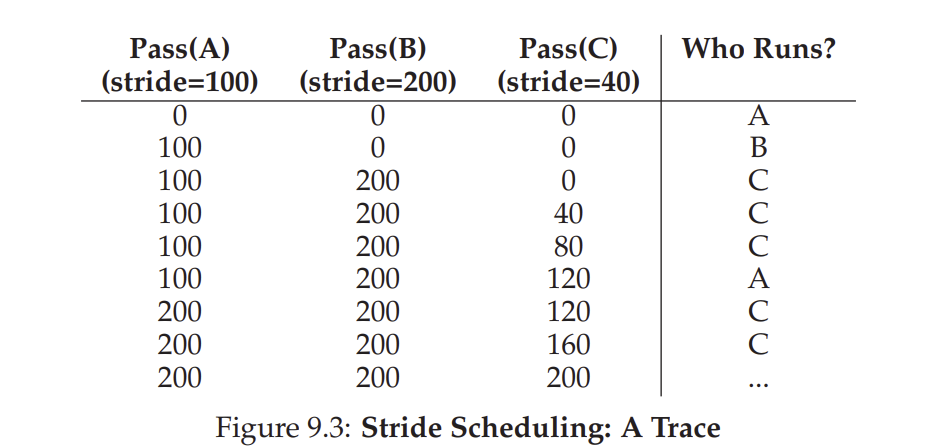
처음에는 모든 process의 pass 값이 0이기에 무작위로 선택되는데 A가 선택되었다고 하자. 그럼 A의 pass값은 자기의 stride 값인 100만큼 증가한다.
그 다음에 B가 선택되었다고 하자. 그럼 B의 pass 값은 200만큼 증가한다.
이 상태에서 pass 값이 가장 낮은 process는 C이기에 C가 선택되고 stride 값인 40만큼 pass가 증가한다.
이 원리를 통해 계속 진행하면, 결국 C는 5번, A는 두 번, B는 한 번만 실행되는데 이 횟수의 비율은 정확하게 가지고 있던 ticket 수의 비율(5:2:1 == 250:100:50)과 같다.
그렇다면 stride scheduling은 deterministic 하기에 무조건 좋은 것이라고 할 수 있는 것 아닌가?
그렇지 않다. Stride scheduling에서 새로운 process가 들어온다고 해보자. 그래서 pass의 값을 0으로 했다고 하자. 그런데 예를 들어서 진행이 오래 되었어서 다른 process들의 pass 값이 매우 크다고 해보자. 그렇다면 새로운 process의 pass 값은 한동안 제일 낮을 것이므로 CPU 자원을 독차지하게 된다. 즉, stride scheduling은 새로운 process의 pass 값으로 무엇을 주냐에 따라 starvation이 발생할 수 있다.
보통 현재 pass value 중에서 최솟값으로 설정한다.
반대로 lottery에서는 새로운 process에게 필요한 ticket 수만 주면 되고 동일하게 winner ticket을 뽑으면 되기에 이런 문제를 겪지 않는다는 장점이 있다.