<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://joowan1108.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://joowan1108.github.io/" rel="alternate" type="text/html" /><updated>2026-10-19T13:31:52+00:00</updated><id>https://joowan1108.github.io/feed.xml</id><title type="html">Study-Blog</title><subtitle>공부 기록용</subtitle><author><name>채주완</name></author><entry><title type="html">5systemmodeling</title><link href="https://joowan1108.github.io/skku_sweng/5SystemModeling/" rel="alternate" type="text/html" title="5systemmodeling" /><published>2026-10-17T00:00:00+00:00</published><updated>2026-10-17T00:00:00+00:00</updated><id>https://joowan1108.github.io/skku_sweng/5SystemModeling</id><content type="html" xml:base="https://joowan1108.github.io/skku_sweng/5SystemModeling/"><![CDATA[<h1 id="system-modeling">System Modeling</h1>

<p>System의 abstract model을 개발하는 방법</p>

<p>각 model을 각자 다른 perspective을 보여주고 diagram type을 UML을 통해 보여준다.</p>

<p>이미 존재하는 system과 새로운 system을 modeling할 때는 다른 정보를 담아야 한다</p>

<ul>
  <li>Models of existing system
    <ul>
      <li>Existing system이 하는 것</li>
      <li>장점과 단점</li>
    </ul>
  </li>
  <li>Models of new system
    <ul>
      <li>Proposed requirements 설명하기</li>
      <li>Design proposal 설명하기</li>
      <li>구현하기 위한 documentation</li>
    </ul>
  </li>
</ul>

<p>Graphical model을 사용하는 이유</p>
<ul>
  <li>Existing, proposed system에 집중할 때
    <ul>
      <li>Model은 incomplete + informal notation 가능</li>
    </ul>
  </li>
  <li>Documenting existing system
    <ul>
      <li>Model은 incomplete 가능 하지만 correct 해야함</li>
    </ul>
  </li>
  <li>Generating system implementation
    <ul>
      <li>Model은 complete 해야 하고 correct 해야함</li>
    </ul>
  </li>
</ul>

<p>System modeling을 하기 위해서 사용되는 언어가 UML: Unified Modeling Language이다. 이 langauge는 object oriented modeling을 위한 standard langauge이다.</p>

<p>종류로는 5가지가 존재한다.</p>

<ul>
  <li><strong>Use Case Diagram</strong>
    <ul>
      <li>Iteractions between system and environment</li>
    </ul>
  </li>
  <li><strong>Sequence Diagram</strong>
    <ul>
      <li>Interactions between actors and system + between system components</li>
    </ul>
  </li>
  <li><strong>Class Diagram</strong>
    <ul>
      <li>Object classes in the system and associations</li>
    </ul>
  </li>
  <li><strong>Activity Diagram</strong>
    <ul>
      <li>Activities involved in process</li>
    </ul>
  </li>
  <li><strong>State Diagram</strong>
    <ul>
      <li>How system reacts to internal / external events</li>
    </ul>
  </li>
</ul>

<p>System modeling의 perspective은 4가지가 존재한다.</p>

<ul>
  <li><strong>External perspective</strong>
    <ul>
      <li>Context와 environment을 modeling</li>
    </ul>
  </li>
  <li><strong>Interaction perspective</strong>
    <ul>
      <li>System과 environment의 interaction modeling</li>
    </ul>
  </li>
  <li><strong>Structural perspective</strong>
    <ul>
      <li>System의 organization과 data의 structure</li>
    </ul>
  </li>
  <li><strong>Behavioral perspective</strong>
    <ul>
      <li>Dynamic behavior modeling</li>
    </ul>
  </li>
</ul>

<h2 id="external-perspective">External Perspective</h2>

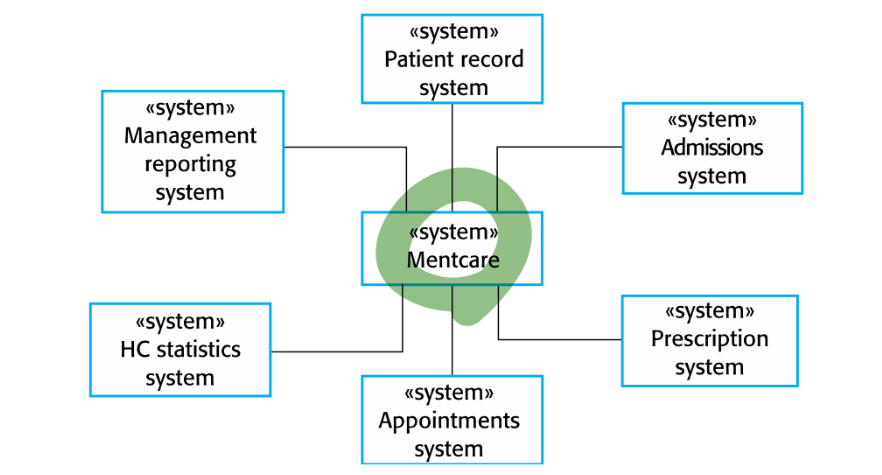
<p>External perspective을 보여주는 system model은 context model이다. System이 다른 system들이 존재하는 environment에서 어떤 위치에 있는지 알려준다.</p>

<p>이 중 Simple Context model이 있다.</p>

<p><strong>Simple Context Model</strong></p>

<p>Relationship type을 보여주지는 않는다. 따라서 다음 정보는 없다</p>

<ul>
  <li>System이 생성하고 소비하는 data</li>
  <li>Physical location</li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure10.png" alt="joowan1108" /></p>

<p>하지만 relation 정보는 system의 requirements와 design에 영향을 주기 때문에 단독으로 사용되지는 않는다</p>

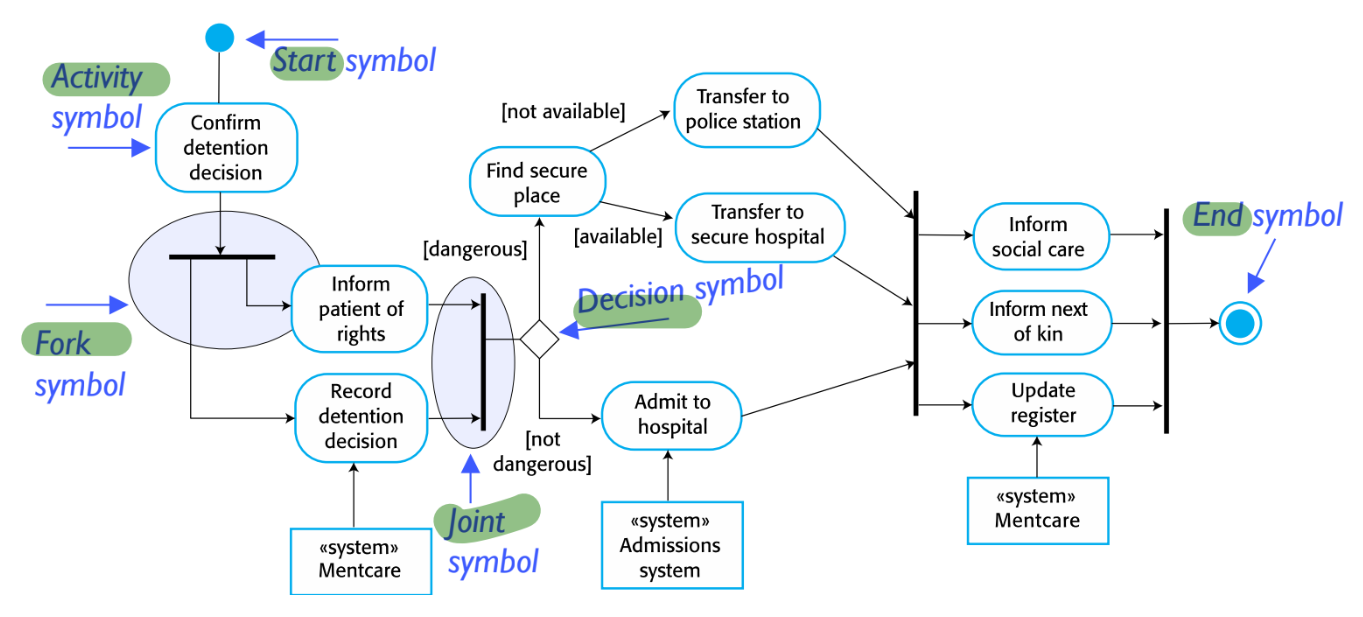
<p>예를 들어 activity model과 같이 사용되면 다음처럼 된다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure11.png" alt="joowan1108" /></p>

<h2 id="interaction-perspective">Interaction Perspective</h2>

<p>Interaction modeling을 하기 위해서 보통 use case 또는 sequence diagram을 사용한다.</p>

<p>Use case는 system과 external agents(human users or other systems) 간의 interaction</p>

<p>Sequence diagram은 system components 간의 interaction. 이때 external agents도 포함될 수 있다.</p>

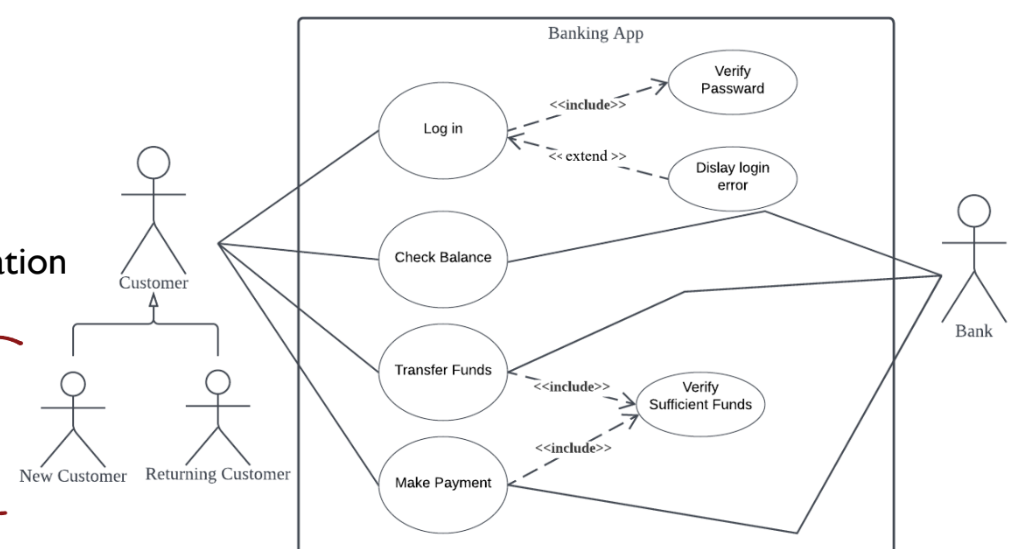
<p><strong>Use Case Diagram</strong></p>

<p>User가 interaction을 통해 무엇을 expect하는지 설명하는 것이라고 보면 된다.</p>

<p>Use case diagram은 actor, use case, system, relationship으로 구성된다.</p>

<ul>
  <li><strong>Actor</strong>
    <ul>
      <li><strong>Primary actors</strong>: 자기의 목적을 달성하기 위해 system을 사용하는 사람 (고객)</li>
      <li><strong>Secondary actors</strong>: Primary actor의 목표를 달성할 수 있도록 시스템에 서비스를 제공하는 actor (결제 시스템)</li>
    </ul>
  </li>
  <li><strong>Relationship</strong>
    <ul>
      <li><strong>Association</strong>: Actor가 use case에 참여 / 상호 작용하는 관계</li>
      <li><strong>Include</strong>: 가리키는 대상이 실행되어야 base use case도 실행된다 (mandatory)</li>
      <li><strong>Extend</strong>: 조건에 따라 추가되는 use case</li>
      <li><strong>Generalization</strong>: Actor / Use case는 behavior / relationship을 inherit</li>
    </ul>
  </li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure12.png" alt="joowan1108" /></p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure13.png" alt="joowan1108" /></p>

<p><strong>Sequence Diagram</strong></p>

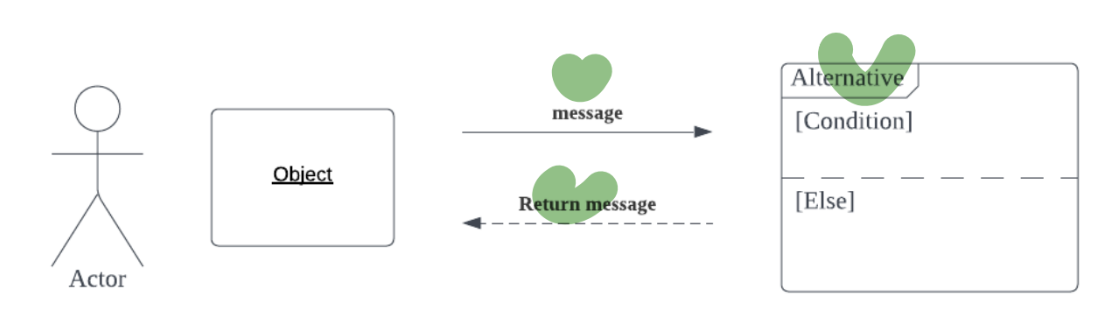
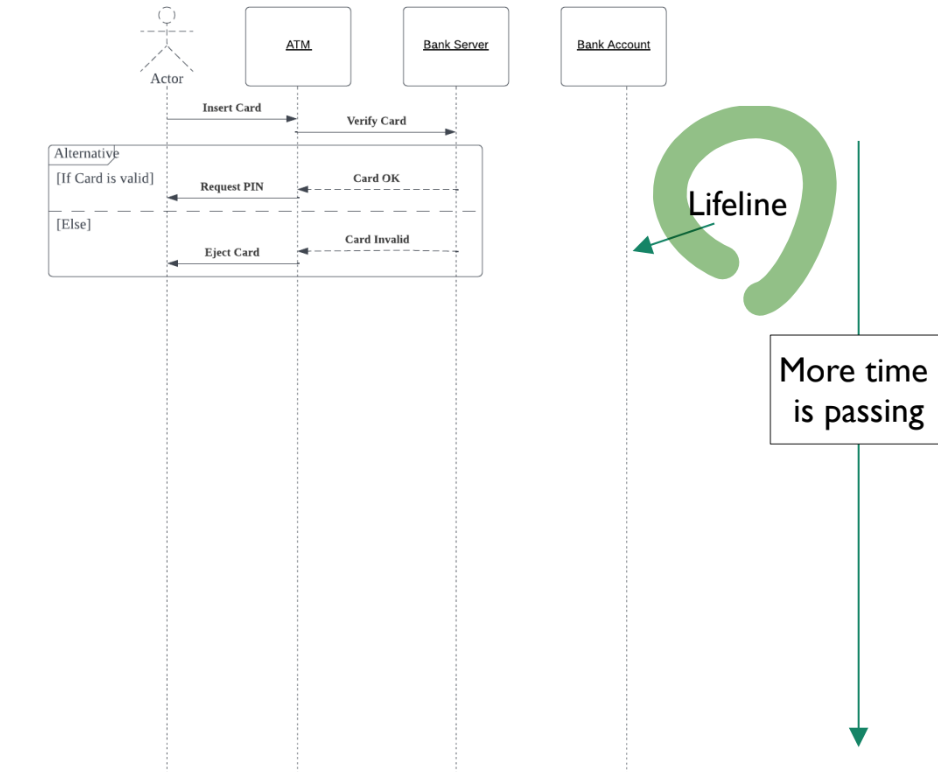
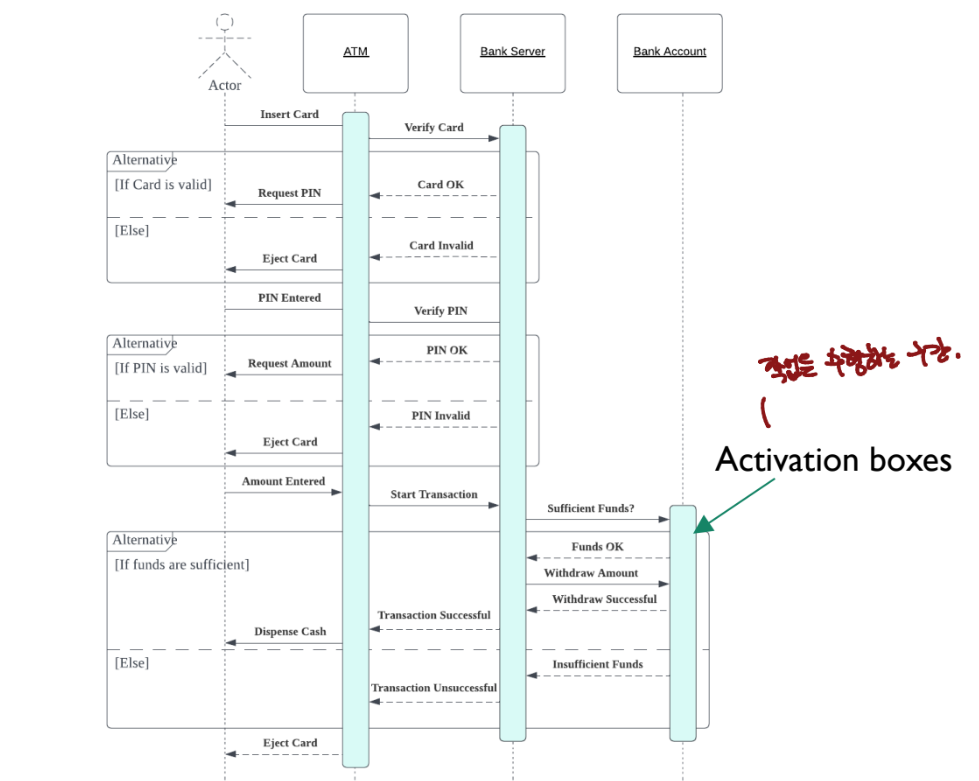
<p>Actor와 object 간의 interaction을 설명한다. (주고 받는 message)</p>

<p>Interaction의 sequence을 특정 use case에 대해서 설명한다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure14.png" alt="joowan1108" /></p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure15.png" alt="joowan1108" /></p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure16.png" alt="joowan1108" /></p>

<h2 id="structural-perspective">Structural Perspective</h2>

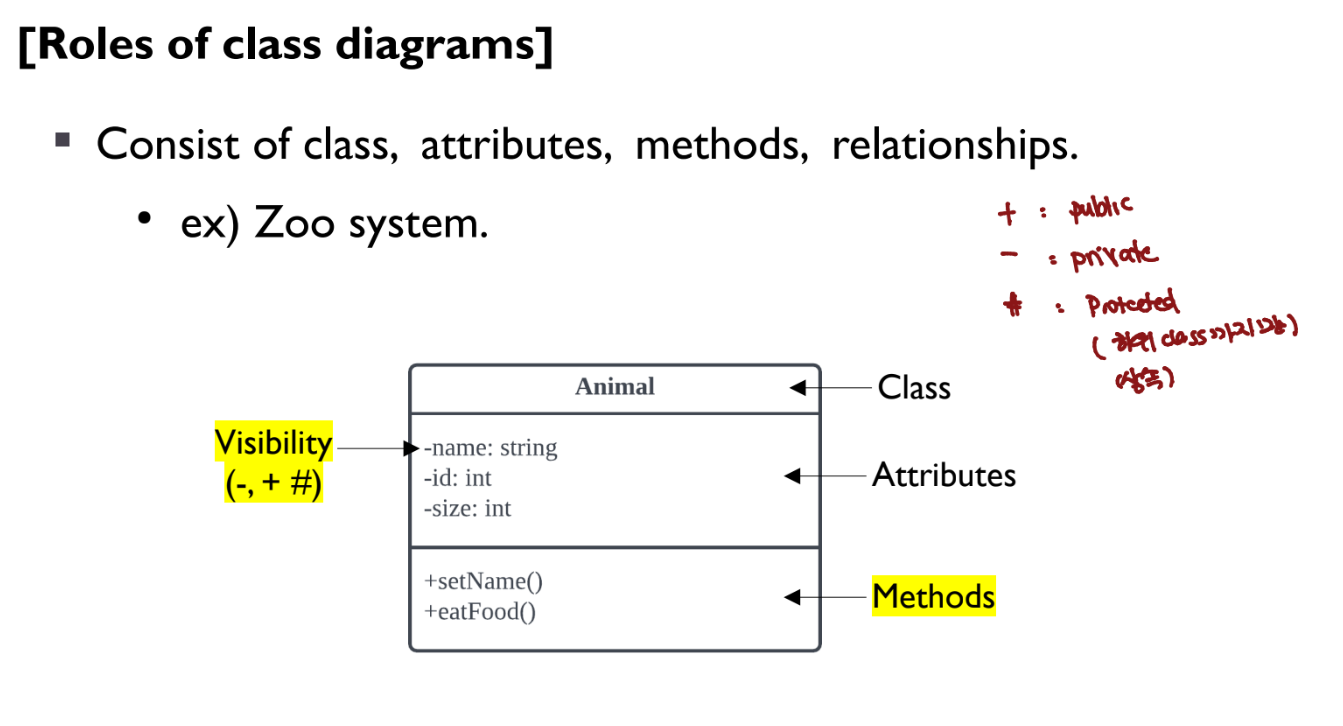
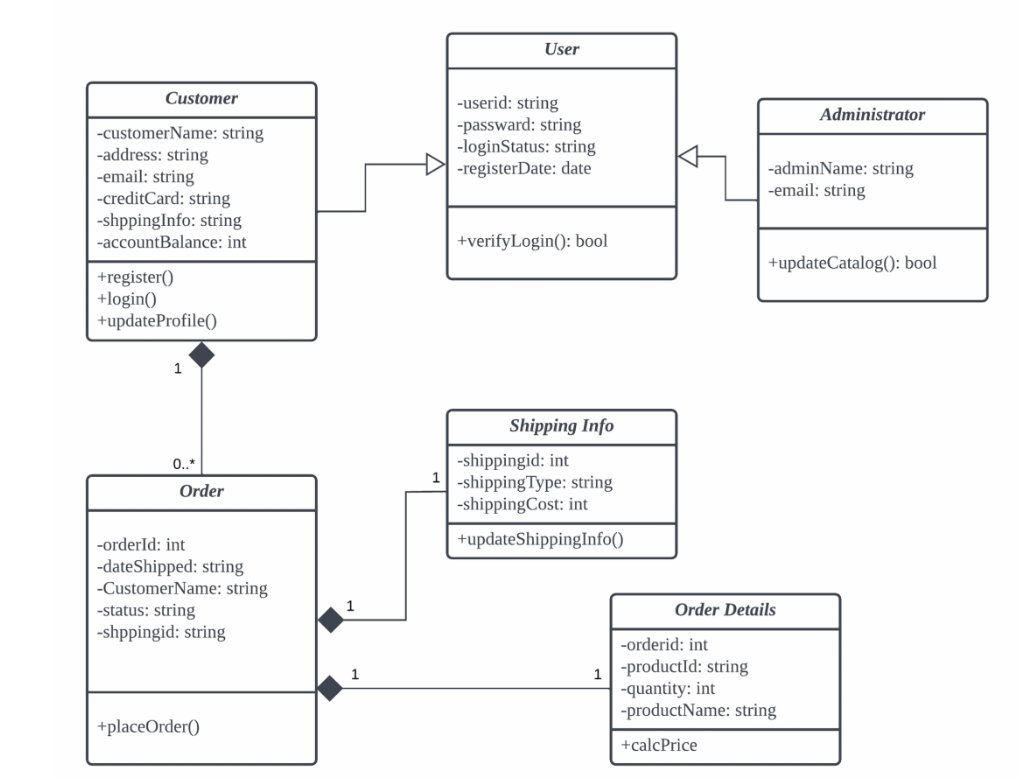
<p>Structural model을 사용한다. System의 organization을 통해 system과 relationship을 보여준다.</p>

<p>이때 class diagram을 사용한다. SW system에서의 object classes의 static structure을 modeling한다. message의 순서는 표시되지 않는다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure17.png" alt="joowan1108" /></p>

<p>Class 간의 relationship은 5가지가 존재한다.</p>

<ul>
  <li><strong>Inheritance</strong>
    <ul>
      <li>하위 클래스가 상위 클래스를 가리킴</li>
    </ul>
  </li>
  <li><strong>Association</strong>
    <ul>
      <li>두 객체들 간의 연결 /연관</li>
    </ul>
  </li>
  <li><strong>Aggregation</strong>
    <ul>
      <li>전체 (하얀색 사각형) - 부분 으로 표시되고 부분은 life cycle이 전체와 independent함. Independent하게 exist가 가능함</li>
    </ul>
  </li>
  <li><strong>Composition</strong>
    <ul>
      <li>전체 (검은색 사각형) - 부분 으로 표시되고 부분은 life cycle이 전체와 dependent함.</li>
    </ul>
  </li>
  <li><strong>Multiplicity</strong>
    <ul>
      <li>관계에 참여할 수 있는 객체 개수</li>
      <li>4..* 적혀있으면 4개 이상이 참여한다고 보면 된다.</li>
    </ul>
  </li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure18.png" alt="joowan1108" /></p>

<h2 id="behavioral-models">Behavioral models</h2>

<p>Dynamic behavior을 modeling함</p>

<p>System이 stimulus에 respond할 때 어떻게 되는지를 보여줌 (Stimulus = data / event)</p>

<p>Stimulus에도 다양한 종류가 존재한다.</p>

<p>Business system들은 data driven stimulus이다. 예를 들어서 phone billing system에서 call이 생기면 cost을 계산하고 bill generation 은 stimulus가 data이다.</p>

<p>한면 real time system들은 event driven stimulus이다.</p>

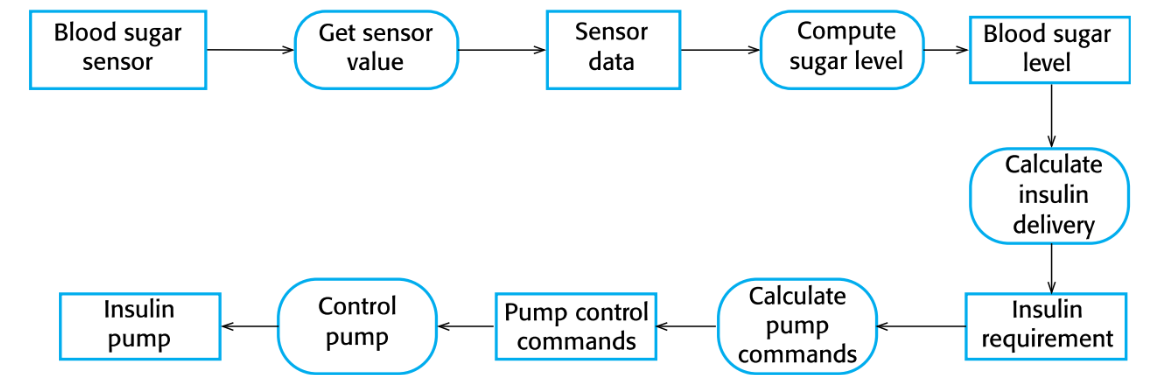
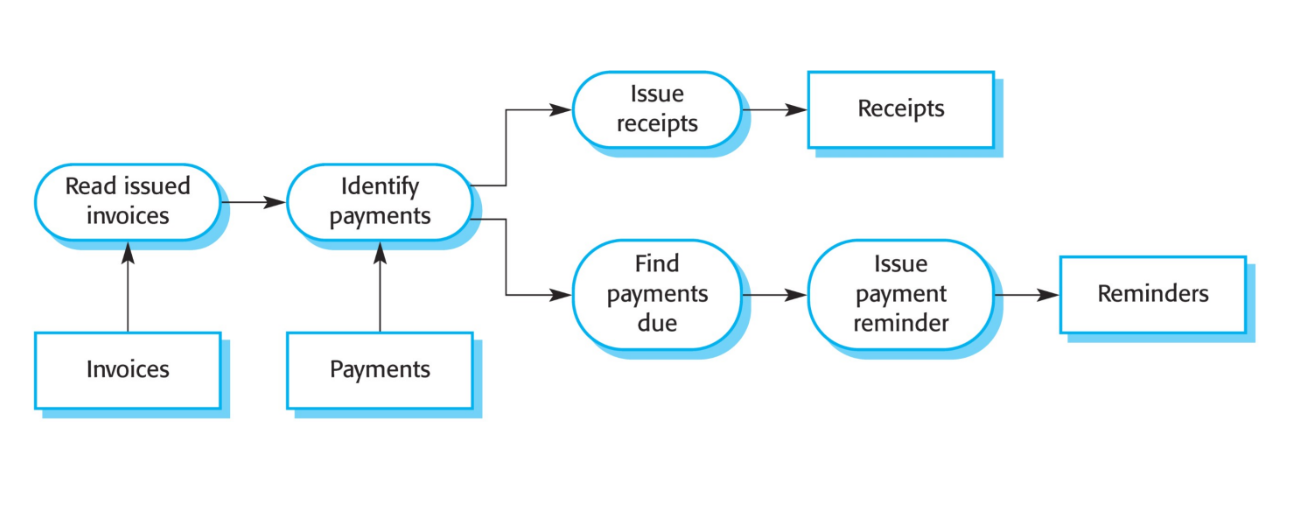
<p><strong>Data driven model</strong></p>

<p>Input/output을 처리하는 sequence of actions을 보여준다</p>

<p>이때 사용하는게 activity diagram이다. Activity는 rounded rectangles이고 data는 rectangles으로 보여준다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure19.png" alt="joowan1108" /></p>

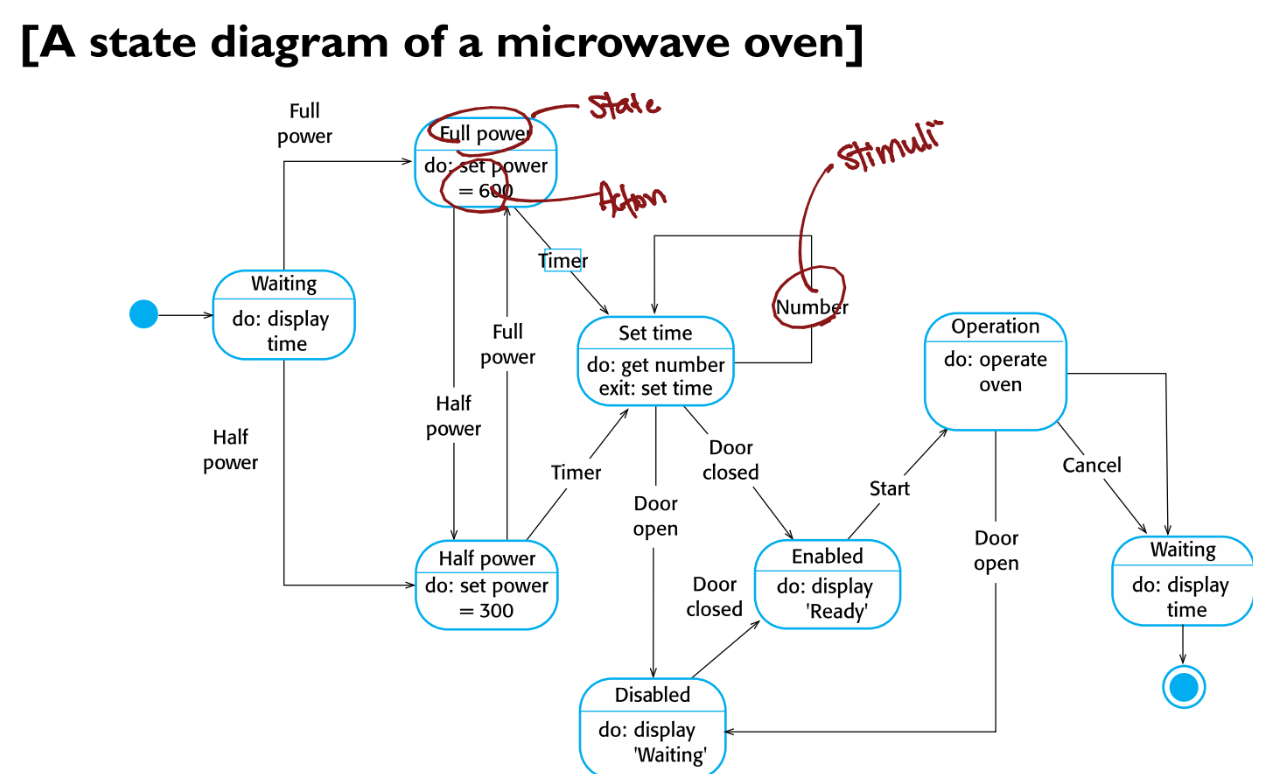
<p><strong>Event driven model</strong></p>

<p>System이 external과 internal event에 어떻게 반응하는지 보여줌</p>

<p>이때 states의 수가 제한적이고 event는 state transition을 일으킨다는 전제가 존재함</p>

<p>State diagram에서 rounded reactiangles는 system state을 보여주고 labeled arrows는 transition을 보여준다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure20.png" alt="joowan1108" /></p>

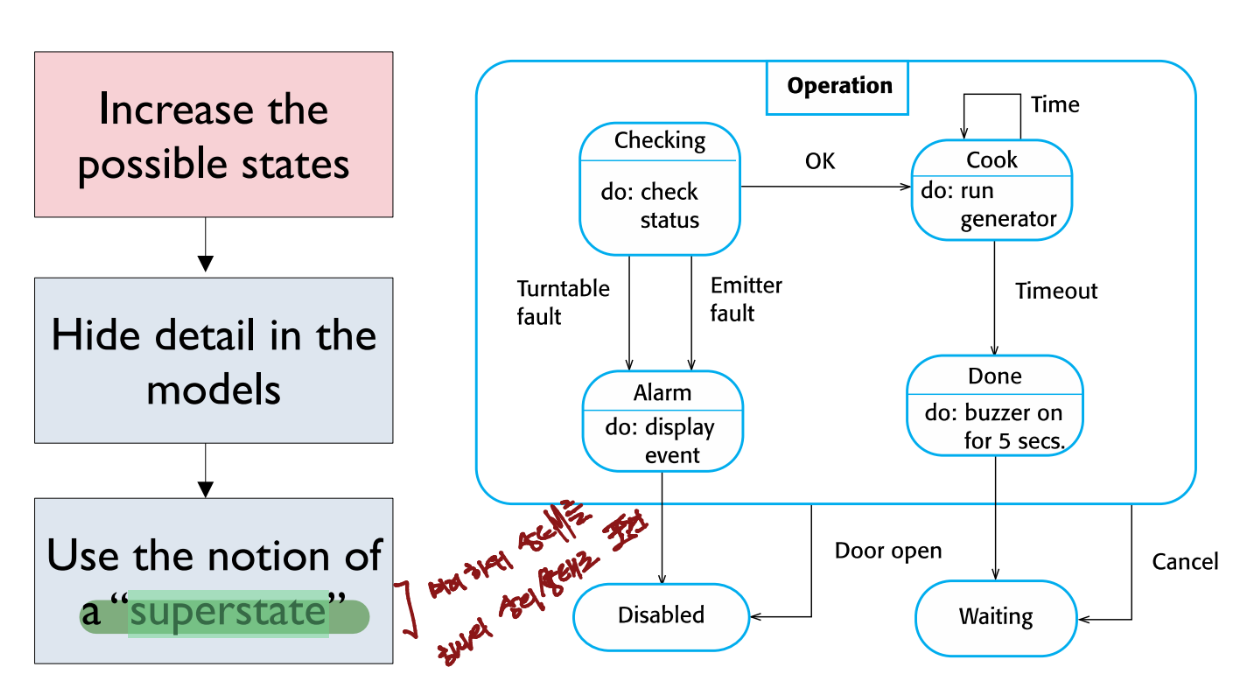
<p><strong>Superstate</strong></p>

<p>System이 복잡해질수록 states가 늘어난다.</p>

<p>이때 모든 state들을 개별적으로 표현하면 모델이 복잡해지므로 세부사항을 묶어서 숨긴다.</p>

<p>그리고 state들을 하나의 상위 state으로 묶어서 표현한다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure22.png" alt="joowan1108" /></p>
<h1 id="model-driven-architecture">Model Driven Architecture</h1>

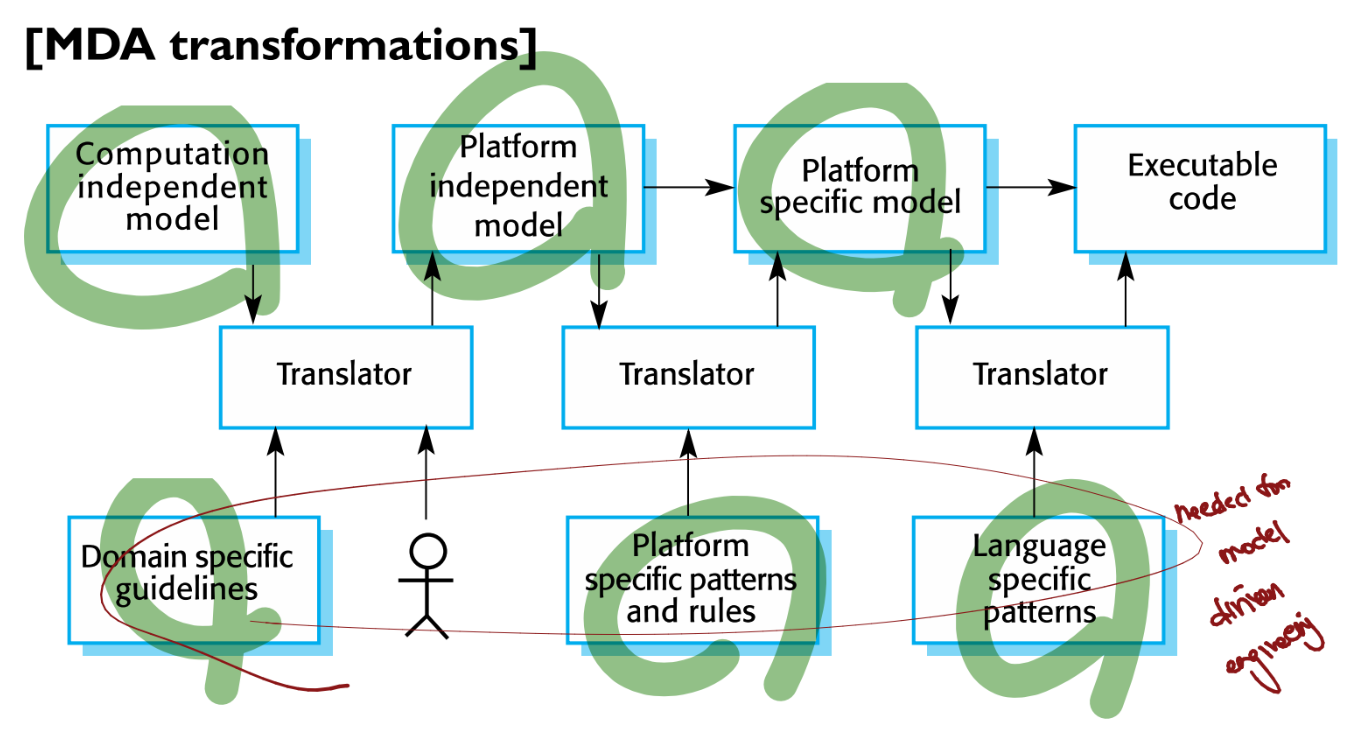
<p>System modeling의 결과 model을 통해서 실제 software design / implementation에도 사용하는 방법이 MDA이다.</p>

<p>즉, model을 중심으로 소프트웨어를 설계하고 구현하는 접근법이다. 지금까지 배운 system modeling은 시스템을 이해하고 다른 사람에게 설명하기 위해서인데 MDA는 이것을 구현 과정으로 옮기는 과정을 다룬다고 보면 된다.</p>

<p>이 MDA는 하나의 가설을 바탕으로 작동한다. Programs that execute on a SW platform are generated automatically from the models == 프로그램을 모델로부터 자동으로 생성할 수 있을 것이라는 기대 또는 가설</p>

<p>MDA에는 세 가지 abstract system model을 사용한다.</p>

<ul>
  <li><strong>CIM Computation Independent Model</strong>
    <ul>
      <li>Model important domain abstractions</li>
    </ul>
  </li>
  <li><strong>PIM Platform Independent Model</strong>
    <ul>
      <li>Enable mapping to one or more platforms by abstracting technical details (플랫폼 특징을 고려하지 않는다)</li>
    </ul>
  </li>
  <li><strong>PSM Platform Specific Model</strong>
    <ul>
      <li>Combine with PIM with details required for using in particular type of platform</li>
    </ul>
  </li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure21.png" alt="joowan1108" /></p>

<p>각 model들은 자기만의 translator을 통해서 다른 model에게 전달한다. 이때 필요한 정보가 각각 다르다.</p>

<p><strong>하지만 MDA가 주요 approach가 되지 않은 이유는 다음과 같다.</strong></p>

<p>Abstractions that are usefulf ro discussion are not right abstractions for implementation</p>

<p>For complex system, implementation is not the major problem</p>
<ul>
  <li>requirements engineering, security, dependability, testing이 더 중요한 문제임</li>
</ul>

<p>Agile method가 너무 좋음</p>]]></content><author><name>채주완</name></author><category term="SKKU_SwEng" /><summary type="html"><![CDATA[System Modeling]]></summary></entry><entry><title type="html">6architecturaldesign</title><link href="https://joowan1108.github.io/skku_sweng/6ArchitecturalDesign/" rel="alternate" type="text/html" title="6architecturaldesign" /><published>2026-10-17T00:00:00+00:00</published><updated>2026-10-17T00:00:00+00:00</updated><id>https://joowan1108.github.io/skku_sweng/6ArchitecturalDesign</id><content type="html" xml:base="https://joowan1108.github.io/skku_sweng/6ArchitecturalDesign/"><![CDATA[<h1 id="architectural-design">Architectural Design</h1>

<p>소프트웨어 전체 구조를 어떻게 설계할 것인지 설명한다. 그러기 위해서는 네 가지 관점을 얻어야 한다.</p>

<ol>
  <li>Designing the overall strucutre of SW system</li>
  <li>Identifying the main structural components and relationships</li>
  <li>Satisfying functional and non-functional requirements</li>
  <li>Depending on system type, architect experience and specific requirements</li>
</ol>

<p>Architecture을 표현한다고 할 때 block diagram을 사용할 수 있다.</p>

<p>Box는 component을 표현하고 arrow는 flow of data / signal을 표현한다.</p>

<p>Architectural design을 하면 얻은 세 장점이 있다.</p>

<ul>
  <li><strong>Stakeholder communication</strong></li>
  <li><strong>System analysis</strong>
    <ul>
      <li>System이 critical requirements을 만족할 수 있는지에 design이 영향을 준다</li>
    </ul>
  </li>
  <li><strong>Large scale reuse</strong>
    <ul>
      <li>Large scale SW reuse에 도움이 된다.</li>
    </ul>
  </li>
</ul>

<p><strong>이때 architectural design 결정에 영향을 주는 것은 non functional requirements이다.</strong></p>

<ul>
  <li><strong>Performance</strong>
    <ul>
      <li>적은 수의 components에 critical operations 압축
        <ul>
          <li>Localize critical operations within a small number of components</li>
        </ul>
      </li>
      <li>Large components을 통해 Component communications을 최소화</li>
    </ul>
  </li>
  <li><strong>Security</strong>
    <ul>
      <li>Layered structure을 사용하여 critical assets을 innermost에 숨김</li>
    </ul>
  </li>
  <li><strong>Safety</strong>
    <ul>
      <li>Reduce the costs and problems of safety validation</li>
      <li>Safety related operations을 하나의 component을 압축</li>
    </ul>
  </li>
  <li><strong>Availability</strong>
    <ul>
      <li>Components을 중복 사용해서 하나가 무너져도 작동되도록</li>
    </ul>
  </li>
  <li><strong>Maintainability</strong>
    <ul>
      <li>Fine grained, self-contained compoenents을 사용해서 유지 보수 쉽게</li>
    </ul>
  </li>
</ul>

<p>이때 performance와 maintainability가 충돌한다. Performance는 large components을 사용하고자 하고 maintainability는 small components을 유도한다.</p>

<h2 id="architectural-views">Architectural Views</h2>

<p>어떤 views / perspective가 designing에 중요할까?</p>

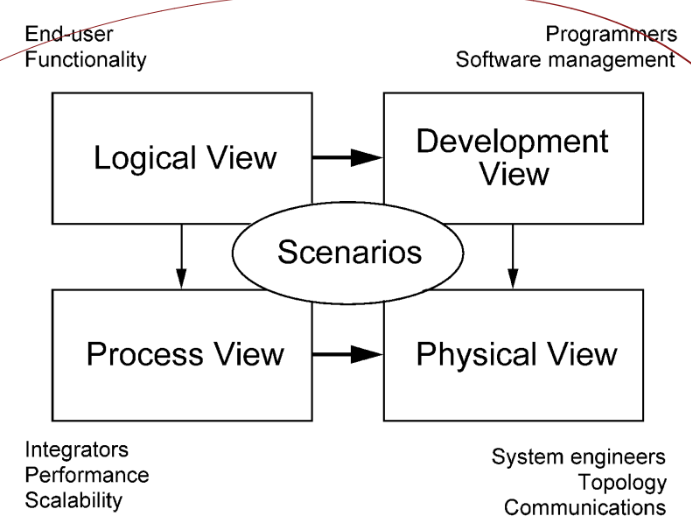
<p>다양한 사람들은 자기에 맞는 정보만 보고 싶어 하기 때문에 하나의 그림으로 모든 정보를 표현하기 어렵다.</p>

<p>따라서 4+1 view model을 사용한다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure23.png" alt="joowan1108" /></p>

<ul>
  <li><strong>Logical View</strong>
    <ul>
      <li>Key abstractions in the system as objects</li>
      <li>Functional requirements</li>
    </ul>
  </li>
  <li><strong>Process View</strong>
    <ul>
      <li>interacting process가 run time에 어떻게 구성되는지</li>
      <li>Non functional requirements 중에 performance</li>
    </ul>
  </li>
  <li><strong>Development View</strong>
    <ul>
      <li>Software가 어떻게 decompose 되었는지</li>
      <li>SW managers / developers을 위한 것</li>
    </ul>
  </li>
  <li><strong>Physical View</strong>
    <ul>
      <li>HW / SW가 어떻게 분산되어있는지</li>
      <li>System engineers</li>
    </ul>
  </li>
  <li><strong>Scenarios</strong>
    <ul>
      <li>Object와 process 간의 sequence of interactions</li>
    </ul>
  </li>
</ul>

<h2 id="architectural-patterns">Architectural Patterns</h2>

<p>Abstract description of good practice</p>

<p>이미 다양한 environments와 system에 tested / tried 된 것</p>

<p>이때 특정 pattern이 언제 안 좋은지 / 좋은지에 대한 정보도 들어있음</p>

<p>### Model View Controller Pattern</p>

<p>Separate presentation and interaction of system data</p>

<p><strong>Model</strong>: system data와 data에 가해지는 operations</p>

<p><strong>View</strong>: Data가 user에게 보여지는 부분</p>

<p><strong>Controller</strong>: User interaction과 interactions들을 model과 view에 보내는 것</p>

<p><strong>언제 사용하는가</strong></p>
<ul>
  <li>Data을 view하고 interact하는 여러 방법이 있을 때 사용</li>
</ul>

<p><strong>장점</strong></p>
<ul>
  <li>Data가 independent하게 변함</li>
  <li>다양한 data에 대한 Presentation을 다양하게 하기</li>
</ul>

<p><strong>단점</strong></p>
<ul>
  <li>Data model과 interaction이 간단해도 code complexity가 높다</li>
</ul>

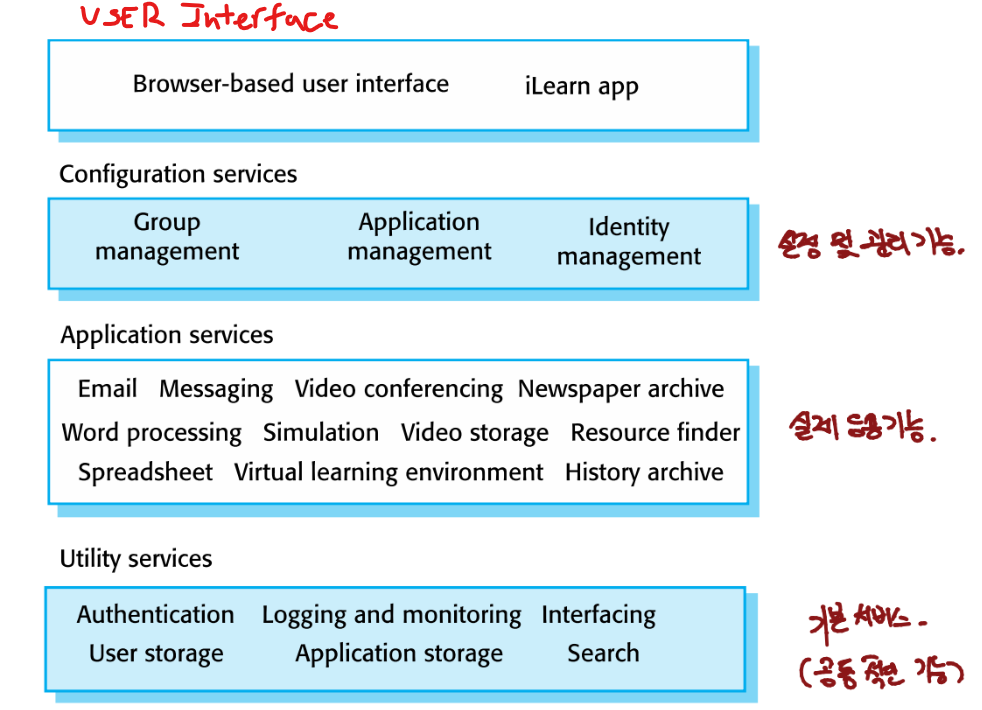
<h3 id="layered-architecture">Layered Architecture</h3>

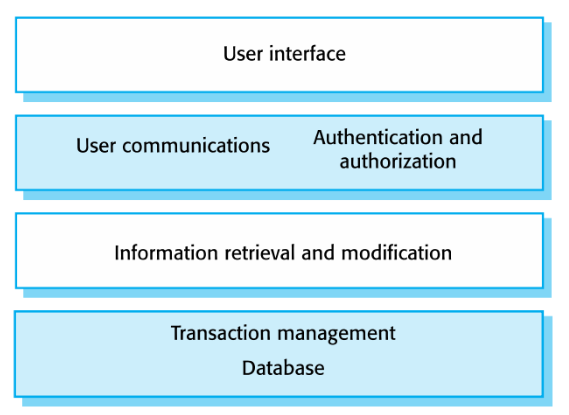
<p>System을 여러 layer으로 쌓고 각 layer가 위 layer에 service을 제공한다</p>

<p><strong>User interface</strong></p>

<p>$\uparrow$</p>

<p><strong>User interface management</strong></p>

<p><strong>Authentication and authorization</strong></p>

<p>$\uparrow$</p>

<p><strong>Core business logic / Application functionality</strong></p>

<p>$\uparrow$</p>

<p><strong>System support (OS, Database)</strong></p>

<p><strong>특징</strong></p>
<ul>
  <li>Separation과 independence가 가능하고</li>
  <li>Incremental development of system을 지원
    <ul>
      <li>Layer interface가 달라지면 Adjacent layer만 영향을 받는다</li>
    </ul>
  </li>
</ul>

<p><strong>언제 사용하는가</strong></p>
<ul>
  <li>이미 존재하는 system에 추가를 할 때</li>
  <li>여러 team이 관여하고 각 team은 하나의 layer을 담당할 때</li>
  <li>Multi-level security 가능</li>
</ul>

<p><strong>장점</strong></p>
<ul>
  <li>전체 layer의 교체가 가능하다. Interface만 유지되면 내부 수정은 상관 없다</li>
  <li>각 layer에서 중복 facilities가 제공될 수 있어서 system의 신뢰성 (dependability)가 높다</li>
</ul>

<p><strong>단점</strong></p>
<ul>
  <li>Layer간의 clear separation 어려움</li>
  <li>붙어있지 않은 layer 간의 직접적인 소통이 불가능함</li>
  <li>여러 계층을 거쳐야 되기 때문에 performance 감소</li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure24.png" alt="joowan1108" /></p>

<h3 id="repository-architecture">Repository Architecture</h3>

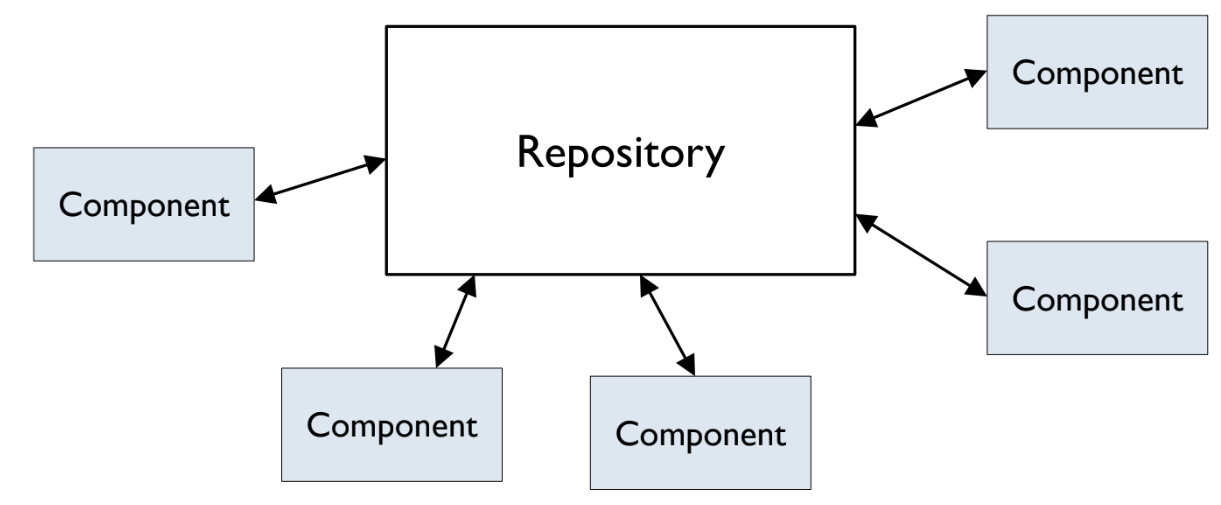
<p>모든 data가 하나의 repository에 관리된다.</p>

<p>Component끼리는 직접 소통할 수 없고 repository을 통해서만 가능하다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure25.png" alt="joowan1108" /></p>

<p><strong>언제 사용하는가</strong></p>
<ul>
  <li>Large volume of information이 오랫동안 저장되어야 할 때</li>
</ul>

<p><strong>장점</strong></p>
<ul>
  <li>Component independent 가능</li>
  <li>서로 존재 알 필요 없음</li>
  <li>모든 data가 managed consistenly (한 곳에만 존재하므로)</li>
</ul>

<p><strong>단점</strong></p>
<ul>
  <li>Repository가 고장나면 전체가 고장남</li>
  <li>모든 communication을 하나의 repository으로 관리하는 것은 어려움</li>
  <li>이 repository을 여러 computer에 분배하는 것도 어려움</li>
</ul>

<p>Toy story 2에서 pixar가 rm -rf을 root에 실행해서 toy story 파일이 다 없어졌을 뻔했다.</p>

<h3 id="client-server-architecture">Client Server Architecture</h3>

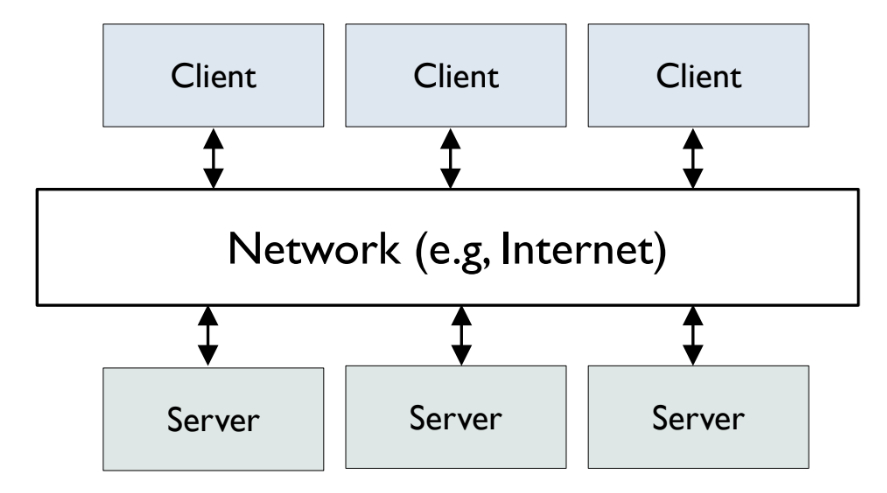
<p>System이 여러 service으로 구현되어 있고 각 service는 자기만의 server를 가진다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure26.png" alt="joowan1108" /></p>

<p><strong>주요 components</strong></p>
<ul>
  <li>Set of servers
    <ul>
      <li>service 제공자</li>
    </ul>
  </li>
  <li>Set of clients
    <ul>
      <li>Server 이용자</li>
    </ul>
  </li>
  <li>Network
    <ul>
      <li>Client가 server에 접근하도록 도와줌</li>
    </ul>
  </li>
</ul>

<p><strong>언제 사용하는가</strong></p>
<ul>
  <li>다양한 곳에서 shared DB에 있는 정보에 접근해야 할 때</li>
</ul>

<p><strong>장점</strong></p>
<ul>
  <li>Server가 network에서 분배가 가능</li>
  <li>General한 functionality가 모든 client에게 제공될 수 있다.</li>
</ul>

<p><strong>단점</strong></p>
<ul>
  <li>Denial of Service에 영향을 받을 수 있다</li>
  <li>Performance가 network에 영향을 받음</li>
  <li>Server를 직접 구현하지 않으면 management problem 존재</li>
</ul>

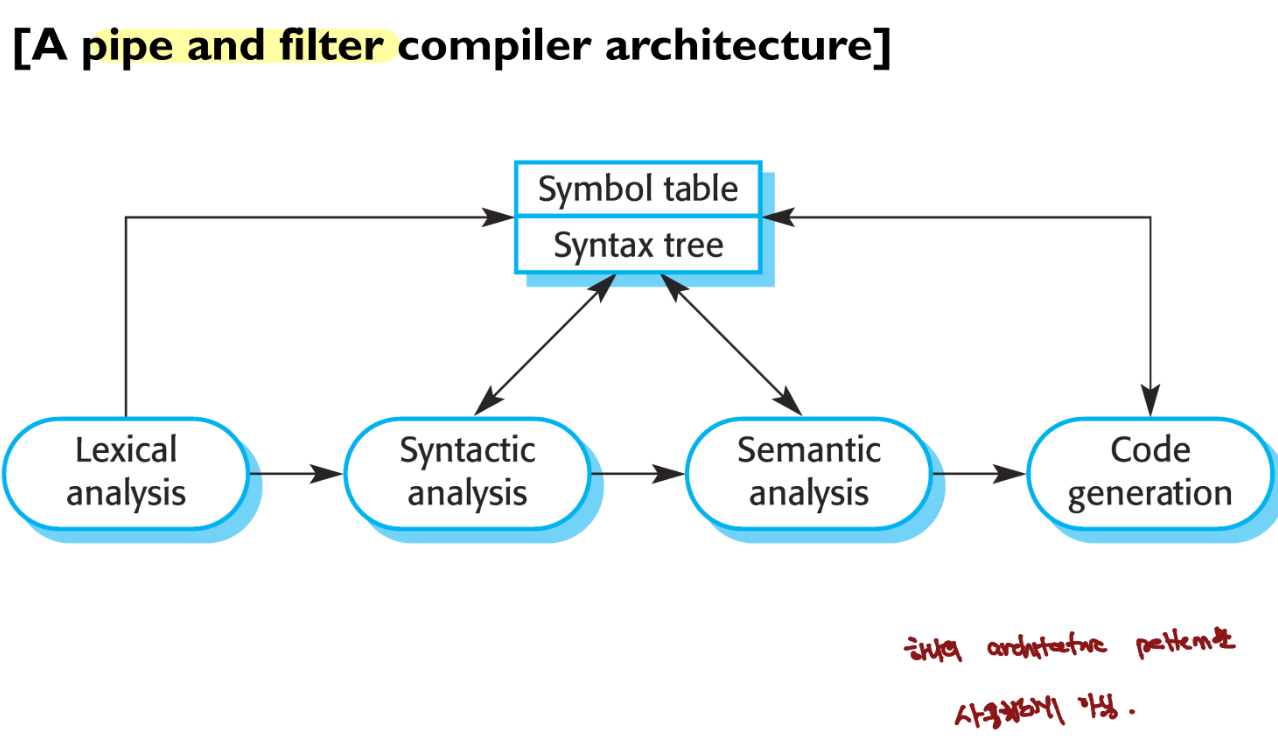
<h3 id="pipe-and-filer-architecture">Pipe and Filer Architecture</h3>

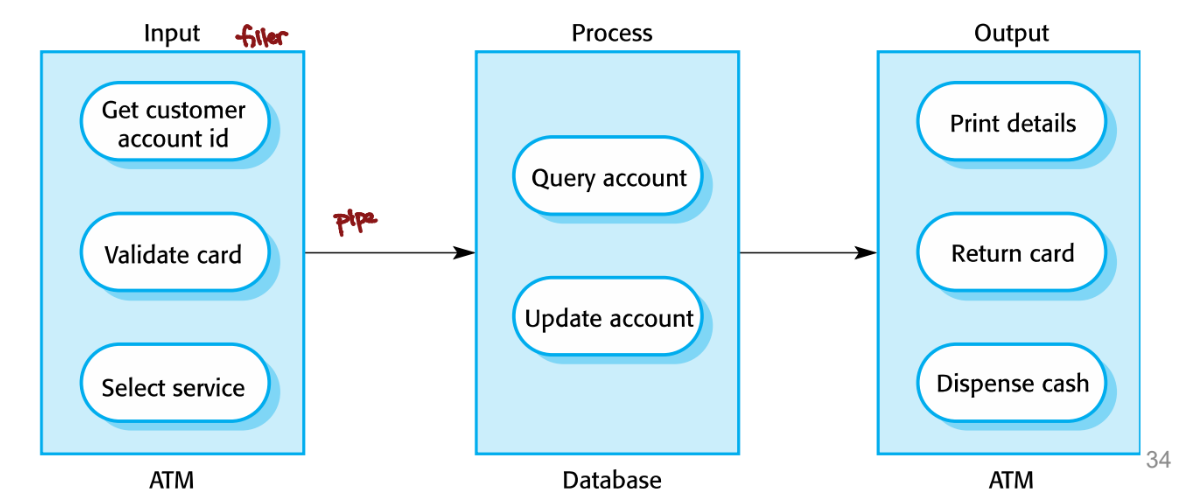
<p>Data을 여러 처리 단계로 전달하면서 변환</p>

<p>각 processing component (filter)는 discrete하고 one type of data transformation을 수행한다.</p>

<p>Data flow는 pipe으로 filter들을 지나가도록 한다.</p>

<p><strong>언제 사용하는가</strong></p>
<ul>
  <li>Data processing app</li>
  <li>Input이 분리된 stage들을 통해 처리될 때</li>
  <li>
    <table>
      <tbody>
        <tr>
          <td>ex) cat test.c</td>
          <td>grep ‘cha’</td>
        </tr>
      </tbody>
    </table>
  </li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure27.png" alt="joowan1108" /></p>

<p><strong>장점</strong></p>
<ul>
  <li>이해하기 쉽고 transformation reuse 가능</li>
  <li>business process와 일치</li>
  <li>tranformation 추가 및 evolution이 직관적임</li>
</ul>

<p><strong>단점</strong></p>
<ul>
  <li>Filter가 받고 주는 data 형식이 미리 정해져있어야 함</li>
  <li>Data 구조 간의 호환이 되어야 한다.</li>
</ul>

<h1 id="application-architecture">Application Architecture</h1>

<p>Business가 사용하는 Application system은 공통적인 특성을 가진다.</p>

<p>Application architecture는 특정 system의 principal characteristics을 encapsulate 한다.</p>

<p>Application architecture model은 사용 용도가 4가지이다.</p>
<ul>
  <li>Architectiral design process의 starting point
    <ul>
      <li>기존에 알려진 구조를 통해 필요한 component들을 결정 가능</li>
    </ul>
  </li>
  <li>Design checklist
    <ul>
      <li>설계 과정에 필요한 구성요소나 기능을 누락하지 않았는지 확인 가능</li>
    </ul>
  </li>
  <li>Organizing the work of development team</li>
  <li>Application type을 위한 의사소통을 위한 vocabulary
    <ul>
      <li>공통적인 개념을 사용하여 의사소통 편리화</li>
    </ul>
  </li>
</ul>

<p>Application Architecture의 종류에는 2가지가 있다</p>

<ul>
  <li><strong>Transaction Processing Applications</strong>
    <ul>
      <li>Database 중심</li>
      <li>User가 data을 사용하고 update하는 작업</li>
      <li>Interactive business system에서 가장 흔한 구조</li>
      <li>이때 transaction 이란 특정 goal을 만족하는 sequence of operations</li>
      <li>Pipe and filter architecture으로 표현될 수 있다.</li>
    </ul>
  </li>
</ul>

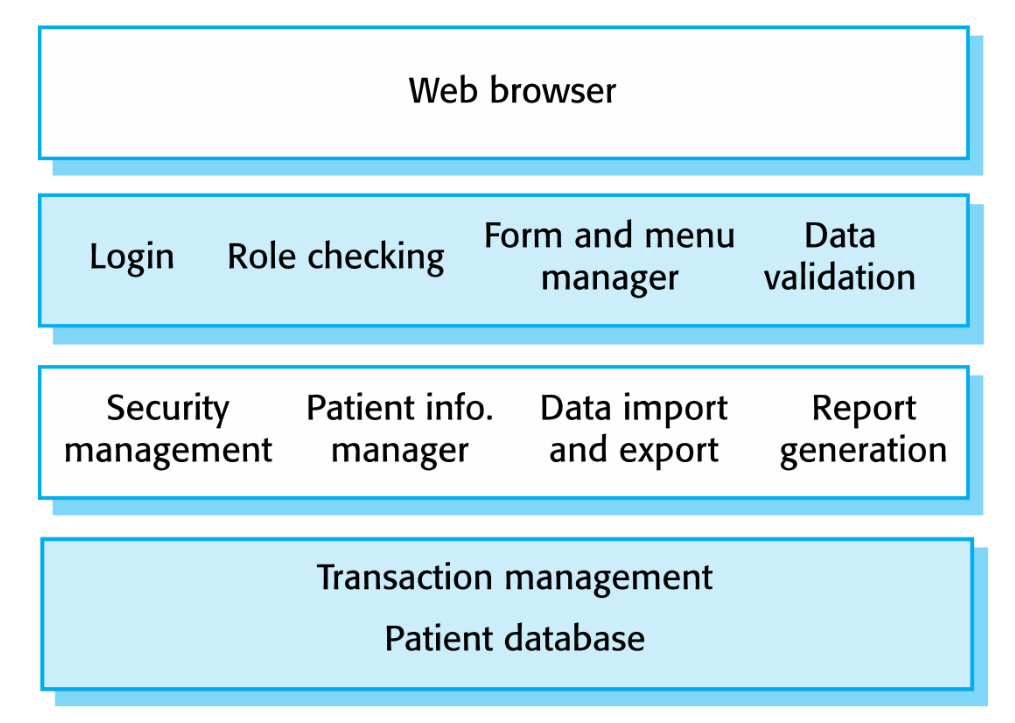
<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure28.png" alt="joowan1108" /></p>

<blockquote>
  <p>Information System
모든 system이 shared database와 작용을 한다 ex) web based
이때 information system은 layered approach을 적용한다.</p>
</blockquote>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure29.png" alt="joowan1108" /></p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure30.png" alt="joowan1108" /></p>

<ul>
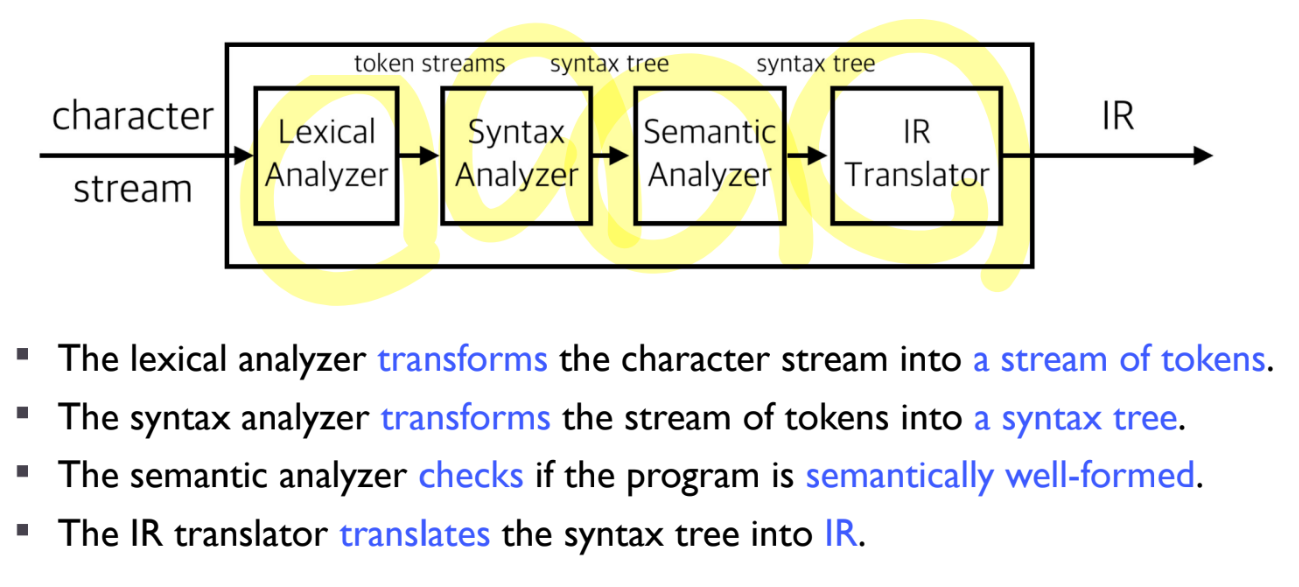
  <li><strong>Language Processing Systems</strong>
    <ul>
      <li>User의 의도가 formal langauge으로 표현되고 그 의미를 이해하는 것</li>
      <li>Compiler라고 보면 된다 (high level program -&gt; machine code)</li>
      <li>Translator라고 봐도 된다.</li>
    </ul>
  </li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure31.png" alt="joowan1108" /></p>

<p><strong>Lexical analyzer</strong></p>

<ul>
  <li>
    <p>character stream
pos = init + rate * 10</p>
  </li>
  <li>
    <p>Lexemes sequence
“pos”, “=”, “init”, “+”, “rate”, “$*$”, “10”</p>
  </li>
  <li>
    <p>token sequence
(ID, pos), ASSIGN, (ID, init), PLUS, (ID, rate), MULT, (NUM,10)</p>
  </li>
</ul>

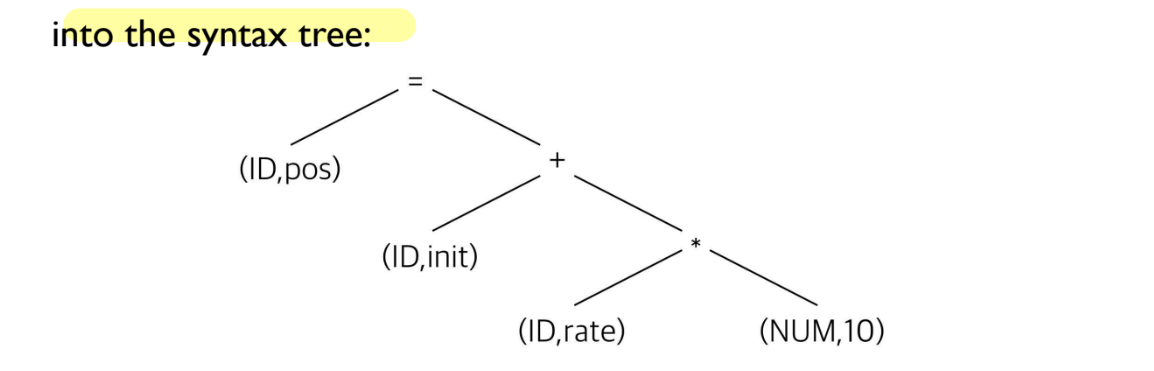
<p><strong>Syntax Analyzer</strong></p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure32.png" alt="joowan1108" /></p>

<p><strong>Semantic Analyzer</strong></p>

<p>Type errors 검토</p>

<p>Semantic erros 검토</p>
<ul>
  <li>Array out of bounds</li>
  <li>null dereference</li>
  <li>divide by zero</li>
</ul>

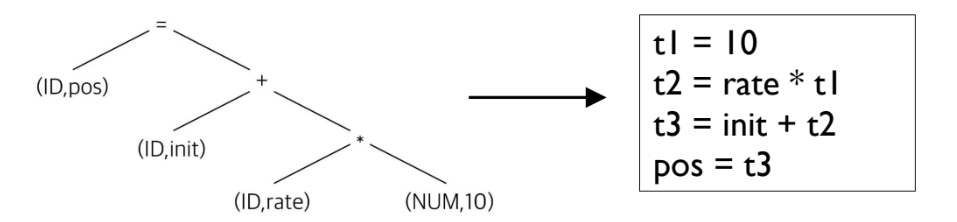
<p><strong>IR Translator</strong></p>

<p>Intermediate Representation (IR)</p>

<ul>
  <li>Lower level than source langauge</li>
  <li>higher level than target language</li>
</ul>

<p>Three address code으로 바꿈</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure33.png" alt="joowan1108" /></p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure34.png" alt="joowan1108" /></p>]]></content><author><name>채주완</name></author><category term="SKKU_SwEng" /><summary type="html"><![CDATA[Architectural Design]]></summary></entry><entry><title type="html">1introduction</title><link href="https://joowan1108.github.io/skku_sweng/1Introduction/" rel="alternate" type="text/html" title="1introduction" /><published>2026-10-16T00:00:00+00:00</published><updated>2026-10-16T00:00:00+00:00</updated><id>https://joowan1108.github.io/skku_sweng/1Introduction</id><content type="html" xml:base="https://joowan1108.github.io/skku_sweng/1Introduction/"><![CDATA[<h1 id="introduction">Introduction</h1>

<ul>
  <li><strong>Program</strong>: collection of instructions</li>
  <li><strong>Software</strong>: Programs + documentation (testing results, user manual, etc.)</li>
</ul>

<p>좋은 Software의 Essential Attributes</p>
<ul>
  <li><strong>Maintainability</strong>
    <ul>
      <li>Evolve to meet changing needs</li>
      <li>annotation 중요</li>
    </ul>
  </li>
  <li><strong>Dependability and Security</strong>
    <ul>
      <li>Should not cause damage</li>
      <li>Malicious users cannot access</li>
    </ul>
  </li>
  <li><strong>Efficiency</strong>
    <ul>
      <li>responsiveness, processing time, memory utilisation 중요</li>
    </ul>
  </li>
  <li><strong>Acceptability</strong>
    <ul>
      <li>Understandable, usable, compatible</li>
    </ul>
  </li>
</ul>

<p><strong>ICSE</strong> (International Conference on Software Engineering)에서 정의하는 필요한 documents</p>
<ul>
  <li>README: what the software does</li>
  <li>REQUIREMENTS: environment information</li>
  <li>LICENSE: distribution rights</li>
  <li>INSTALL: Usage example / installation test</li>
</ul>

<p>Software 개발에 드는 cost는 develop보다 maintain하는데 오래 걸린다. Debugging만 해도 develop의 절반의 cost가 필요하다고 한다.</p>

<p><strong>Software project들이 실패하는 이유</strong></p>

<ul>
  <li>System complexity increase exponentially on software size
    <ul>
      <li>Execution path increase exponentially with conditional statement</li>
    </ul>
  </li>
  <li>Software engineering method 사용 x</li>
</ul>

<h1 id="software-engineering">Software Engineering</h1>

<p>Software engineering이란 early stage부터 all aspects of software production + after it has gone to use까지 고려하는 engineering discipline. Technical process만 고려하는게 아님</p>

<p><strong>Documenting</strong> $\rightarrow$ <strong>Programming</strong> $\rightarrow$ <strong>Testing</strong> $\rightarrow$ <strong>Debugging</strong> $\rightarrow$ <strong>Evolving</strong></p>

<p>이때 engineering discipline이란 constraints을 고려한 theories와 methods을 사용해서 문제를 해결하는 것</p>

<p><strong>Software Engineering에 사용되는 topics</strong></p>

<ol>
  <li>AI and software engineering</li>
  <li>Testing and analysis</li>
  <li>Software Evolution</li>
  <li>Social Aspects of Software Engineering</li>
  <li>Requirements, Modeling, Design</li>
</ol>

<p><strong>Software Engineering이 중요한 이유</strong></p>
<ol>
  <li>Dependency of Software: Complex Software System에 더 의존하게 된다.</li>
  <li>Cost saving: 길게 보면 cost saving. 대부분의 cost는 사용하기 시작한 다음에 software가 바뀔 때 생긴다</li>
</ol>

<p><strong>Software Engineering의 key challenge</strong></p>

<p>Diversity가 증가하더라도 demands for reduced delivery times and developing trustworthy software</p>

<h1 id="software-process-activities">Software Process Activities</h1>

<ul>
  <li><strong>Software Specification</strong>
    <ul>
      <li>Define the software and constraints</li>
    </ul>
  </li>
  <li><strong>Software Development</strong>
    <ul>
      <li>Designed and programmed</li>
    </ul>
  </li>
  <li><strong>Software Validation</strong>
    <ul>
      <li>Check requirements are implemented</li>
    </ul>
  </li>
  <li><strong>Software Evolution</strong>
    <ul>
      <li>Modify</li>
    </ul>
  </li>
</ul>

<p><strong>Software에 영향을 주는 문제들</strong></p>
<ul>
  <li><strong>Heterogeneity</strong>
    <ul>
      <li>여러 environments에 작동해야 한다.</li>
    </ul>
  </li>
  <li><strong>Business and Social Change</strong>
    <ul>
      <li>Business와 society가 빨리 변한다</li>
    </ul>
  </li>
  <li><strong>Security and Trust</strong></li>
</ul>

<h1 id="software-products">Software Products</h1>

<ul>
  <li><strong>Generic Products</strong>
    <ul>
      <li>Stand alone system: Marketed and sold to any customer</li>
      <li>Specification은 software developer가 가짐</li>
      <li>Decision도 developer가 함</li>
    </ul>
  </li>
  <li><strong>Customized Products</strong>
    <ul>
      <li>Commisioned by specific customer</li>
      <li>Specification은 customer가 가짐</li>
      <li>Decision도 customer가 함</li>
    </ul>
  </li>
</ul>

<p>하지만 이 product type 간의 distinction이 점점 옅어지고 있다.</p>

<h1 id="software-engineering-ethics">Software Engineering Ethics</h1>

<p>Wide Responsibility, Honest, more than upholding the law</p>

<p><strong>Issues of professional responsiblity</strong></p>

<ul>
  <li><strong>Confidentiality</strong></li>
  <li><strong>Competence</strong>
    <ul>
      <li>Should not misrepresent level of competence</li>
      <li>능력 과장 x / 능력 부족하면 일 맡기 x</li>
    </ul>
  </li>
  <li><strong>Intellectual property rights</strong>
    <ul>
      <li>local laws, intellectual property</li>
    </ul>
  </li>
  <li><strong>Computer misuse</strong></li>
</ul>

<blockquote>
  <p><strong>ACM</strong>: Association for Computing Machinery
   <strong>IEEE</strong>: Institute of Electrical and Electronics Engineers</p>
</blockquote>

<p><strong>이 organization에서 정의한 ethical principles</strong></p>

<p>Ethical Principles에서 Colleagues, self가 중오</p>

<ul>
  <li><strong>Colleagues</strong>: Fair and Supportive</li>
  <li><strong>Self</strong>: Lifelong learning</li>
</ul>]]></content><author><name>채주완</name></author><category term="SKKU_SwEng" /><summary type="html"><![CDATA[Introduction]]></summary></entry><entry><title type="html">2softwareprocess</title><link href="https://joowan1108.github.io/skku_sweng/2SoftwareProcess/" rel="alternate" type="text/html" title="2softwareprocess" /><published>2026-10-16T00:00:00+00:00</published><updated>2026-10-16T00:00:00+00:00</updated><id>https://joowan1108.github.io/skku_sweng/2SoftwareProcess</id><content type="html" xml:base="https://joowan1108.github.io/skku_sweng/2SoftwareProcess/"><![CDATA[<h1 id="software-process">Software Process</h1>

<ul>
  <li><strong>Specification</strong>
    <ul>
      <li>Define functionality and constraints</li>
    </ul>
  </li>
  <li><strong>Developement</strong>
    <ul>
      <li>Produce software</li>
    </ul>
  </li>
  <li><strong>Validation</strong>
    <ul>
      <li>Checking the requirements</li>
      <li>Unit testing (False positive 문제 있음), System testing, Customer testing</li>
    </ul>
  </li>
  <li><strong>Evolution</strong>
    <ul>
      <li>Evolving</li>
    </ul>
  </li>
</ul>

<p>Software Process을 정의하기 위해서는 세 가지를 정의해야 한다.</p>

<ul>
  <li><strong>Product &amp; Deliverables</strong> : outcomes of activity</li>
  <li><strong>Roles</strong>: Responsiblities</li>
  <li><strong>Pre and Post conditions</strong>: Conditions that must hold before and after</li>
</ul>

<p>Pre condition으로 input specification이 정의된 것이 architectural design으로 들어가고 post condition으로 정의된 expected output이 나와야 한다.</p>

<p>Software process으로는 두 종류가 있다.</p>

<ul>
  <li><strong>In plan-driven processes</strong>
    <ul>
      <li>모든게 먼저 계획되어 있어야 함</li>
    </ul>
  </li>
  <li><strong>In agiles processes</strong>
    <ul>
      <li>계획이 incremental, continual하게 된다.</li>
    </ul>
  </li>
</ul>

<p>Large system은 이 두 process의 중간점을 가져야 한다.</p>

<h1 id="software-process-model">Software Process Model</h1>

<p>이런 software process 방법을 표현하기 위해 software process model을 사용한다.</p>

<ul>
  <li>Waterfall model
    <ul>
      <li>Scratch</li>
      <li>Process activities as separate process phases</li>
      <li>for plan driven</li>
    </ul>
  </li>
  <li>Incremental Development
    <ul>
      <li>Scratch</li>
      <li>Interleaving process activities</li>
      <li>for agile, series of versions</li>
    </ul>
  </li>
  <li>Integration and Configuration
    <ul>
      <li>Reusable software components</li>
    </ul>
  </li>
</ul>

<p>최근 large system들은 모든 모델의 elements을 조금씩 사용함</p>

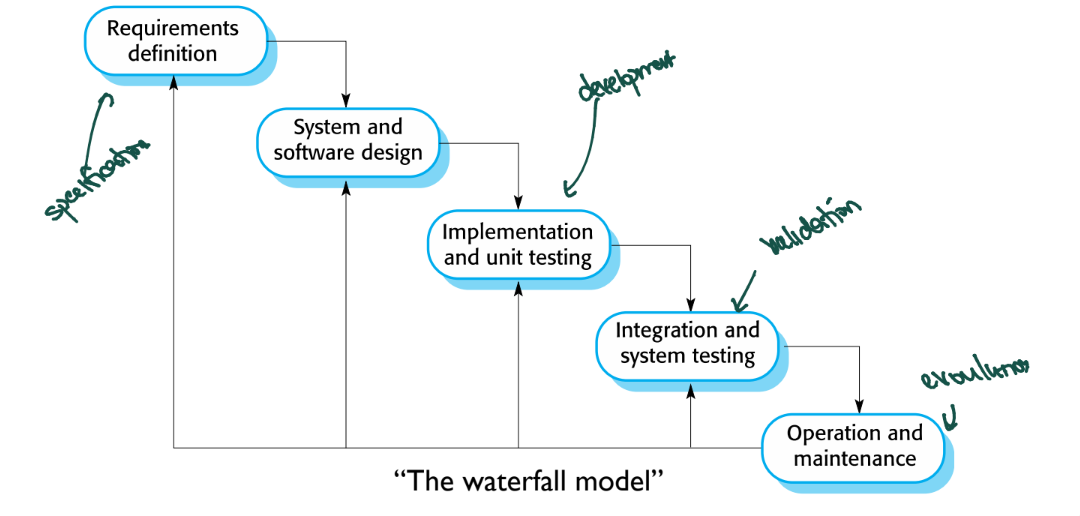
<h2 id="waterfall-model">Waterfall Model</h2>

<p>Planning all of process activies before starting</p>

<p>Direct하게 development activities reflect함</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure1.png" alt="joowan1108" /></p>

<p>Critical system / Embedded system에 적합</p>

<p>빠르게 변하는 상황에서는 별로임</p>

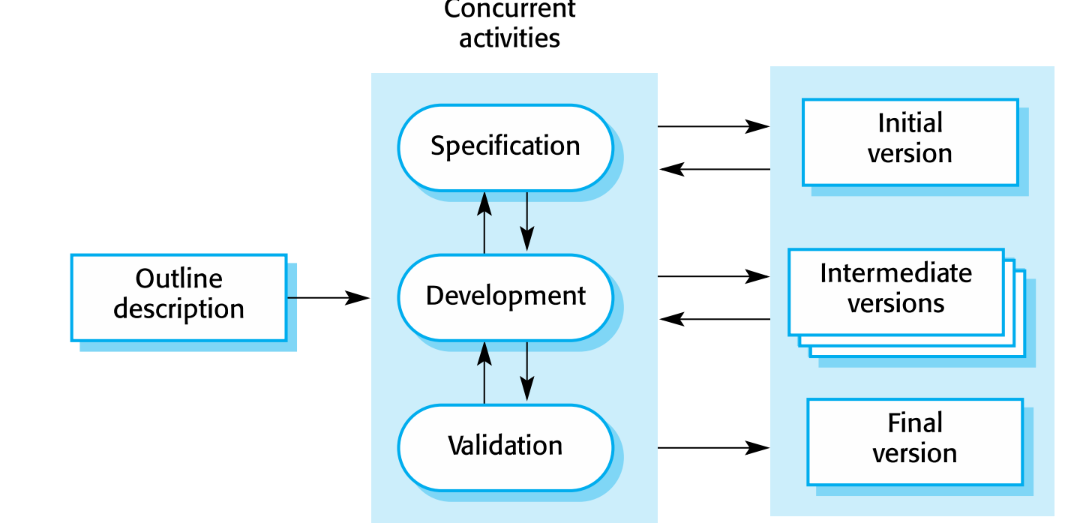
<h2 id="incremental-development">Incremental Development</h2>

<p>Interleaved</p>

<p>Initial implementation을 한 다음, feedback을 받고, evolving하는 과정을 반복한다</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure2.png" alt="joowan1108" /></p>

<p><strong>장점</strong></p>
<ul>
  <li>Cost of implementing changes is reduced
    <ul>
      <li>Waterfall model은 documentation까지도 바꿔야 하기 때문</li>
    </ul>
  </li>
  <li>Customer feedback을 받기 쉽다</li>
  <li>Deploy가 빠르다</li>
</ul>

<p><strong>단점</strong></p>
<ul>
  <li>Process is not visible
    <ul>
      <li>개발이 빠르게 진행되기 때문에 매 version마다 documents을 만드는게 어렵다. 따라서 progress을 알기 어렵다</li>
    </ul>
  </li>
  <li>Degrade 발생 가능
    <ul>
      <li>Messy code, 새로운 feature을 더 추가하는 것은 어려움</li>
      <li>따라서 refactor을 자주 해야함</li>
    </ul>
  </li>
</ul>

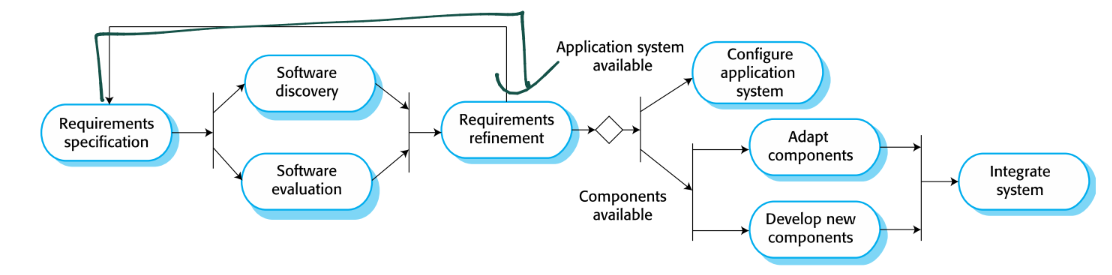
<h2 id="integration-and-configuration">Integration and Configuration</h2>

<p>이미 존재하는 reusable components을 재사용해서 integrating</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure3.png" alt="joowan1108" /></p>

<p>이 model에 중요한 key process들은 다음과 같다.</p>

<ul>
  <li>Requirements Specification
    <ul>
      <li>간단한 description을 포함</li>
    </ul>
  </li>
  <li>Software Discovery and Evaluation
    <ul>
      <li>존재하는 components 찾고 검증하는 과정</li>
    </ul>
  </li>
  <li>Requirements Refinement
    <ul>
      <li>찾은 components을 바탕으로 requirements refining</li>
    </ul>
  </li>
  <li>Application System Configuration
    <ul>
      <li>COTS을 변경</li>
      <li>COTS 가능할 때 (Commercial Off The Shelf application 있을 때)</li>
    </ul>
  </li>
  <li>Component Adaptation and Integration
    <ul>
      <li>Components을 변경</li>
      <li>COTS 없을 때</li>
    </ul>
  </li>
</ul>

<p><strong>장점</strong></p>
<ul>
  <li>Software develop에 드는 cost 줄이기</li>
  <li>Delivery 빠르게 하기</li>
</ul>

<p><strong>단점</strong></p>
<ul>
  <li>기존 소프트웨어에 맞는 요구사항을 타협해야 하기에 user의 실제 요구를 완벽하게 만족 못 할 수 있음</li>
  <li>Control over system evolution is lost : 사용한 reusable components을 조정할 수 없기에</li>
</ul>

<h1 id="software-process-activities">Software Process Activities</h1>

<p>Specification, development, validation, evolution</p>

<p>이 activities는 Software process model마다 다르다.</p>

<h2 id="1-software-specification">1. Software Specification</h2>

<p>== Requirements Engineering</p>

<p>Service의 requirements을 이해하고 정의하는 과정
Contraints을 정의하는 과정</p>

<ul>
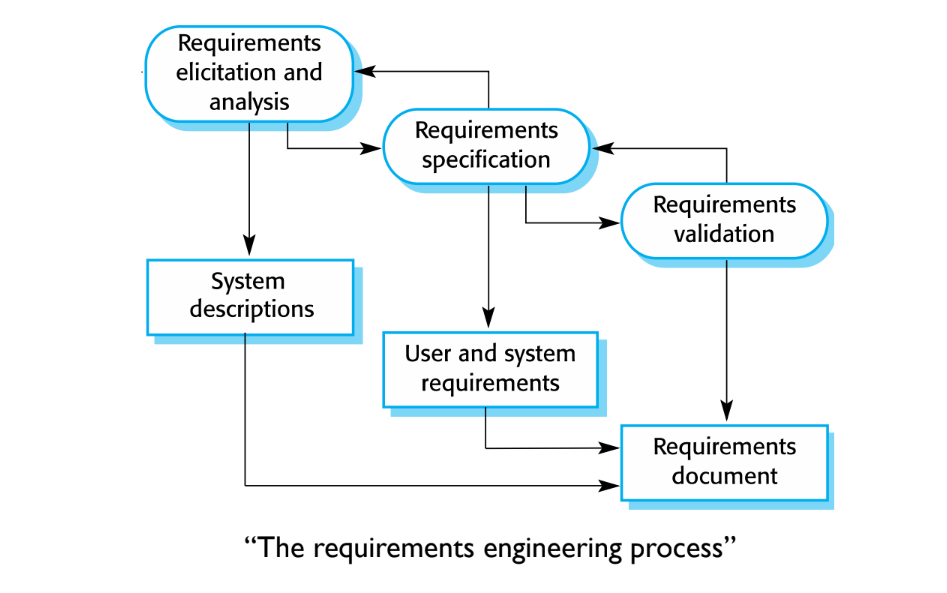
  <li><strong>Requirements elicitation and analysis</strong>
    <ul>
      <li>Observation과 discussions을 통해 requirements을 알아내기</li>
    </ul>
  </li>
  <li><strong>Requirements specification</strong>
    <ul>
      <li>얻은 정보를 document으로 정리하기</li>
    </ul>
  </li>
  <li><strong>Requirements validation</strong>
    <ul>
      <li>Requirements가 realism (실현 가능), consistency (모순적이지 않은지), completeness (빠짐없이 정의되어 있는지)을 만족하는지 확인</li>
    </ul>
  </li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure4.png" alt="joowan1108" /></p>

<h2 id="2-software-development">2. Software Development</h2>

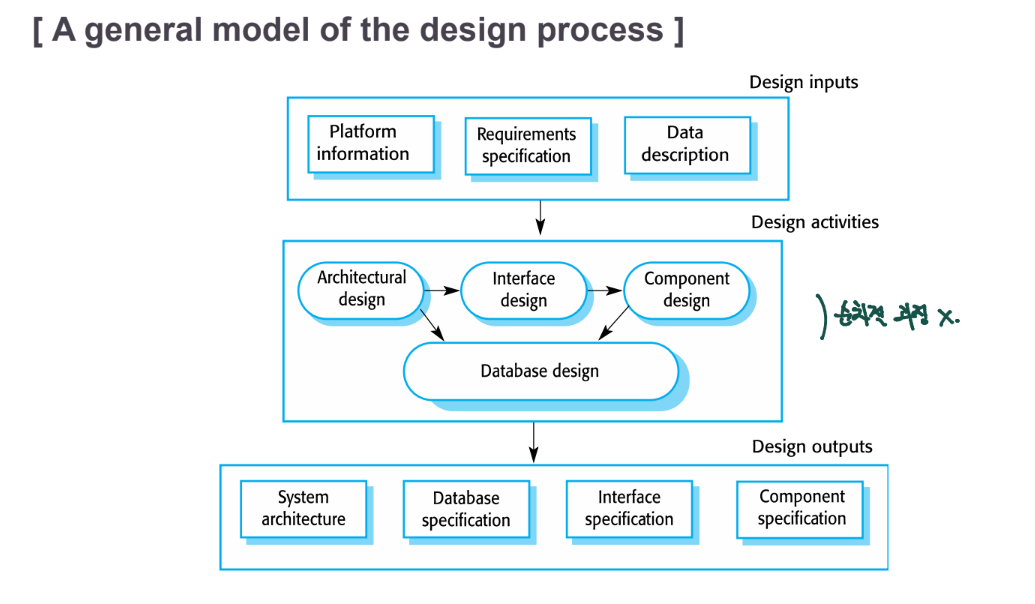
<p><strong>Software design activities</strong></p>

<ul>
  <li><strong>Architectural Design</strong>
    <ul>
      <li>전체 구조, 주요 components, relationships 정의</li>
    </ul>
  </li>
  <li><strong>Database Design</strong>
    <ul>
      <li>Datastructure 정의</li>
    </ul>
  </li>
  <li><strong>Interface Design</strong>
    <ul>
      <li>System component 간 interface 정의</li>
    </ul>
  </li>
  <li><strong>Compoenent Selection and Design</strong>
    <ul>
      <li>Resuable component 찾기 및 새로운 components 정의</li>
    </ul>
  </li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure5.png" alt="joowan1108" /></p>

<p><strong>Implementation</strong></p>

<p>Programming은 standard process 없이 하는 individual activity</p>

<p>Testing은 bug을 찾아내는거고 debugging은 bug가 어디있는지 찾고 수정하는 것</p>

<h2 id="3-software-validation">3. Software Validation</h2>

<p>System이 specification과 requirements을 만족하는지 확인하는 과정</p>

<p>모든 단계에서 수행된다</p>

<p>Requirements 확인보다 프로그램 testing에 더 큰 노력을 한다.</p>

<p>Testing에는 여러 state가 존재한다.</p>

<ul>
  <li><strong>Component Testing</strong>
    <ul>
      <li>Testing individual components</li>
    </ul>
  </li>
  <li><strong>System Testing</strong>
    <ul>
      <li>Entire system</li>
    </ul>
  </li>
  <li><strong>Customer Testing</strong>
    <ul>
      <li>Test data 말고 실제 customer가 test</li>
    </ul>
  </li>
</ul>

<p><strong>V-model</strong>은 plan driven software process을 위한 testing model이다. 각 단계마다 미리 어떻게 test을 할 것인지 미리 정의한다. Link between testing and development activities</p>

<h2 id="4-software-evolution">4. Software Evolution</h2>

<p>Software에서 development와 maintenance을 분리하는 것은 점점 모호해진다.</p>

<p>Software에서 change는 cost을 유발하는데 이 cost을 최소화하는 것은 두 방법이 있다.</p>

<ul>
  <li><strong>Change Anticipation</strong>
    <ul>
      <li>변경사항을 예측하고 구현 : Prototype</li>
    </ul>
  </li>
  <li><strong>Change Tolerance</strong>
    <ul>
      <li>쉽게 수정될 수 있도록 설계 : Incremental Delivery</li>
    </ul>
  </li>
</ul>

<p>Change에 유연해지도록 하는 두 방법</p>

<ul>
  <li><strong>Prototyping</strong>
    <ul>
      <li>Early version of software to demonstrate concepts</li>
      <li>장점
        <ul>
          <li>Potential users가 사용할 수 있게 해서 system이 자기 requirements을 만족하는지 보기 가능</li>
          <li>Errors와 omissions을 파악하기 가능</li>
          <li>변한 것을 바로 반영 가능</li>
          <li>User interface을 개발하기 위한 유일한 방법</li>
        </ul>
      </li>
      <li>단점
        <ul>
          <li>Final system과 prototype은 다름</li>
          <li>Prototype tester는 실제 user와 다름</li>
        </ul>
      </li>
      <li>Prototype을 개발할 때는 중요한 점
        <ul>
          <li>필요한 것만 남기기</li>
          <li>Non functional requirements는 고려하지 않기</li>
          <li>Error handling은 고려하지 않기</li>
        </ul>
      </li>
    </ul>
  </li>
  <li><strong>Incremental Delivery</strong>
    <ul>
      <li>중간에 완성된 기능들을 보고하기</li>
      <li>이때 각 increment가 실제 가치를 지녀야함</li>
      <li>장점
        <ul>
          <li>중간에 추가되는 기능들을 통해 prototype을 또 구성할 수 있고 더 testing 가능</li>
          <li>User가 기다리지 않아도 된다</li>
          <li>가장 중요한 system이 가장 많은 testing을 받는다</li>
        </ul>
      </li>
      <li>단점
        <ul>
          <li>새로운 system으로 바꿀 때 user는 이전 system의 기능까지도 필요로 한다.
            <ul>
              <li>기존 system을 사용하던 user는 모든 기능이 가능하길 원하지만 incremental delivery는 그게 불가능함</li>
            </ul>
          </li>
          <li>Requirements가 자세히 defined 되지 않았기 때문에 increment가 공통적으로 필요로 하는 설계가 나중에 완성된다.</li>
        </ul>
      </li>
    </ul>
  </li>
</ul>

<blockquote>
  <p>Process Improvement: 기존 process을 바꿔서 효율을 높이는 것</p>

  <p>방법 1: Process maturity approach : Process와 project management 향상</p>

  <p>방법 2: Agile Approach : 반복적인 development와 개발 overhead 줄이기</p>
</blockquote>]]></content><author><name>채주완</name></author><category term="SKKU_SwEng" /><summary type="html"><![CDATA[Software Process]]></summary></entry><entry><title type="html">3agilesoftwaredevelopment</title><link href="https://joowan1108.github.io/skku_sweng/3AgileSoftwareDevelopment/" rel="alternate" type="text/html" title="3agilesoftwaredevelopment" /><published>2026-10-16T00:00:00+00:00</published><updated>2026-10-16T00:00:00+00:00</updated><id>https://joowan1108.github.io/skku_sweng/3AgileSoftwareDevelopment</id><content type="html" xml:base="https://joowan1108.github.io/skku_sweng/3AgileSoftwareDevelopment/"><![CDATA[<p>Software system을 개발할 때의 문제는 빠른 배포를 할 것인가 소프트웨어의 품질을 좋게 할 것인가이다.</p>

<p>Software process 중 Plan Driven method는 소프트웨어의 품질을 좋게 하는 방법론인 반면 빠른 처리가 중요한 환경에서는 Agile method가 유리하다.</p>

<h1 id="agile-development">Agile Development</h1>

<p>Program specification, design, implementation이 모두 interleave 되어있다. System specification을 간단화하고 documentation을 최소화하였다.</p>

<p>개발은 series of versions / increments으로 되어있고 stakeholder는 later version을 위한 new requirements을 제안한다.</p>

<p>빠른 일처리를 위해서 자동화된 test tool처럼 Extensive tool support도 필요하다.</p>

<p>Plan driven approach에서는 iteration은 within activities에서 진행되고 activities끼리는 진행되지 않는다. Agile approach에서는 activity끼리도 iteration이 진행된다는 차이가 있다.</p>

<p>따라서 agile approach는 software에만 집중을 하고 evolving도 빠르게 한다.</p>

<h2 id="principles-of-agile-development">Principles of Agile Development</h2>

<ul>
  <li>Customer Involvement
    <ul>
      <li>Customer들이 development에 많은 관여를 한다</li>
    </ul>
  </li>
  <li>Incremental Delivery
    <ul>
      <li>Increments으로 개발</li>
    </ul>
  </li>
  <li>Embrace Change
    <ul>
      <li>Expect to change</li>
      <li>System design 자체가 변화에 유연함</li>
    </ul>
  </li>
  <li>Maintain Simplicity
    <ul>
      <li>간단함을 유지</li>
    </ul>
  </li>
  <li>People, not process
    <ul>
      <li>자기에게 맞는 방법으로 스스로 개발</li>
    </ul>
  </li>
</ul>

<h2 id="agile-개발-방법론-extreme-programming">Agile 개발 방법론: Extreme Programming</h2>

<p>Iterative development to extreme levels</p>

<p>Several versions of system are developed, integrated, and tested in a day</p>

<p>Extreme Programming에서 수행하는 practices에는 10가지가 있다. 이때 company들은 선택적으로 사용한다.</p>

<p><strong>Extreme Programming Practices</strong></p>

<ul>
  <li>Collective ownership
    <ul>
      <li>work on all areas</li>
      <li>take responsibility for all of the code</li>
    </ul>
  </li>
  <li>Continuous integration
    <ul>
      <li>Integrated to whole system</li>
      <li>그 다음에는 unit tests가 pass 해야 함</li>
    </ul>
  </li>
  <li>Incremental planning
    <ul>
      <li>Requirements는 그때그때 남은 시간마다 달라짐 + relative priority</li>
    </ul>
  </li>
  <li>On-site customer
    <ul>
      <li>customer가 development team에 참여해서 requirements 알려줌</li>
    </ul>
  </li>
  <li>Pair programming
    <ul>
      <li>Work in pairs</li>
    </ul>
  </li>
  <li>Refactoring
    <ul>
      <li>Code simpler</li>
    </ul>
  </li>
  <li>Simple Design
    <ul>
      <li>meet current requirements only</li>
    </ul>
  </li>
  <li>Small releases
    <ul>
      <li>최소한의 유용한 기능 먼저</li>
    </ul>
  </li>
  <li>Sustainable pace
    <ul>
      <li>야근 x</li>
    </ul>
  </li>
  <li>Test first development
    <ul>
      <li>Implementation보단 test을 먼저 작성함</li>
    </ul>
  </li>
</ul>

<p><strong>User Story</strong></p>

<p>이때 requirements을 짧게, 이해하기 쉽게 정의하기 위해서 user story을 사용한다.</p>

<p>User가 system을 사용하면서 경험할 법한 story card을 통해 customer needs을 전달한다.</p>

<p>이 story card는 여러 task으로 분해</p>

<p>각 task마다 필요한 effort와 resources을 계산</p>

<p>Story들을 business support usefulness을 바탕으로 우선순위 정하기</p>

<p>$\rightarrow$ 이해하기는 쉽지만 불완전하다</p>

<p><strong>Test first development</strong></p>

<p>Test가 implementation보다 먼저여야 하기에 test development도 incremental하다</p>

<p>Test development에 user도 involve한다. 그리고 automated test framework (tool)도 사용한다. (Agile을 위해서)</p>

<p>ex) 일회분 분량 check task에 대한 test 작성한다고 하자</p>

<p>Single dose of drug는 몇 mg으로 구성되는지 그리고 이 dose을 하루에 몇번 받는지가 input이라고 하자.</p>

<p>Test case:  총 4개임 If else statement가 4개이므로 (조건 2개 : 가능성 $2^2$)</p>

<ol>
  <li>Dose의 양은 맞더라도 frequency가 너무 빠르거나 느린지 확인</li>
  <li>Frequency는 맞더라도 dose 양이 너무 높거나 낮은지</li>
  <li>Dose와 frequency가 위험한 범위인지</li>
  <li>Dose와 frequency가 모두 정당한 범위인지</li>
</ol>

<p>Test first development의 문제점</p>

<ul>
  <li>Test을 제대로 작성하지 않음 (short cut)\</li>
  <li>Test는 increment하게 작성하기 어려움</li>
  <li>Test가 complete coverage을 하는지 판단하기 어려움 (기준은 100% branch &lt; 100% path)</li>
</ul>

<p><strong>Pair Programming</strong></p>

<p>Pairs는 dynamic하게 구성되며 모든 team member가 다른 사람과 같이 일을 함</p>

<p>장점</p>
<ul>
  <li>Collective ownership and responsibility</li>
  <li>Informal review</li>
  <li>Encourage refactoring</li>
</ul>

<p>실험 결과</p>
<ul>
  <li>시간 오래 걸리지만 test pass 높음</li>
  <li>만족도 높음</li>
  <li>Code 수 적음 (refactor)</li>
</ul>

<h2 id="agile-project-management-scrum">Agile Project Management: Scrum</h2>

<p>Agile의 informal planning과 project control은 너무 빠르게 변하기에 visibility가 없다는 단점이 있다. 즉, 진행 상황을 파악하기 어려움</p>

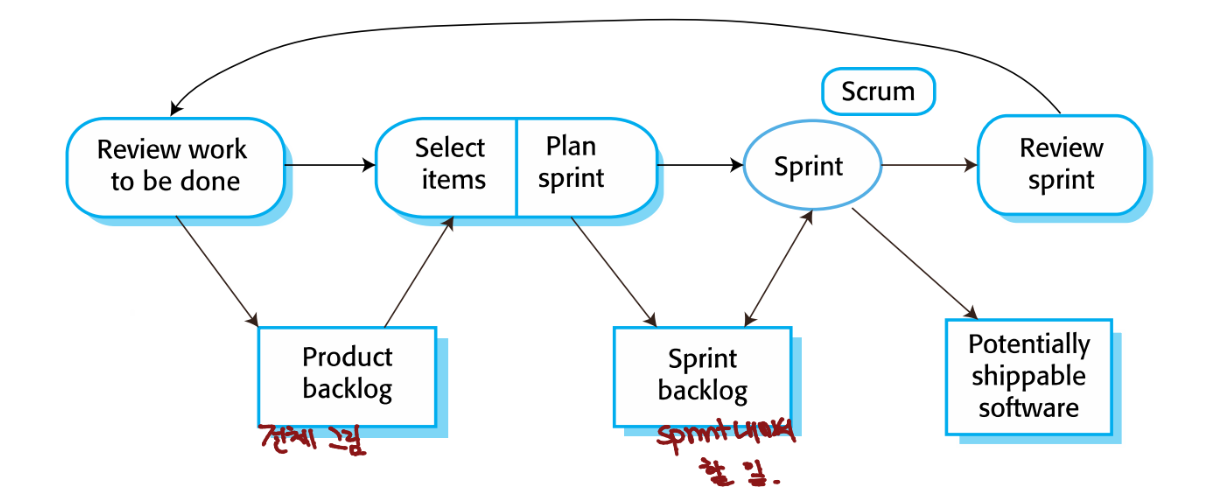
<p>이를 알아내기 위해서 scrum이라는 방법론이 사용된다. Scrum은 새로운 terminology을 사용해서 구별해서 사용한다.</p>

<p><strong>Scrume Terminology</strong></p>

<ul>
  <li>Development team
    <ul>
      <li>7명 이하로 이뤄진 self organizing group</li>
    </ul>
  </li>
  <li>Sprint
    <ul>
      <li>development iteration (2~4 weeks)</li>
    </ul>
  </li>
  <li>Scrum
    <ul>
      <li>Daily meeting: progress와 우선순위 작업 설정</li>
    </ul>
  </li>
  <li>Scrum Master
    <ul>
      <li>Project manager와 비슷</li>
      <li>다른 사람들과 interface</li>
    </ul>
  </li>
  <li>Product backlog
    <ul>
      <li>To do list</li>
    </ul>
  </li>
  <li>Product owner
    <ul>
      <li>요구사항 알아내기</li>
      <li>Backlog을 보고 요구사항과 맞는지 확인</li>
      <li>Customer / Product manager 등이 될 수 있음</li>
    </ul>
  </li>
  <li>Velocity
    <ul>
      <li>작업 처리 속도</li>
      <li>backlog을 하나의 sprint에서 얼만큼 처리할 수 있는지</li>
    </ul>
  </li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure6.png" alt="joowan1108" /></p>

<p>Sprints는 절대 연장되지 않고 끝나지 않은 일은 다시 backlog으로 돌아간다</p>

<p>Scrum board는 team간의 daily interactions을 보여준다</p>

<h1 id="scaling-agile-methods">Scaling Agile Methods</h1>

<p><strong>장점</strong></p>
<ul>
  <li>Product가 이해가 가능한 수준으로 분해되기에 stakeholder들도 감당 가능하다</li>
  <li>요구사항 불완전해도 progress가 멈추지 않음</li>
  <li>전체 team이 visibility을 가진다 (Agile의 visibility의 문제를 해결한다)</li>
  <li>Customer는 시간에 따른 increments을 갖고 feedback을 줄 수 있다</li>
  <li>Trust</li>
</ul>

<p><strong>Agile method 자체의 단점</strong></p>
<ul>
  <li>Agile은 우선 small / medium sized system에만 사용된다는 전제를 갖고 있다.</li>
  <li>Informality 때문에 contractual issue 발생 가능</li>
  <li>Agile은 new development에만 유용함</li>
  <li>Development가 worldwide 하게 distributed 되었을 때는 agile이 더 어려워짐</li>
</ul>

<p><strong>Maintenance에서 Agile method 자체의 단점</strong></p>
<ul>
  <li>Product documentation 부족</li>
  <li>Agile team이 분해되면 documentation으로 기록을 안 해두기 때문에 implicit knowledge가 아예 없어짐</li>
  <li>Customer을 계속 참여시키는게 어려움</li>
</ul>

<p><strong>Agile methods for large systems</strong></p>

<p>Agile이 large system에 사용되기 위해서는 개선이 필요하다.</p>

<p><strong>그럼 large scale system을 복잡하게 만드는 factor는 무엇인가</strong></p>

<ul>
  <li>System of systems
    <ul>
      <li>개별적인 team이 서로 다른 환경에서 개발을 하기 때문에 전체 system의 view는 파악이 어려움</li>
    </ul>
  </li>
  <li>Brownfield development
    <ul>
      <li>이미 존재하는 system을 사용함</li>
    </ul>
  </li>
  <li>System configuration
    <ul>
      <li>실제 개발보다는 system configuration에 맞춰져 있음</li>
    </ul>
  </li>
  <li>Regulatory constraints
    <ul>
      <li>규칙으로 개발 방식이 제한됨</li>
    </ul>
  </li>
  <li>Prolonged procurement
    <ul>
      <li>팀 유지 어려움</li>
    </ul>
  </li>
  <li>Diverse stakeholders
    <ul>
      <li>다양한 stakeholder들을 참여시키는 것은 어려움</li>
    </ul>
  </li>
</ul>

<p><strong>Agile method을 large system에 적용할 때 고려해야 하는 것</strong></p>

<ul>
  <li>완전한 incremental approach는 불가능함</li>
  <li>한 명의 product owner는 불가능함</li>
  <li>코드에만 집중하는 것은 어려움: documentation도 해야 함</li>
  <li>Cross team communication을 통해 team 간 visibility 얻어야 함</li>
  <li>변화가 있을 때마다 전체 system에 반영시키는 것은 어려움</li>
</ul>

<p><strong>Agile for Large System : Multi-team Scrum</strong></p>

<ul>
  <li>Role replication
    <ul>
      <li>각 team에 product owner와 scrum master 설정</li>
    </ul>
  </li>
  <li>Product architects
    <ul>
      <li>각 team은 product architect을 선정하고 이 architect들끼리 협업하여 overall system architecture을 구축함</li>
    </ul>
  </li>
  <li>Release alignment
    <ul>
      <li>Product release 날짜들을 일치</li>
    </ul>
  </li>
  <li>Scrum of Scrums
    <ul>
      <li>각 team의 대표들끼리 scrum을 진행해서 진행 사항을 공유함</li>
    </ul>
  </li>
</ul>]]></content><author><name>채주완</name></author><category term="SKKU_SwEng" /><summary type="html"><![CDATA[Software system을 개발할 때의 문제는 빠른 배포를 할 것인가 소프트웨어의 품질을 좋게 할 것인가이다.]]></summary></entry><entry><title type="html">4requirementengineering</title><link href="https://joowan1108.github.io/skku_sweng/4RequirementEngineering/" rel="alternate" type="text/html" title="4requirementengineering" /><published>2026-10-16T00:00:00+00:00</published><updated>2026-10-16T00:00:00+00:00</updated><id>https://joowan1108.github.io/skku_sweng/4RequirementEngineering</id><content type="html" xml:base="https://joowan1108.github.io/skku_sweng/4RequirementEngineering/"><![CDATA[<h1 id="requirement-engineering">Requirement Engineering</h1>

<ul>
  <li>Requirement
    <ul>
      <li>System이 제공해야 하는 service의 descriptions과 constraints</li>
      <li>User requirements는 abstract한 service / constraint</li>
      <li>System requirements는 detailed한 formal definition</li>
    </ul>
  </li>
  <li>Requirement Engineering
    <ul>
      <li>Service와 constraints을 finding out, analyzing, documenting, checking 하는 과정</li>
      <li>Software Engineering process의 첫 단계</li>
    </ul>
  </li>
</ul>

<p>User와 System은 알아야 하는 정보, 이해하는 정보가 다르기 때문에 user쪽은 abstract한 것만 알면 되고 system은 detailed한 것까지 알아야 함</p>

<p>Stakeholder란 system에 어떻게든 영향을 받는 사람인데 이들은 system에 영향을 주면서 요구는 모두 다르다</p>

<p>System requirements에는 두 종류가 있다.</p>

<ul>
  <li>Functional requirements
    <ul>
      <li>System이 제공해야 하는 statements (input / output)</li>
      <li>System이 하면 안 되는 일</li>
    </ul>
  </li>
  <li>Non-functional requirements
    <ul>
      <li>Service의 constraint (responsiveness 등)</li>
      <li>전체 system의 constraints</li>
    </ul>
  </li>
</ul>

<p>하지만 이 둘의 구분은 정의만 봤을 때는 어렵다.</p>

<blockquote>
  <p>A statement limiting access to authorized users</p>
  <ul>
    <li>functional 관점: 승인되지 않은 사용자에게 기록을 보여주지 않는다</li>
    <li>Non functional 관점: 시스템은 보안 정책을 충족해야 한다</li>
  </ul>
</blockquote>

<h2 id="functional-requirements">Functional Requirements</h2>

<p>functional requirements는 general하거나 specific 하다.</p>

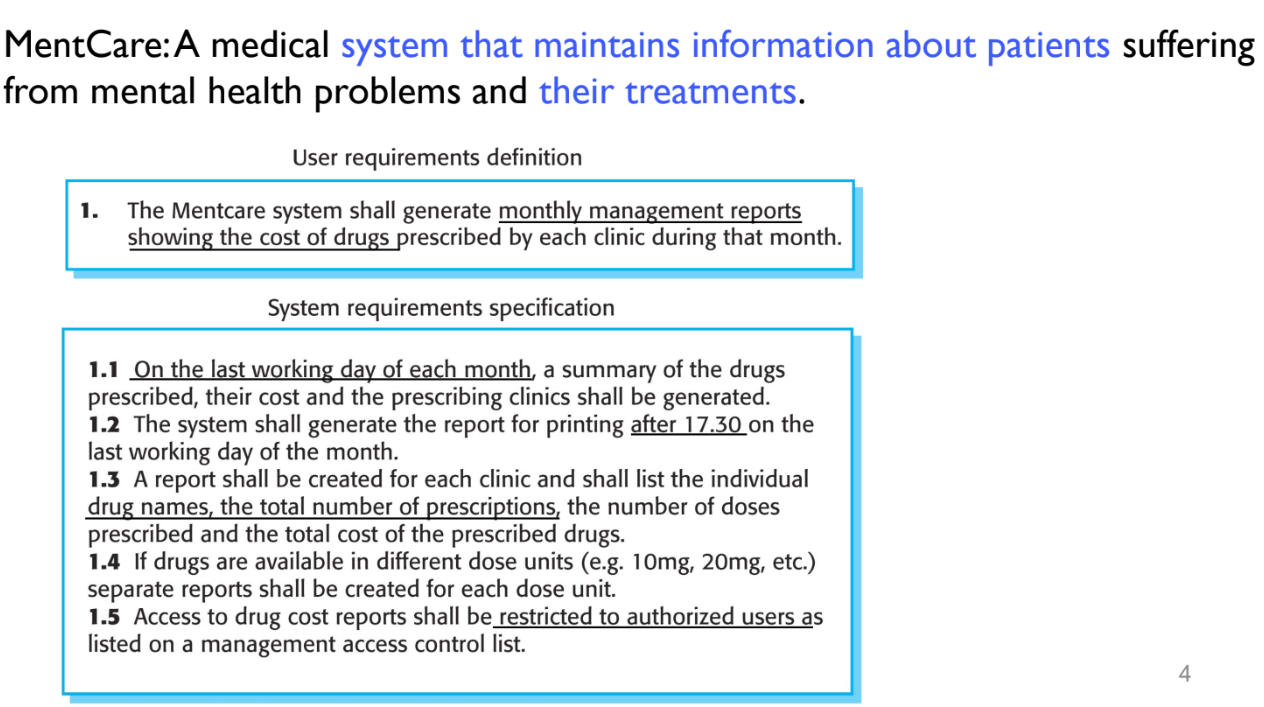
<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure7.png" alt="joowan1108" /></p>

<p>이 서비스에서 functional requirements의 예시는 다음과 같다.</p>
<ol>
  <li>User is able to search the appointments lists for all clinics</li>
  <li>각 clinic과 날짜마다 예약된 환자 명단을 생성해야 한다</li>
  <li>각 staff는 employee number로 identified 되어야 한다.</li>
</ol>

<p>functional requirements의 <strong>단점</strong>은 imprecision, 불명확하다.</p>

<ul>
  <li>이 불명확함은 developer와 customer의 이해도에 영향을 줄 수 있다</li>
  <li>System delivery가 늦어질 수 있고 cost도 높아질 수 있다.</li>
</ul>

<p>ex) User is able to search the appointments lists for all clinics</p>

<ul>
  <li>모든 clinic에서의 모든 예약에서 이름으로 검색</li>
  <li>User가 참여한 clinic에서 이름을 검색</li>
</ul>

<p>$\rightarrow$ 불명확함</p>

<p>따라서 이상적인 functional requirements는 두 특징을 가져야 한다.</p>

<ul>
  <li>Completeness: User가 요구하는 모든 service가 정의되어 있어야 한다</li>
  <li>Constistency: 요구사항들이 모순되면 안된다</li>
</ul>

<p>하지만 large system에서는 stake holders가 많고 실수가 생기기 때문에 이 두 특징을 갖기 어렵다</p>

<h2 id="non-functional-requirements">Non Functional Requirements</h2>

<ul>
  <li>시스템 전체의 특징에 constrain을 건다
    <ul>
      <li>ex) response time, memory use, reliability</li>
    </ul>
  </li>
  <li>Non functional requirements가 individual function requirements보다 더 큰 영향을 준다
    <ul>
      <li>Non functional requirements가 안 맞으면 전체 시스템의 사용 가능성에 더 큰 영향을 준다</li>
    </ul>
  </li>
  <li>Non functional requirements는 user needs으로부터 나온다</li>
</ul>

<p><strong>Types of non-functional requirements</strong></p>

<ul>
  <li>Product requirements
    <ul>
      <li>Runtime behavior of software</li>
      <li>execution speed, memory usage, 등등</li>
    </ul>
  </li>
  <li>Organizational requirements
    <ul>
      <li>Organization에서부터 오는 정책으로 인한 requirements</li>
      <li>프로그래밍 언어, process standard 등</li>
    </ul>
  </li>
  <li>External requirements
    <ul>
      <li>System 외부 factor</li>
      <li>법을 생각하면 된다</li>
    </ul>
  </li>
</ul>

<p>ex) Mentcare System의 non functional requirements</p>

<p>Product requirement</p>
<ul>
  <li>정상 근무 시간에는 작동을 해야 하며 작동하지 않는 시간은 5초를 초과하면 안된다</li>
</ul>

<p>Organizational requirement</p>
<ul>
  <li>Identity card을 통해 접근이 가능해야 한다. (Customer’s organization policy)</li>
</ul>

<p>External requirement</p>
<ul>
  <li>HStan-03-2006-priv에 명시된 환자 개인정보 보호 규정을 구현</li>
</ul>

<p><strong>Non functional requirements의 문제</strong></p>

<p>Stakeholder들은 requirements을 general하게 표현한다. ex) 사용하기 쉬운, 반응이 빠른..</p>

<p>예를 들어 The system should be easy to use by medical staff and should be organized in such a way that user errors are minimized.</p>

<p>–&gt; User errors are minimized는 너무 general하고 구체적인 수치가 제공되지 않는다</p>

<p>이를 해결하기 위해서 이런 요구 사항들을 <strong>testable</strong> 으로 바꿔야 한다.
ex) 평균 error 발생이 시간당 두개를 넘으면 안된다</p>

<p>즉, non functionasl requirements을 수치적으로 testable하게 작성해야 한다. 그리고 customer의 goal을 측정 가능한 requirements으로 바꿔야 한다. 이때 측정 property는 speed, size, ease of use, reliability, portability 등이 있다.</p>

<h2 id="requirements-engineering-key-activities">Requirements Engineering Key Activities</h2>

<p>어떻게 functional / non functional requirements을 알아내고 문서화하고 검증할 것인가</p>

<ul>
  <li>Elicitation and analysis
    <ul>
      <li>Stakeholder와 상호작용해서 requirements 얻기</li>
    </ul>
  </li>
  <li>Specification
    <ul>
      <li>Requirements을 documentation 하기</li>
    </ul>
  </li>
  <li>Validation
    <ul>
      <li>Requirements가 제대로 되어있는지 확인하기</li>
    </ul>
  </li>
</ul>

<p>Requirements Engineering은 iterative하고 interleaved 되어있다. (Spiral)</p>

<h3 id="elicitation">Elicitation</h3>

<p>Stakeholder가 하는 일을 이해하고 이 일을 어떻게 도울 것인가를 이해하기</p>

<p>이때 문제는 다음과 같다</p>

<ul>
  <li>Stakeholder들이 SW system으로부터 무엇을 정말 원하는지 모른다</li>
  <li>Stakeholder의 domain 단어들로 설명한다</li>
  <li>Stakeholder마다 요구사항이 다르다</li>
  <li>Political factors가 관여한다</li>
  <li>Requirements가 dynamic하게 바뀐다.</li>
</ul>

<p><strong>Requirements discovery and understanding</strong></p>

<ul>
  <li>Stakeholder와 상호작용</li>
</ul>

<p><strong>Requirements classification and organization</strong></p>

<ul>
  <li>관련된 requirements을 묶고 clustering하기</li>
</ul>

<p><strong>Requirements prioritization and negotation</strong></p>

<ul>
  <li>Requirement 들에 우선순위를 매기고 conflict 해결하기</li>
</ul>

<p><strong>Requiremnts documentation</strong></p>

<ul>
  <li>Documenting</li>
</ul>

<p>Elicitation을 하기 위해서 보통 두 가지 방법을 사용한다</p>

<ul>
  <li>Interviewing
    <ul>
      <li>Stakeholder와 대화</li>
      <li>Closed interview
        <ul>
          <li>미리 알려준 질문 대답</li>
        </ul>
      </li>
      <li>Open interview
        <ul>
          <li>알려지지 않은 질문 대답</li>
        </ul>
      </li>
    </ul>
  </li>
  <li>Observation or Ethnography
    <ul>
      <li>직접 일하는 것을 관찰하기</li>
    </ul>
  </li>
</ul>

<p>하지만 interviewing을 통해 정보를 알기가 어렵다</p>

<ul>
  <li>
    <p>domain specific term들을 사용하고</p>
  </li>
  <li>
    <p>자기의 knowledge을 설명하기도 어렵고</p>
  </li>
  <li>
    <p>fundamental knowledge을 빼먹을 수도 있다.</p>
  </li>
</ul>

<p>Interviewing을 보완하기 위한 방법이 Stories and Scenarios이다.</p>

<p><strong>Stories and Scenarios</strong></p>

<p>특정 task을 위해서 system이 어떻게 활용될 수 있는지에 대한 설명</p>

<ul>
  <li><strong>Stories</strong>: narrative text for <strong>High level</strong> description of system use</li>
  <li><strong>Scenarios</strong>: <strong>specific</strong> information collected such as inputs and outputs</li>
</ul>

<p>Discussion을 쉽게 도와주고 starting point가 된다.</p>

<p>Story는 어떻게 보면 사용 맥락이고 scenario는 user story의 구조화된 버전이다.</p>

<p>Scenario의 특징</p>

<ul>
  <li>Scenario가 시작하는 지점 (initialization state)에 대한 설명</li>
  <li>normal flow의 description</li>
  <li>what can go wrong의 description</li>
  <li>동시에 실행되는 다른 activity의 정보</li>
  <li>Scenario가 끝나는 지점에 대한 설명</li>
</ul>

<h3 id="requirement-specification">Requirement Specification</h3>

<p>User와 system requirements을 문서화하는 단계</p>

<p>User requirements는 natural language으로 적혀있고  end-user가 이해하기 쉽다</p>

<p>System requirements는 user requirements의 확장 버전으로 implementation에 사용되는 contract이다.</p>

<p>이때 system requirements을 작성하기 위해서는 다양한 방법을 사용할 수 있다.</p>

<ul>
  <li>Natural language
    <ul>
      <li>Numbered sentence 사용</li>
      <li>각 sentence마다 하나의 requirement만 담는다</li>
      <li>가장 많이 사용되지만 ambiguous하다</li>
      <li>highlighting을 사용해야 한다.</li>
      <li>필수와 필수 아닌것을 구분</li>
      <li>Assume 금지</li>
      <li>근거를 작성해라 (<strong>rationale</strong>) : 10분마다 insulin을 측정해라만 적지말고 이유까지 : 자주 측정하는건 의미가 없다 혈당은 느리게 변한다</li>
    </ul>
  </li>
  <li>Structured natural language
    <ul>
      <li>Template에 적혀있다</li>
      <li>각 field는 requirement의 한 aspect을 담는다</li>
      <li>함수 / entity의 description</li>
      <li>input output description</li>
      <li>수행해야 하는 action, precondition + post condition</li>
      <li>side effects 적기</li>
      <li>예시로 tabular specifications가 있다
        <ul>
          <li>Alternative situation이 존재할 때 (conditions가 많을 때) 효과적이다</li>
          <li>상황마다 적용해야 하는 수식이 존재할 때도 효과적이다</li>
        </ul>
      </li>
    </ul>
  </li>
  <li>Graphical notations
    <ul>
      <li>Functional requirements을 담는다</li>
      <li>UML use case와 sequence diagram이 사용된다</li>
      <li>Use case는 user와 system 간의 interactions을 정의한다.</li>
    </ul>
  </li>
  <li>Mathematical specification
    <ul>
      <li>Finite state machines가 사용된다.</li>
      <li>Unambiguous는 없어지지만 customers가 이해하기는 어렵다</li>
    </ul>
  </li>
</ul>

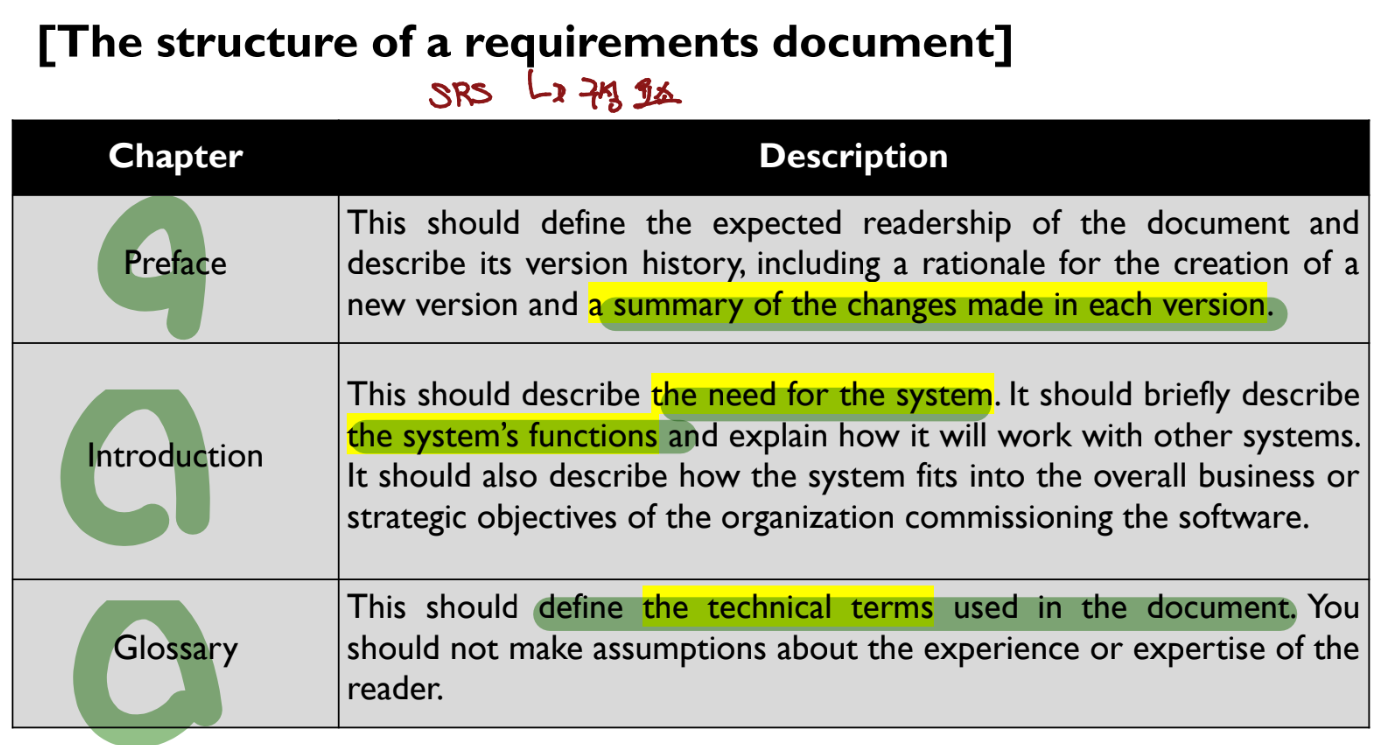
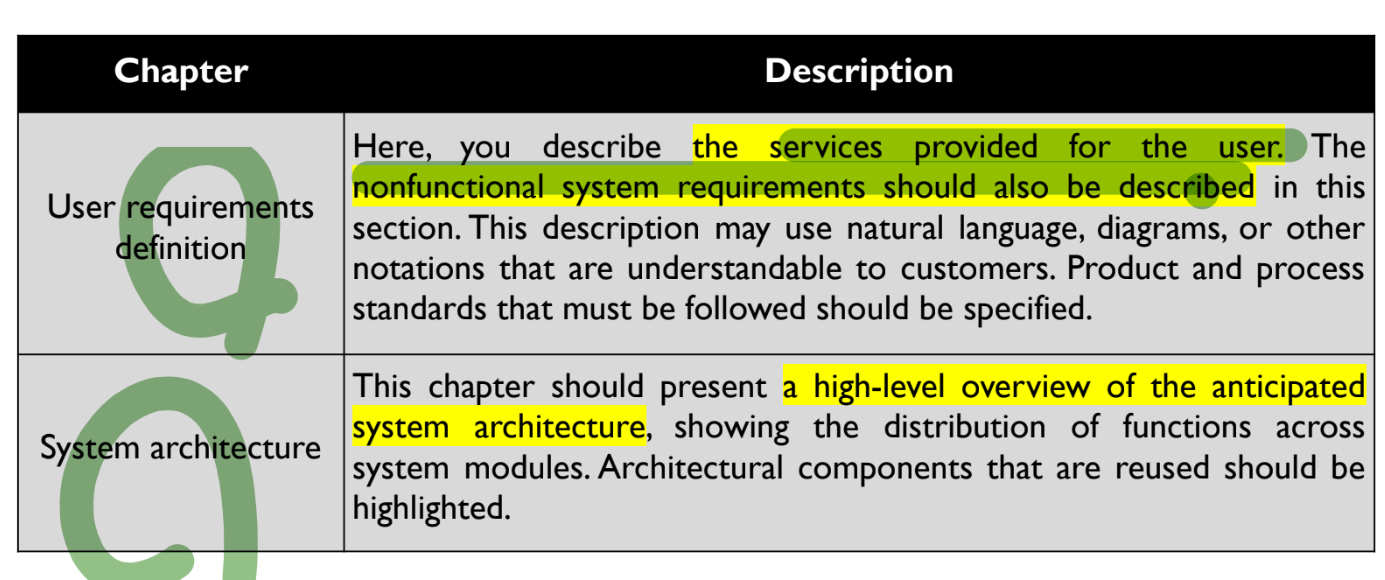
<p>요구사항들을 다 정리한 document을 <strong>SRS: Software Requirements Document</strong>이라고 부른다</p>

<p>Offical statement of what system developers should implement</p>

<p>User와 system requirements을 모두 포함</p>

<p>User가 다양하다</p>

<ul>
  <li>System Customers
    <ul>
      <li>Requirements을 정의하고 needs와 맞는지 확인할 때 사용</li>
    </ul>
  </li>
  <li>Managers
    <ul>
      <li>Development process을 미리 계획할 때 사용</li>
    </ul>
  </li>
  <li>System engineers
    <ul>
      <li>Requirements을 사용해서 무슨 system을 구현하고자 하는지 이해할 때 사용</li>
    </ul>
  </li>
  <li>System Test engineers
    <ul>
      <li>Requirements을 통해 validation test 생성</li>
    </ul>
  </li>
  <li>System Maintenance engineers
    <ul>
      <li>System을 이해하고 parts들이 주고받는 relationship 이해</li>
    </ul>
  </li>
</ul>

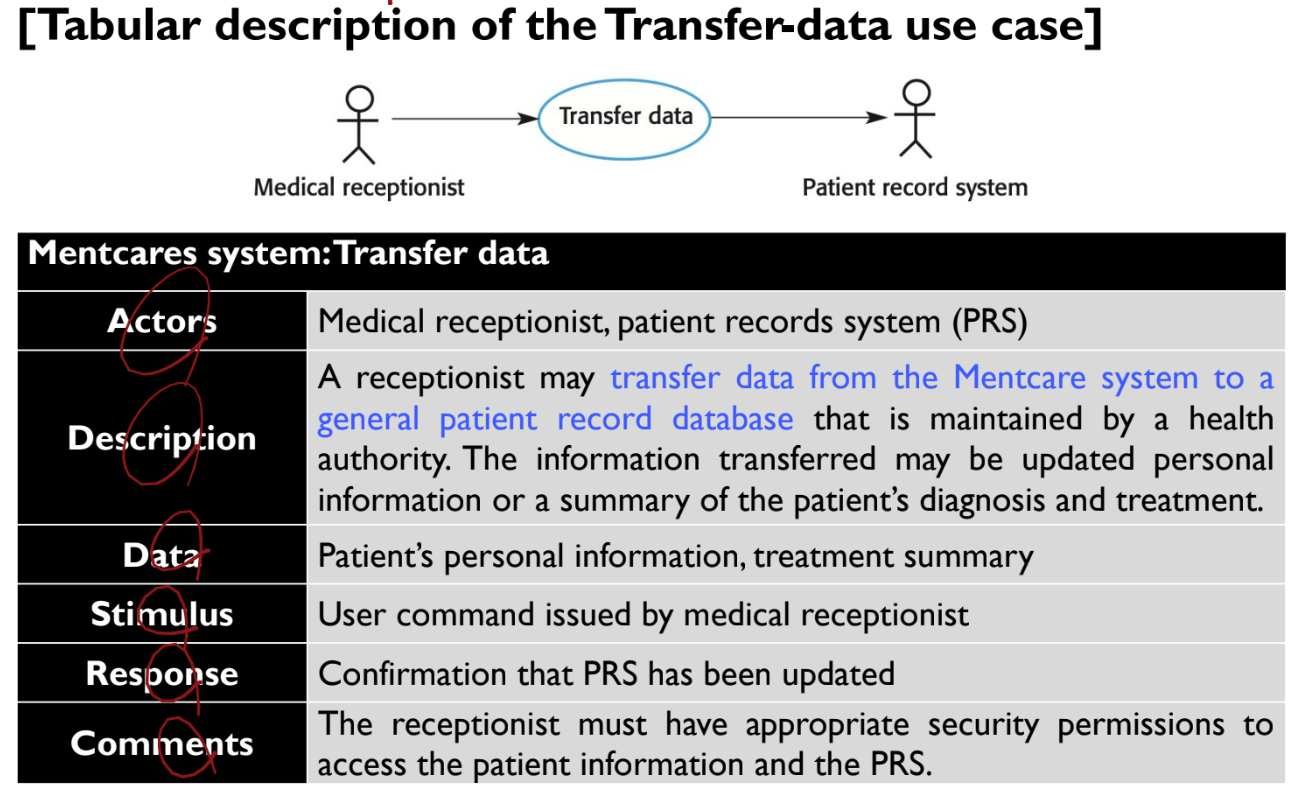
<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure8.png" alt="joowan1108" /></p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure9.png" alt="joowan1108" /></p>]]></content><author><name>채주완</name></author><category term="SKKU_SwEng" /><summary type="html"><![CDATA[Requirement Engineering]]></summary></entry><entry><title type="html">7designandimplementation</title><link href="https://joowan1108.github.io/skku_sweng/7DesignandImplementation/" rel="alternate" type="text/html" title="7designandimplementation" /><published>2026-10-16T00:00:00+00:00</published><updated>2026-10-16T00:00:00+00:00</updated><id>https://joowan1108.github.io/skku_sweng/7DesignandImplementation</id><content type="html" xml:base="https://joowan1108.github.io/skku_sweng/7DesignandImplementation/"><![CDATA[<p>설계를 실제 implementation으로 만드는 방법</p>

<h1 id="sw-design-and-implementation">SW Design and Implementation</h1>

<p>Executable SW system이 develop되는 단계이다</p>

<ul>
  <li>SW design: Identy SW components and their relationships based on customer’s requirements</li>
  <li>Implementation: Realizing the design as a program</li>
</ul>

<p><strong>중요한 implementation decision</strong></p>

<p>Implementation에서 중요한 것은 직접 개발할 것인가 아니면 application software을 구매할 것인가이다.</p>

<p>구매를 하게 된다면 이 software을 어떻게 우리 요구사항에 맞게 바꿀 것인가가 중요하다</p>

<h1 id="system-설계-전체-절차">System 설계 전체 절차</h1>

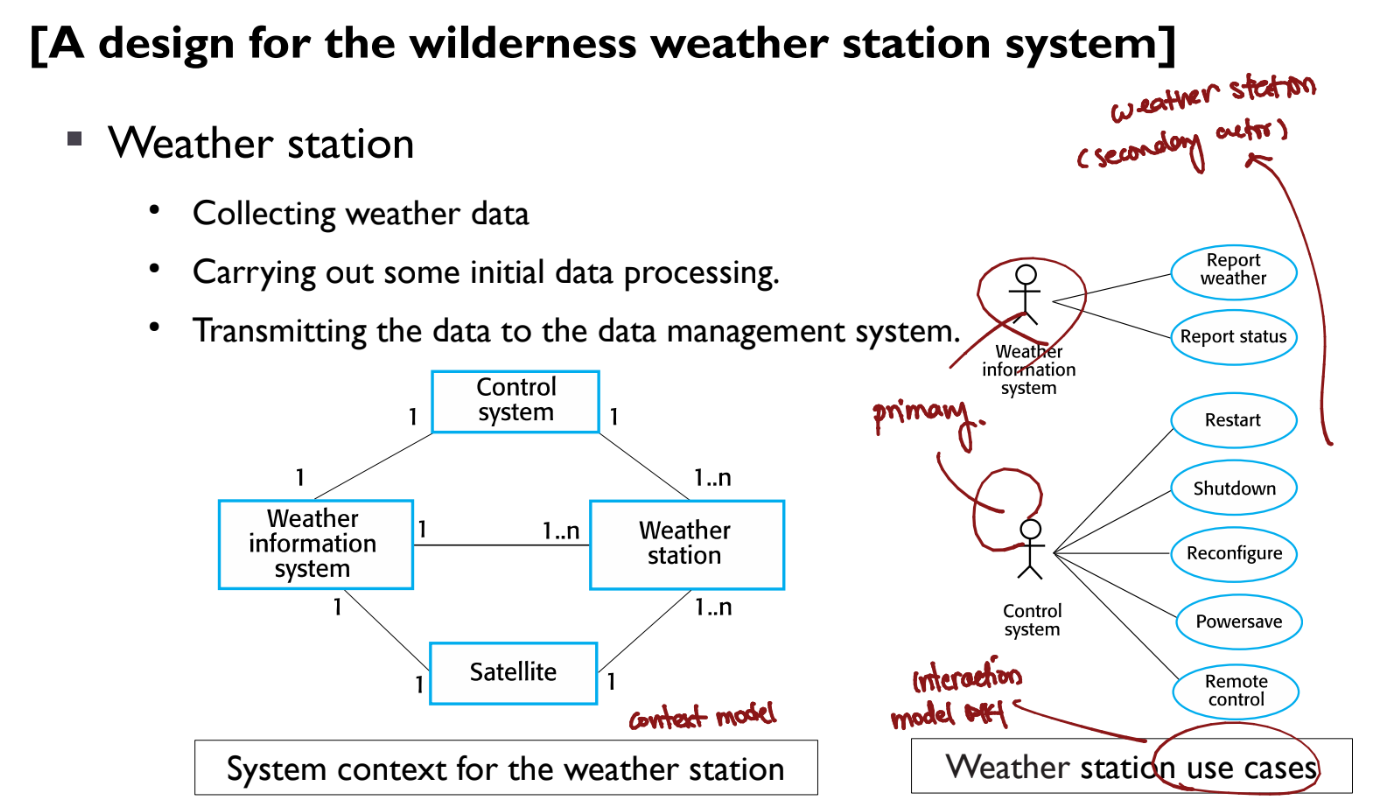
<p><strong>System context and interactions</strong></p>

<p>Sw design의 첫 단계이다</p>
<ul>
  <li>SW와 external environment 간의 상호작용을 배우는 것</li>
</ul>

<p>System Context Model</p>
<ul>
  <li>Other system in environments을 보여줌</li>
</ul>

<p>Interaction model</p>
<ul>
  <li>System이 environment와 상호작용하는 법을 보여줌</li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure35.png" alt="joowan1108" /></p>

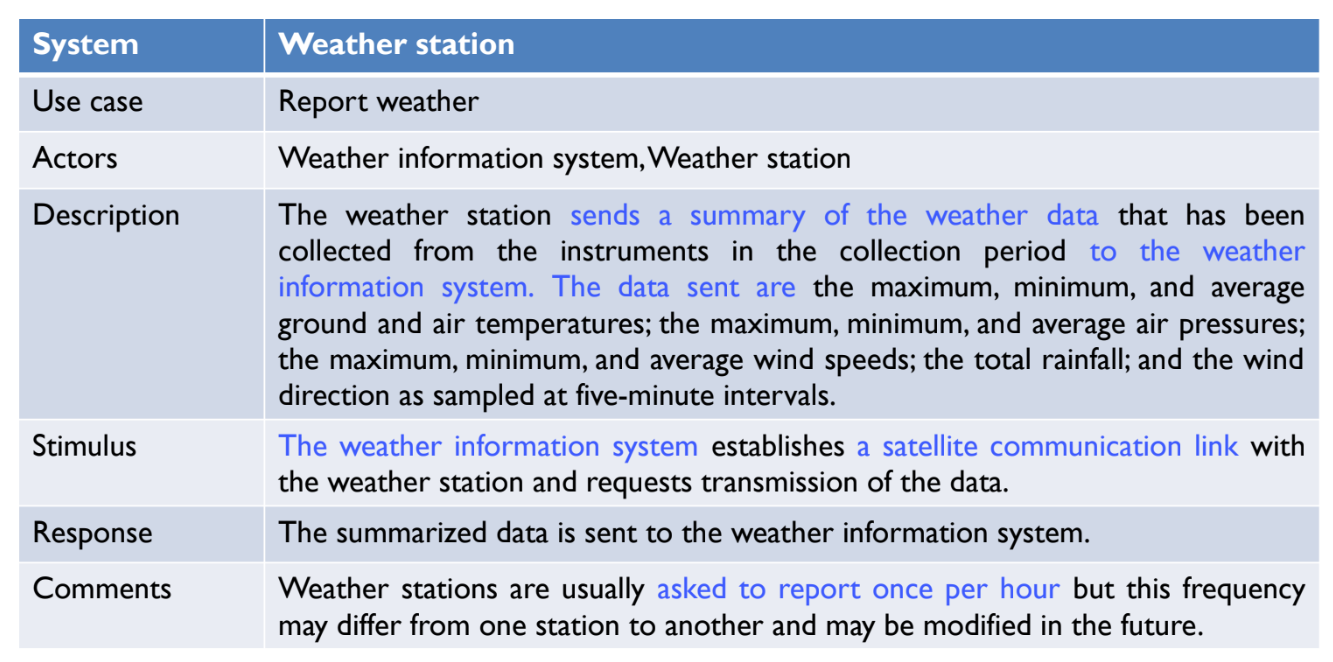
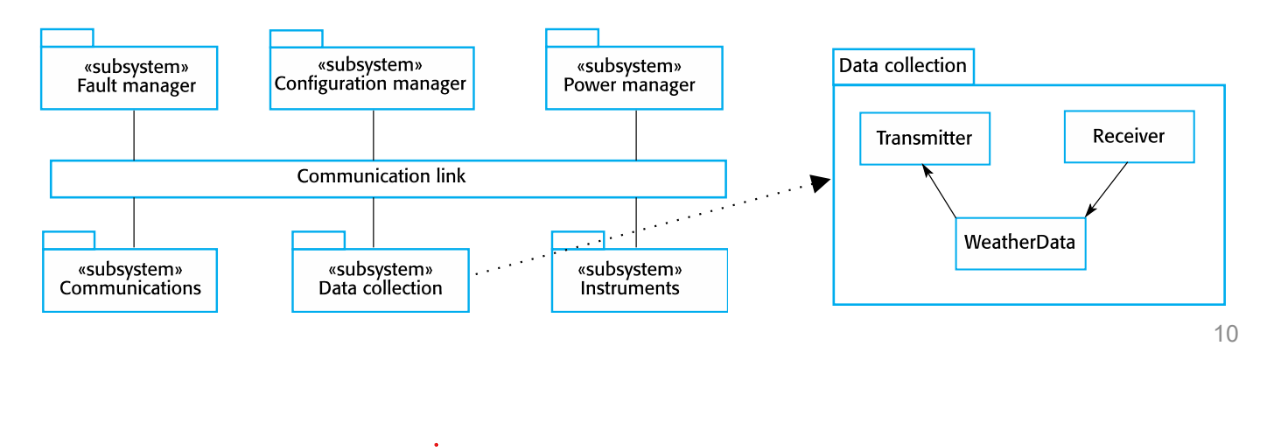
<p>Weather station이라는 system을 생각했을 때 외부 environment가 이 system을 어떻게 사용하는지를 보여주는게 use case이다. 따라서 외부 environment가 primary actor가 되고 weather station이 secondary actor가 된다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure36.png" alt="joowan1108" /></p>

<p><strong>Architectural design</strong></p>

<p>Major components을 안아내고 이들 간의 interaction을 찾아내는 것</p>

<p>Architectural pattern을 통해 system organization design하기</p>

<p>Variant of <strong>Client and Server</strong> design으로 Weather station을 구성할 수 있다.</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure37.png" alt="joowan1108" /></p>

<p><strong>Object class identification</strong></p>

<p>System interaction을 encapsulate하는 high level system objects을 파악</p>

<p>이들을 파악하는 방법으로는 세 가지가 존재한다</p>

<ul>
  <li><strong>Grammatical analysis</strong>
    <ul>
      <li>Grammatical analysis of natural language description 사용</li>
    </ul>
  </li>
  <li><strong>Tangible Entities</strong>
    <ul>
      <li>구체적 실체를 사용</li>
      <li>domain -&gt; aircraft</li>
      <li>role -&gt; manager</li>
      <li>location -&gt; office</li>
    </ul>
  </li>
  <li><strong>Scenario based analysis</strong></li>
</ul>

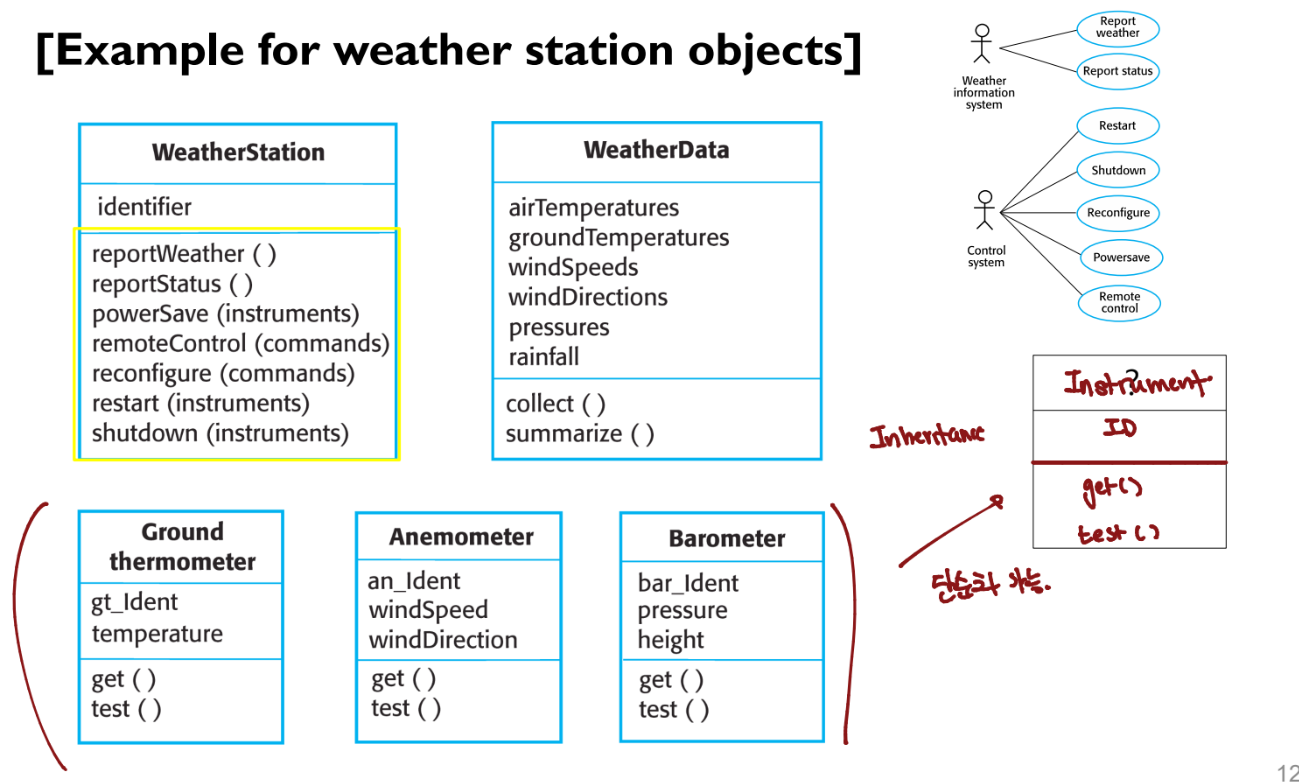
<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure38.png" alt="joowan1108" /></p>

<p>여기서 찾은 object들을 더 refine 할 수 있다. (instrument을 하나로 묶음)</p>

<p>Weather Station Object Class</p>
<ul>
  <li>Weather station의 interface을 정의</li>
  <li>usecase으로부터 함수들이 정의되었음</li>
</ul>

<p>Weather Data object class</p>
<ul>
  <li>Report weather command을 처리</li>
</ul>

<p>Ground thermometer, Anemometer, and Barometer object classes</p>
<ul>
  <li>tangible hardware entities</li>
</ul>

<p><strong>Design methods</strong></p>

<p>System requirement와 implementation의 bridge 역할을 한다.</p>

<p>Object / Object class을 보여주고 이들간의 association / relationship을 보여준다</p>

<p>이때 무슨 design model을 사용할 것인지 잘 선택해야 하며 design process에 따라 detail이 달라진다.</p>

<blockquote>
  <p>Agile에서는 whiteboard면 충분</p>
</blockquote>

<p>그리고 model의 수를 최소화해서 cost reducing을 해야 한다.</p>

<p>Design model에는 두 종류가 있다.</p>

<ul>
  <li><strong>Structural Models</strong>
    <ul>
      <li>Static structure을 보여줌</li>
      <li>ex) class diagram</li>
    </ul>
  </li>
  <li><strong>Dynamic Models</strong>
    <ul>
      <li>Dynamic structure와 expected runtime interactions을 보여준다</li>
      <li>sequence diagram, state diagram</li>
    </ul>
  </li>
</ul>

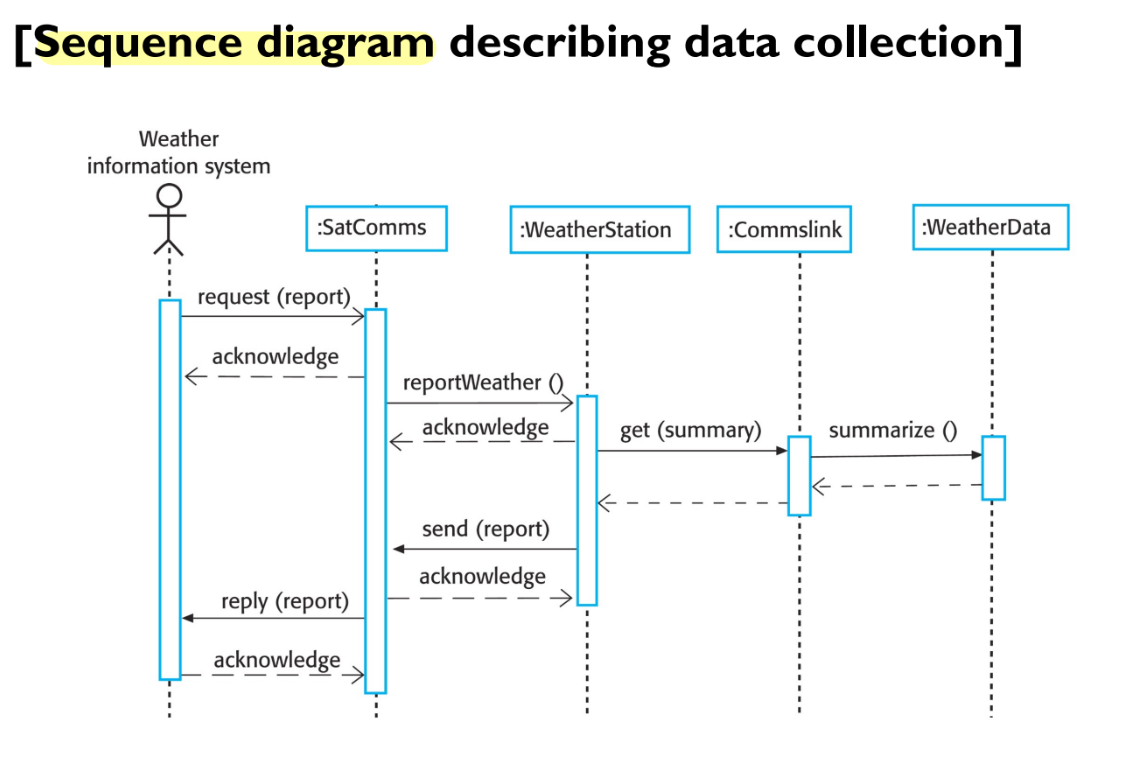
<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure39.png" alt="joowan1108" /></p>

<ul>
  <li>이때 점선 화살표는 asynchronous : sender가 기다리지 않음</li>
  <li>중간 직사각형의 크기가 클수록 active하다</li>
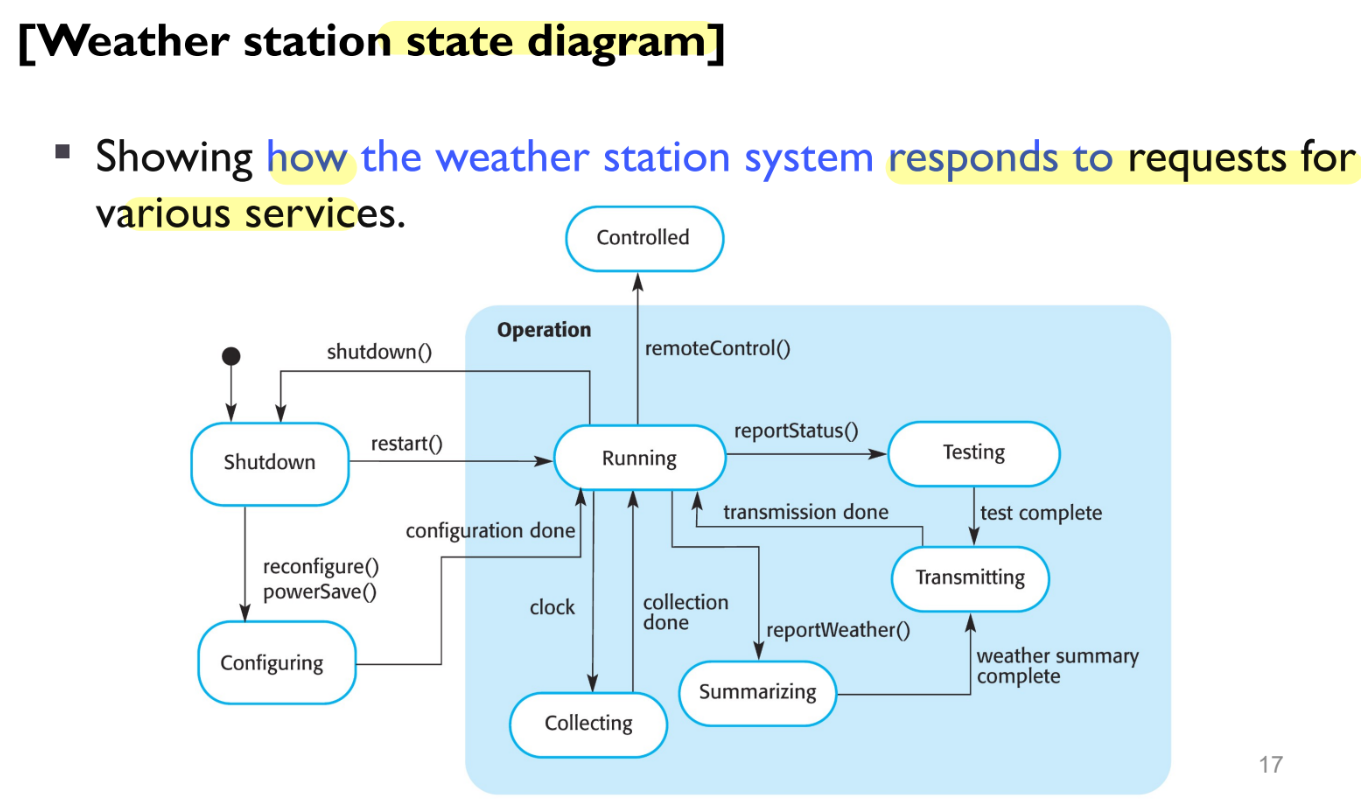
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure40.png" alt="joowan1108" /></p>

<p><strong>Interface specification</strong></p>

<ul>
  <li>Interface의 detail을 명시</li>
  <li>Service의 semantics을 정의</li>
  <li>하지만 data representation의 detail은 정의하지 않는다</li>
  <li>Access / update data operations까지만 정의</li>
</ul>

<p>Interface는 class diagram과 동일한 UML으로 정의될 수 있다</p>
<ul>
  <li>이때 attribute section은 신경쓰지 않고 연산만 신경쓴다</li>
  <li>stereotype가 name part에 있어야 한다 (interface)</li>
  <li>1 대 1 대응 아니여도 괜찮다</li>
</ul>

<h1 id="design-pattern">Design Pattern</h1>

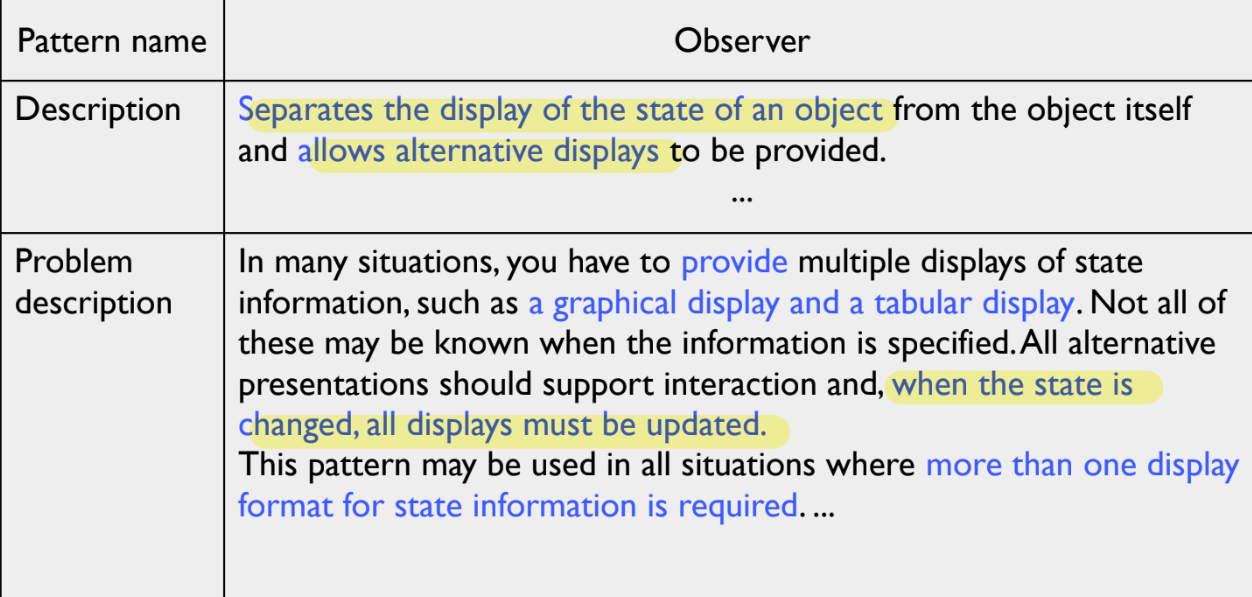
<p>Design pattern은 이미 accumulated 된 지식이고 well tried solution이며 reusing knowledge가 장점이다.</p>

<p>이때 patterns는 object oriented design에 적합하다.</p>

<p>Design pattern의 elements는 다음과 같다.</p>

<ul>
  <li>Name
    <ul>
      <li>reference</li>
    </ul>
  </li>
  <li>Problem Description
    <ul>
      <li>어디에 적용되는지</li>
    </ul>
  </li>
  <li>Solution Description
    <ul>
      <li>Design 설명. relationships과 responsibilities</li>
    </ul>
  </li>
  <li>Statement of Consequences
    <ul>
      <li>어떤 문제 / 단점이 있는지</li>
    </ul>
  </li>
</ul>

<p><strong>Observer Pattern</strong></p>

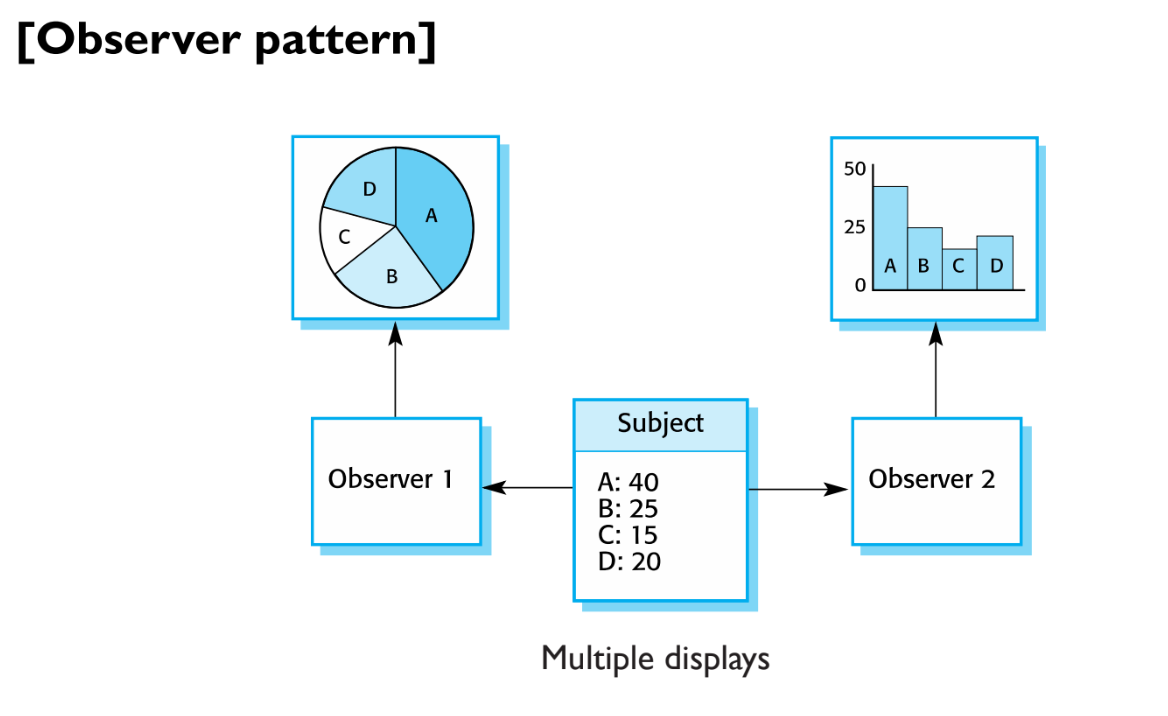
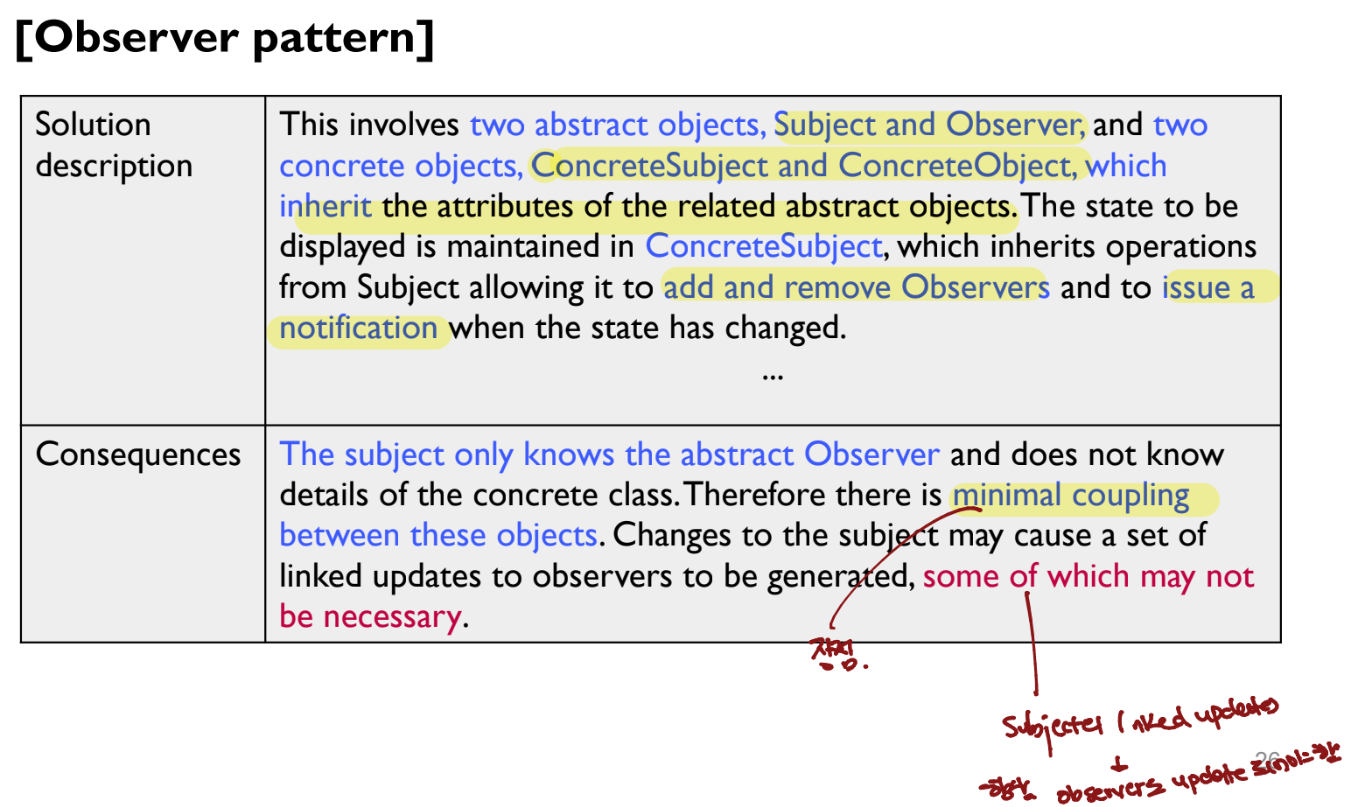
<p>Single object에 대해 다양한 presentations 필요할 때 사용한다</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure42.png" alt="joowan1108" />
<img src="https://joowan1108.github.io/images/SKKU_SwEng/figure43.png" alt="joowan1108" />
<img src="https://joowan1108.github.io/images/SKKU_SwEng/figure44.png" alt="joowan1108" /></p>

<p>Need to recognize that your design problem has an associated pattern that can be applied.</p>
<ul>
  <li>Tell several objects that the state of some other object has changed (Observer pattern).</li>
  <li>Tidy up the interfaces to a number of related objects that have often been developed incrementally (Façade pattern).</li>
  <li>Allow for the possibility of extending the functionality of an existing class at
runtime (Decorator pattern).</li>
</ul>

<h1 id="implementation-issues">Implementation Issues</h1>

<p>Important aspects는 다음과 같다</p>

<ul>
  <li>Reuse</li>
  <li>Configuration Management
    <ul>
      <li>다양한 SW versions들을 관리</li>
    </ul>
  </li>
  <li>Host target development
    <ul>
      <li>Host system: 하나의 computer에서 SW 구현</li>
      <li>Target system: 여러 computer에서 실행</li>
      <li>즉, 실행 환경을 고려해야 함</li>
    </ul>
  </li>
</ul>

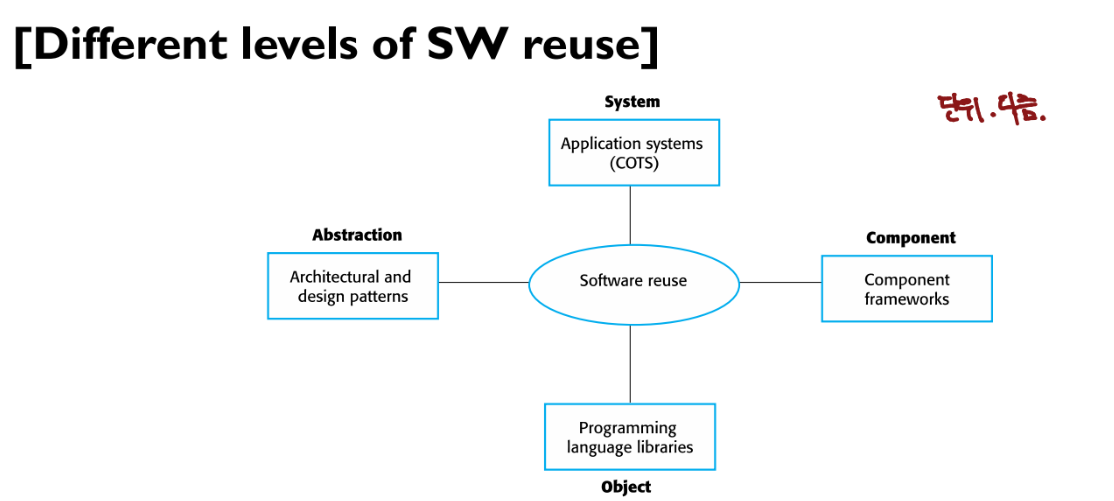
<p><strong>Reuse</strong></p>

<p>Reuse의 단위가 다를 수 있다</p>

<p><img src="https://joowan1108.github.io/images/SKKU_SwEng/figure41.png" alt="joowan1108" /></p>

<ul>
  <li>Abstraction Level
    <ul>
      <li>Knowledge of successful abstractions 사용</li>
      <li>SW을 직접 reuse하는 것 아님</li>
    </ul>
  </li>
  <li>Object Level
    <ul>
      <li>Library 잘 찾기</li>
    </ul>
  </li>
  <li>Component Level
    <ul>
      <li>Components을 직접 재사용</li>
    </ul>
  </li>
  <li>System Level
    <ul>
      <li>전체 application system을 재사용</li>
    </ul>
  </li>
</ul>

<p>Reuse을 함으로써 얻는 cost는 얼마인가</p>

<ul>
  <li>Reuse할 거 찾는 cost</li>
  <li>Reusable SW 구매하는 cost</li>
  <li>Reusable SW을 요구사항에 맞게 configuring cost</li>
  <li>Reusable SW을 integrating 하는 cost</li>
</ul>

<p><strong>Configuration Management</strong></p>

<p>Managing a changing software system</p>

<p><strong>Goal</strong></p>
<ul>
  <li>Supporting the system integration process so that all developers can access the project code in a controlled way. (e.g., conflict in git)</li>
  <li>Ensuring that everyone can access the most up-to-date versions of SW.</li>
  <li>Finding out what changes have been made.</li>
</ul>

<p><strong>4 fundamental configuration management activities</strong></p>

<ul>
  <li>Version management
    <ul>
      <li>다양한 version 관리</li>
      <li>다양한 programmer들의 development을 coordinate</li>
      <li>Overwriting code 멈추기</li>
    </ul>
  </li>
  <li>System Integration
    <ul>
      <li>Component의 각 버전들이 어떻게 사용되었는지 알려주기</li>
    </ul>
  </li>
  <li>Problem Tracking
    <ul>
      <li>Report bugs and problems</li>
      <li>누가 고치고 있고 언제 고쳐지는지 알기</li>
    </ul>
  </li>
  <li>Release management
    <ul>
      <li>새 release의 functionality 계획하고 software 배포를 위해 정리</li>
    </ul>
  </li>
</ul>

<p><strong>Host target development</strong></p>

<h1 id="open-source-development">Open-source development</h1>

<p>Source code가 공개되고 참여자들이 이 개발에 참여하는 것</p>

<p>cost가 싸고 widely used open source들은 매우 reliable하다</p>

<p>하지만 실제 기업에서 Opensource을 사용할 때의 문제점은 다음과 같다.</p>

<ul>
  <li>우리 회사의 제품을 개발할 때 기존 오픈소스 컴포넌트를 사용할 것인가?</li>
  <li>우리 회사가 개발하는 소프트웨어 자체를 오픈소스 방식으로 개발할 것인가?</li>
</ul>

<h2 id="open-source-licensing">Open source Licensing</h2>

<p>Open source는 free하게 사용 가능하지만 code을 맘대로 다룰 수 있다는 것은 아니다.</p>

<p>Open source을 올릴 때 license에 따라 restrictions가 다르다</p>

<ul>
  <li>The GNU General Public License (GPL)
    <ul>
      <li>reciprocal</li>
      <li>이걸 사용하면 사용한 것도 open source 해야 한다</li>
    </ul>
  </li>
  <li>The GNU Lesser General Public License (LGPL)
    <ul>
      <li>Variant of GPL</li>
      <li>사용할 때 사용한 것은 open source 하지 않아도 되지만 license된 component을 수정했다면 open source 해야함</li>
    </ul>
  </li>
  <li>The Berkley Standard Distribution (BSD) License
    <ul>
      <li>아무것도 안 해도 된다</li>
    </ul>
  </li>
</ul>]]></content><author><name>채주완</name></author><category term="SKKU_SwEng" /><summary type="html"><![CDATA[설계를 실제 implementation으로 만드는 방법]]></summary></entry><entry><title type="html">Vis1</title><link href="https://joowan1108.github.io/skku_infoviz/VIS1/" rel="alternate" type="text/html" title="Vis1" /><published>2026-10-13T00:00:00+00:00</published><updated>2026-10-13T00:00:00+00:00</updated><id>https://joowan1108.github.io/skku_infoviz/VIS1</id><content type="html" xml:base="https://joowan1108.github.io/skku_infoviz/VIS1/"><![CDATA[<h1 id="vis-landscape">VIS Landscape</h1>

<h2 id="infovis">InfoVis</h2>

<p>Bridging humans and data, 여러 분야의 교집합</p>

<ul>
  <li><strong>HCI</strong>: Human users</li>
  <li><strong>Computer Graphics</strong>: Millions of visual elements</li>
  <li><strong>Machine Learning</strong>: Abstracted numbers into bigger patterns</li>
  <li><strong>Databases</strong>: User’s visualization query targets large-scale data</li>
  <li><strong>Cognitive Science</strong>: Which visual representation is effective</li>
  <li><strong>Statistics</strong>: Data aggregation</li>
</ul>

<h3 id="6-area-model">6 Area Model</h3>

<p>시각화 연구를 6가지 영역으로 분류한 체계</p>

<p><strong>Area 1: Theoretical &amp; Empirical</strong></p>

<p>시각화의 이론적 기초와 실험적 검증</p>

<p><strong>Area 2: Applications</strong></p>

<p>시각화 도구</p>

<p><strong>Area 3: Systems &amp; Rendering</strong></p>

<p>시각화 rendering을 위한 system &amp; algorithm</p>

<p><strong>Area 4: Representations &amp; Interaction</strong></p>

<p>데이터 표현 방법 및 상호작용 방법</p>

<p><strong>Area 5: Data Transformations</strong></p>

<p>데이터를 시각화하기 적합한 형태로 변환</p>

<p><strong>Area 6: Analytics &amp; Decisions</strong></p>

<p>시각화를 통해 의가결정 돕기</p>

<blockquote>
  <p>InfoVis에서는 Domain, Users, Goal을 정의하는게 중요하다.</p>
</blockquote>

<h3 id="view-description">View Description</h3>

<p>Visual system에서는 다음 세 가지를 담는다</p>

<p><strong>Encoding</strong> : 무슨 visual mapping을 사용했는가</p>

<p><strong>Interaction</strong> : 어떤 상호작용이 가능한가</p>

<p><strong>Justification</strong> : 왜 특정 encoding 및 interaction 조합을 선택했는가</p>

<p><strong>Usage example</strong> : 어떻게 사용하는가</p>

<h3 id="evaluations-with-humans">Evaluations with Humans</h3>

<p>Visualization이 제공되는 대상은 사람이기 때문에 사람에 의한 검증이 필요하다</p>

<p><strong>User study</strong></p>

<p>10명보다 많은 non-expert가 usability test</p>

<p><strong>Case study</strong></p>

<p>few experts가 designer들의 설명을 들으면서 전체적인 workflow 평가</p>

<p><strong>Deployment study</strong></p>

<p>실제 deploy하여 10명보다 많은 non-expert가 평가</p>

<h3 id="early-visualization-approaches">Early Visualization Approaches</h3>

<p>GUI (MFC) : hard to learn, limited audience
$\downarrow$
Spreadsheet program (Excel): 
$\downarrow$
Business Intelligence Solutions (Spotfire, Tableau)
$\downarrow$
Web browsers: but limited
$\downarrow$
AI</p>

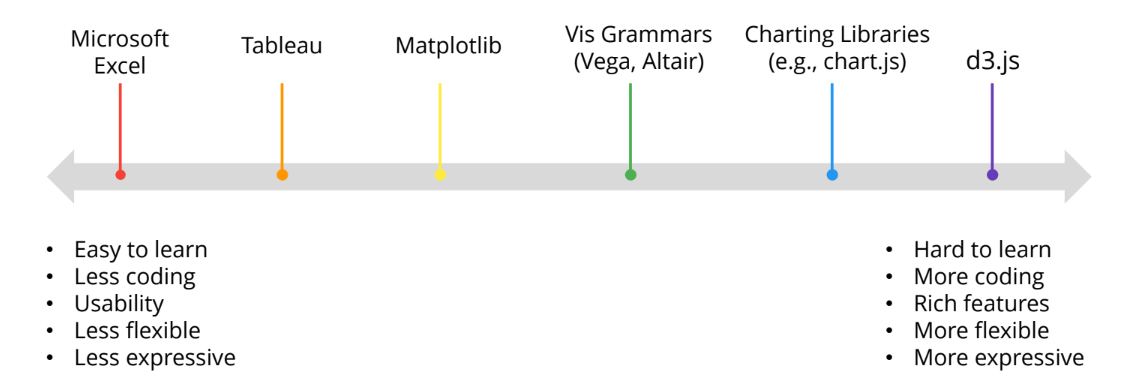
<h3 id="drawing-visualizations-comparison">Drawing Visualizations Comparison</h3>

<p>Top down: 이미 정해진 chart type과 map attribute. 즉, 이미 정해진 template들 기반</p>
<blockquote>
  <p>Excel , Spotfire, Chart libraries
Familiar, not expressive</p>
</blockquote>

<p>Bottom up: Mark와 channel을 먼저 고르는 것</p>
<blockquote>
  <p>Tableau, Visualization Grammar, d3.js
Aligned with research
leanrning curve</p>
</blockquote>

<h4 id="top-down">Top down</h4>

<p><strong>General Spreadsheet Software (Excel, 한글)</strong></p>
<ul>
  <li>Pros
    <ul>
      <li>Easy to learn</li>
      <li>Familiar</li>
      <li>No code</li>
    </ul>
  </li>
  <li>Cons
    <ul>
      <li>Limited expressiveness</li>
      <li>not aligned with InfoVis theory</li>
      <li>Less customizable</li>
    </ul>
  </li>
</ul>

<p><strong>Reusable Chart Libraries</strong></p>
<ul>
  <li>Pros
    <ul>
      <li>custamizable</li>
      <li>web framework에 가능</li>
    </ul>
  </li>
  <li>Cons
    <ul>
      <li>Coding required</li>
      <li>Not aligned with InfoViz</li>
    </ul>
  </li>
</ul>

<p>Notebook based Solution</p>
<ul>
  <li>Pros
    <ul>
      <li>3D visualization</li>
      <li>Easily integrated</li>
    </ul>
  </li>
  <li>Cons
    <ul>
      <li>Less expressive</li>
      <li>Not interactive</li>
      <li>Not aligned with InfoViz</li>
      <li>Static</li>
    </ul>
  </li>
</ul>

<h4 id="bottom-up">Bottom up</h4>

<p><strong>Tableau</strong></p>
<ul>
  <li>Pros
    <ul>
      <li>Familiar interface</li>
      <li>expressive</li>
      <li>well aligned with theory</li>
    </ul>
  </li>
  <li>Cons
    <ul>
      <li>Learning curve</li>
      <li>Customizable but limited</li>
    </ul>
  </li>
</ul>

<blockquote>
  <p><strong>Imperative programming</strong>: How the program should do something: 어떻게 보여줄 것인가를 설명해야 함
<strong>Declarative programming</strong>: What the program should do: 무엇을 보여줄 것인가를 설명해야 함 $\rightarrow$ <strong>더 좋음</strong></p>
</blockquote>

<p><strong>Visualization Grammars</strong></p>
<ul>
  <li>Pros
    <ul>
      <li>Declarative language</li>
      <li>Aligned</li>
      <li>Interactive and customizable</li>
    </ul>
  </li>
  <li>Cons
    <ul>
      <li>Coding</li>
      <li>Knowledge needed</li>
    </ul>
  </li>
</ul>

<p><strong>GenAI tools</strong></p>
<ul>
  <li>Pros
    <ul>
      <li>No knowledge needed</li>
      <li>no coding</li>
      <li>customizable</li>
    </ul>
  </li>
  <li>Cons
    <ul>
      <li>Often not specialized</li>
      <li>limited to narrow scope of chart and interactions</li>
    </ul>
  </li>
</ul>

<p><strong>d3.js</strong></p>
<ul>
  <li>Pros
    <ul>
      <li>Highest customizability</li>
      <li>Well aligned</li>
      <li>Scalable</li>
      <li>Well maintained</li>
    </ul>
  </li>
  <li>Cons
    <ul>
      <li>Steepest learning curve</li>
      <li>Coding required</li>
      <li>stubborn</li>
    </ul>
  </li>
</ul>

<p><img src="https://joowan1108.github.io/images/SKKU_InfoViz/figure1.png" alt="joowan1108" /></p>]]></content><author><name>채주완</name></author><category term="SKKU_InfoViz" /><summary type="html"><![CDATA[VIS Landscape]]></summary></entry><entry><title type="html">Vis2</title><link href="https://joowan1108.github.io/skku_infoviz/VIS2/" rel="alternate" type="text/html" title="Vis2" /><published>2026-10-13T00:00:00+00:00</published><updated>2026-10-13T00:00:00+00:00</updated><id>https://joowan1108.github.io/skku_infoviz/VIS2</id><content type="html" xml:base="https://joowan1108.github.io/skku_infoviz/VIS2/"><![CDATA[<h1 id="definition-and-justification">Definition and Justification</h1>

<p><strong>Data</strong>: raw materials without insights</p>

<p><strong>Information</strong>: Data을 analyze 한 다음에 얻는 meaningful한 정보. Data으로부터 insight을 뽑아낸 결과</p>

<h2 id="infovis">InfoVis</h2>

<p>Important Concepts</p>
<ul>
  <li><strong>Abstract data</strong>
    <ul>
      <li>Scientific visualization은 이미 공식적인 representation 방법이 존재하지만 abstract data는 그렇지 않음</li>
    </ul>
  </li>
  <li><strong>Humans 중요</strong>
    <ul>
      <li>많은 문제들이 ill specified하다. 즉, 문제 및 목표가 불확실하기 때문에 사람이 개입하여 어떤 데이터로 어떤 문제를 해결할 것인가를 알아내야 한다</li>
    </ul>
  </li>
  <li><strong>Computer 중요</strong>
    <ul>
      <li>사람이 다 할 순 없으므로</li>
      <li>Response time, interactivity, errors, scalability, generalizability</li>
    </ul>
  </li>
  <li><strong>Visual representation 중요</strong>
    <ul>
      <li>Visiual representation은 accurate하고 <strong>preattentive processing</strong>이 가능함</li>
      <li>Visual representation은 external memory, external representation의 역할을 함.</li>
    </ul>
  </li>
  <li><strong>상호작용 중요</strong>
    <ul>
      <li>하나의 view에 모든 차원을 담을 수 없음</li>
      <li>user가 보고싶은 것을 상호작용을 통해 볼 수 있게 해야 함</li>
    </ul>
  </li>
</ul>

<h2 id="vis-idiom">Vis Idiom</h2>

<p>특정 데이터를 표현하기 위해 어떤 visual representation을 고려할 것인가를 선택하는 방법
ex) Bivariate data을 위한 vis idiom은 scatter plot</p>

<p>이때 task, effectiveness, validation을 해야 한다.</p>

<p>Vis system을 구축할 때 고려해야 하는 3가지는 다음과 같다</p>

<ul>
  <li><strong>Computational capacity</strong>
    <ul>
      <li>Scalability와 responsiveness을 위해</li>
    </ul>
  </li>
  <li><strong>Human perceptual and cognitive capacity</strong>
    <ul>
      <li>사람의 memory와 attention은 유한함</li>
    </ul>
  </li>
  <li><strong>Display capacity</strong>
    <ul>
      <li>Pixel 수는 유한함</li>
    </ul>
  </li>
</ul>

<p>Vis system에서 중요한 것</p>

<ul>
  <li><strong>Data abstraction</strong>
    <ul>
      <li>What data does the user see?</li>
    </ul>
  </li>
  <li><strong>Task abstraction</strong>
    <ul>
      <li>Why does the user use the system?</li>
    </ul>
  </li>
  <li><strong>Idiom abstraction</strong>
    <ul>
      <li>How are the visual encoding and interaction idioms constructed?</li>
    </ul>
  </li>
</ul>

<blockquote>
  <p><strong>Information density</strong>: 사용 안 된 공간 대비 표현된 정보량</p>
</blockquote>]]></content><author><name>채주완</name></author><category term="SKKU_InfoViz" /><summary type="html"><![CDATA[Definition and Justification]]></summary></entry><entry><title type="html">Vis3</title><link href="https://joowan1108.github.io/skku_infoviz/VIS3/" rel="alternate" type="text/html" title="Vis3" /><published>2026-10-13T00:00:00+00:00</published><updated>2026-10-13T00:00:00+00:00</updated><id>https://joowan1108.github.io/skku_infoviz/VIS3</id><content type="html" xml:base="https://joowan1108.github.io/skku_infoviz/VIS3/"><![CDATA[<h1 id="data-and-task-abstraction">Data and Task Abstraction</h1>

<h2 id="data-abstraction">Data Abstraction</h2>

<p>Dataset의 종류는 무한이기 때문에 data 종류별로 visualize 방법을 정의해야 한다</p>

<blockquote>
  <p>Type of data: structural interpretation
Semantics of data: real world meaning
Metadata: Additional data required for interpreting data (types, semantics, syntax)</p>
</blockquote>

<p>Data abstraction을 위해서는 세 가지를 알아야 한다,</p>

<p><strong>Data</strong></p>

<ul>
  <li><strong>Item</strong>: Individual entity</li>
  <li><strong>Attribute</strong>: Property that can be measured, observed, logged (ex: dimension)</li>
  <li><strong>Link</strong>: Relationshup between items</li>
  <li><strong>Grid</strong>: Geometric/Topological 관계를 보여주는 data</li>
  <li><strong>Position</strong>: Spatial data (직접적인 위치)</li>
</ul>

<p><strong>Dataset</strong></p>

<ul>
  <li><strong>Table</strong>: Item과 attribute을 포함</li>
  <li><strong>Network</strong>: Items, links, attributes을 포함</li>
  <li><strong>Fields</strong>: Grids, Positions, Attributes (Continuous domain)
    <ul>
      <li><strong>Sampling</strong>: Measure 주기</li>
      <li><strong>Interpolation</strong>: Sampled points 중간을 어떻게 채울 것인가</li>
    </ul>

    <blockquote>
      <p><strong>Grid geometry</strong>: Cells location in space
<strong>Grid topology</strong>: How cells connect with neighboring cells</p>
    </blockquote>
  </li>
  <li><strong>Geometry</strong>: Items, Positions</li>
  <li><strong>Clusters</strong>(grouping), <strong>Sets</strong>(unordered), <strong>Lists</strong>(ordered): Items</li>
</ul>

<p><strong>Attribute</strong></p>

<ul>
  <li><strong>Categorical</strong>
    <ul>
      <li>Implicit ordering 없음 (ex: movie genres)</li>
      <li>Operators: = = 또는 ! =</li>
    </ul>
  </li>
  <li><strong>Ordered</strong>
    <ul>
      <li><strong>Ordinal</strong>: Ordering이 있지만 arithmetic이 의미 없음 (shirt sizes)</li>
      <li><strong>Quantative</strong>: Ordering과 arithmetic 가능 (length, prices)
        <ul>
          <li><strong>Interval</strong>: 차이가 의미있지만 absolute zero는 없음</li>
          <li><strong>Ratio</strong>: 차이가 의미있고 absolute zero도 있음 (Kelvin temperature)
            <ul>
              <li>곱하기 나누기 가능</li>
            </ul>
          </li>
        </ul>
      </li>
      <li>Operators: = = 또는 ! = 또는 &gt;,&lt; (Arithmetics는 quantative data에서만 가능)</li>
    </ul>
  </li>
</ul>

<p>Ordered attribute type에는 ordering direction도 중요하다.
<strong>Sequential</strong>: Min to max가 정해져있음
<strong>Diverging</strong>: zero point으로부터 방향이 두 갈래
<strong>Cyclic</strong>: 일주일처럼 계속 증가해도 starting point으로 돌아감</p>

<p><strong>Attribute Semantics</strong>
데이터가 데이터셋에서 어떤 역할을 하는가를 의미</p>
<ul>
  <li>Key: index for look up (ex: ID, 좌표값)</li>
  <li>Value: look up되는 값</li>
</ul>

<h2 id="task-abstraction">Task Abstraction</h2>

<p>사람이 하고싶은 task도 무한이기 때문에 각 task마다 별도의 visualize 방법은 정의하는 것은 비효율적이다. 따라서 큰 범주로 정의 (Abstract)하고 그 범주마다 방법을 정의해야 한다. ex) Compare values between two groups</p>

<h3 id="actions">Actions</h3>

<p>Analyze: 무엇을 위해 사용하는가
Search: 관심 대상을 어떻게 찾는가
Query: 대상에 대해 무엇을 알아보는가</p>

<p><strong>High level: Analyze</strong></p>
<ul>
  <li>Consume
    <ul>
      <li>이미 생성된 information을 사용하는 것</li>
      <li>Consume을 하는 방법은 세 가지로 나뉜다.</li>
      <li><strong>Discover</strong>
        <ul>
          <li>이전에 몰랐던 정보를 찾는 것</li>
          <li>이때 hypothesis을 verify하거나 disconfirm 하기</li>
        </ul>
      </li>
      <li><strong>Present</strong>
        <ul>
          <li>이미 알려진 정보를 설명하는 것</li>
        </ul>
      </li>
      <li><strong>Enjoy</strong>
        <ul>
          <li>Visualization 감상</li>
        </ul>
      </li>
    </ul>
  </li>
  <li><strong>Produce</strong>
    <ul>
      <li>이미 생성된 information으로 새로운 information을 얻는 것</li>
      <li>Produce을 하는 방법도 세 가지로 나뉜다</li>
      <li><strong>Annotate</strong>
        <ul>
          <li>Annotations 적기</li>
        </ul>
      </li>
      <li><strong>Record</strong>
        <ul>
          <li>Saving / Capturing visualization elements
            <blockquote>
              <p>Annotate은 일시적인 정보를 붙이는 것이고 record는 영구적인 것을 저장하는 것</p>
            </blockquote>
          </li>
        </ul>
      </li>
      <li><strong>Derive</strong>
        <ul>
          <li>새로운 data elements을 존재하는 data elements으로부터 얻는 것</li>
          <li>ex: changing types of attribute, augmenting, apply operations</li>
        </ul>
      </li>
    </ul>
  </li>
</ul>

<p><strong>Mid level: Search</strong></p>

<p><img src="https://joowan1108.github.io/images/SKKU_InfoViz/figure2.png" alt="joowan1108" /></p>

<p>사람(Target)을 찾는다고 했을 때 이 정보가 있는 location은 포유류 섹션</p>

<ul>
  <li><strong>Lookup</strong>: 사람이 포유류 섹션에 있다는 것을 알고 찾기</li>
  <li><strong>Locate</strong>: 사람이 어떤 섹션에 있는지 모르고 찾기</li>
  <li><strong>Browse</strong>: 포유류 섹션을 훑어보기</li>
  <li><strong>Explore</strong>: Species tree 전체를 훑어보기</li>
</ul>

<p><strong>Low level: Query</strong></p>

<ul>
  <li><strong>Identify</strong>: 하나의 target의 특징 반환</li>
  <li><strong>Compare</strong>: 여러 target의 특징 반환</li>
  <li><strong>Summarize</strong>: 모든 것의 comprehensive view 반환</li>
</ul>

<h3 id="targets">Targets</h3>

<p>Action의 대상도 정의해야 한다</p>

<p>Data level</p>
<ul>
  <li><strong>Trends</strong>: High level characterization of data (증가한다, peak이다, 등)</li>
  <li><strong>Outliers</strong>: Trend에 맞지 않는 정보</li>
  <li><strong>Features</strong>: Interest의 구조</li>
</ul>

<p>Attribute level</p>
<ul>
  <li><strong>Distribution</strong>: ex) 공부 시간의 분포</li>
  <li><strong>Extremes</strong>: ex) 가장 오래 공부하는 학생</li>
  <li><strong>Dependency</strong> ex) 성적이 공부 시간과 관련이 있는지</li>
  <li><strong>Correlation</strong> ex) 성적과 공부 시간이 비례하는지</li>
  <li><strong>Similarity</strong> ex) 성적과 공부 시간 dimension에서 학생들 간의 유사도</li>
</ul>

<blockquote>
  <p>Network dataset에서는 target이 topology와 path
Spatial dataset에서는 target이 shapes</p>
</blockquote>]]></content><author><name>채주완</name></author><category term="SKKU_InfoViz" /><summary type="html"><![CDATA[Data and Task Abstraction]]></summary></entry></feed>