3: CPU Virtualization Scheduling
Scheduling
Time sharing이 가능하기 위해서는 mechanism 말고 intelligence도 필요하다고 하였다. 다시 설명하자면 intelligence란 한 process을 멈추고 새로운 process을 실행할 때 어떤 process을 골라야 하는지 결정해주는 정책을 의미하고 이를 scheduling이라고 한다.
Scheduling 내에서는 process을 job라고 표현하기에 process 말고 job라고 지칭하겠다.
Scheduling 방법들을 설명하기 위해서 4 가지의 assumption을 해야 한다.
- job은 모두 동일한 시간동안 실행된다.
- 모든 job는 OS에 동시에 도착한다.
- 모든 job는 CPU만 사용한다.
- 각 job에 걸리는 시간을 알 수 있다.
Scheduling methods
Scheduling의 성능을 평가하기 위해서 보통 두 가지의 평가 지표: turnaround time과 response time을 사용한다.
Turnaround time은 job가 완성되는 시각과 job가 scheduler에 도착한 시각의 차이를 의미한다.
\[T_{\text{turnaround}} = T_{\text{completion}} - T_{\text{arrival}}\]즉, job가 얼마나 빨리 처리되느냐를 평가하는 지표로 생각하면 된다.
Scheduling First In, First Out (FIFO)
FIFO는 먼저 도착한 job부터 끝내버리는 scheduler로 A,B,C가 순서대로 왔다면 각 job가 끝날 때까지 온 순서대로 CPU를 할당해준다. 이때 모든 job은 동일한 시간에 도착한다고 가정하였기에 $T_{\text{arrival}} = 0$ 으로 고정이다.
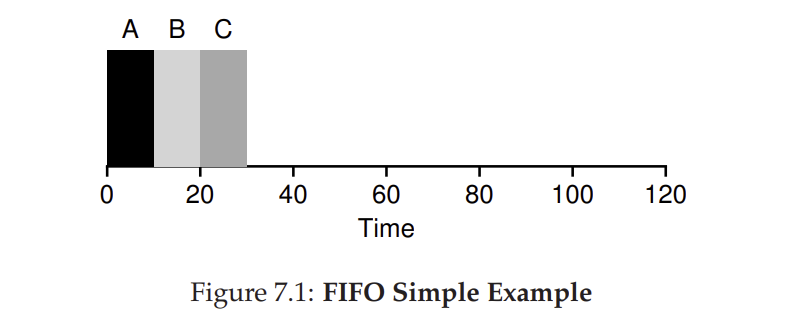
A의 turnaround time: 10 - 0 = 10
B의 turnaround time: 20 - 0 = 20
C의 turnaround time: 30 - 0 = 30
따라서 평균 turnaround time은 $\frac {10+20+30} {3} = 20$ 이 된다.
이렇게 보면 꽤 괜찮다고 생각할 수 있는데 예를 들어 가정 1: job는 모두 실행되는데 동일한 시간이 걸린다를 없앤다면 어떻게 될까?
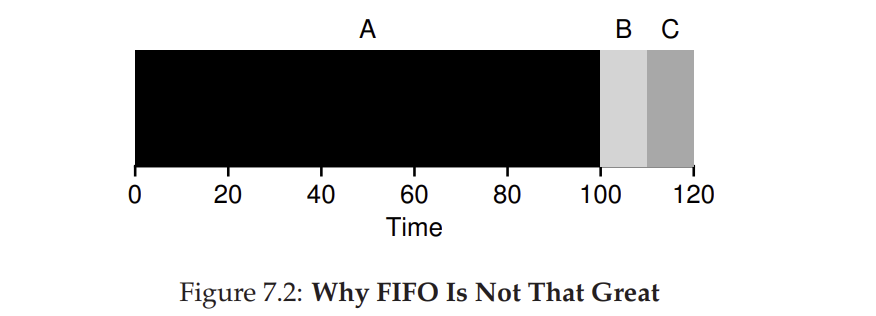
먼저 도착한 A가 엄청 오래 걸리는 job이라면 B,C의 turnaround time이 나빠져 turnaround time 기준 성능이 매우 나빠진다.
A의 turnaround time: 100 - 0 = 100
B의 turnaround time: 110 - 0 = 110
C의 turnaround time: 120 - 0 = 120
따라서 평균 turnaround time은 $\frac {100+110+120} {3} = 110$ 이 된다.
이를 convoy effect라고 한다. Queue에 맨 앞에 엄청 오래 걸리는 작업이 있다면 그 작업을 뒤따르는 작업도 오래 걸리는 현상이다.
Scheduling Shortest Job First (SJF)
따라서 대안으로 나온 scheduling 방법이 SFJ이다. 즉, 실행 시간이 가장 짧은 job부터 처리하여 turnaround time을 최소화하는 것이다.
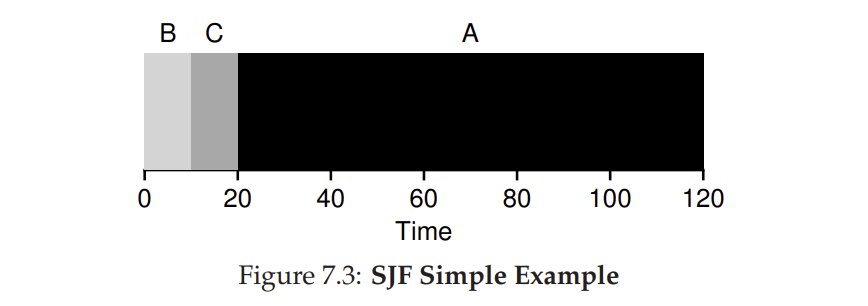
B의 turnaround time: 10 - 0 = 10
C의 turnaround time: 20 - 0 = 20
A의 turnaround time: 120 - 0 = 120
따라서 평균 turnaround time은 $\frac {10+20+120} {3} = 50$ 이 된다.
SJF는 turnaround time을 기준으로 현재 상황에서 최고의 선택을 하기 때문에 optimal 하다고 볼 수 있다.
하지만 SJF이 효과적인 이유는 모든 job가 동시에 도착하기 때문이다. 가정 2. 모든 job는 OS에 동시에 도착한다를 없앤다고 해보자. 그러면 SJF의 한계가 나타난다.
100ms가 걸리는 A가 가장 먼저 왔다면 FIFO처럼 B와 C의 turnaround time도 증가하게 된다.
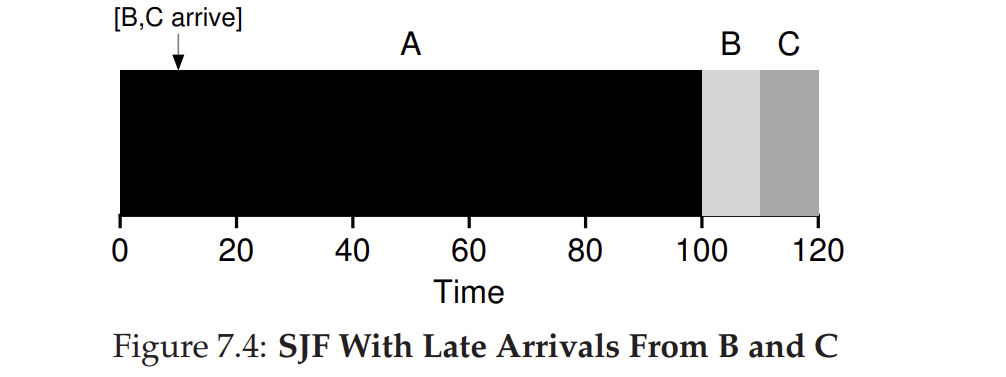
A의 turnaround time: 100 - 0 = 100
B의 turnaround time: 110 - 10 = 100
C의 turnaround time: 120 - 10 = 110
따라서 평균 turnaround time은 $\frac {100+100+110} {3} = 103.33$ 이 된다.
Shortest Time to Completion First (STCF)
SFJ가 가정 2가 없어졌을 때 효과적이지 못한 이유는 한 job을 실행하면 중간에 결정을 바꿀 수 없기 때문이다. 이런 성격을 non-preemptive이라고 한다.
하지만 이 결정을 바꿀 수 있는 scheduler라면 어떻게 될까? 이런 성격, preemptive 성격을 가진 scheduler가 STCF이다.
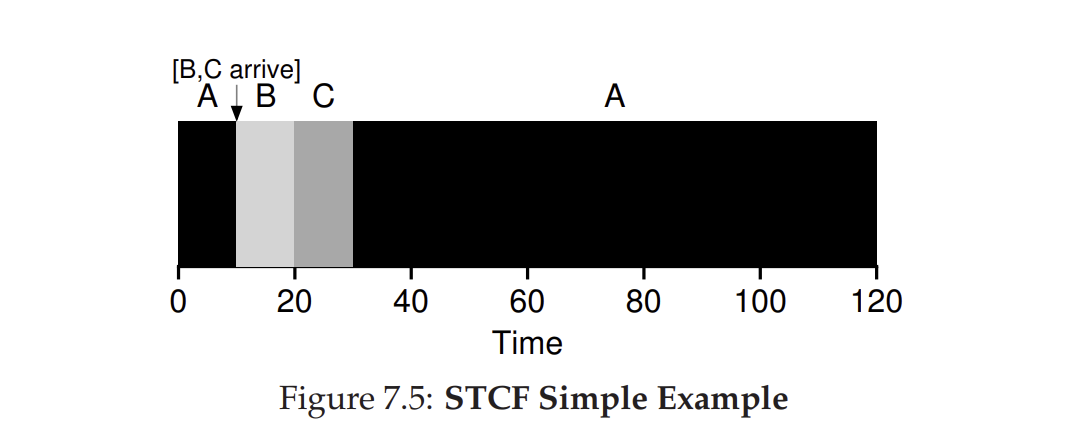
STCF는 새로운 job가 들어올 때마다 현재 가장 빨리 끝낼 수 있는 job으로 전환하는 scheduling 방법이다. 즉, SJF의 단점을 바로 해결해준다. 엄청 오래 걸리는 작업이 먼저 오더라도 더 빨리 끝낼 수 있는 작업이 오면 그 작업으로 바꿀 수 있는 것이다
A의 turnaround time: 120 - 0 = 120
B의 turnaround time: 20 - 10 = 10
C의 turnaround time: 30 - 10 = 20
따라서 평균 turnaround time은 $\frac {120+10+20} {3} = 50$ 이 된다.
$\rightarrow$ 따라서 각 job에 걸리는 시간을 알고, CPU만 사용하고, turnaround time으로 성능을 평가했을 때 STCF가 가장 효과적인 scheduler이다.
하지만 새로운 metric: reponse time을 사용하게 된다면 얘기가 달라진다.
Response time은 job가 처음 실행된 시각 - job가 도착한 시각으로 job을 얼마나 빨리 시작하는지를 측정하는 metric이다.
\[T_{\text{response}} = T_{\text{firstrun}} - T_{\text{arrival}}\]지금까지의 scheduler는 모두 response time에 최악이다. STCF을 보더라도 C의 response time은 10초로 어떻게 보면 엄청 긴 시간이다. (C 프로그램을 열었는데 실행되기까지 10초가 걸린다고 생각해보자..)
Round Robin
Round Robin은 Response time에 최적화하기 위한 scheduler이다. Round robin은 job가 빨리 실행될 수 있도록 모든 실행 시간 단위를 time slice라는 단위로 쪼개어 모든 job을 한번씩 time slice만큼 실행시키는 방법이다. 이때 time slice는 timer interrupt 주기의 배수가 되어야 한다.
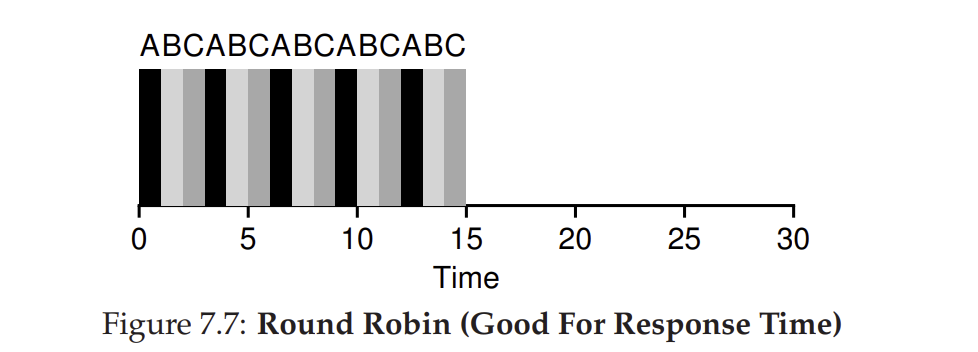
time slice가 1이고 A,B,C가 동시에 왔다고 했을 때
A의 response time: 0
B의 response time: 1
C의 response time: 2
따라서 평균 response time = $\frac {0+1+2} {3} = 1$ 이다.
Time slice의 크기에 따라 Round Robin의 response time 성능이 좌우된다는 것을 알 수 있다. Time slice가 너무 길면 response time은 길어질 것이고 너무 짧아진다면 response time은 짧아지겠지만 context switching의 빈도가 너무 높아져서 성능이 저하될 수 있다.
이때 Round Robin의 원리를 보면 response time에는 좋지만 turnaround time에는 최악임을 알 수 있다.
Round robin은 모든 job에게 동일한 기회를 준다는 점에서 fair한 알고리즘으로 볼 수 있는데 fair와 turnaround time은 trade off 관계이기 때문이다.
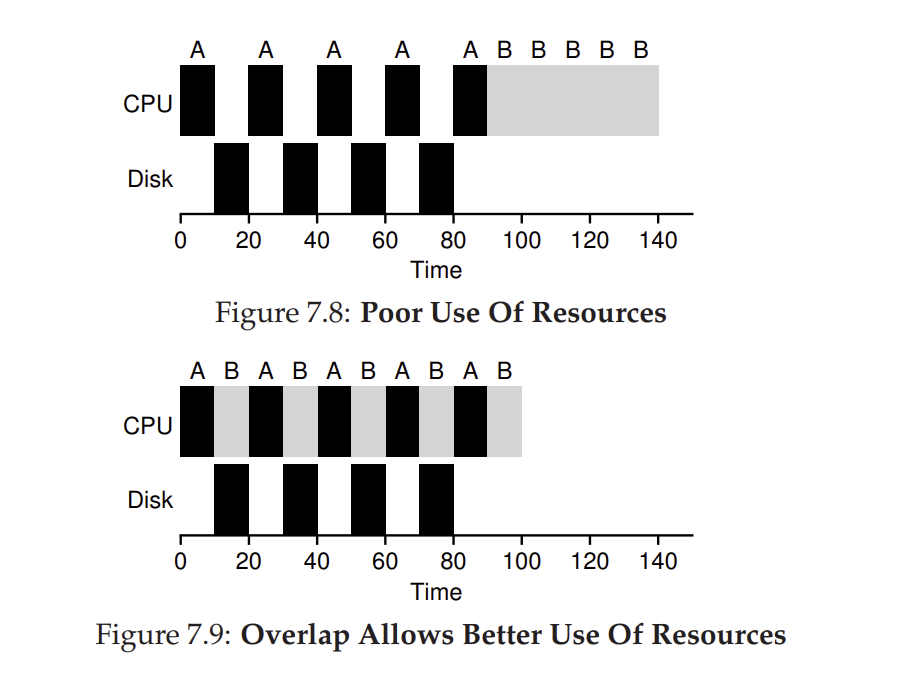
지금까지 scheduler 방법들을 설명할 때 가정 3과 4를 완화하지 못했다. 모든 process는 disk에 접근하는 등 I/O을 요청할 수도 있다. Process가 I/O 요청을 하면 blocked state에 들어가기 때문에 I/O을 처리하는 동안 다른 process에게 CPU을 주어서 그 빈 시간동안 다른 process를 진행시킬 수 있다.
가정 4는 사실 엄청 비현실적이다. 하나의 process의 실행 시간은 아무도 알 지 못하기 때문이다. 가정 4을 없앤다면 지금까지 배운 scheduler는 모두 쓸모가 없다는 것을 알 수 있다.
그렇다면 process에 대한 사전 지식 없이도 잘 작동하는 scheduler는 뭐가 있을까?
Multi-Level Feedback Queue (MLFQ)
MLFQ는 process에 대한 사전 지식 없이도 두 metrics turnaround time과 response time을 최소화하는 알고리즘이다.
MLFQ Rules
MLFQ는 여러 queue을 사용하고 각 queue가 다른 우선순위를 갖도록 하였다. 이때 이 우선순위는 다음에 실행될 job을 고를 때 사용되는 우선순위이다. 하나의 queue에 여러 job가 존재한다면, 이때는 round robin을 통해 각 job가 실행된다.
그렇다면 우선순의는 어떻게 결정되는 것일까?
$\rightarrow$ MLFQ는 사전 정보가 아니라 지금까지 관찰한 내용을 바탕으로 우선순위를 결정한다. 즉, MLFQ는 job의 성격을 파악하고 이를 바탕으로 job의 미래 성격을 예측한다고 볼 수 있다. 예를 들어 CPU을 조금 쓰고 IO을 요청하는 job의 경우, 빨리 처리할 수 있기 때문에 높은 우선순위를 가진다. 반대로 CPU을 오랫동안 많이 쓰는 job의 경우, 낮은 우선순위를 가진다.
따라서 MLFQ의 rule을 다음과 같이 정할 수 있다.
- Rule 1: If priority(A) > priority(B), A runs
- Rule 2: If priority(A) = priority(B), A and B run in Round Robin
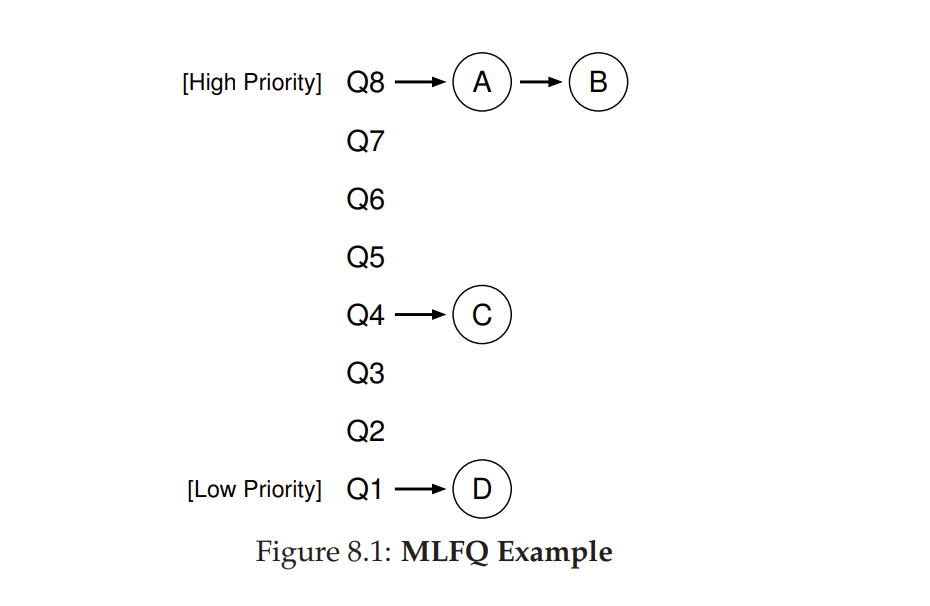
여기에 더해 우선순의가 변하는 rule까지 만들었다.
-
Rule 3: When a job enters the system, it is placed at the highest priority (the topmost queue).
$\rightarrow$ job가 새로 들어오면 가장 높은 우선순위를 가진다
-
Rule 4a: If a job uses up an entire time slice while running, its priority is reduced (i.e., it moves down one queue).
$\rightarrow$ Job가 time slice 전체를 다 CPU 사용에 쓴다면 우선순위가 줄어든다.
-
Rule 4b: If a job gives up the CPU before the time slice is up, it stays at the same priority level.
$\rightarrow$ Job가 time slice가 끝나기 전에 interrupt으로 CPU를 반환하면 우선순위가 줄어든다.
이 rule들을 통해 MLFQ의 원리를 더 정확히 이해할 수 있다. MLFQ는 process에 대한 사전 정보가 없기 때문에 처음에 process가 들어올 때는 우선순위가 가장 높다고 가정하고 이 process의 성격을 파악하는 것이다. CPU을 많이 사용한다면 우선순위를 낮추고, CPU를 많이 사용하지 않는다면 CPU을 오래 사용하지 않는 process라고 생각하고 우선순위를 유지시키는 것이다. 즉, 가장 빨리 끝날 거 같은 process을 먼저 실행시키고 오래 걸릴 거 같은 process을 나중에 실행시키는 것이다. 이는 가장 짧은 작업을 먼저 실행시키는 SJF와 매우 유사하다고 볼 수 있다.
하지만 문제점들이 존재한다.
-
우선순위가 높은 job들이 많다면 우선순위가 낮은 job들은 실행될 기회가 없다는 것이다. 이 문제를 starvation이라고 한다
-
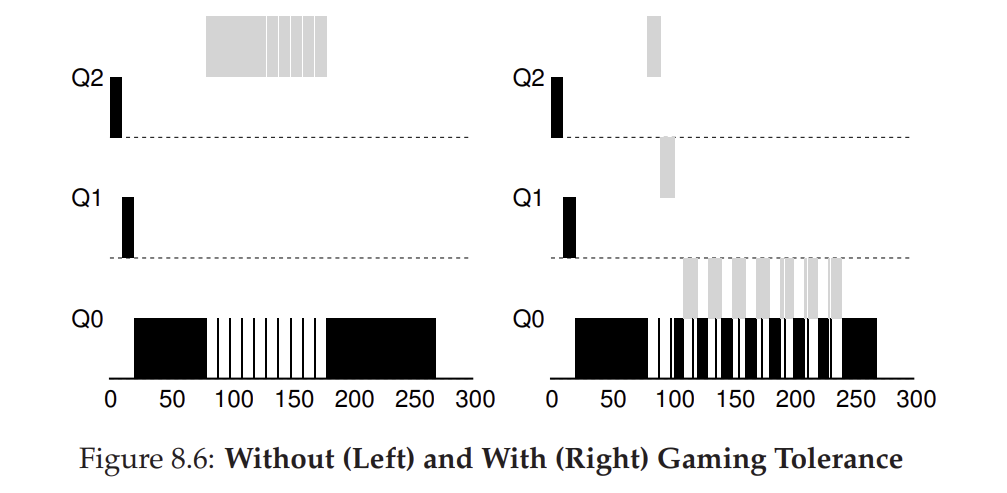
Gaming Scheduler : 이 scheduler의 원리를 악용해서 CPU가 많이 필요한 작업이지만 I/O 요청 등 trap을 일부로 많이 발생시켜서 CPU을 독차지하는 program을 만들 수 있다.
-
Program의 behavior가 변할 수 있다. 예를 들어, Program이 처음에만 CPU을 많이 쓰고 나중에는 CPU을 적게 쓸 수 있다
Starvation 해결
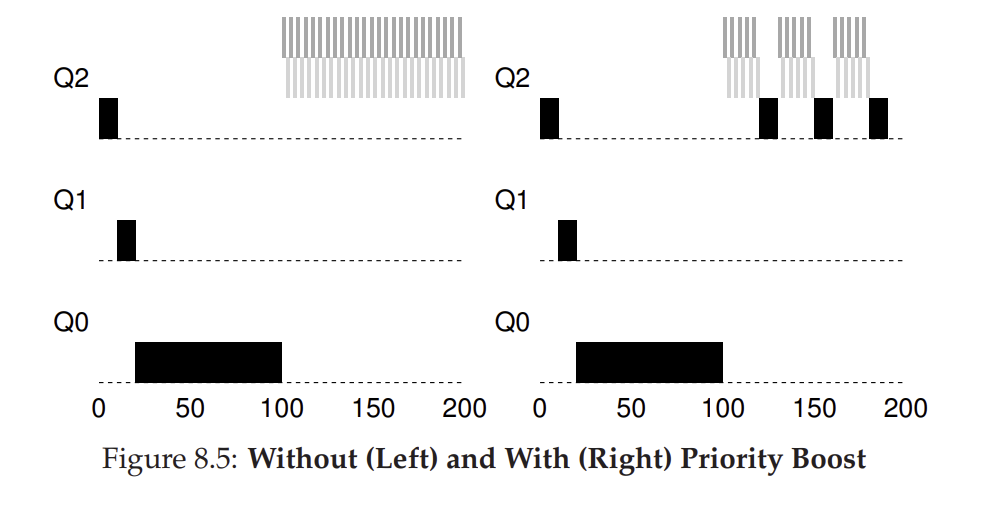
Starvation을 해결하기 위해 priority boost rule을 추가하였다.
-
Rule 5: After some time period S, move all the jobs in the system to the topmost queue.
$\rightarrow$ S의 시간 이후, 모든 job의 우선순위를 최우선순위로 초기화한다.
이 rule을 통해 우선순위가 낮아 실행을 하나도 못 했던 job도 우선순위가 높아져서 일정 주기로 한번은 CPU를 얻을 수 있게 되었다.
또, Program의 최근 성격을 바탕으로 우선순위가 변할 수 있게 되어서 문제 3까지 해결된다.
Gaming Scheduler 해결
하지만 Rule 5으로 일부로 IO을 계속 요청해서 우선순위를 높이고 CPU을 계속 할당받는 program은 막지 못한다. 이 이유는 rule 4a와 4b 때문이다. Time slice의 단위로 우선순위를 높이거나 낮추기 때문에 time slice 내에서만 속이면 우선순위가 계속 높을 수 있던 것이다.
따라서 time slice 내에서의 CPU 사용량이 아니라 누적 CPU 사용량을 통해 우선순위가 변할 수 있다면 gaming scheduler는 막을 수 있게 된다.
Rule 4a와 rule 4b을 하나의 rule 4로 합쳤다.
-
Rule 4: Once a job uses up its time allotment at a given level (regardless of how many times it has given up the CPU), its priority is reduced (i.e., it moves down one queue)
$\rightarrow$ CPU의 누적 사용량이 각 level의 기준보다 커졌다면 priority을 줄인다. 따라서, I/O 요청을 통해 time slice 내에서는 CPU을 적게 쓰더라도 우선순위가 낮아질 수 있다.