5: Multiprocessor Scheduler
Multiprocessor Scheduling
Multiprocessor 환경과 Single processor 환경은 매우 다르다. 이 차이점은 cache으로부터 온다.
Cache는 그저 locality을 기반으로 memory에 존재하는 정보를 빠르게 얻기 위해서 존재한다.
Memory의 값에 변경을 하였을 때도 우선 cache에 변경된 내용이 저장되고 나중에 변경사항이 적용된다.
$\rightarrow$ 바로 이 지점에서 Multiprocessor에서 문제가 생기는 것이다.
Multiprocessor는 각 CPU마다 하나의 cache을 가지지만 하나의 main memory을 공유한다.
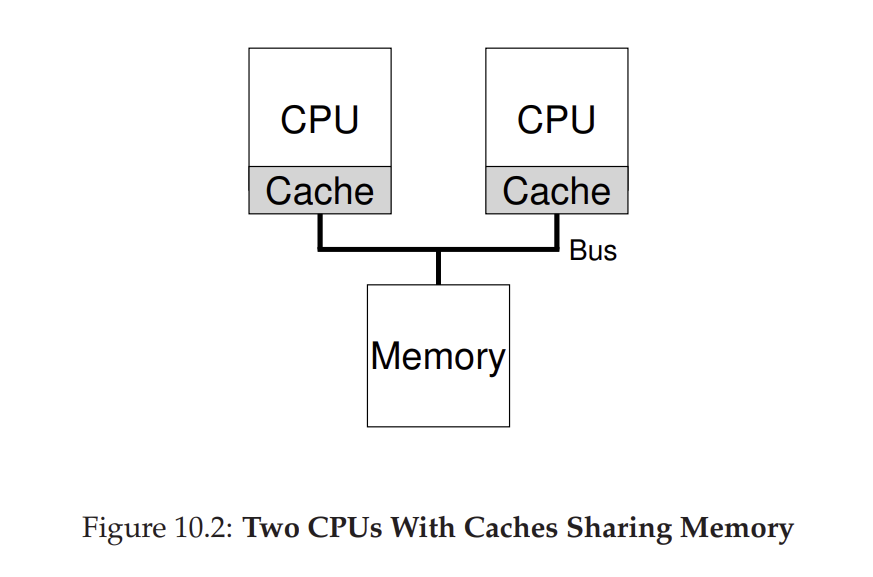
이때 CPU1이 address A에 있는 값 D을 읽은 다음 D’로 바꾼 뒤, cache에 저장했다고 해보자. 이 상황에서 CPU1이 멈추고 CPU2가 실행되고 Address A의 값을 읽으면 CPU2의 cache에는 address A에 대한 내용이 없기에 main memory에 접근하여 정보를 가져온다. 이때, D’ 값은 반영이 안 되었기에 D 값이 불러와진다. 즉, 의도치 않은 오류가 발생한다.
이런 문제를 cache coherence라고 한다. 이 문제를 해결하기 위해서는 hardware의 도움이 필요하다. 방법의 예시로는 bus snooping이 있다. 각 cache는 bus를 관찰해서 memory update가 발생하는지 관찰한다. CPU가 다른 CPU에서 자기 cache에 존재하는 값의 update를 감지하면 cache에 존재하는 것을 없애버리거나 자기 cache을 update된 값으로 변경하는 방법이다.
Multiprocessor에서는 synchronization 문제도 발생한다. 이 문제는 다양한 CPU가 하나의 main memory을 공유해서 생기는 것이다. 이런 문제를 아예 없애기 위해서는 program 측에서도 locking을 사용하여 한 CPU가 공유되는 자원에 접근을 하고 있을 때, 다른 CPU는 이 자원에 접근을 하지 못하게 막아야 한다.
마지막 문제는 cache affinity이다. 하나의 process가 특정 CPU에서 실행된다면, 그 process의 status의 일부분은 그 CPU의 cache에 저장된다. 따라서, process 입장에서 동일한 CPU에서 실행되면 더 빠르게 실행될 수 있다. 반면 process가 매번 실행될 때마다 CPU가 달라진다면, 속도가 매우 느려진다.
Single Queue Scheduling
Multiprocessor scheduling을 위해서 처리해야 하는 process들을 하나의 queue에 넣고 여러 processor들이 이를 관리한다고 해보자.
이 상황은 여러 개체가 하나의 자원을 공유할 때의 상황과 동일하다. 즉, Single queue scheduling에서는 locking을 사용해야 한다. 하지만 locking은 성능 저하를 일으키기 때문에 CPU의 수가 많아질수록 더 비효율적이게 된다.
Single queue로 multiprocessor scheduling을 구현해서 생기는 두 번째 문제는 cache affinity이다. 예를 들어 4개의 processor가 있고 처리해야 하는 process는 A,B,C,D,E 총 5개라고 하자.
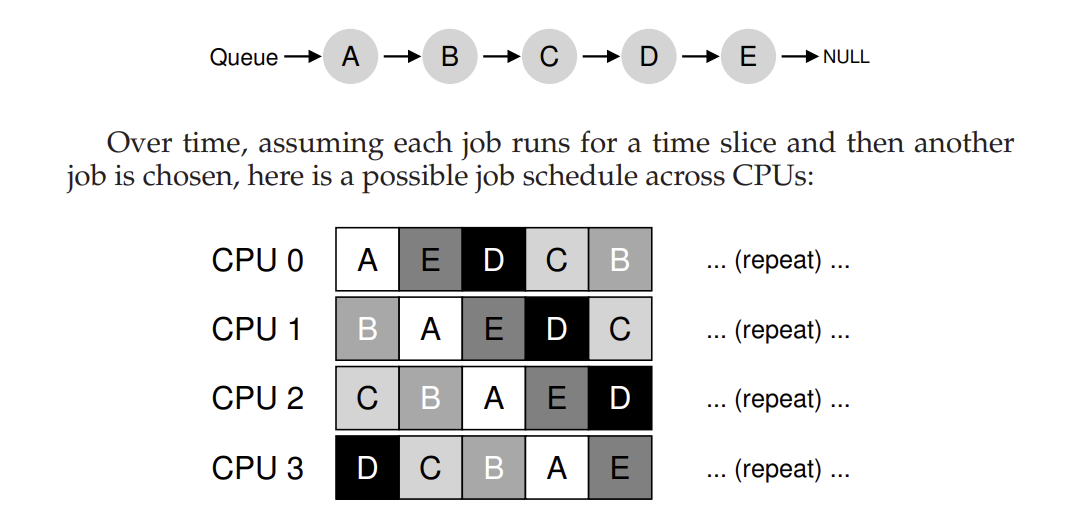
그렇다면 각 CPU에는 매번 다른 process가 실행되기 때문에 비효율적으로 process가 실행된다.
Single queue에서 이를 해결하기 위해서는 일부 process들을 특정 CPU에 할당시키고 다른 process들은 CPU 간 migration을 시켜서 모든 processor가 동일하게 돌아가도록 하는 방법을 사용한다.
Mutli Queue Scheduling
Single Queue scheduling에서 발생한 문제의 궁극적인 원인은 하나의 queue을 여러 processor들이 공유했기 때문이다.
따라서 CPU마다 하나의 queue을 할당하는 Multi queue scheduling은 single queue scheduling의 문제점들을 해결한다.
각 queue 안에서는 round robin이든 그 queue만의 scheduling policy가 진행되며 job가 system에 들어올 때 하나의 scheduling queue에만 들어간다. (어떤 queue에 들어가는지는 heuristic에 의거한다.)
즉, 각 queue에 존재하는 job들은 독립적으로 scheduling 되기 때문에 synchronization 등의 문제가 발생하지 않는다.
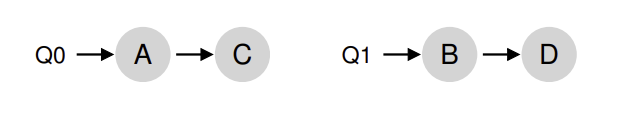
각 CPU는 자기 queue에 존재하는 job만 신경쓰면 되고 자기 queue에 할당된 process는 자기 CPU에만 실핼이 되기 때문에 cache affinity 문제도 발생하지 않는다.
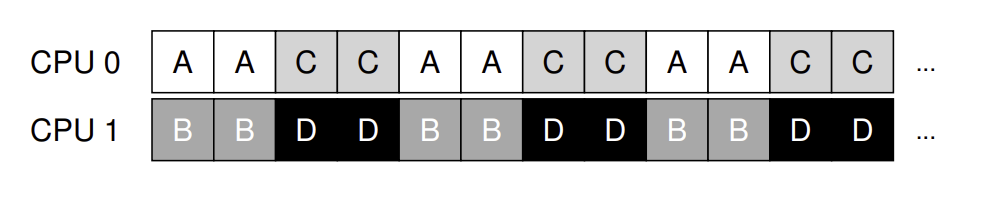
하지만 장점만 존재하는 것은 아니다. Multi Queue scheduling은 load imbalance 문제를 겪는다.
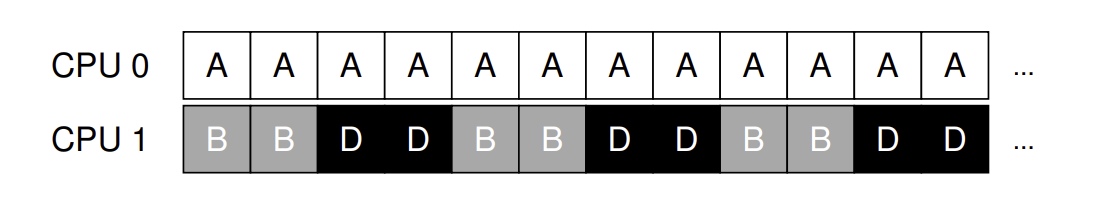
예를 들어 C가 먼저 끝나게 되어 Q0에 A만 존재하게 된다면, CPU0에는 A만 실행되어 B나 D보다 두 배의 CPU을 할당받는다. 즉, B,D 그리고 A는 모두 동일한 우선순위를 가지면서도 어떤 queue에 존재하는지에 따라 CPU 할당량이 달라지게 되므로 fair하지 않게 된다는 것이다. 또, A는 더 많은 CPU을 할당받게 되므로 Q0 또한 금방 비워질 것이므로 CPU0이 낭비되는 현상이 발생한다.
이런 문제를 해결하기 위해서 또 migration을 사용한다. CPU 0에서 일정 시간 A가 독차지하다가도 나중에는 B도 실행하고 A가 나중에는 CPU 1에서도 실행이 되는 등, continuous migration을 하는 것이다.
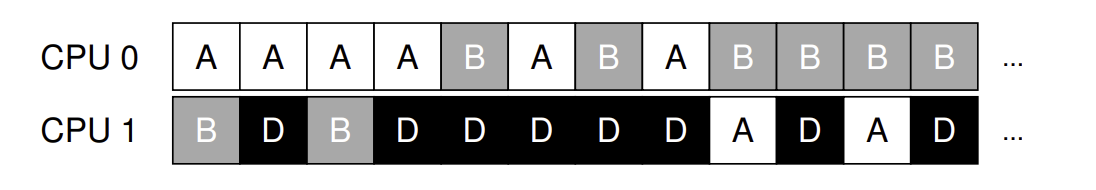
그렇다면 어떤 process가 migrate 할 지는 어떻게 결정할까?
이 결정은 work stealing으로 결정된다. Work stealing은 거의 비어진 queue 측에서 다른 queue들을 관찰하면서 어떤 queue가 너무 꽉차있다고 판단되면 job 몇 개를 가져와 자기 queue에서 scheduling을 하는 것이다.
Work stealing을 하기 위해서 다른 queue들을 너무 자주 관찰한다면 이 또한 overhead가 생긴다.