2: CPU Virtualization Limited Direct Execution
Mechanism for Time Sharing
Mechanism은 context switch처럼 한 process의 실행을 멈춰서 새로운 process을 실행할 수 있도록 해주는 기능이라고 하였다. 이때, CPU의 성능을 저하시키지 않기 위해서는 새로운 process으로 바뀌는 과정을 빠르게 해야 하며 OS가 CPU 사용 권한이 process에게 뺏기지 않도록 잘 제어해야 한다.
Direct Execution
우선, process 간의 전환을 빠르게 하기 위해서는 program을 빠르게 실행시키야 한다. Program을 빠르게 실행시키는 방법 중 하나는 Direct Execution이다. Direct Execution은 program 실행을 위한 모든 환경과 자원을 주는 것이다.
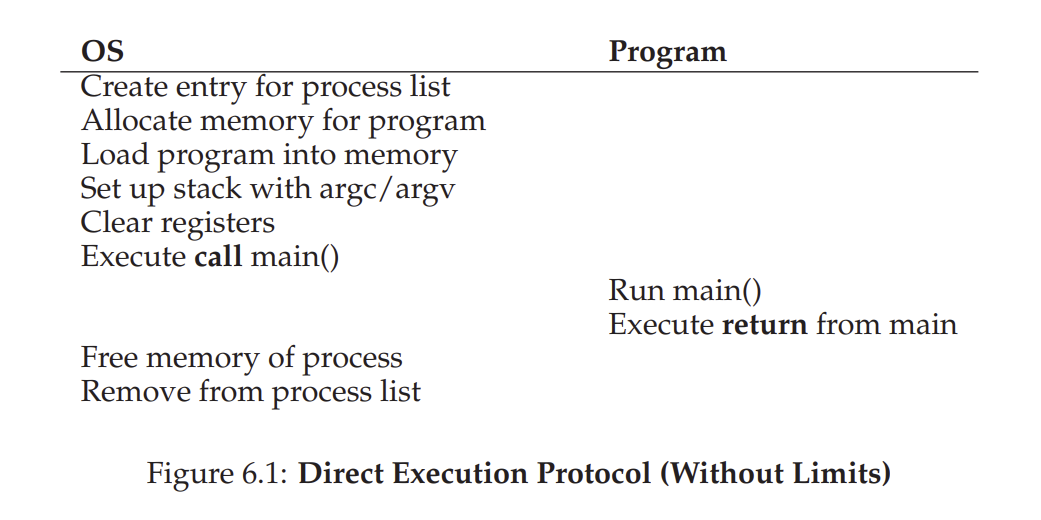
이 방법이 매우 간단해보이지만 Virtualization에는 적절하지 않다. 우선, virtualization이 가능하기 위해서는 각 process가 실행되는 동안에 허용된 행동만 할 수 있어야 하며 언제든지 CPU 자원이 뺏겨 멈추어지고 다른 process으로 넘어갈 수 있어야 한다. Direct Execution에서는 OS가 개입하지 않고 자원을 그대로 넘겨주기 때문에, process가 허용되지 않은 행동(예: 다른 process 메모리 접근)을 해도 막을 수가 없다. 또, OS가 CPU 제어권을 잃어버리기 때문에 언제든지 process를 멈추고 다른 process로 전환하는 time sharing이 불가능해진다.
따라서, time sharing이 가능하기 위해서는 program을 효율적으로 실행하는 동시에 program이 허용되지 않는 행동을 못하도록 막아야 하며 실행되는 program은 언제든지 CPU 자원이 뺏겨서 멈출 수 있어야 한다. 이것을 가능하게 하는 방법이 Limited Direct Execution이다.
Limited Direct Execution
Direct Execution Problem 1: Restricted Operations
Direct Execution의 문제점 중 하나는 Program이 모든 자원을 받기 때문에 disk에 직접적으로 접근하거나 I/O 요청을 main disk에 보내거나 더 많은 자원을 요청하게 될 수 있게 된다는 것이다. 즉, direct execution은 하나의 program에게 모든 권한을 넘겨주는 것이기 때문에 공용으로 사용하는 자원이 보호 받지 못한다는 문제점을 지닌다.
이를 해결하기 위해서 Limited Direct Execution은 process가 실행되기 전에 어떤 mode으로 실행될 지 정해준다. 이 mode는 user mode와 kernel mode으로 나뉜다. User mode에서는 제한된 행동을 하면 exception이 발생하고 그 process가 kill된다. 반대로 OS가 사용하는 mode인 kernel mode는 모든 행동을 다 할 수 있다.
그렇다면 모든 user mode process는 메모리 read 등과 같은 제한된 행동을 어떻게 수행할 수 있을까?
$\rightarrow$ 이는 System call으로 가능하다 System call은 kernel이 user mode process에게 요청한 일부분에 대한 권한을 주어서 user mode process도 제한된 행동을 할 수 있도록 해준다.
그러면 user mode process는 system call을 어떻게 실행하는가?
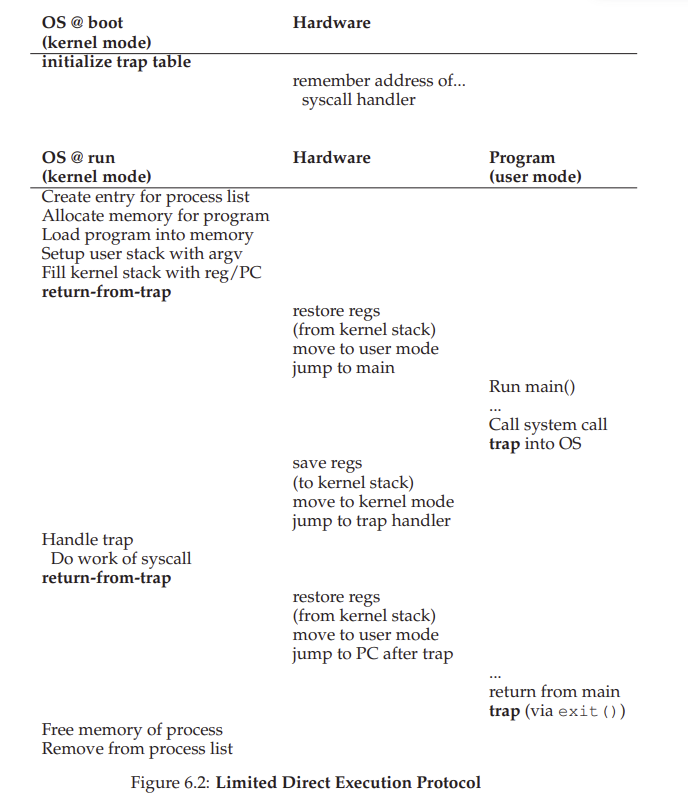
$\rightarrow$ User mode process가 system call읋 하기 위해서는 trap을 발생시켜야 한다. Trap이 발생되면 kernel이, 즉 OS가 user mode process가 원하는 행동을 수행해주고 return from trap을 통해 다시 user mode process으로 돌아간다.
Interrupt는 3가지로 나뉜다.
- Hardware Interrupt: keyboard, timer로 인해 발생하는 interrupt으로 해결되면 다음 instruction으로 돌아간다.
- Exception: CPU에 의해 발생한다. (divide by zero, page fault 등) 이 문제가 해결되면 동일한 instruction을 다시 시도한다.
- Trap: Software에 의해 발생하고 system call, overflow 등을 의미한다. 항상 다음 instruction을 실행한다.
이때, trap을 실행하면 return from trap을 통해 trap을 실행했을 때의 상태로 돌아가기 위해서는 trap caller의 정보를 hardware에서 기억해야 한다. 이런 정보의 예로는 PC, flag, registers 등이 있으며 각 process의 address space의 kernel stack에 저장된다. Return from trap으로 다시 되돌아올 때, kernel stack에서 이 정보들이 pop되어 원래의 상태로 다시 돌아가게 된다.
그렇다면 어떤 trap이 실행됐다는 정보가 주어졌을 때, OS는 어떤 code로 대처해야 하는지 어떻게 알까?
Trap을 호출한 process는 이 정보를 가지고 있으면 안 된다. 이 정보를 안다면 결국 이 process는 kernel mode의 일부분을 바로 수행할 수 있다는 뜻과 같기 때문이다.
$\rightarrow$ Kernel은 booting이 될 때 trap table을 hardware에게 전달한다. Trap table에는 trap 별로 대처 코드 (trap handler)의 위치가 담겨있다. 따라서 trap이 발생하면 hardware가 trap table로 trap에 맞는 trap handler의 주소를 OS에게 알려주고 OS는 그 위치의 코드를 kernel mode로 실행시켜서 trap을 해결하는 것이다.
전체적인 과정은 다음 diagram과 같다.
Direct Execution Problem 2:Switching between Processes
지금까지 자원을 받은 process가 허용된 행동만 하도록 제한하는 방법에 대해서 알아보았다. User mode와 kernel mode을 구분하고 일반적인 process는 user mode으로만 실행되도록 하여 자원을 다 받아도 행동이 제한되었다.
그렇다면 process 간의 전환을 하기 위해서는 OS가 process로부터 CPU를 다시 받아야 하는데 어떻게 받을까? 이게 문제인 이유는 Process가 실행 중이라는 뜻은 CPU가 user mode process에게 있고 OS는 실행이 안 되는 중이기에 OS는 아무것도 할 수 없기 때문이다. 즉, OS 혼자의 힘으로는 이 CPU를 받아낼 수 없는 것이다.
Cooperative Approach: Wait for System Call
긍정 회로를 돌리자면 Process가 kernel mode의 기능을 사용하기 위해 system call을 할 것이고 system call이 되면 OS가 CPU를 다시 돌려받으므로 문제가 없다고 생각할 수 있다. 따라서 그냥 기다리면 user mode process가 알아서 CPU를 줄 것이라고 생각할 수 있다. 실제로도 file을 읽거나 message을 보내기 위해서 system call이 자주 일어나기도 하고 yield라는 system call도 수행한다. yield()는 CPU 권한을 OS에게 넘겨주기만 하는 system call이다. 즉, OS는 그냥 기다리면 자주 CPU 권한을 얻을 것이라고 예상할 수 있다.
$\rightarrow$ 하지만 process가 inifinite loop에 빠지면 어떻게 할 것인가
이때의 유일한 해결책은 rebooting이다. Rebooting이 OS의 kernel mode을 활성화시킬 유일한 방법이기 때문이다.
Non-Cooperative Approach
즉, OS는 hardware의 도움 없이는 혼자서 process로부터 CPU 자원을 뺏지 못한다. Hardware의 도움으로 OS가 쉽게 CPU 자원 control을 얻도록 하는 방법을 Non-Cooperative approach라고 한다.
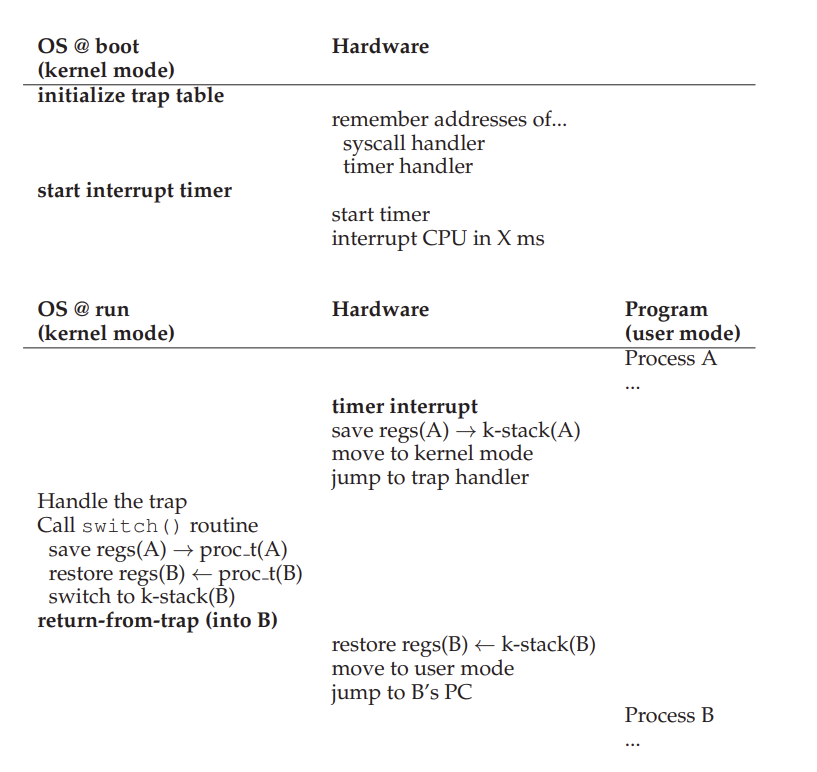
여기서 hardware의 도움으로는 timer interrupt을 사용한다. Timer로 매 millisecond마다 hardware interrupt을 일으킬 수 있다. 이 interrupt가 발생할 때마다 process는 OS에게 이 interrupt을 해결해달라고 CPU 자원을 OS에게 넘겨야 한다. OS는 넘겨받은 자원을 활용해 interrupt handler를 실행하고 interrupt을 해결하는 것이다.
이때, trap handler처럼 booting 때 OS가 hardware에게 interrupt 종류별 handler 위치가 담긴 interrupt table을 전달해준다. 또, booting 할 때 timer를 시작시켜야 한다.
여기서 추가로 생각해야 하는 것이 있다. Interrupt/trap handler을 실행했을 때 꼭 원래의 process으로 되돌아가야 하는가? Scheduler는 다음에 실행할 process을 결정한다고 했는데 scheduler가 다른 process을 실행하도록 했다면 꼭 그런 것은 아니다. 즉, scheduler가 다른 process을 실행하고자 하였을 때, context switch가 일어나야 한다.
더 자세히 설명하자면 OS(scheduler)가 동일한 process으로 돌아간다고 결정했다면 hardware에 의해 그 process의 정보 (user register state)가 kernel stack에 저장되고 OS가 다른 process을 실행하고자 결정하였다면, OS에 의해 그 process의 정보 (kernel register state)가 process의 PCB에 저장된다.