1: CPU Virtualization Introduction
CPU Virtualization: Introduction
OS가 제공하는 기능 중 CPU Virtualization은 여러 process들이 동시에 실행되는 것처럼 보이도록 해주는 기능이다. CPU Virtualization을 학습하기 전에 process의 정의부터 알아야 한다.
간단하게, Process는 실행되고 있는 program이고 program은 그냥 disk에 존재하는 instructions이다. 이 process가 실행되기 위해서는 CPU가 필요한데 어떻게 한 컴퓨터에서 여러 process들을 실핼할 수 있을까? (예를 들어 web browser을 키면서, mail도 보고, 음악까지 같이 들을 수 있는걸까)
이를 가능하게 하는 것은 time sharing이다. Time sharing은 여러 process에게 CPU을 쓸 수 있는 시간을 배분하여 조금씩 돌아가면서 실행되도록 하는 것이다. 이 과정이 빠르게 이루어지면 하나의 CPU로 여러 process가 실행되는 듯한 착각을 불러일으킬 수 있게 되는 것이다.
Time sharing을 구현하기 위해서는 low level machinery mechanism과 high level intelligence가 필요하다.
-
Mechanism
한 process의 실행을 멈춰서 새로운 process을 실행할 수 있도록 해주는 기능
Context switch가 이 영역에 들어간다.
-
Intelligence
한 process을 멈추고 새로운 process을 실행할 때 어떤 process을 골라야 하는지 결정해주는 정책을 의미
Scheduling policy가 이 영역에 들어간다.
Process
Process는 실행되는 동안 읽고 처리할 수 있는 정보인 machine state을 각자 갖고 있다. 당연한 예시로는 memory가 있다. Process가 사용하는 instructions나 읽는 data 모두 memory에 존재하기 때문이다. Process의 전용 memory을 Address space이라고 부른다.
또 다른 예시로는 register가 존재한다. Register 값의 예로 Program Counter (PC)는 현재 실행되고 있는 부분을 가리키는 역할을 하여 process의 진행 상태를 보여준다.
Process Creation
Program이 process가 되기 위해서는 어떤 과정을 겪어야 할까?
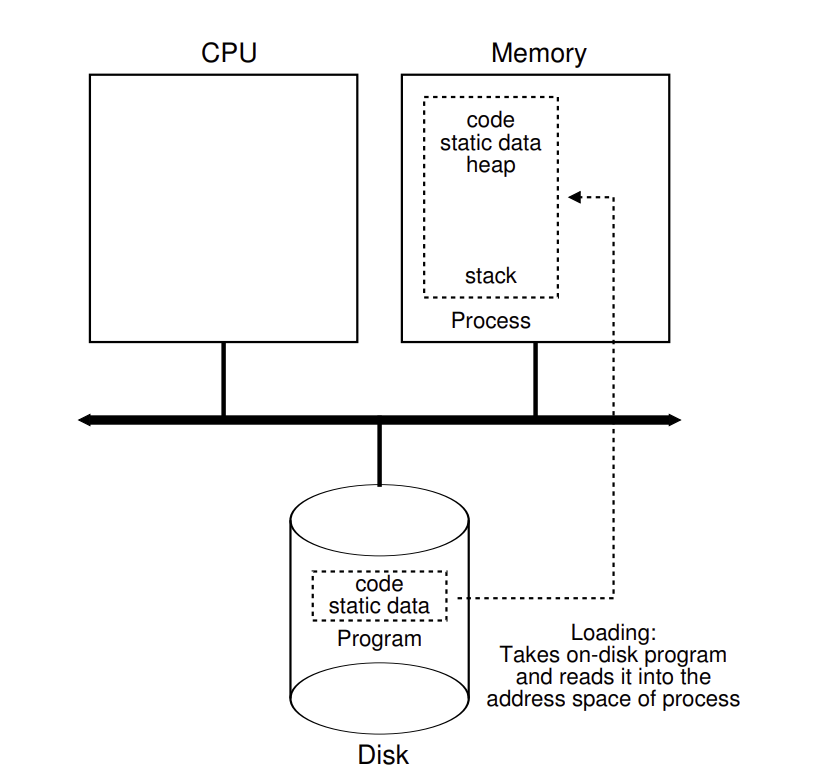
Program을 실행하기 위해서는 우선 program의 code와 static data을 process의 address space에 옮겨야 한다.
원래는 program을 실행하기 위해 필요한 것들을 한꺼번에 다 address space에 옮겼지만 이제는 그때 필요한 것만 옮긴다. (lazy loading)
Address space는 여러 영역으로 나뉘어져 있고 각 영역에 담기는 data의 성격은 다르다.
Code $\rightarrow$ Data $\rightarrow$ Heap $\rightarrow$ Blank space $\rightarrow$ stack으로 구성되어 있다.
Stack에는 local variable, function parameters, 함수들의 return address들이 담긴다. Heap은 process가 malloc()과 같은 함수를 통해 데이터가 들어갈 공간 할당을 요구할 때마다 늘어난다.
이렇게 OS에 의해 process의 address space가 할당되면 process가 되고 process에게 CPU 사용 권한을 넘겨주면 program의 main()부터 실행이 되어 process가 된다.
Process States
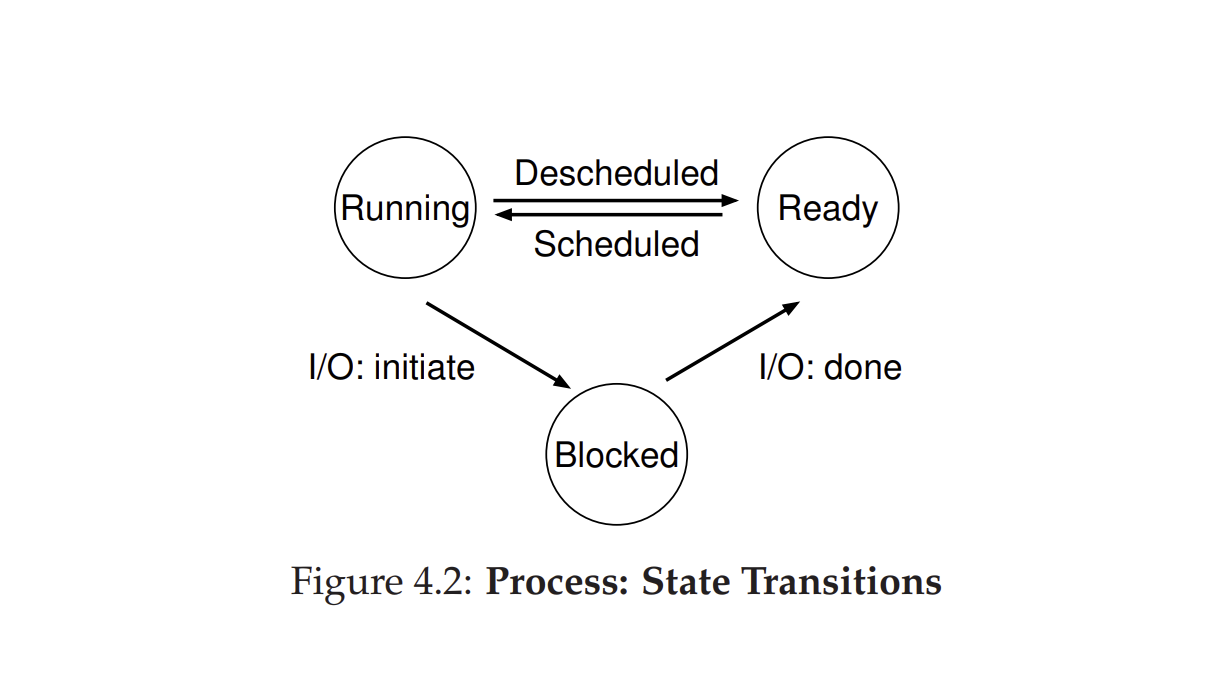
Process의 상태는 크게 3가지 + 특별한 케이스인 2가지가 존재한다.
-
Running
Process 실행 중인 상태
-
Ready
Process가 실행될 준비는 되었지만 아직 OS (Scheduler)에게 선택받지 못한 상태
-
Blocked
Process가 CPU가 필요없는 작업을 요청해서 CPU 사용 권한이 뺏긴 상태. Process가 I/O 작업을 요청했을 때 이런 상태에 들어간다.
-
Initial
Process가 막 생성된 상태
-
Zombie
Process가 종료되었지만 관련 정보가 지워지지 않은 상태
프로세스가 종료된 후에도 부모 프로세스가 wait()을 통해 자식의 return code를 확인해서 성공/실패 여부를 알 수 있도록 잠깐 유지되는 상태이기에 유용하다.
OS가 여러 process들을 관리하기 위해서는 process들을 관리할 데이터 구조가 필요하다. OS는 보통 process list을 통해 process들을 관리한다. Process list에 저장하는 process 정보들은 다음과 같다.
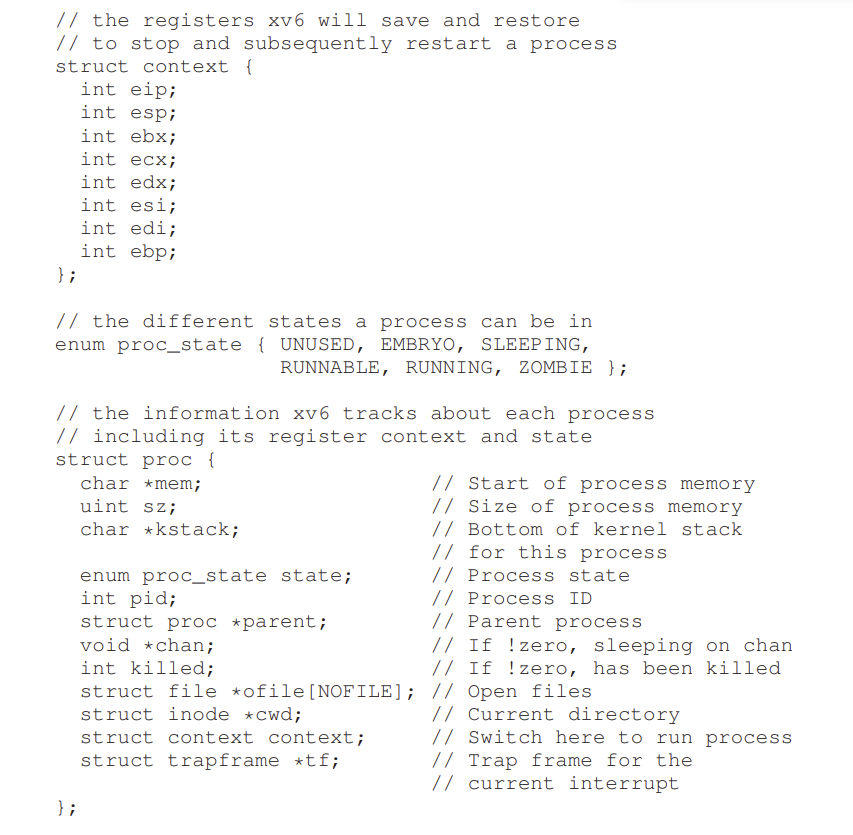
이런 하나의 process 정보를 담는 데이터 구조는 Process Control Block (PCB)라고 부른다.
Process API
Process을 이용하기 위해서는 Process API가 필요하다. 필요한 API의 종류는 크게 다음과 같다.
-
Create
Process의 생성에 필요한 API다.
-
Destroy
Process 실행 과정에서 멈추거나 없애는 API다.
-
Wait
특정 process가 끝날 때까지 기다리게 하는 API이다.
-
Miscellaneous Control
이미 존재하는 process들을 제어하고 관리하는 API이다.
-
Status
Process의 상태 정보를 가져오는 API이다.
실제 API 예시는 다음과 같다.
fork() system call
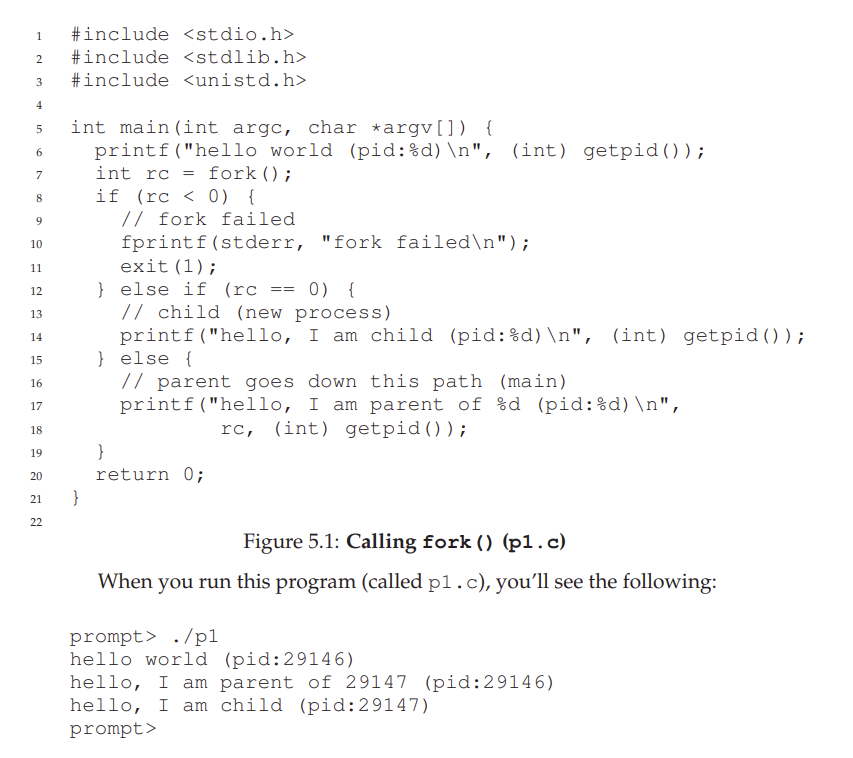
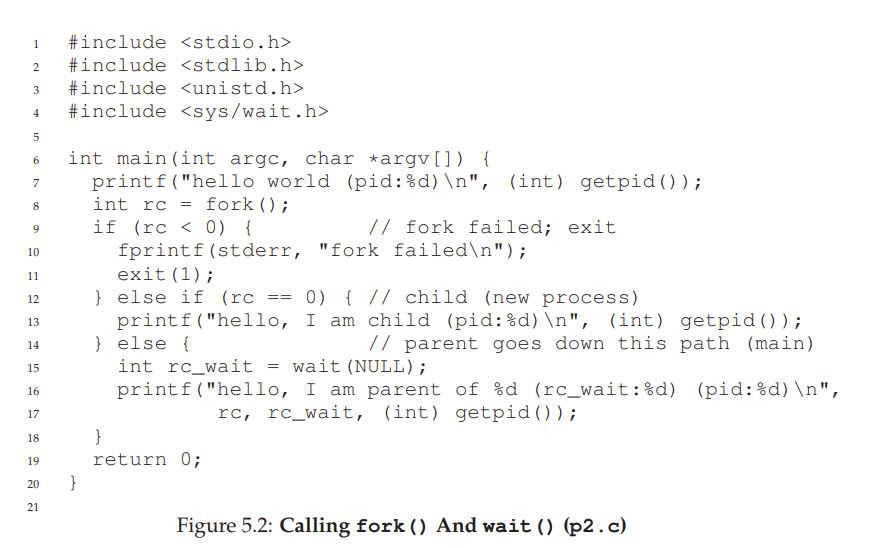
fork()는 process을 생성하기 위해서 사용하는 system call이다. 각 proces에게는 PID (Process indentifier) 값이 있는데 이는 process을 구분하기 위한 값이라고 보면 된다.
-
fork()을 통해 생성된 process을 child, fork()을 호출한 process는 parent이라고 부른다.
-
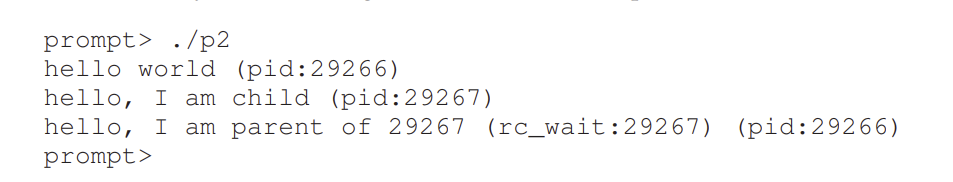
Child process는 parent process와 거의 동일하며 main()부터 실행되는 것이 아니라 생성된 시점, 즉 fork() 호출이 되어 이제 막 return 할 때쯤부터 실행된다. 따라서 실행결과를 보면 “hello world”가 한번만 나온 것이다.
-
Child에게는 fork()의 return 값이 0이고 parent에게는 fork()의 return 값이 양수이기에 child와 parent는 코드에서 서로 다른 부분을 실행한다.
-
Child process가 parent와 완전히 같은 것이 아닌 이유는 PID 값을 통해 알 수 있다. 즉, 어떻게 보면 다른 process인 것이다. 실제로, Child는 parent와 독립적인 address space와 registers을 가지고 있다.
-
또, child와 parent가 있을 때, 둘 중 어떤 것이 먼저 실행될 지는 scheduler가 결정하는 것이기에 이 코드의 실행 결과는 deterministic하지 않다.
wait() system call
Parent가 child가 끝날 때까지 기다리도록 해주는 system call을 wait()라고 한다.
- 따라서 wait()을 사용하면 실행 결과는 무조건 child가 끝난 뒤에 parent가 실행되기에 deterministic 해진다.
exec() system call
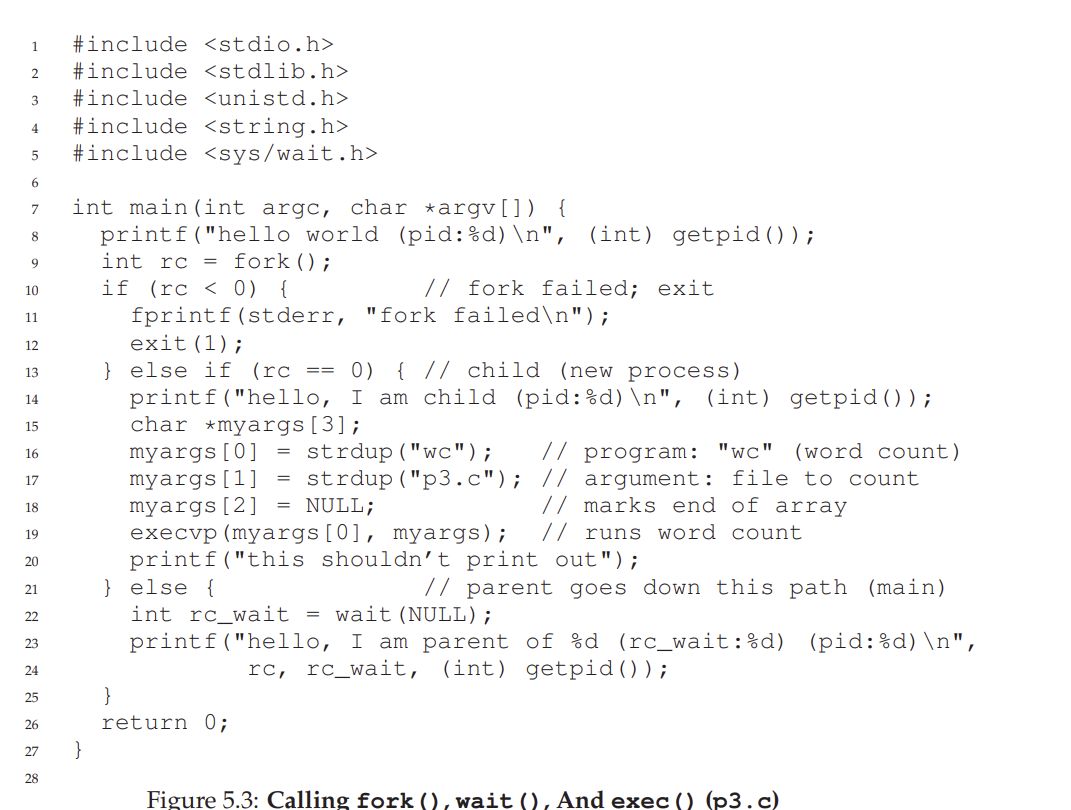
지금 실행되는 program과 다른 program을 실행하고 싶을 때 사용되는 system call이다. fork()와 다른 점은 fork()은 동일한 프로그램의 copies을 만들어서 실행하는 것이고 exec()는 아예 다른 program을 실행하는 process을 만들기 위해서 사용되는 것이다.
-
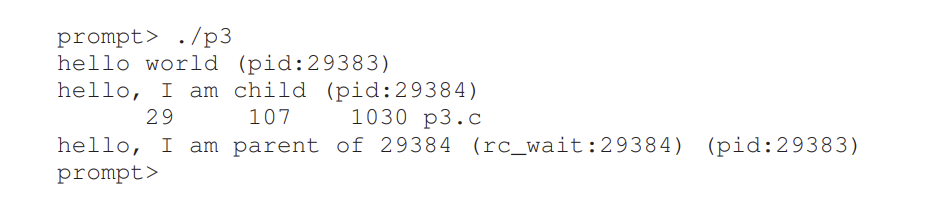
여기서는 execvp()을 사용하는데 executable의 이름과 arguments가 주어졌을 때, 그 프로그램에 필요한 코드, data, heap, stack 등을 초기화해서 아예 새로운 program (word count: wc)을 실행해주는 system call이다.
-
exec()가 성공적으로 호출되면 return 값은 아예 없고 그 뒤의 코드는 실행되지 않는다.