6: Address Spaces
Address Spaces
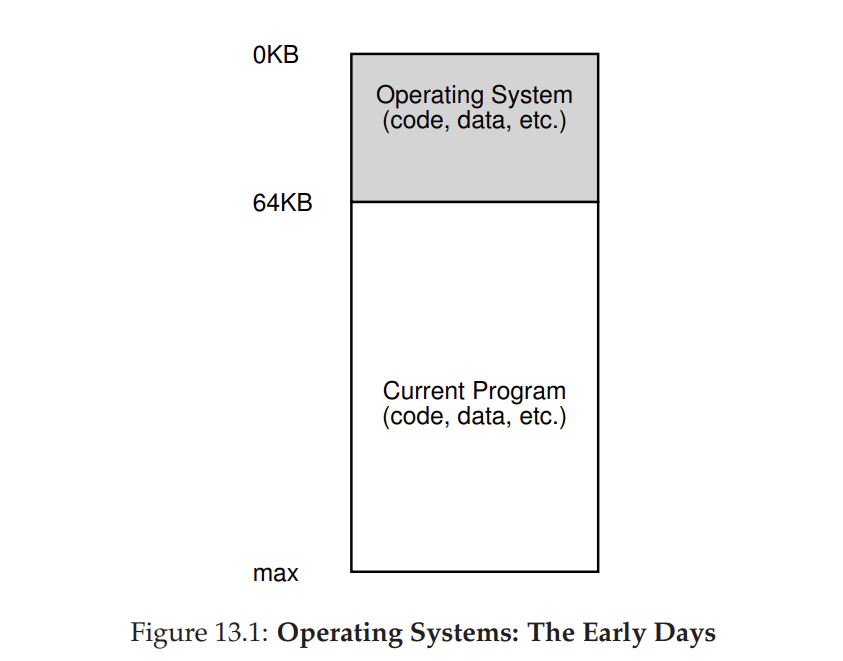
초기에는 memory의 abstraction이 user에게 제공되지 않았었다. OS 안에는 그저 library만 존재하고 running program은 나머지 공간을 다 사용하는 구조였다.
하지만 한 machine에서 여러 process을 돌리고자 하는 추세로 인해 memory에도 time sharing이 필요해졌다. 이를 구현하기 위해 처음에는 CPU time sharing처럼 process마다 memory에 대한 모든 권한을 주고 switch 될 때 process의 내용을 disk 에 저장하는 방법을 사용하였다.
이때 memory는 RAM, disk는 hard disk을 의미한다
하지만 switch 할 때마다 disk에 저장하는 과정은 너무 느리기 때문에 성능 저하가 발생하였다.
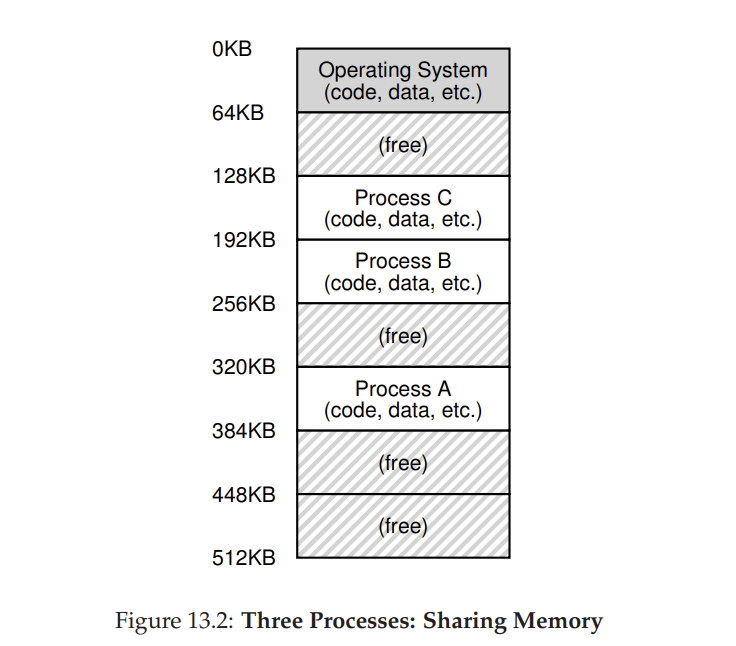
Process의 정보를 disk에 저장하는 방법에서 벗어나기 위해 처음부터 physical memory의 일부분을 각 process에게 나누어줘서 process만의 memory로 사용하게 하였다. 하지만 이 방법에서 생기는 문제점은 process의 memory 접근 능력이 다른 process의 memory을 침범할 수 있다는 것이다. 즉, process의 memory가 독립적이지 못하고 보호를 받지 못했다.
이를 해결하기 위해 address space라는 개념이 사용되었다. 각 process가 접근하는 memory 영역을 address space라는 단위로 추상화하여 이 영역에만 접근할 수 있게 한 것이다.
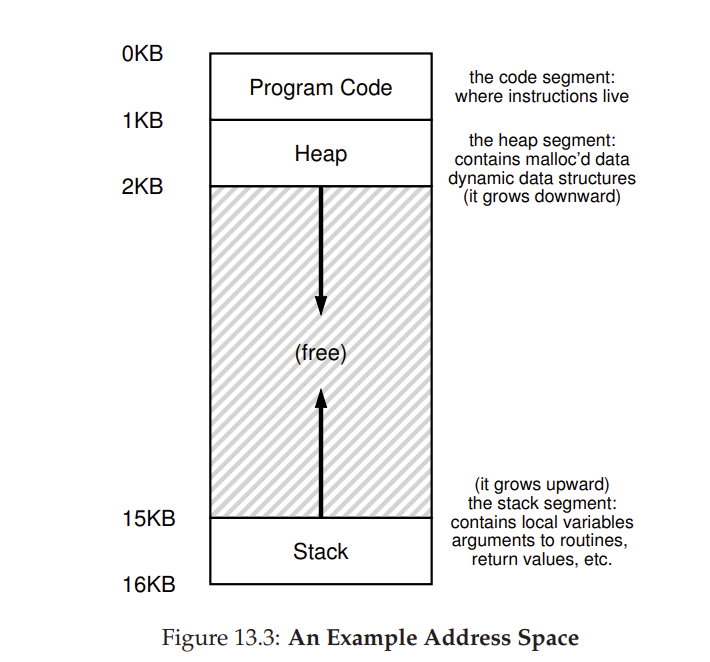
Addresss space는 memory처럼 code, data, heap, stack으로 이루어져있다.
code와 data는 static하여 변하지 않기에 맨 위에 두고 시간에 따라 크기가 변하는 heap과 stack은 아래에 두었다. Heap에는 malloc()으로 인해 새로 할당된 공간이 저장되고 stack에는 local variable이나 function call들이 저장된다.
그렇다면 이 address space으로 정확히 어떻게 memory virtualization을 하는걸까?
Process가 자기의 address space의 address 0에 접근한다고 하자. 그렇다고 해서 진짜 physical memory의 address 0에 접근하는 것이 아니다. 사실은 physical address에 다른 주소에 접근한다. 즉, process 입장에서는 자기가 memory을 독차지하고 있다고 생각하지만 사실은 하나의 physical memory을 공유하는 것이다. 이것이 바로 memory virtualization이다.
Memory virtualization의 목표는 3 가지이다.
-
각 process가 자기만의 private physical memory가 존재한다고 믿도록 하는 것이다.
-
메모리 사용 효율성을 높이는 것이다.
-
각 Process의 memory을 다른 process들로부터 보호하는 것이다.