기학원 Week 2 Regression 정리
Regression
Regression은 데이터를 제일 잘 표현하는 모델 (linear / polynomial)을 찾는 것이다.
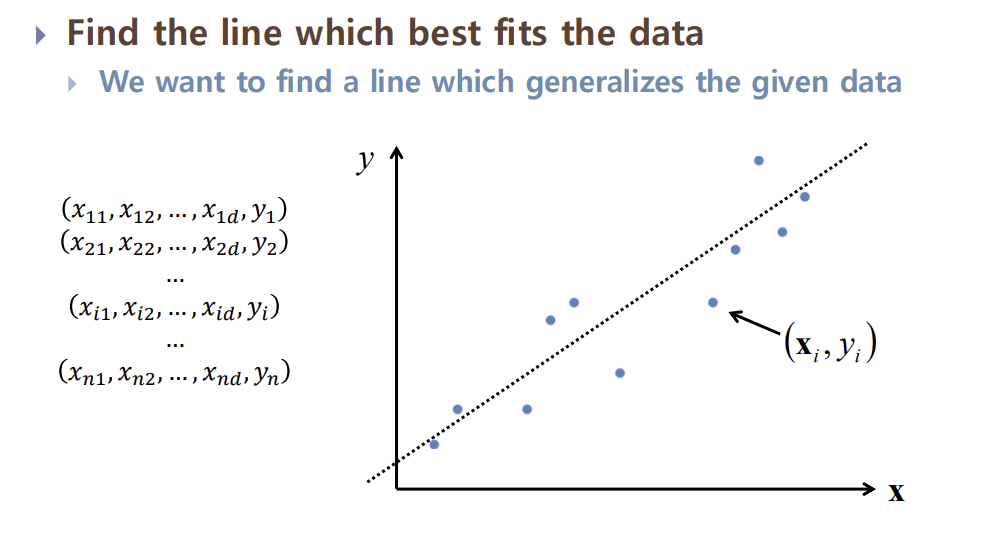
그렇다면 제일 잘 표현한다는 것은 무슨 뜻일까?
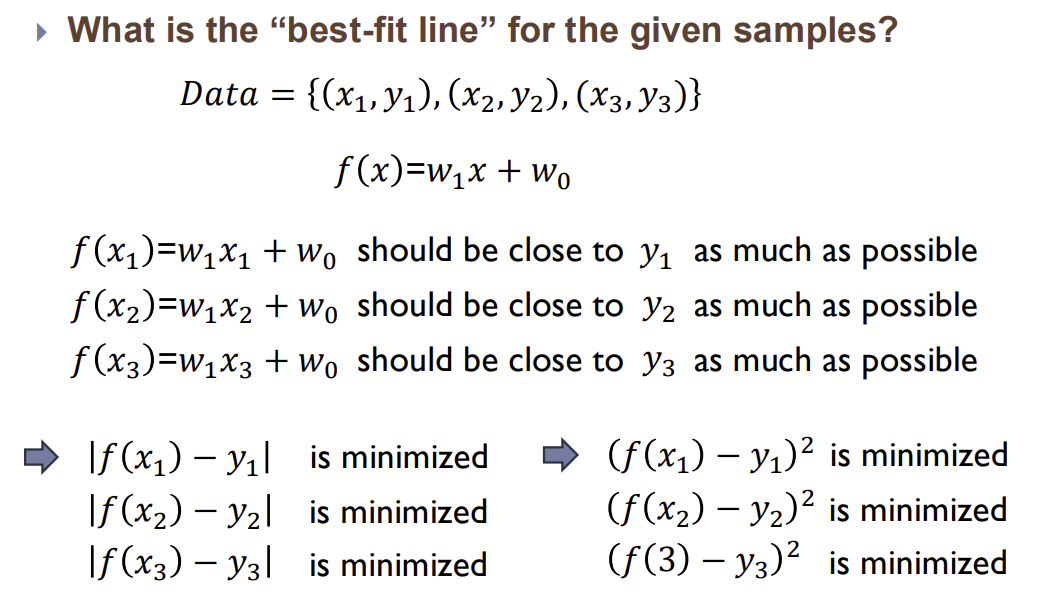 모델이 $f(x) = w_1x + w_0$이라고 할 때 Regression의 관점에서 제일 잘 표현 (fit) 하는 모델은 모델 f(x)와 모든 데이터 간의 거리의 합이 최소인 모델이다.
이 E 값을 최소화하는 w을 값을 구하는 것이 regression의 목표이다.
최적의 w을 구하는 방법 1: E을 전개해서 편미분을 사용하는 방법
이 w을 구하는 방법은 여러 방법들이 존재한다. 그 중에서 가장 이해하기 쉬운 것은 편미분을 사용하는 것이다.
E을 전개하면 $w_1, w_0$에 대한 이차함수가 나오는데 E을 각 변수에 대해 미분하여 0이 되게 하는 w값을 구하면 된다.
\[\frac {\partial E} {\partial w_1} = 0\] \[\frac {\partial E} {\partial w_0} = 0\]이때, E는 w에 대한 함수라는 것을 잊으면 안된다. 즉, 이 방법은 E가 w에 대해 linear일 때만 적용할 수 있다. 따라서 $f(x) = w_1 x^2$ 이든 $f(x) = w_1\sin(\pi x)$의 형태로 되어있든 x에 대한 것은 신경쓰지 않아도 된다. 결국 $E = \sum_{(x,y) \in \text{Data}} (y - (f(x)))^2$이기에 w에 대한 이차함수가 된다.
최적의 w을 구하는 방법 2: Quadratic Function Optimization AX=B
이 방법은 편미분을 하는 방법을 더 간단하게 표현하고자 하는 방향으로 전개하면 유도할 수 있다.
Regression의 목표는 다음과 같이 볼 수 있다.
$w = (w_0, w_1, .., w_d)$가 있을 때, $E(w) = \sum_{i=1}^{n} (f(x_i)-y_i)^2$을 최소화하는 w을 구하는 것이다.
이때, $f(x_i)$의 형태는 보통 $f(x_i) = w_0 + w_1x_{i1} + w_2x_{i2} … + w_d x_{id}$ 인데 $x_{i0}$은 항상 1이라는 가정 하에 형태를 다음과 같이 표현할 수 있다
\[f(x_i) = w_0x_{i0} + w_1x_{i1} + w_2x_{i2} ... + w_d x_{id} = \sum_{j=0}^{d} w_jx_{ij}\]이대로 E을 $w_j$에 대해 편미분한다고 할 때 식은 다음으로 고정된다.
\[\frac{\partial} {\partial w_j} E(w) = \sum_{i=1}^{n} \frac{\partial} {\partial w_j} (f(\mathbf{x}_i) - y_i)^2 = \sum_{i=1}^{n} 2(f(\mathbf{x}_i) - y_i) x_{ij} = 0\]방법 1처럼 다 전개해서 풀어도 되지만 w의 개수가 많아질수록 계산량이 복잡해진다.
\[\sum_{i=1}^{n} x_{i0} (f(\mathbf{x}_i) - y_i) = 0\] \[\sum_{i=1}^{n} x_{i1} (f(\mathbf{x}_i) - y_i) = 0\] \[\vdots\] \[\sum_{i=1}^{n} x_{id} (f(\mathbf{x}_i) - y_i) = 0\]이는 결국 다음과 같다.
\[\sum_{i=1}^{n} x_{i0} (w_0 x_{i0} + w_1 x_{i1} + \dots + w_d x_{id} - y_i) = 0\] \[\sum_{i=1}^{n} x_{i1} (w_0 x_{i0} + w_1 x_{i1} + \dots + w_d x_{id} - y_i) = 0\] \[\vdots\] \[\sum_{i=1}^{n} x_{id} (w_0 x_{i0} + w_1 x_{i1} + \dots + w_d x_{id} - y_i) = 0\]이때, 이를 w에 대해서 정리하면
\[w_0 \sum_{i=1}^{n} x_{i0} x_{i0} + w_1 \sum_{i=1}^{n} x_{i0} x_{i1} + \dots + w_d \sum_{i=1}^{n} x_{i0} x_{id} = \sum_{i=1}^{n} x_{i0} y_i\] \[w_0 \sum_{i=1}^{n} x_{i1} x_{i0} + w_1 \sum_{i=1}^{n} x_{i1} x_{i1} + \dots + w_d \sum_{i=1}^{n} x_{i1} x_{id} = \sum_{i=1}^{n} x_{i1} y_i\] \[\vdots\] \[w_0 \sum_{i=1}^{n} x_{id} x_{i0} + w_1 \sum_{i=1}^{n} x_{id} x_{i1} + \dots + w_d \sum_{i=1}^{n} x_{id} x_{id} = \sum_{i=1}^{n} x_{id} y_i\]이 식들을 matrix으로 정리하게 된다면 엄청 간단하게 풀 수 있게 된다.
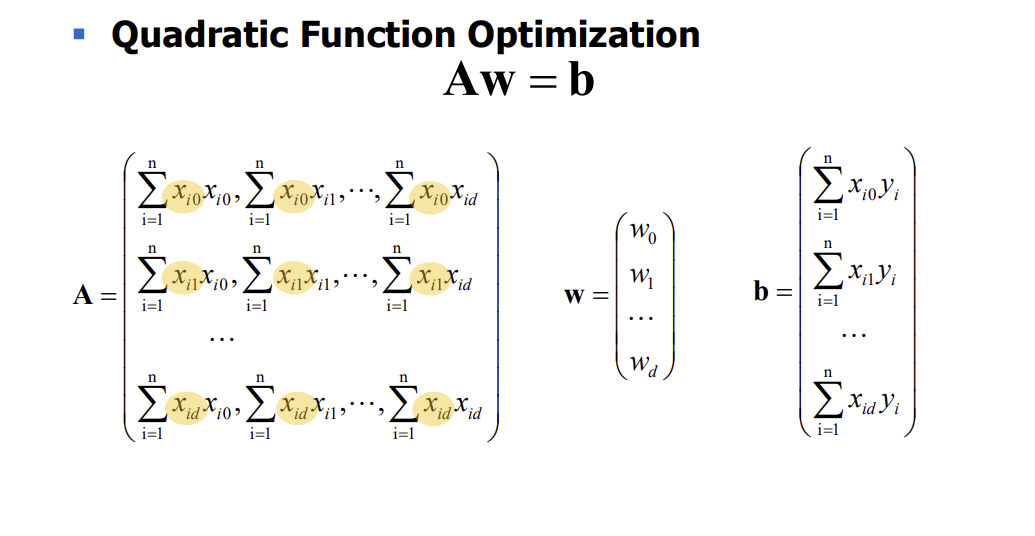
X을 다음과 같다고 하자.
\[X = \begin{pmatrix} x_{10} & x_{11} & x_{12} & \dots & x_{1d} \\ x_{20} & x_{21} & x_{22} & \dots & x_{2d} \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ x_{n0} & x_{n1} & x_{n2} & \dots & x_{nd} \end{pmatrix}\]그럼 A는 결국 다음과 같아지는 것을 알 수 있다.
\[A = X^T X = \begin{pmatrix} \sum_{i=1}^n x_{i0}x_{i0} & \sum_{i=1}^n x_{i0}x_{i1} & \dots & \sum_{i=1}^n x_{i0}x_{id} \\ \sum_{i=1}^n x_{i1}x_{i0} & \sum_{i=1}^n x_{i1}x_{i1} & \dots & \sum_{i=1}^n x_{i1}x_{id} \\ \vdots & \vdots & \ddots & \vdots \\ \sum_{i=1}^n x_{id}x_{i0} & \sum_{i=1}^n x_{id}x_{i1} & \dots & \sum_{i=1}^n x_{id}x_{id} \end{pmatrix}\]반면, y을 다음과 같다고 하자.
\[Y = \begin{pmatrix} y_1 \\ y_2 \\ \vdots \\ y_n \end{pmatrix}\]그렇다면 b는 다음과 같아짐을 알 수 있다.
\[b = X^T Y = \begin{pmatrix} \sum_{i=1}^n x_{i0} y_i \\ \sum_{i=1}^n x_{i1} y_i \\ \vdots \\ \sum_{i=1}^n x_{id} y_i \end{pmatrix}\]따라서 E(w)을 최소화하는 w을 찾는 방법은 다음과 같아진다
\[Aw = b\] \[(X^TX) w = X^TY\] \[w = (X^TX)^{-1}(X^TY)\]예시를 보자
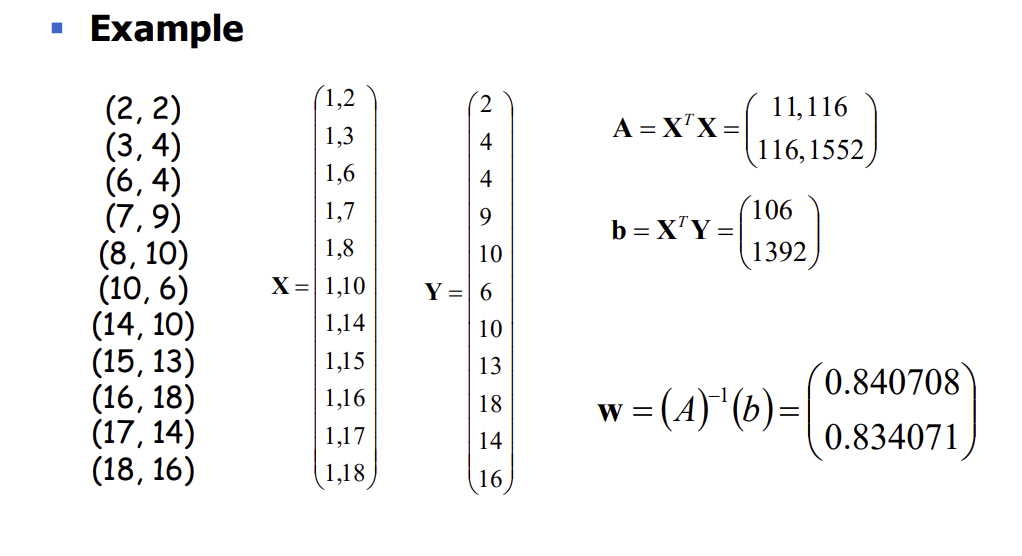
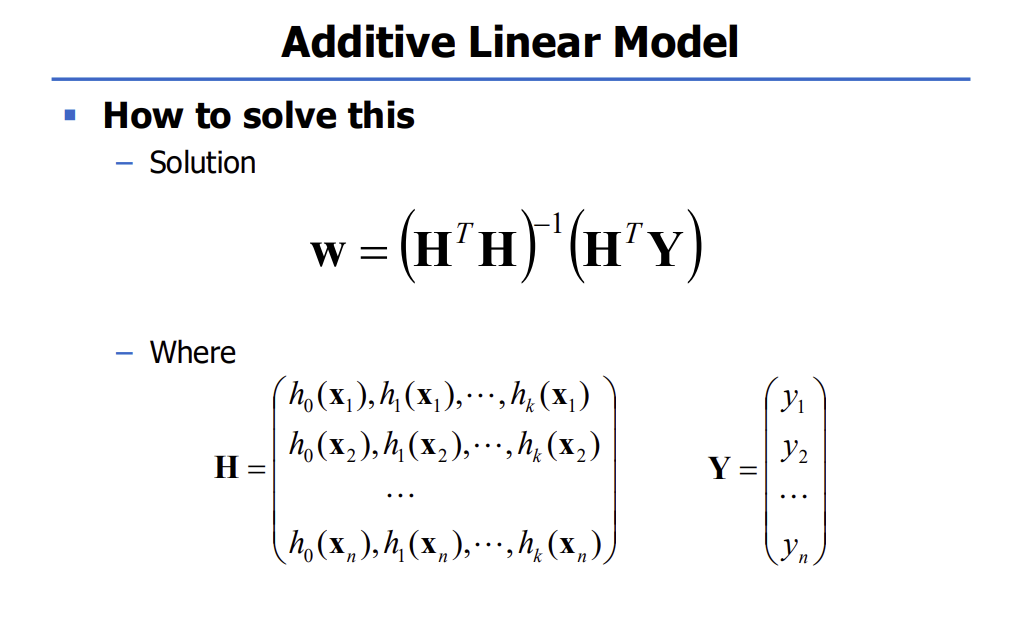
Additive Linear Model
E(w)는 w에 대한 함수이기에 x가 어떤 형태로 되어있는 신경을 쓰지 않아도 된다고 하였다.
\[f(\mathbf{x}) = w_0 + \sum_{j=1}^{d} w_j x_j = w_0 x_0 + w_1 x_1 + w_2 x_2 + \dots + w_d x_d\]따라서 더 generalize하기 위해서 x 부분을 그냥 x에 대한 함수 h(x)으로 바꿨다.
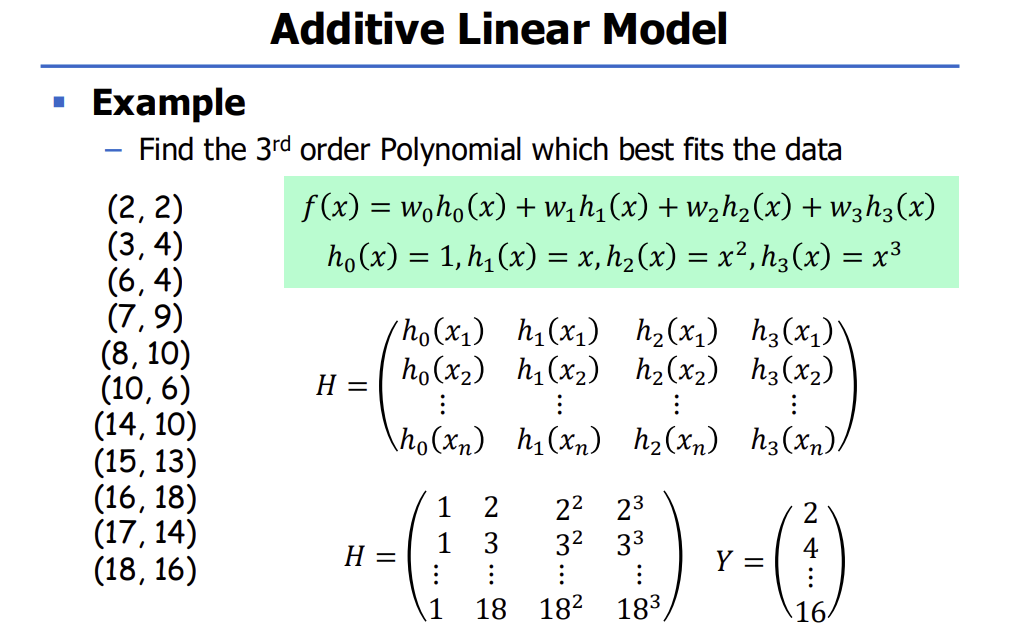
\[f(\mathbf{x}) = w_0 + \sum_{j=1}^{d} w_j h_j(\mathbf{x}) = w_0 h_0(\mathbf{x}) + w_1 h_1(\mathbf{x}) + w_2 h_2(\mathbf{x}) + \dots + w_d h_d(\mathbf{x})\]이를 additive linear model이라고 한다. Additive linear model에서도 Quadratic Function Optimization AX=B을 적용할 수 있다.
이를 적용한 예시는 다음과 같다
최적의 w을 구하는 방법 3: Gradient Descent
지금까지의 최적 w을 구하는 방법들은 E(w)가 w에 대해서 linear하다는 전제 하에 적용이 된다. 하지만 E(w)가 w에 대해서 무조건 linear 안 할 수가 있다. 예를 들어 $f(x) = w_0 +e^{w_1x_1} + sinw_2x_2$인 경우가 있다.
\[E = \sum_{(x,y) \in \text{Data}} (y - (f(x)))^2\]이렇게 되면 E(w)은 w에 대해 non-linear하게 되므로 방법 1,2을 적용할 수 없다. 그렇다면 최적의 w을 구할 수 있나..?
$\rightarrow$ 구할 수 있다. 왜냐하면 E는 그래도 w에 대해서 convex (이차함수 모양)이기 때문이다. 즉, 명확한 최솟값을 갖기 때문이다. 하지만 방법 1,2과 다른 점은 정확한 정답을 구할 수는 없다는 것이다.
방법 1,2는 명확한 절대적인 최솟값을 갖게 하는 w을 구했다면
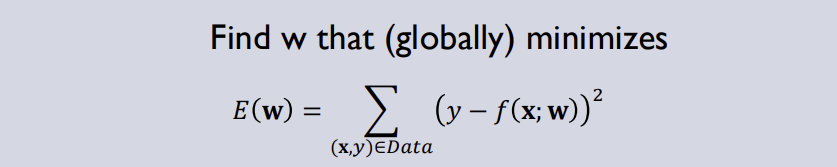
방법 3은 명확하진 않지만 주변보단 최솟값, 즉 local minimum을 갖게 하는 w을 구하는 과정인 것이다.
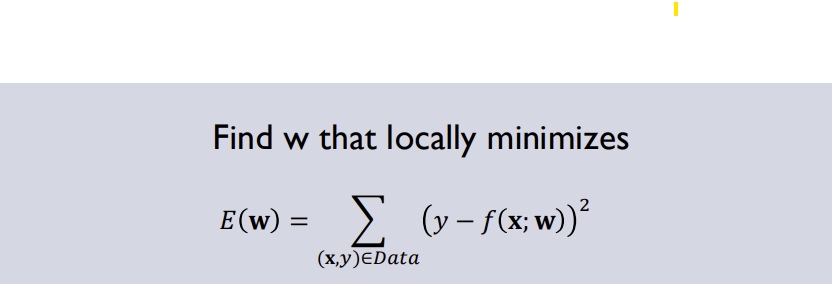
이 방법 3을 Gradient Descent Method이라고 부른다.
- 임의의 시작점 $w^0$을 정한다
- t = 0
-
다음 과정을 stopping condition에 도달할 때까지 반복한다 \(w^{t+1} = w^t - \eta \frac {dE} {dw}_{w = w^t}\)
\[t = t+1\]
이때, stopping condition은 gradient의 크기가 너무 작아 변화가 안 일어나거나, 일정 반복 횟수에 도달했을 때를 의미한다.
Multivariate case, 즉 w가 예를 들어 $w_0^0, w_1^0$으로 이뤄졌다고 할 때도 마찬가지로 적용하면 된다.
- 임의의 시작점 $w_0^0, w_1^0$을 정한다
- t=0
-
다음 과정을 stopping condition에 도달할 때까지 반복한다 \(w_0^{t+1} = w^t - \eta \frac {dE} {dw_0}_{w_0 = w_0^t, w_1 = w_1^t}\)
\[w_1^{t+1} = w^t - \eta \frac {dE} {dw_1}_{w_0 = w_0^t, w_1 = w_1^t}\] \[t = t+1\]
Gradient Descent Method을 하기 위한 가장 직관적인 방법을 소개한다
$f(x; w_0, w_1) = w_1x + w_0$으로 dataset $D = (0,0), (1,1), (1,2)$을 제일 잘 표현하는 w을 구한다고 해보자.
그러면 우선 E의 정확한 식을 구한다
\[E(w_0, w_1) = (0 - f(0; w_0, w_1))^2 + (1 - f(1; w_0, w_1))^2 + (2 - f(1; w_0, w_1))^2\] \[E(w_0, w_1) = (0 - w_0)^2 + (1 - (w_1 + w_0))^2 + (2 - (w_1 + w_0))^2\] \[E(w_0, w_1) = 2w_1^2 + 3w_0^2 - 6w_1 - 6w_0 + 4w_1w_0 + 5\]Gradient descent에 적용하기 위해서는 $\frac {dE} {dw_0}$와 $\frac {dE} {dw_1}$을 각각 구해야 하기 때문에 구한다면
\[\frac {\partial E} {\partial w_0} = 4w_1 + 6w_0 - 6\] \[\frac {\partial E} {\partial w_1} = 4w_1 + 4w_0 - 6\]이렇게 구한 gradient들을 대입
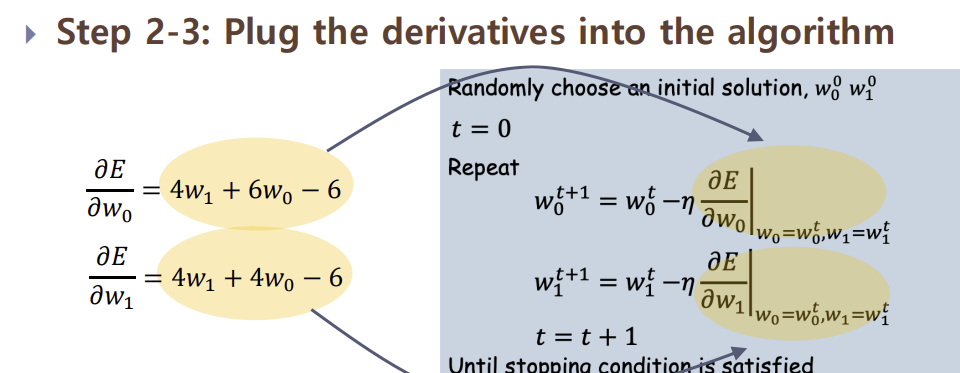
이 예시는 데이터의 개수가 3개라서 금방 구했다. 하지만 데이터 개수가 많아진다면 어떻게 될까? E의 식은 다음과 같다
\[E(w_0, w_1) = \sum_{(\mathbf{x}_i, y_i) \in Data} (y_i - f(\mathbf{x}_i; w_1, w_0))^2\]이때, data 수가 엄청 많다면 E의 정확한 식을 다 전개해야 하기 때문에 너무 복잡해진다. 또 다 전개한 식을 각 variable w에 대해 미분해야 해서 계산이 어려워진다.
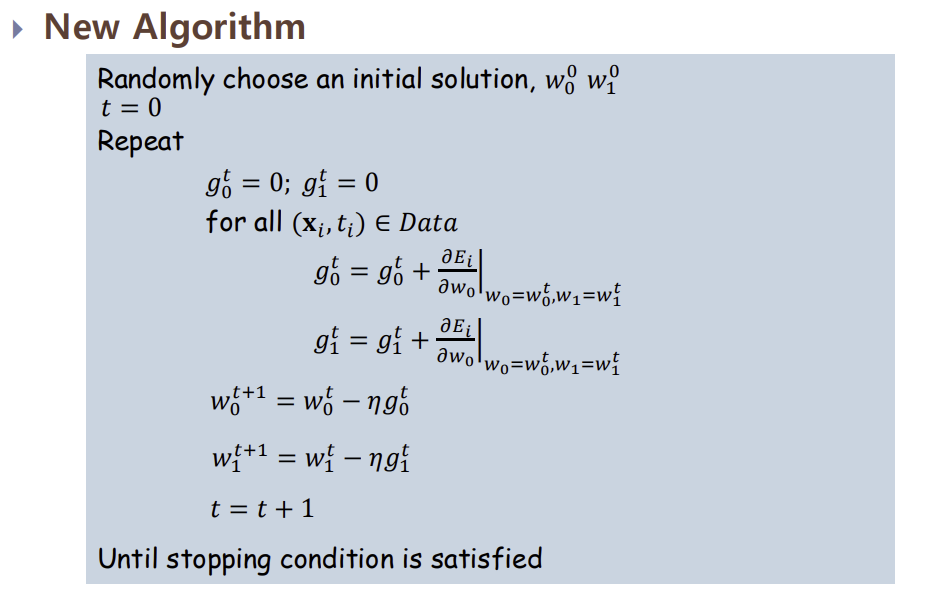
이를 해결하기 위해 E의 정확한 식을 얻지 않고도 미분을 먼저 적용하면 된다.
\[E_i(\mathbf{x}_i, y_i; w_1, w_0) = (y_i - f(\mathbf{x}_i; w_1, w_0))^2\] \[\frac{\partial}{\partial w_j} E(w_0, w_1) = \frac{\partial}{\partial w_j} \sum_{(\mathbf{x}_i, y_i) \in Data} E_i(\mathbf{x}_i, y_i; w_1, w_0) = \sum_{(\mathbf{x}_i, y_i) \in Data} \frac{\partial}{\partial w_j} E_i(\mathbf{x}_i, y_i; w_1, w_0)\]이를 간단히 설명하면 다음 그림처럼 표현된다
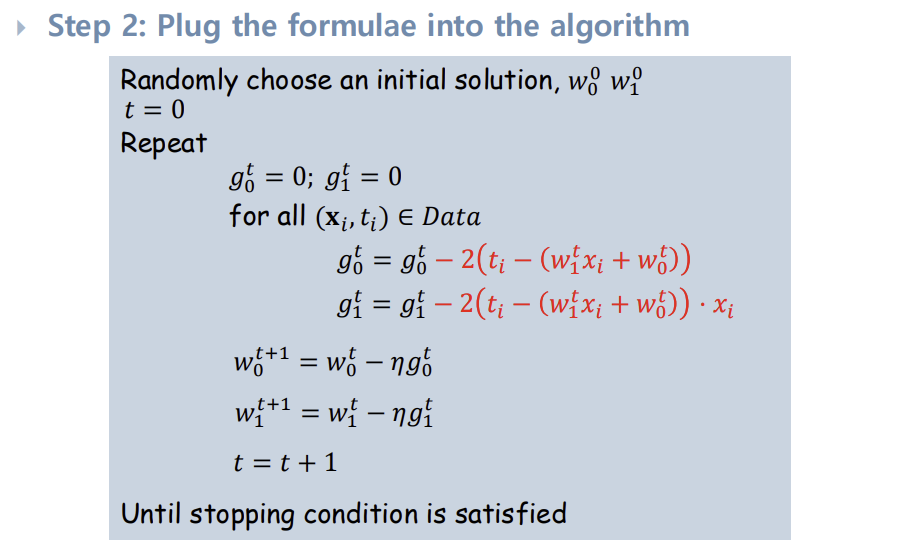
이 방법을 적용해서 동일한 예시를 풀어본다면
$E_i = (y_i - (w_1x_i + w_0))^2$이므로
\[\frac{\partial E_i}{\partial w_0} = -2 (y_i - (w_1x_i + w_0))\] \[\frac{\partial E_i}{\partial w_1} = -2 (y_i - (w_1x_i + w_0)) \cdot x_i\]이대로 대입하면
Regression의 over/underfitting
Regression에서 f(x)의 차원에 따라 모델의 over/underfitting이 결정된다.
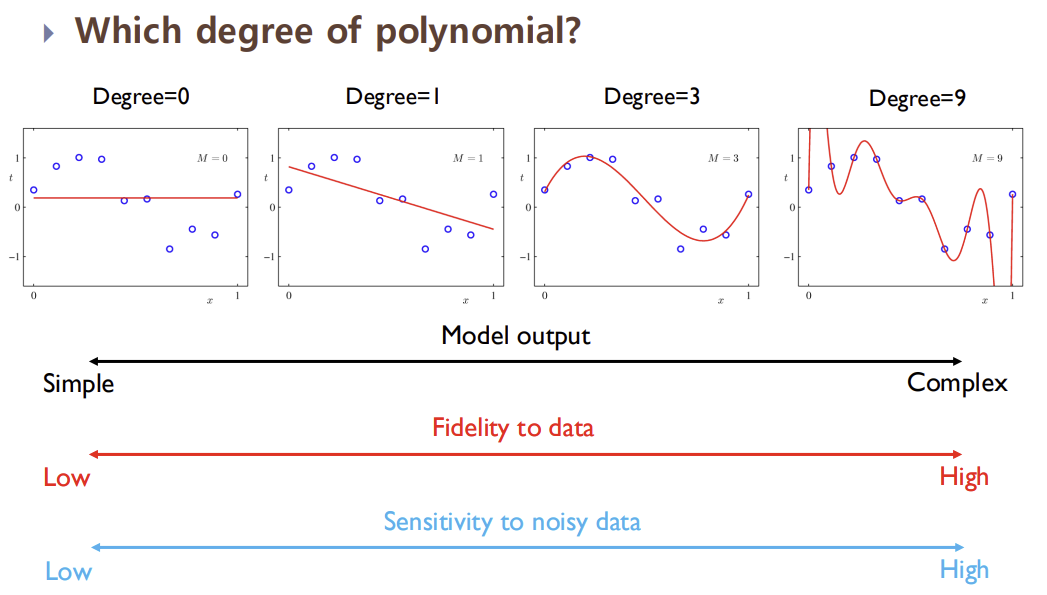
f(x)가 x에 대해 고차원적수록, data에 더 민감해지기 때문에 model이 더 complex해지고 noise에 대해 민감해진다.
반대로 f(x)가 x에 대해 저차원일수록, data에 더 robust 해지기 때문에 model이 더 simple해지고 noise에 대해서도 robust하다.