기학원 Week 1 KNN 정리
K-Nearest Neighbors
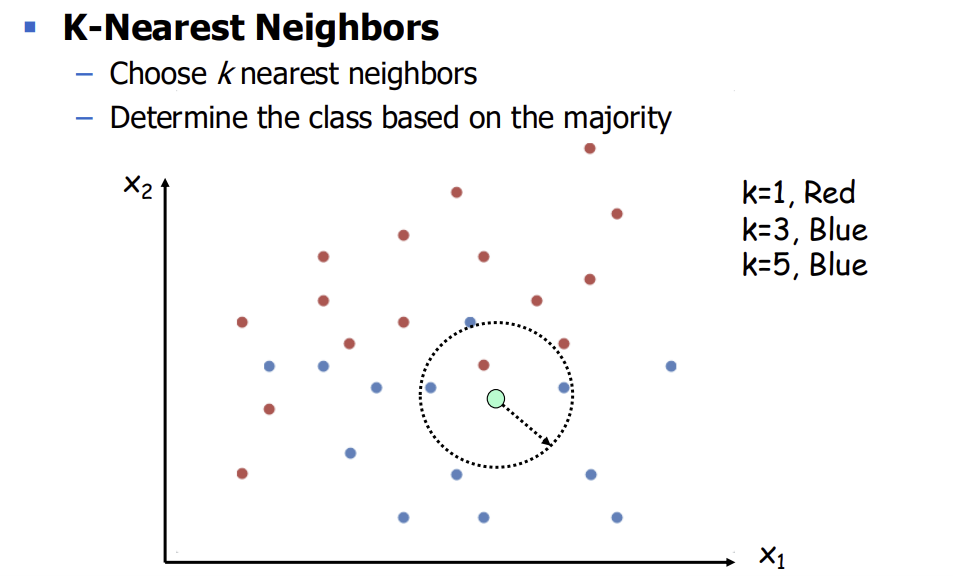
- 보통 Classify을 위해서 사용
- 가장 가까운 k개의 이웃의 majority을 통해 최종 predicition 결정
K 값에 따른 model 변화
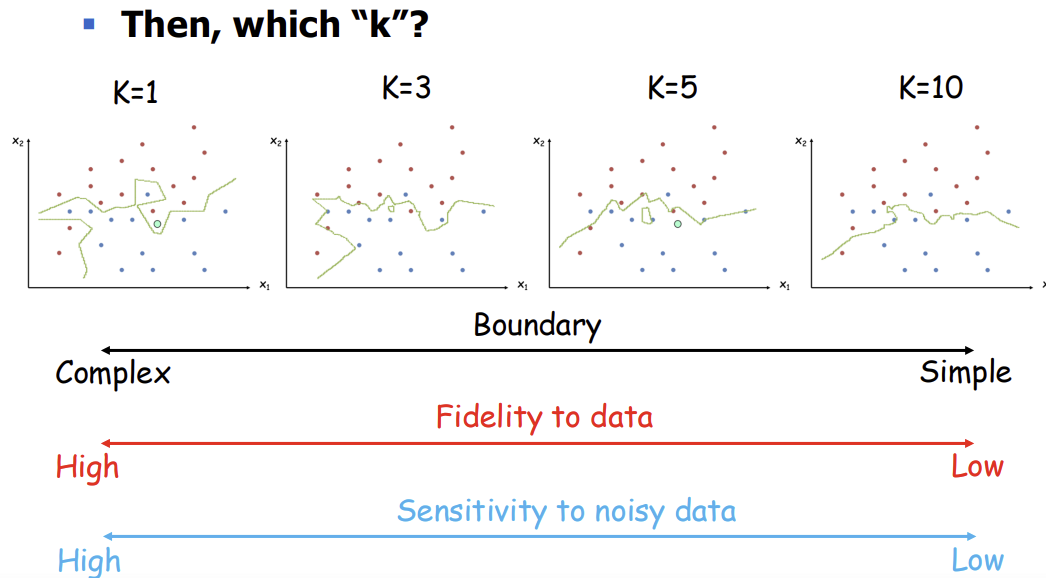
k가 낮을수록 더 적은 수의 이웃을 고려하기 때문에 data에 더 민감해져서 classifying boundary가 더 complex하고 noise sensitivity가 증가한다. 즉 overfitting 된다고 볼 수 있다.
k가 높을수록 더 많은 수의 이웃을 고려하기 때문에 data에 더 robust 해져서 classifying boundary가 더 simple하고 noise sensitivity가 감소한다. 즉, underfitting 된다고 볼 수 있다.
이때 knn은 실제로 boundary을 생성/얻어내는 것이 아님
KNN을 regression에 적용
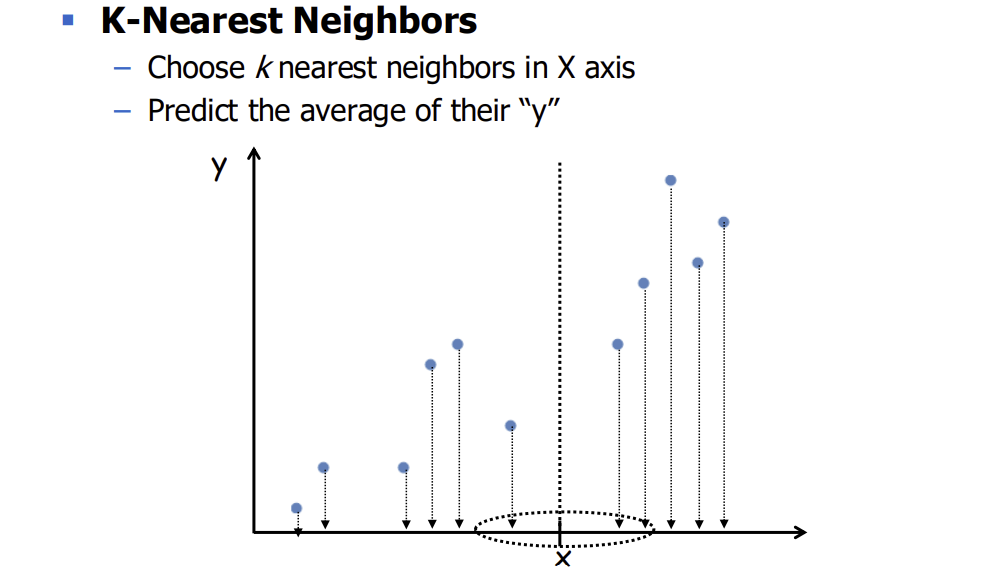
Regression을 하기 위해서는 x에 따른 실수 y값을 예측해야 한다.
KNN을 이용한 regression은 궁금한 x점에서 x axis 상에서 가장 가까운 k개의 이웃을 고른 다음 이 이웃들의 y값 평균을 통해 y값을 예측한다.
K 값에 따른 KNN Regression model 변화
Regression에서도 마찬가지로 k값에 따라 model에 변화가 생긴다.
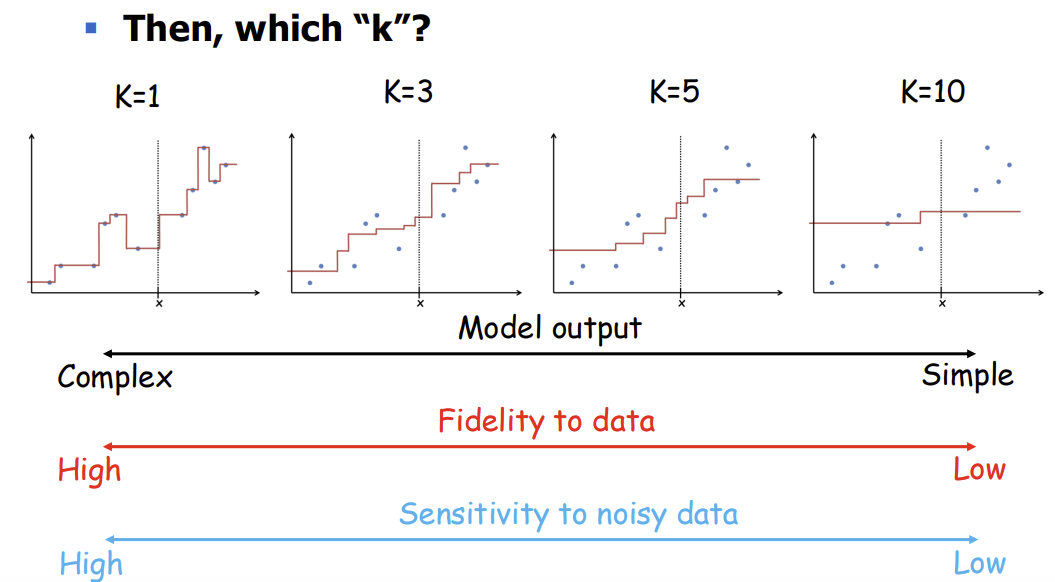
k가 낮을수록 더 적은 수의 이웃을 고려하기 때문에 data에 더 민감해져서 classifying boundary가 더 complex하고 noise sensitivity가 증가한다.
k가 높을수록 더 많은 수의 이웃을 고려하기 때문에 data에 더 robust 해져서 classifying boundary가 더 simple하고 noise sensitivity가 감소한다.
꼭 이웃들의 majority / 평균을 사용해야 할까?
Classification
예를 들어, $x_1$처럼 k=5에서 제일 가까운 5명의 이웃 중 엄청 가까운 2명은 black, 제일 먼 이웃 3명은 red이라고 할 때, majority을 기준으로 classify을 하면 red이 된다.
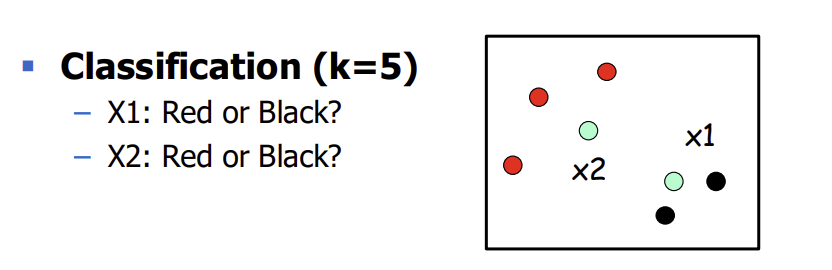
이때, 가장 유사한건 black인데 가까운 이웃들 중 과반수가 red이라고 해서 red label을 가지는 것은 어떻게 보면 부당하다고 볼 수 있다.
따라서 더 가까운 이웃은 더 많은 weight을 주는 방법이 존재한다.
거리값이 낮을수록 weight가 커지도록 weight = $\frac{1} {distance}$ 으로 설정하는 것이다.
이웃이 $n_1, n_2, n_3, n_4, n_5$가 있고 이들과의 거리가 각각 $d_1, d_2, d_3, d_4, d_5$일 때, $d_1, d_2, d_3$는 거리가 덜 가까운 black, $d_4, d_5$는 거리가 엄청 가까운 red라고 하자
- black일 weight: $\frac{1}{d_1} + \frac{1}{d_2} + \frac{1}{d_3}$
- red일 weight: $\frac{1}{d_4} + \frac{1}{d_5}$
이 방법을 사용하면 red일 weight > black일 weight이라면 majority가 black이여도 최종 prediction은 red가 될 수 있게 되는것이다.
공식화하면
\[S(x', R) = \sum_{x \in N(x',R)} w(x)\] \[S(x', B) = \sum_{x \in N(x',B)} w(x)\] \[\text{if $S(x', R) > S(x', B)$ then $x'$ is R}\]Regression
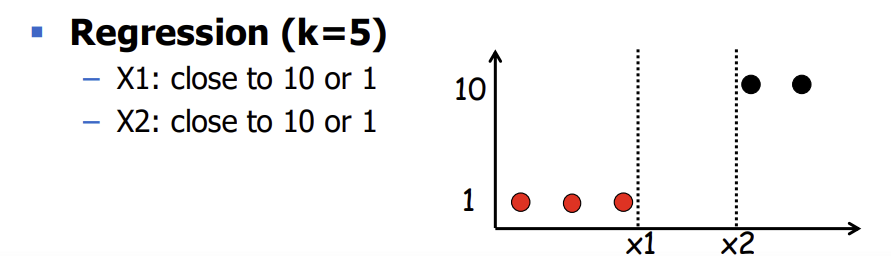
KNN을 활용한 regression에서도 마찬가지이다. 이웃들의 평균값을 통해 prediction을 정하면 $x_1$처럼 x axis에서 가장 가까운 k개의 이웃 안에 들지만 엄청 먼 이웃들의 영향력은 엄청 가까운 이웃들의 영향력과 같아지게 된다.
거리에 따른 weight 값을 regression에 적용하기 위해서는 weight w(x) = $\frac{1} {\text{거리}}$로 두고 weighted sum을 활용하면 된다.
이웃이 $n_1, n_2, n_3, n_4, n_5$가 있고 이들과의 거리가 각각 $d_1, d_2, d_3, d_4, d_5$일 때, 최종 regression 예측값을 다음과 같이 둘 수 있게 되는 것이다.
\[\frac {\frac{y_1}{d_1} + \frac{y_2}{d_2} + \frac{y_3}{d_3} + \frac{y_4}{d_4} + \frac{y_5}{d_5}} {\frac{1}{d_1} + \frac{1}{d_2} + \frac{1}{d_3} + \frac{1}{d_4} + \frac{1}{d_5}}\]이러면 거리 $d$가 작을수록 $\frac {y} {d}$값이 증가하여 가까운 이웃에 더 많은 가충지를 둘 수 있게 되는 것이다.
공식화하면 다음과 같다.
\[f(x') = \frac {\sum_{x \in N(x',R)} w(x) \cdot f(x)} {\sum_{x \in N(x',R)} w(x)}\]Weight의 종류
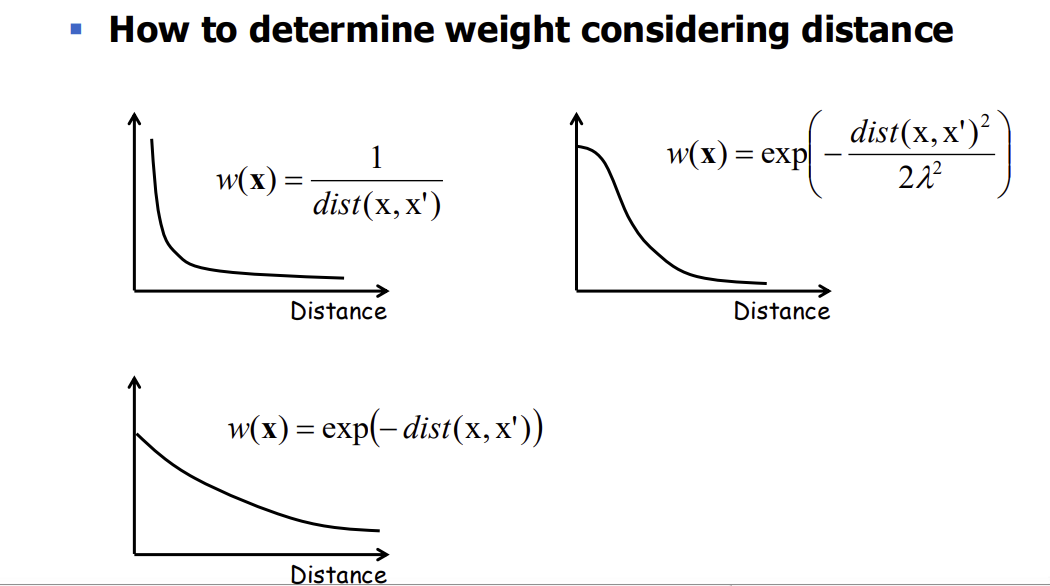
꼭 $\frac {1} {거리}$로 weight을 안 둬도 된다. 다음과 같이 다양한 weight 함수가 존재한다.
x축 값들의 변화에 따른 boundary 변화
Data의 x 값을 linear하게 scaling 해도 boundary 값이 달라지기에 x의 scaling 또한 중요한 변수가 될 수 있다.
KNN의 장점과 단점
장점
- 학습을 하지 않아도 된다.
- information loss가 없다.
- 오직 이웃으로만 결정되기에 target function의 complexity을 고려하지 않아도 된다. 즉, target function 자체가 없다고 볼 수 있다.
단점
- 모든 data을 보관해야 하기에 memory 사용량이 크다
- 오직 이웃의 값으로 모든 것이 결정되기에 noise에 민감하다
- 모은 data의 class 분포가 불균형하다면 적용하기 어려움 (bias가 생김)
- 한번 추론할 때마다 모든 data까지의 거리를 계산해야 한다