기학원 Week 3 Logistic Regression 정리
Linear Classifier 리뷰
Linear classifier을 구한다고 해보자
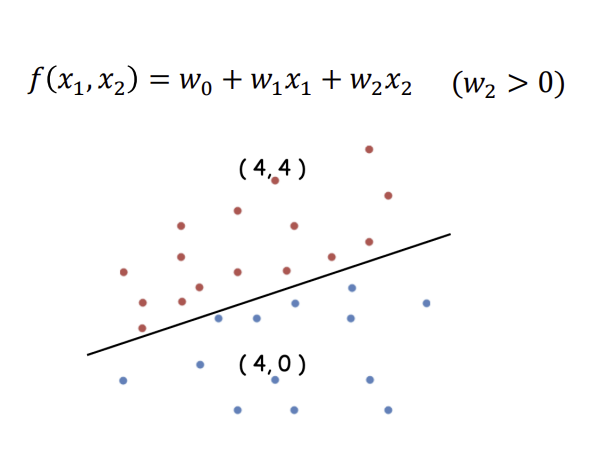
Linear boundary보다 위에 data가 존재한다면 label 1, 아래에 존재한다면 label 2을 부여하는 것이 linear classifier였다.
이때, linear boundary $f(x_1, x_2)$의 출력값은 실수이기 때문에 나온 값을 discrete한 label에 mapping 해야 한다
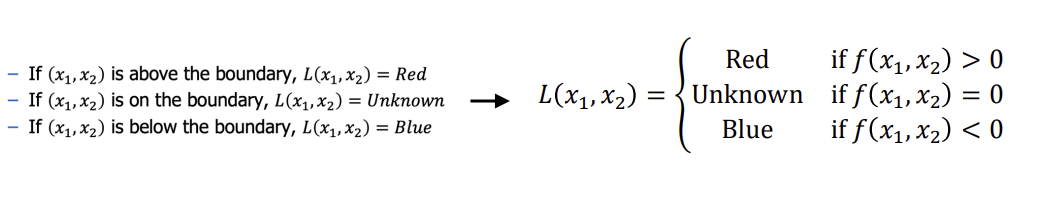
-
Linear classifier의 단점은 output의 실수값을 해석하는 방법이 모호하고 (오직 0보다 크면 label1, 0보다 작으면 label2로만 해석될 수 있기 때문에)
-
학습 과정에서 outlier의 영향을 많이 받기 때문이다
Logistic Regression
Logistic regression은 $f(x)$을 통해서 classifier의 approximation을 얻는 모델이라고 보면 된다.
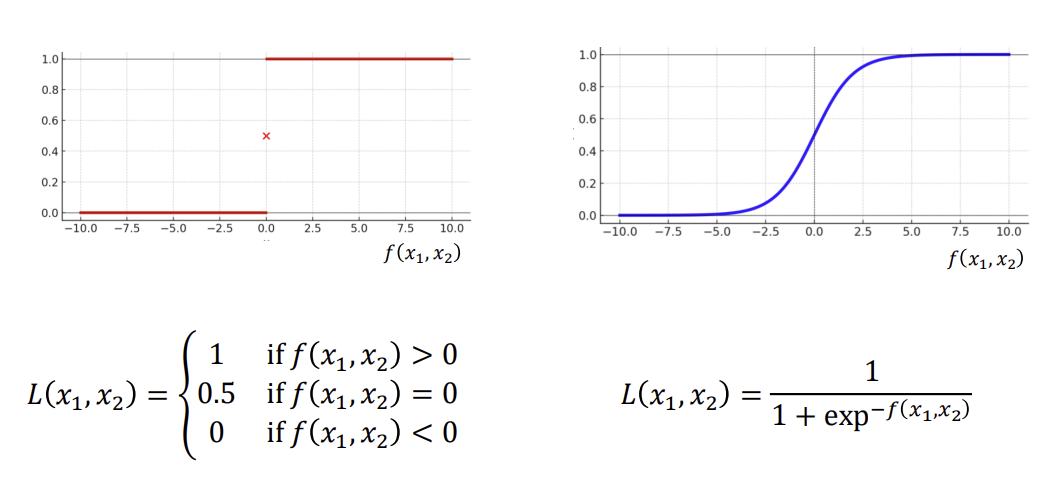
Logistic regression의 특징은 모델의 출력값을 probabilistic하게 해석할 수 있다는 것과 outlier의 영향을 많이 받지 않는다는 점이 있다.
$\rightarrow$ 아무리 높은 값이 label으로 주어져도, logistic function에 의해 1에 매우 가까운 값으로 normalize 되기 때문이다.
$\rightarrow$ 원래대로 boundary을 구하자고 했다면 error 값이 커져서 boundary의 값이 커졌을 것이다.
함수 $f(x)$ 값을 logistic function $\frac {1} {1+e^{-t}}$을 통해 (0,1)로 mapping하여 특정 data의 label이 어떤 것이 될 가능성이 높은지를 알 수 있게 된다.
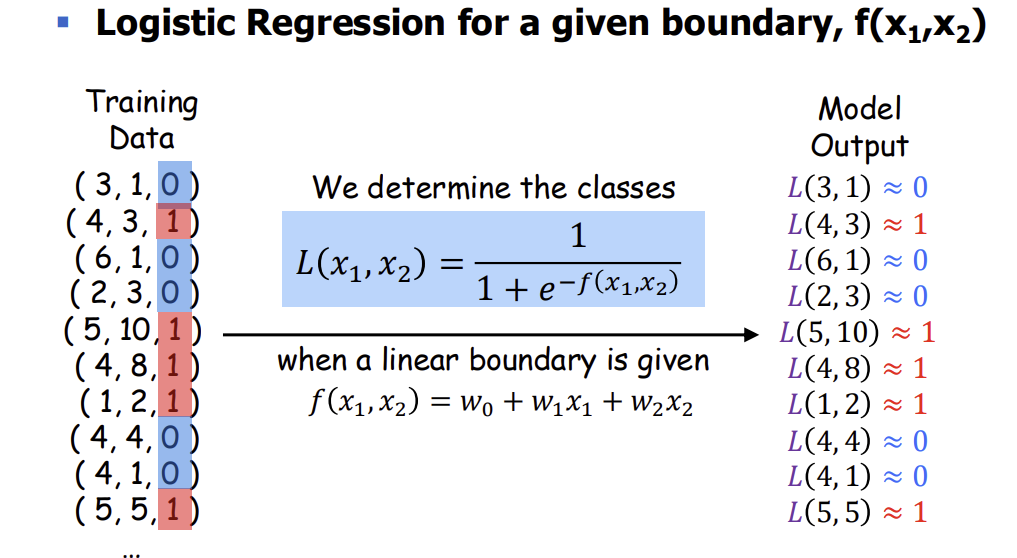
How to get boundary f(x)
그렇다면 최적의 boundary f(x)는 logistic regression에서 어떻게 얻는 것일까?
예를 들어 $f(x_1, x_2) = w_0 + w_1x_1 + w_2x_2$라고 해보자
intercept term w_0은 어떻게 보면 w_0 * 1이므로 training data 앞에 1을 추가해주면 $f(x)$을 더 쉽게 표현할 수 있다.
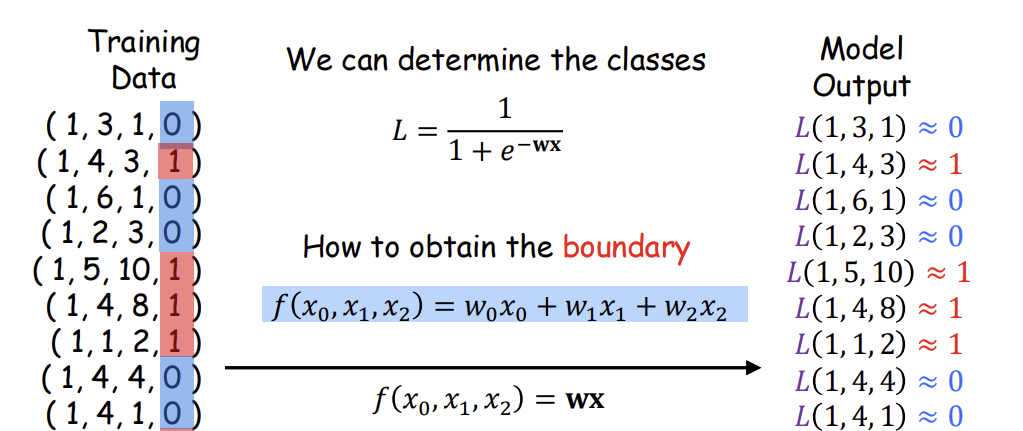
-
먼저 해야 할 일은 정답과 예측값이 얼마나 다른지를 측정하는 Error Function E를 정의하는 것이다.
보통의 regression은 Min Squared Error (MSE) $E = \sum_{(x,y) \in Data} (y - L(x;w))^2$을 사용한다.
하지만 Logistic regression은 진짜 regression이 아니라 classifying boundary을 구하는 것이기 때문에 MSE의 성격과 맞지 않는다.
MSE는 특정 실수값들을 맞추도록 해주는데 logistic regression은 binary한 label만 맞추면 되기 때문에 성격이 맞지 않다고 보면 된다.
Logistic Regression은 Cross Entropy을 사용한다.
\[E = \sum_{(x, t) \in \text{Data}} - \left[ t \log(L(x; \mathbf{w})) + (1 - t) \log(1 - L(x; \mathbf{w})) \right]\] \[L(x;w) = \frac {1} {1+e^{-wx}}\] -
Gradient Descent으로 최적의 w을 구하기
그 이유는 E을 관찰하면 된다. E가 w에 대해 linear하지 않기에 gradient descent만 사용할 수 있는 것이다.
Cross Entropy E의 미분 과정을 살펴보자. 첫 term 미분 과정이다.
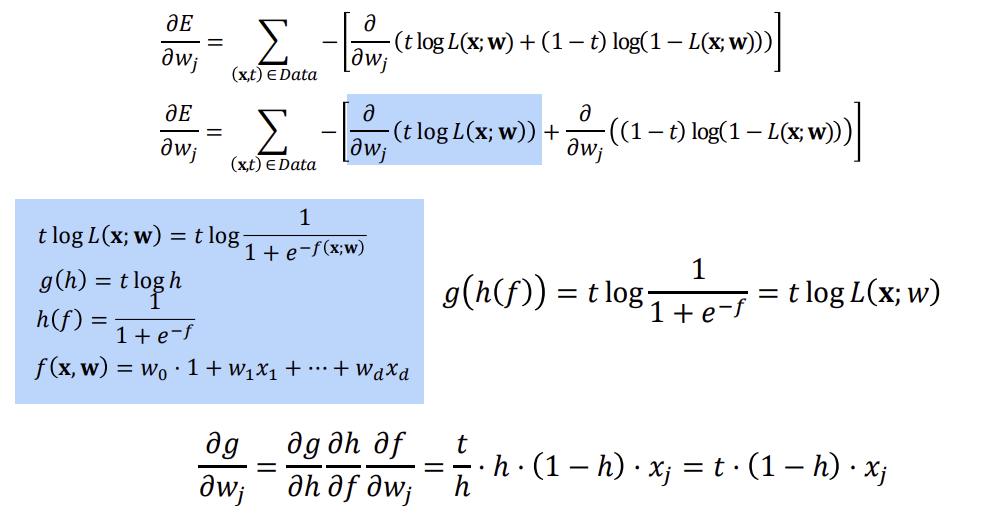
두 번째 term 미분 과정이다.
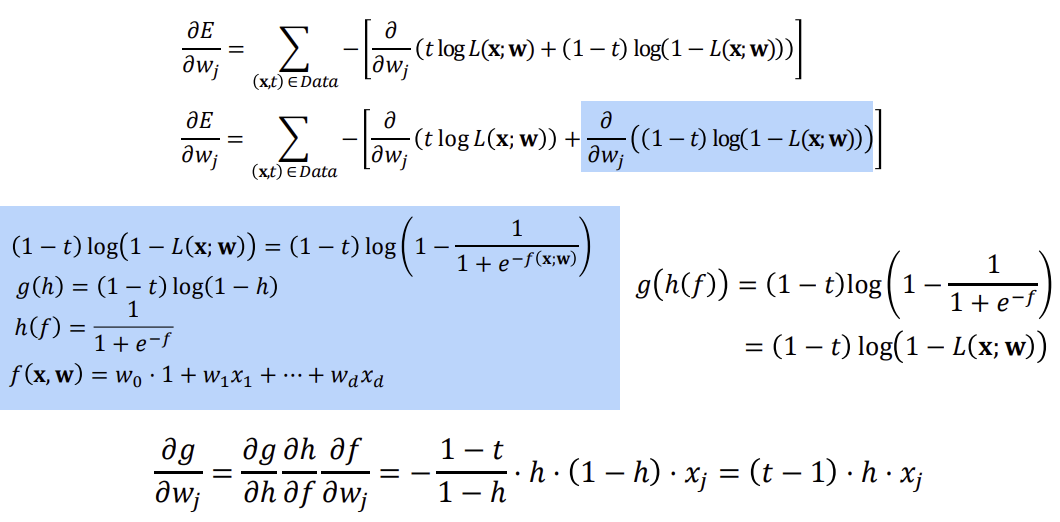
이를 정리하면 $\frac {\partial E} {\partial w_j}$는 다음과 같다.
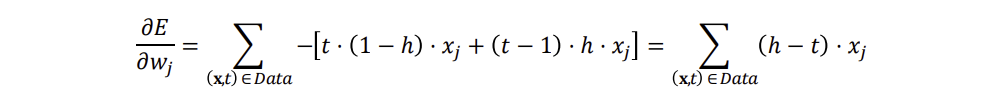
Why not MSE?
정확하게 왜 Error function으로 MSE을 사용하면 안 되는걸까?
Gradient을 분석해보자
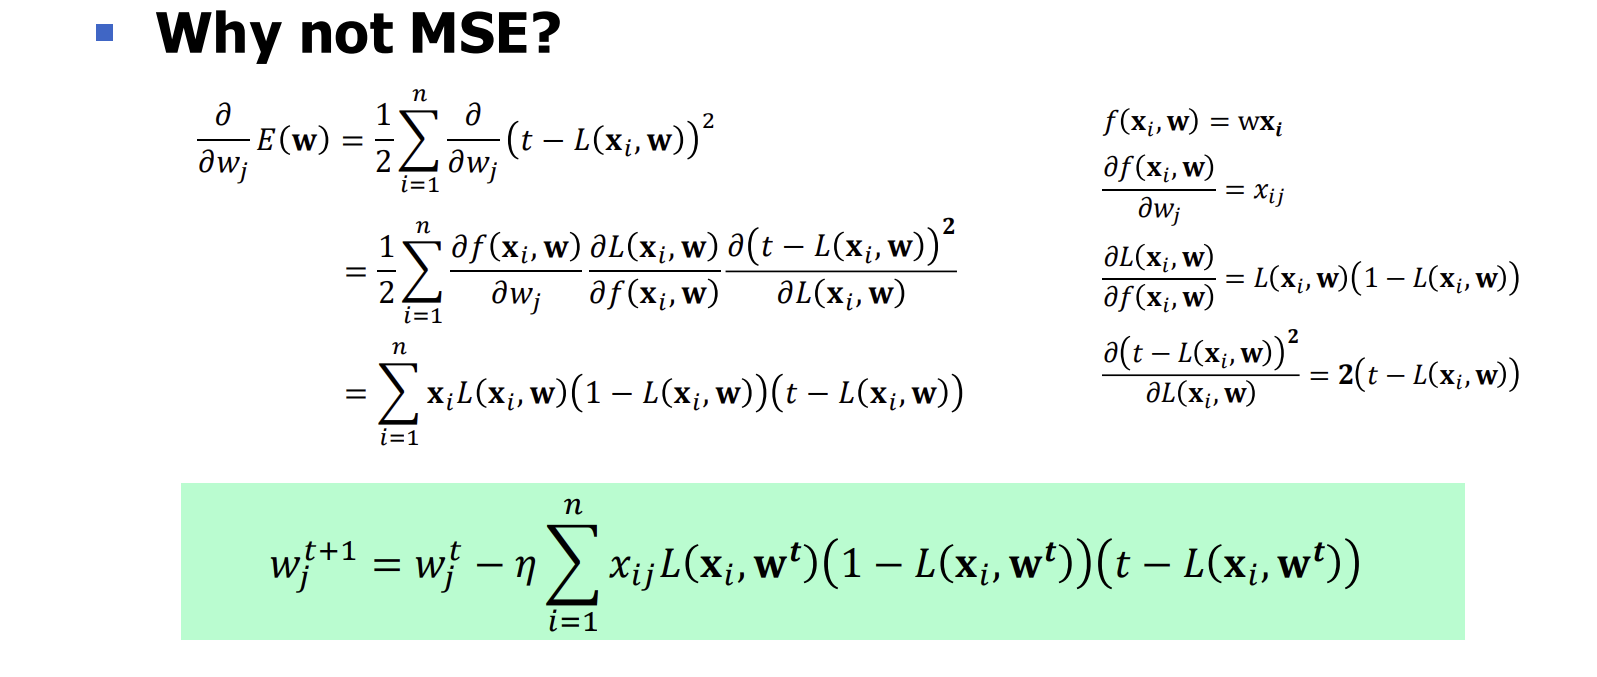
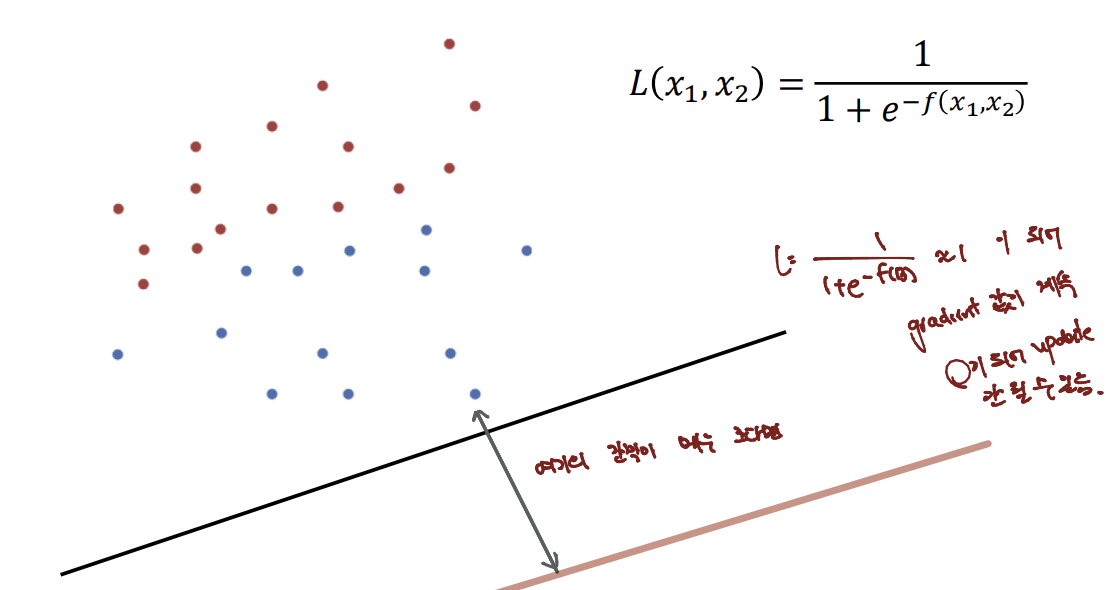
w을 처음 초기화했을 때 L(x;w)의 값이 모든 training data에 대해서 1이나 0에 가깝게 나오도록 설정되었다면 처음부터 w update가 진행되지 않을 수 있다는 단점을 갖는다. (gradient가 accumulate한 뒤에 처리되므로)
따라서 MSE을 사용하면 안되는 것이다.
이 문제를 시각화한 그림이다.
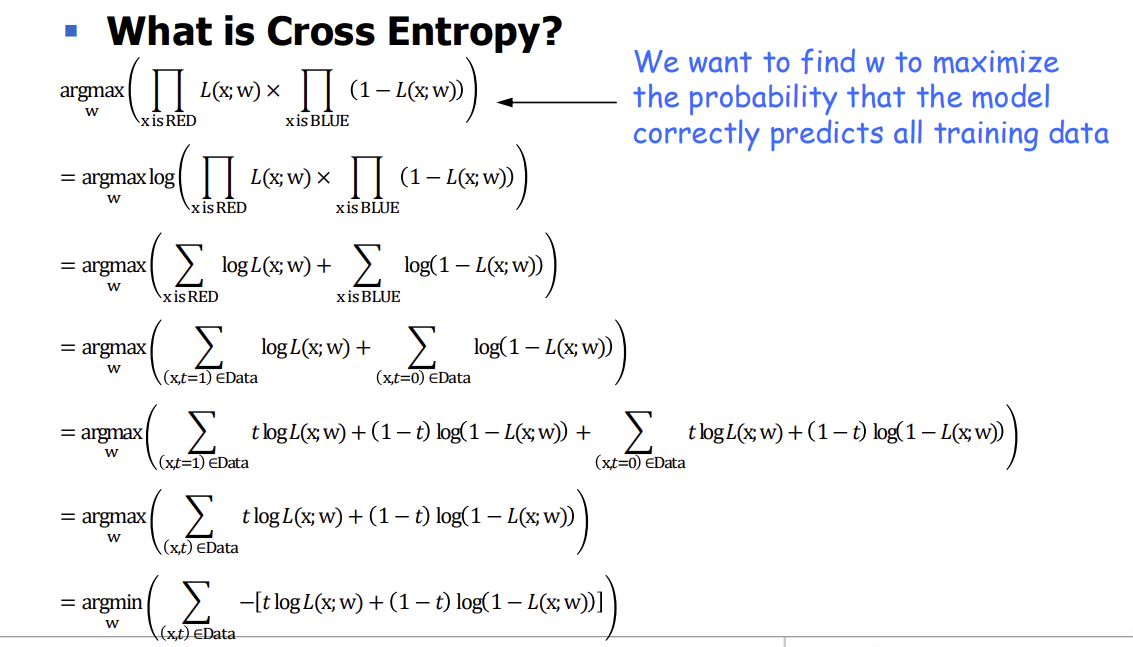
What is Cross Entropy
간단하게 어떤 문제를 확률적인 문제로 바꿔주는 error function이라고 보면 된다.
모든 학습 data을 정확하게 예측하는 w 구하기 문제를 모든 학습 data을 정확하게 예측하는 확률을 최대화하는 w 구하기 문제로 바꾸는 것이다.
모든 학습 data을 정확하게 예측하는 확률을 최대화하는 w 구하기를 수학적으로 표현하면 다음과 같다.
$(\prod_{(x,1) \in Data} L(x;w)) * (\prod_{(x,0) \in Data} (1 - L(x;w)))$
Label이 1인 data에 대해서는 L(x;w)의 값이 최대한 1이 되도록 하는 동시에 label이 0인 data에 대해서는 L(x;w)의 값을 최대한 0이 되도록 하는 w을 구하는 것이다.
이 liklelihood을 최대화하는 w을 구하는 과정을 통해 cross entopy을 유도해보자