기학원 Week 5 Model Evaluation and Selection 정리
Model Evaluation and Selection
모델을 평가하기 위해서는 unseen data에서도 성능이 좋은지 확인해야 한다.
Unseen data에 대해 평가를 하기 위해서는 대표적으로 두 방법, Hold out과 cross validation이 있다.
Hold out
주어진 data를 겹치지 않게 training set과 test set으로 random하게 split한다
Traning set으로 모델을 학습하고 test set으로 모델을 평가하면 된다.
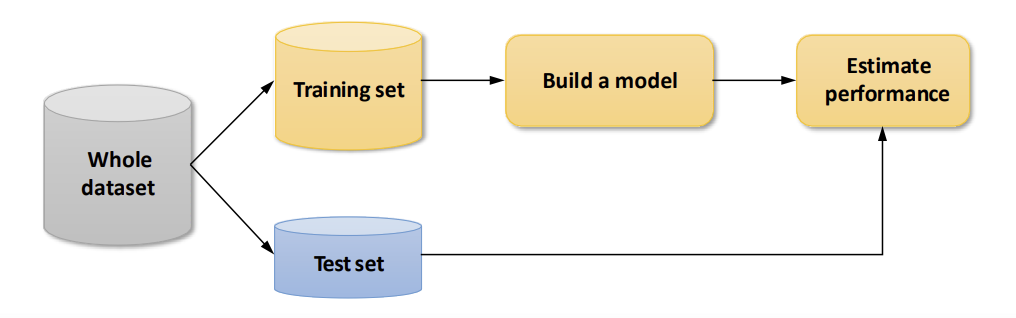
Test set은 전체 data의 10%~30%으로 한다
장점
- 간단하고 비용이 싸다
단점
- Data가 random하게 split되기 때문에 split을 할 때마다 성능이 달라질 수 있다. 즉, 평가 방법의 variance가 크다
- 학습 data가 test data만큼 낭비된다
Cross Validation
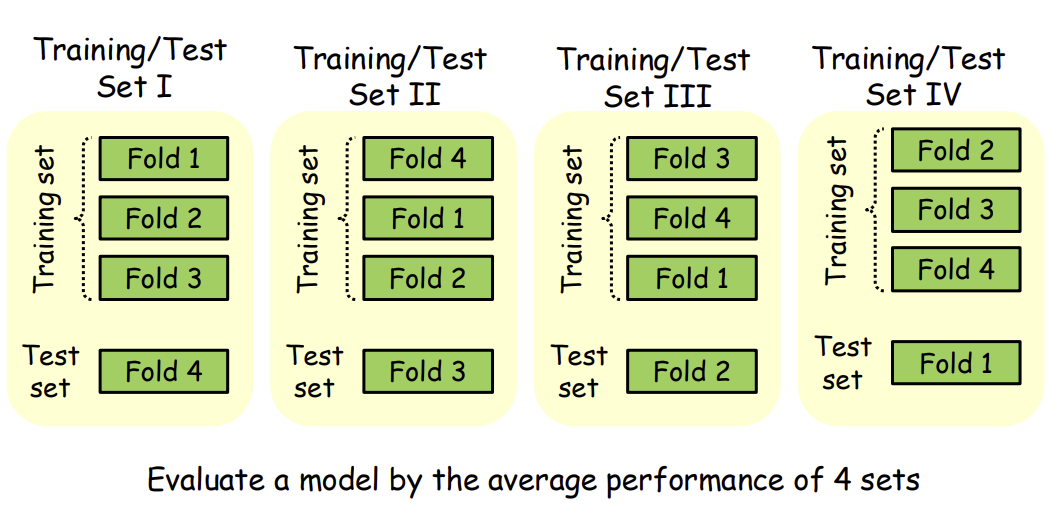
Cross validation은 학습에 사용되는 data을 최대한 늘리기 위해 data을 k개의 fold으로 나눈다.
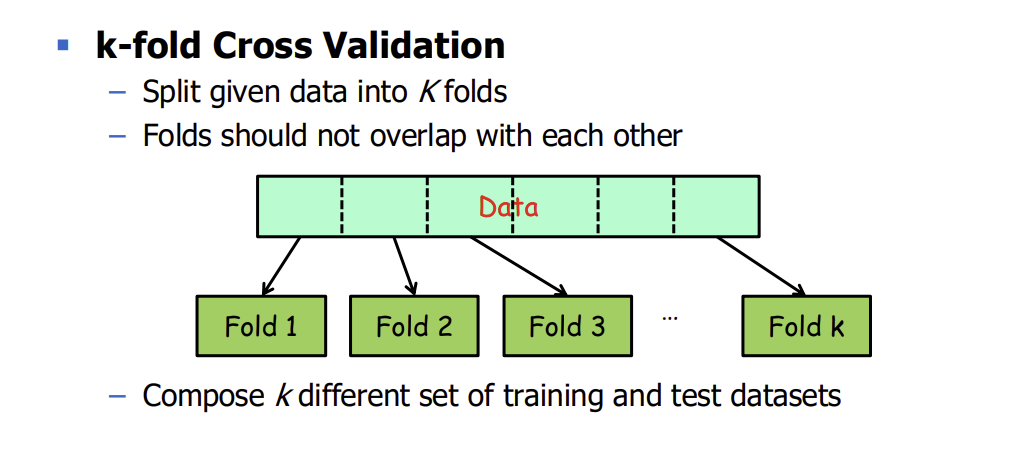
이 fold들을 사용해서 training/test set을 k개 (${}_kC_1$) 만들 수 있게 된다. 한 모델을 독립적으로 각 training set에 대해 학습을 한 뒤, 각 training set들에서의 성능의 평균을 통해 모델의 generalized된 성능을 측정할 수 있게 된다.
이 방법은 평가 지표의 variance가 작다. 또, k가 증가할수록 variance는 감소한다.
장점
- Data가 random split 되더라도 k번 반복하기 때문에 variance가 작다
- 모든 data point가 test data에 1번, traning data에 k-1번 관여한다
단점
- time consuming
Model Evaluation vs Model Selection & Evaluation
-
Model evaluation is evaluating the expected performance of a trained model.
-
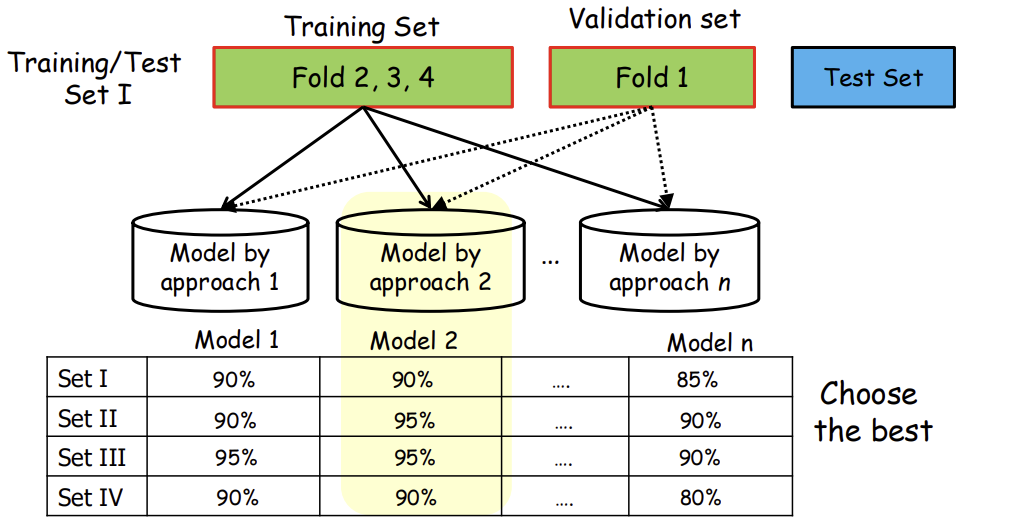
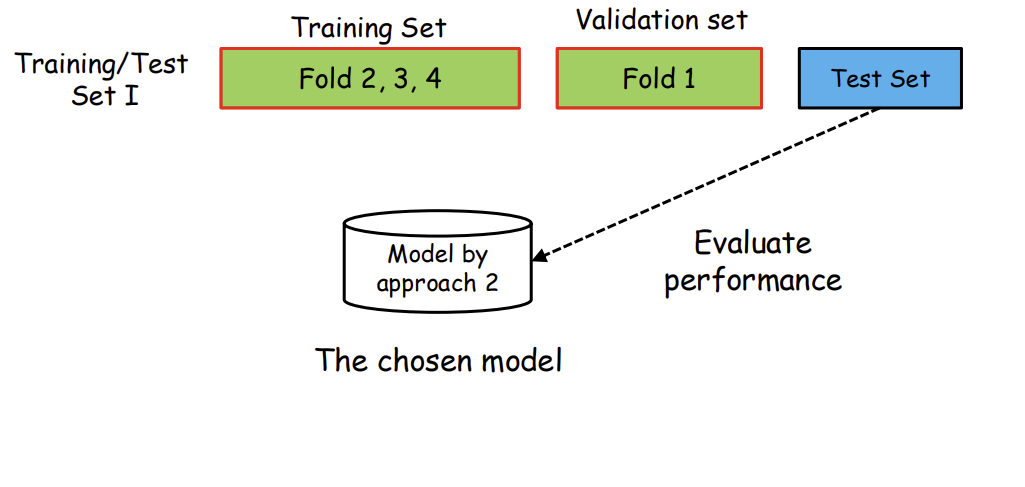
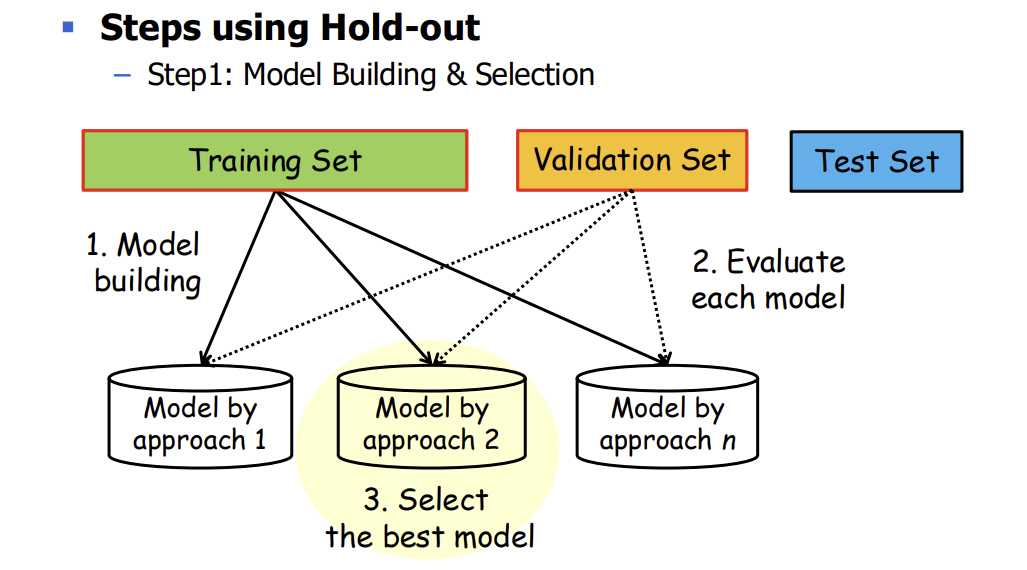
Model evaluation and selection is choosing the best among several ML approaches (models) using validation set and verifying if it is the best using test set.
Model Selection & Evaluation
최고의 모델이 무엇일 지 알아내기 위해서는 모델을 평가하는 방법을 여러 번 반복하고 그 중에서 test set 성능이 가장 좋았던 모델을 골라도 된다고 생각할 수 있다. Test set은 어떻게 보면 random split에서 나온 data이기 때문에 test set에서 95%의 정확성을 보였다면 unseen data에 대해서도 95%의 정확성을 보일 것이라고 예측할 수 있다.
하지만 unseen data에 대해서 모델 성능의 최대치가 95%라고 할 수는 없는 것이다. Test set에 대해서 성능이 다른 모델보다 안 좋았더라도 더 많은 unseen data에 대해서는 성능이 더 좋게 나올 수도 있는 것이다.
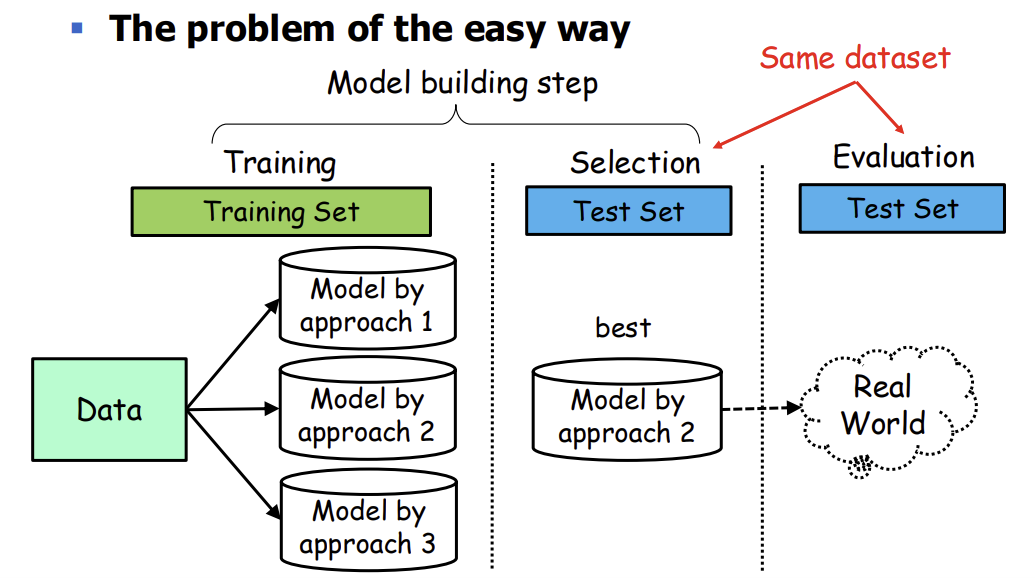
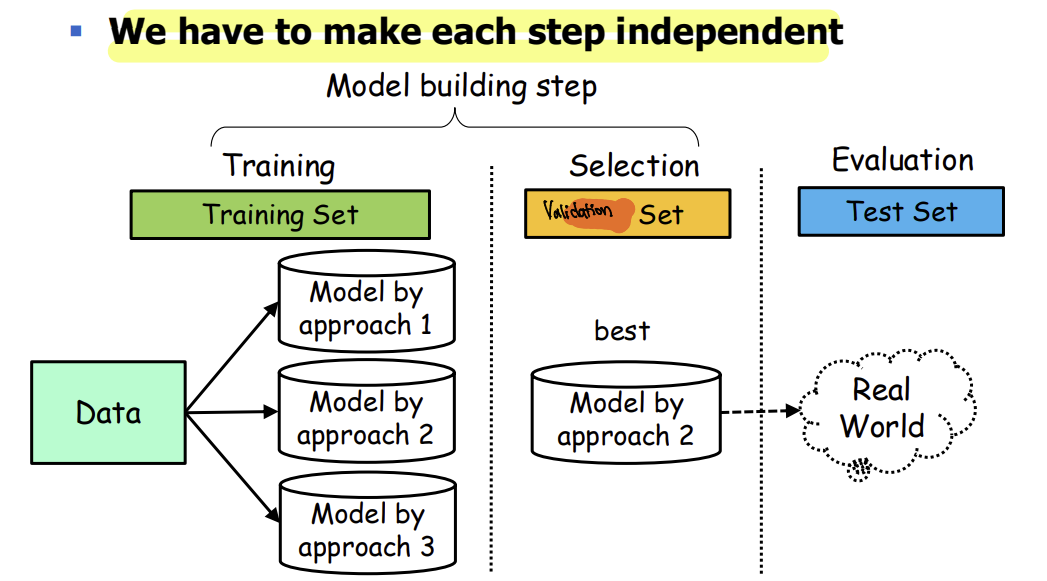
즉, model selection과 evaluation을 동일한 기준으로 하였기 때문에 생기는 문제이다
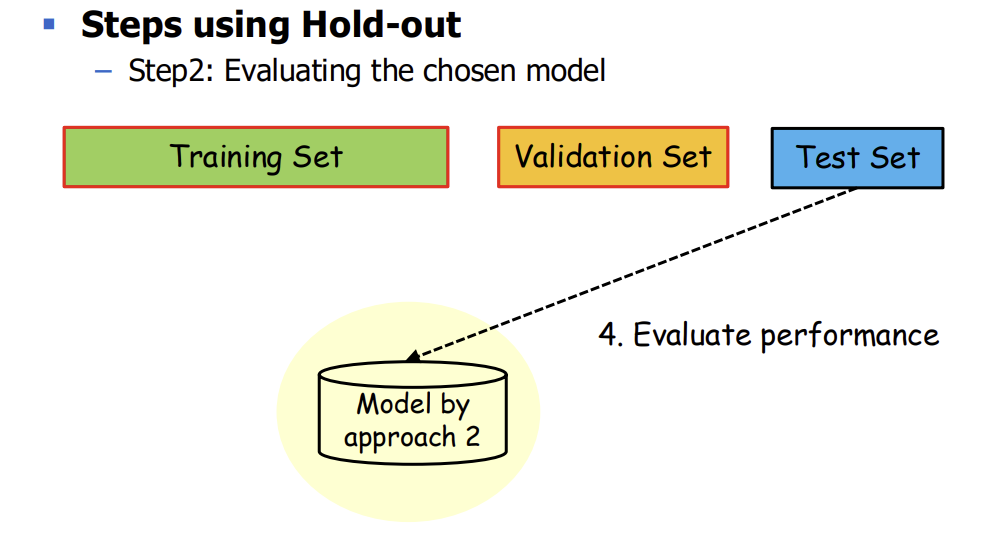
따라서, 실제로 최고의 모델을 선택하기 위한 제일 정확한 방법은 test set과 독립적인 evaluation set을 사용하여 최고일 것일 것 같은 모델을 선택한 다음, test set으로 그 모델을 평가해야 한다.
Model Selection & Evaluation using Hold out
Model Selection & Evaluation using Cross Validation
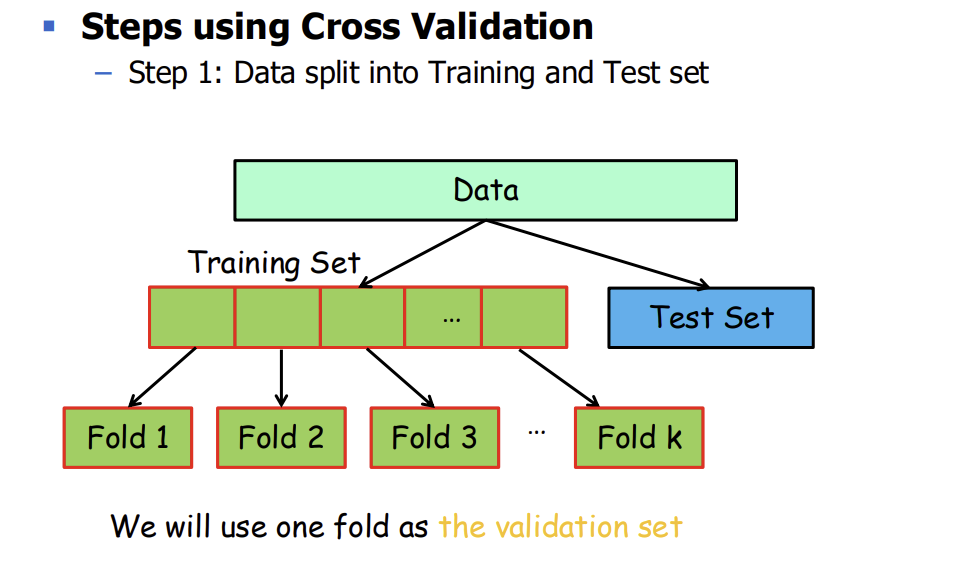
Data을 traning set과 test set으로 나눈 다음에, training set을 k fold으로 나눠 하나의 fold을 validation set으로 사용하는 것이다. K fold cross validation을 통해 최고의 모델이라고 생각된 모델을 test set으로 최종 평가하는 것이다.