기학원 Week 5 Regularization 정리
Regularization
Generalized model을 얻기 위해서는 최적의 model complexity가 얼마인지 알아야 한다. 그렇다면 최적의 model complexity을 어떻게 알아내야 할까?
K fold cross validation처럼 평가를 통해 알아낼 수 있지만, 학습 과정에서 최적의 model complexity을 구할 수도 있다.
이런 방법을 regularization이라고 한다.
ex)
- Additive linear model: weight decay
- DNN: Weight decay, Drop-out …
- Decision Tree: Pruning, Max-Height Limitation …
- Naïve Bayes: Smoothing
Weight Decay
학습을 하는 과정에서는 두 가지의 error가 생긴다
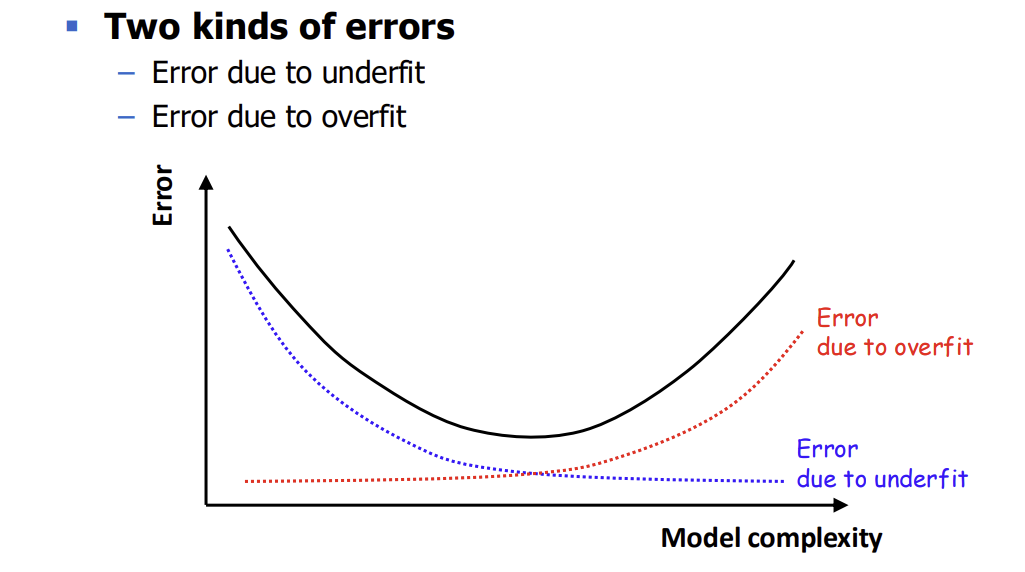
이때, Error due to underfit E(w)은 Traning error와 관련이 있다.
\[\sum_{(x,y) \in Data} (y - f(x))^2\]Error due to overfit C(w)은 Model complexity와 관련이 있다.
\[C(w) = \text{Complexity of the model}\]그렇다면 학습 과정에서 $E(w)$을 최소화하는 것이 아니라 $\tilde E(w)=E(w) + C(w)$을 최소화하면 training error을 최소화하면서 최적의 model complexity을 얻을 수 있지 않을까라는 아이디어가 weight decay이다. 즉, model complexity만큼 penalty을 주는 것이라고 생각하면 된다.
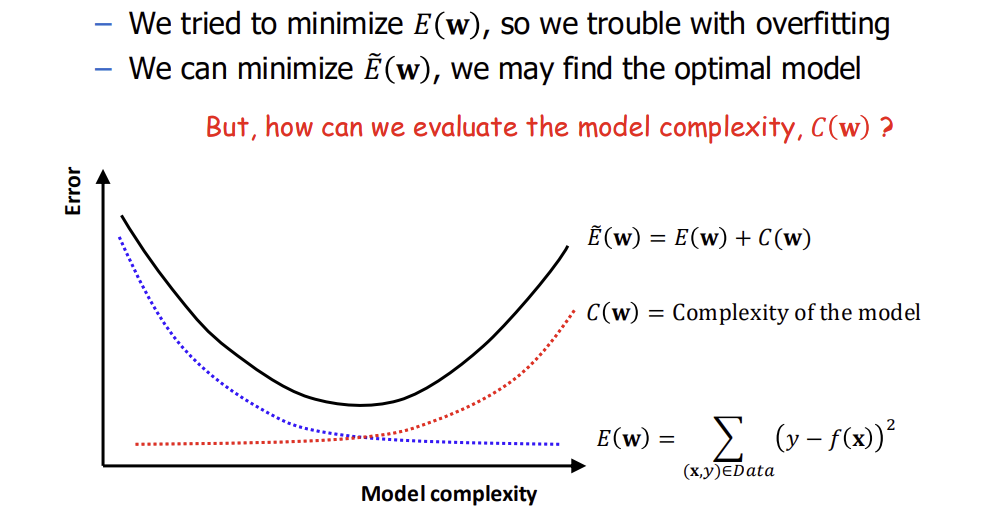
이때, C(w)은 어떻게 정의해야 할까?
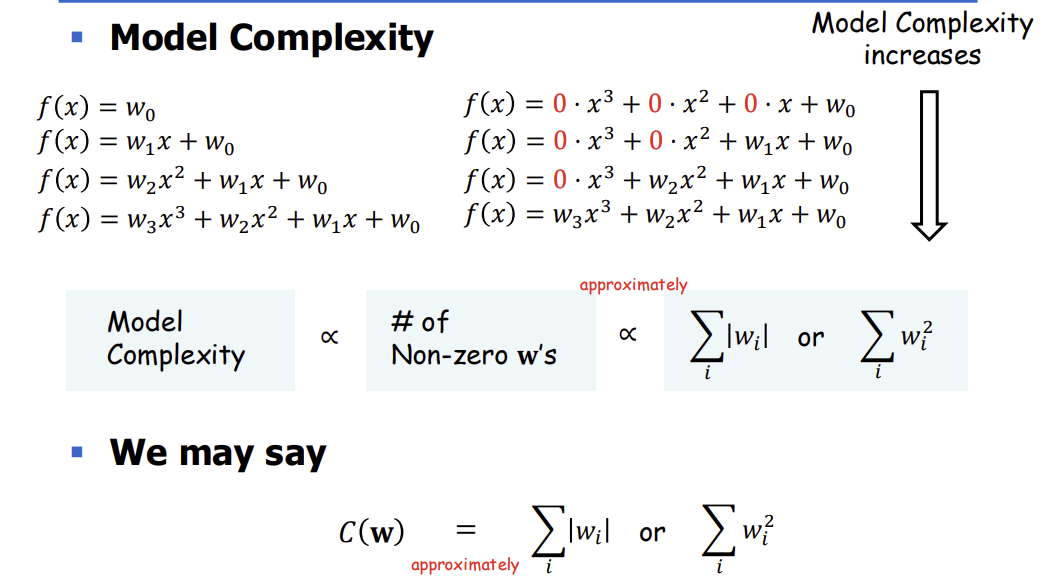
$\rightarrow$ model complexity는 non-zero w의 개수 또는 w의 크기에 비례한다는 것을 알 수 있다.
따라서 $C(w) = \sum_i \mid w_i \mid$ 또는 $\sum_i w_i^2$ 으로 정의할 수 있다.
-
Ridge regression (L1): $C(w) = \sum_i \mid w_i \mid$
-
Lasso regression (L2): $C(w) = \sum_i w_i^2$
이를 바탕으로 $w^* = \text{argmin} E(w) + \lambda C(w)$으로 새로 할 수 있다.
이때 $\lambda$ 값이 작다면 model complexity penalty가 줄어들기 때문에 overfit할 가능성이 높아진다. 따라서 $\lambda$ 값에 따라서 generalization 정도가 달라진다
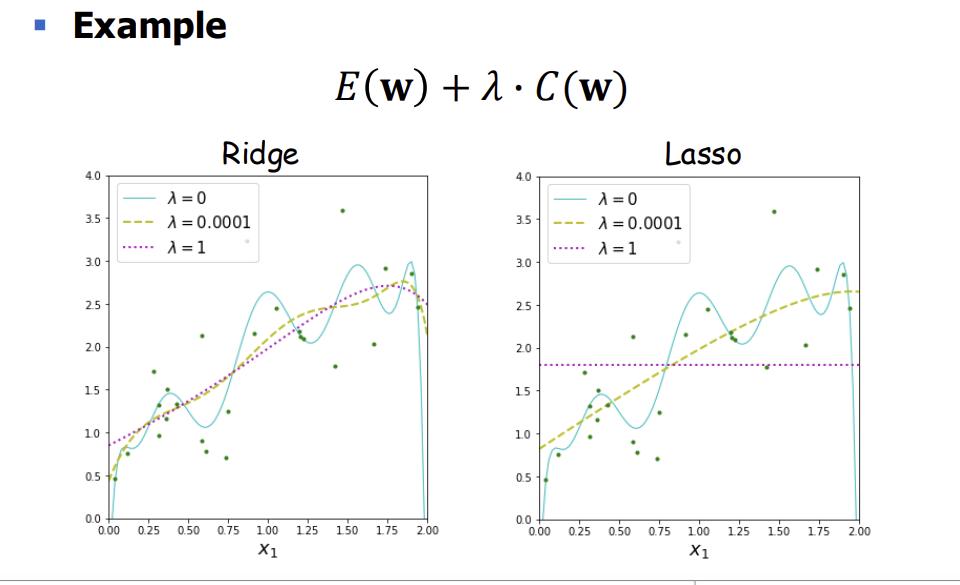
Ridge (L1) Regularization vs Lasso (L2) Regularization
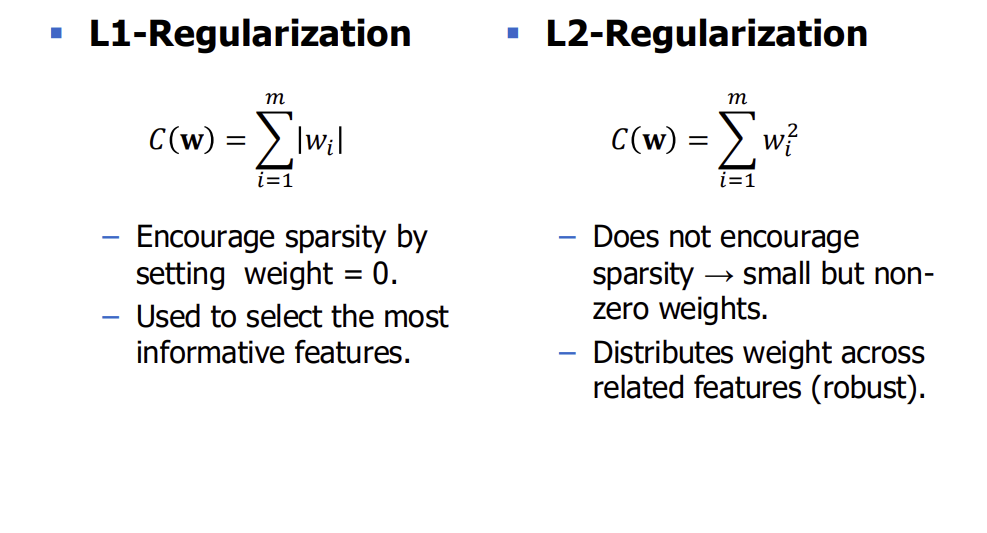
$\rightarrow$ L2은 왜 sparsity가 없고 L1에는 있을까?
이 이유는 complexity C(W)의 gradient을 통해 알 수 있다. L1의 미분값은 1,-1으로 일정하다. 따라서, gradient descent 과정에서 w값과 독립적으로 일정한 값이 더해지거나 빼져서 sparse할 가능성이 높아진다. 하지만 L2의 gradient는 2w으로 w값이 0에 가까울수록 gradient의 크기도 작아져 sparse할 가능성이 낮아진다.