기학원 Week 4 Overfitting and Regularization 정리
Overfitting and Generalization
최적의 모델은 무엇일까?
지금까지 Training error E을 최소화하는 w을 구하는 objective으로 학습을 하였으므로 training error가 가장 작은 모델이 최적의 모델이라고 생각할 수 있다.
하지만 Traning error가 작다고 항상 최적의 모델은 아니다.
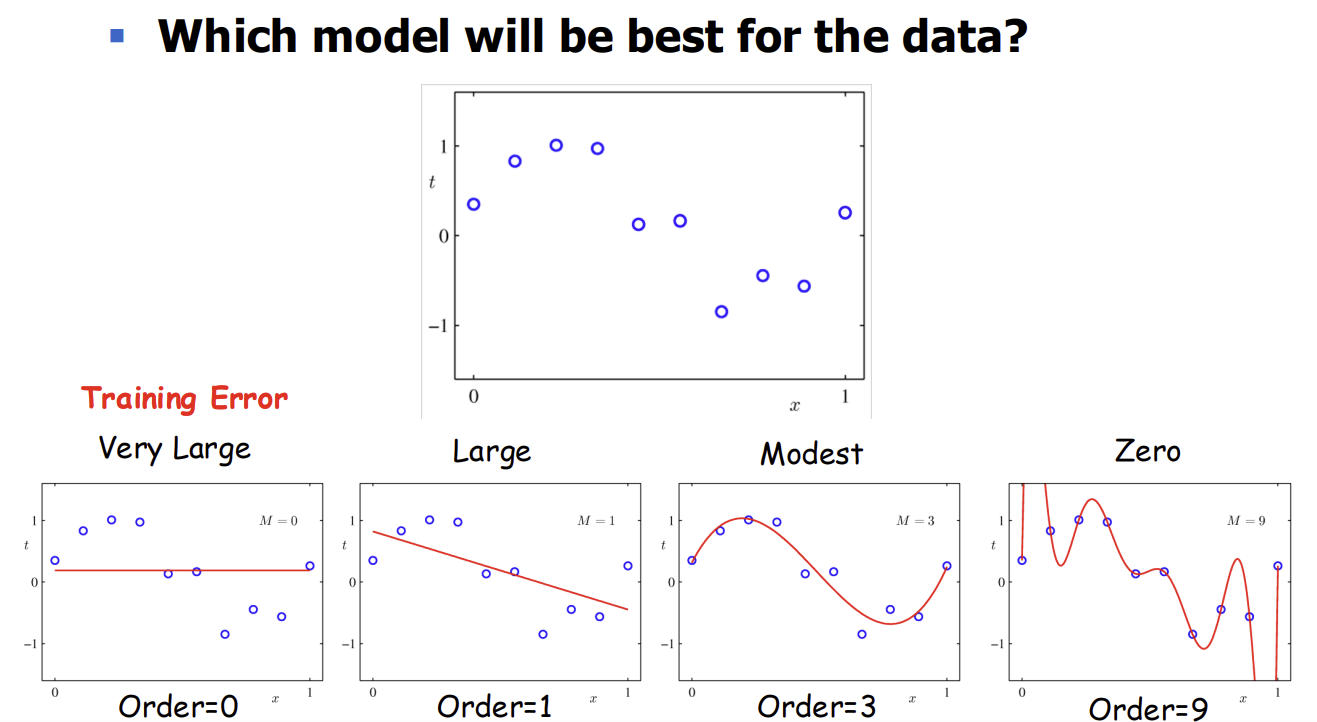
order = 9은 모든 학습 데이터에서 traning error가 0이지만 어떻게 보면 training data만 잘 맞추고 다른 data에서는 예측을 잘 하지 못하게 된다. 이를 overfitting이라고 한다.
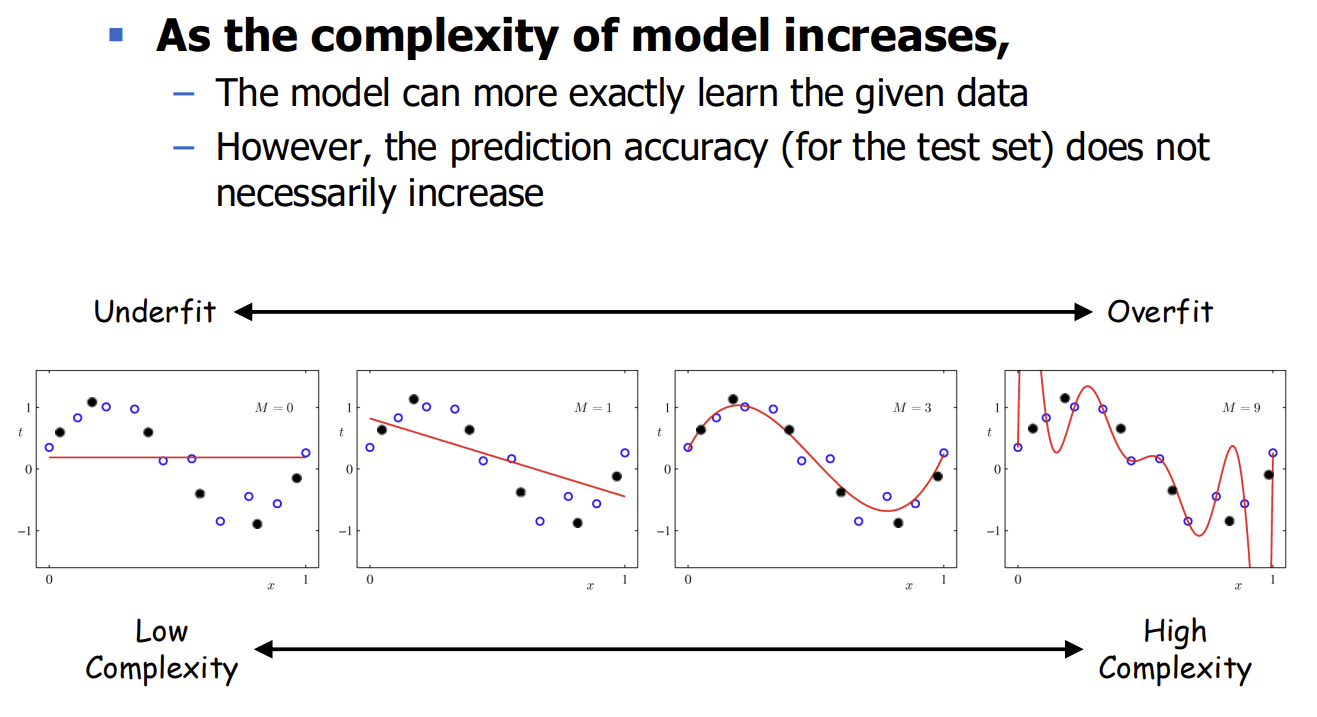
보통 model의 complexity가 증가하여 overfit 될수록 새로운 데이터에 대해서는 예측을 잘 하지 못하게 되는 것이다.
그렇다면 최적의 모델 기준은 무엇인가?
최적의 모델은 학습 데이터에서 error가 가장 낮은 모델이 아니라 학습 데이터를 통해 unknown data을 제일 잘 예측하는 모델을 의미한다.
이를 machine learning에서 generalization이 잘 된 모델이라고도 부른다.
높은 Generalization 얻는 방법
Generalization이 높은 모델은 그럼 어떻게 얻는 것인가
-
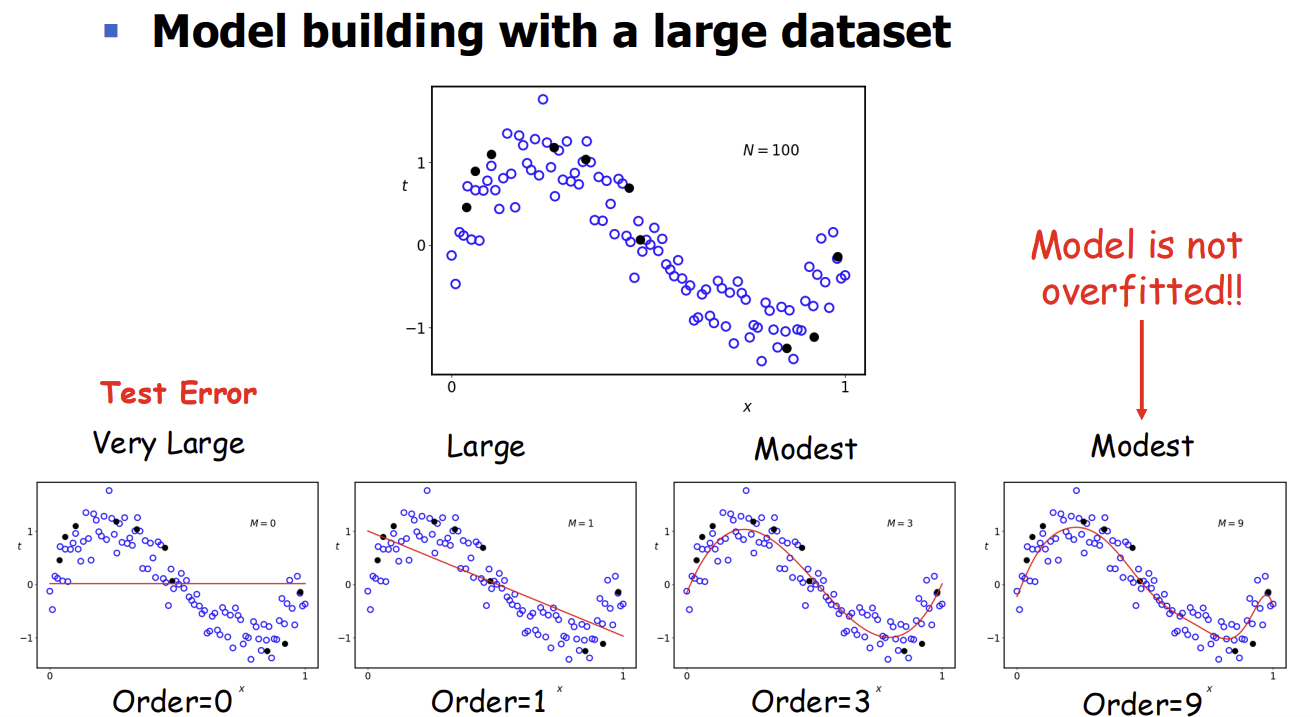
Data 늘리기
-
학습하는 모델 수를 늘리기 Cross valiation / hold out method을 사용하여 실제 데이터에서 성능이 가장 좋은 모델을 선택하는 것이다. 이 부분은 Week 5에서 나온다
-
Regularization method 사용 이 부분도 Week 5에서 나온다