AOP: Automated and Interactive LLM Pipeline Orchestration for Answering Complex Queries 리뷰
Background
다양한 data로부터 multi-hop retrieval, linking, 추론, 분석 능력이 요구되는 query 처리를 하기에는 LLM은 아직 부족하다.
$\rightarrow$ 이 query을 처리하기 위해서는 task을 sub-task으로 분해하고 orchestration, pipleline optimization 등이 요구된다
이런 query의 예시는 3가지가 있다.
-
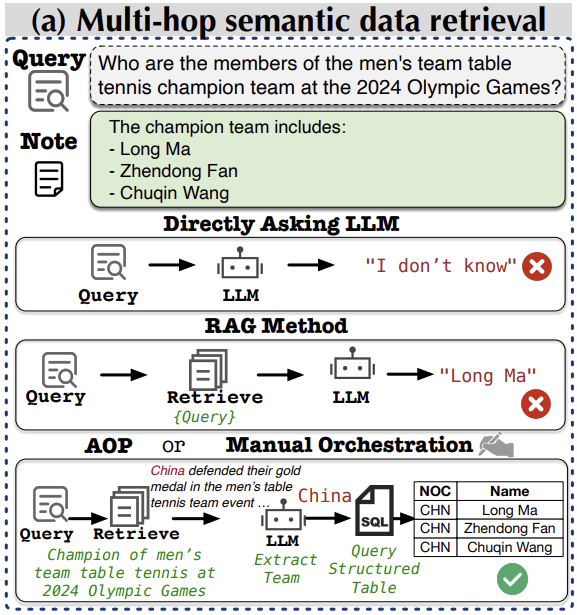
Multi-hop data retrieval : Structured, Unstructured data끼리 연결하고 여러번 retrieval을 요구하는 task
-
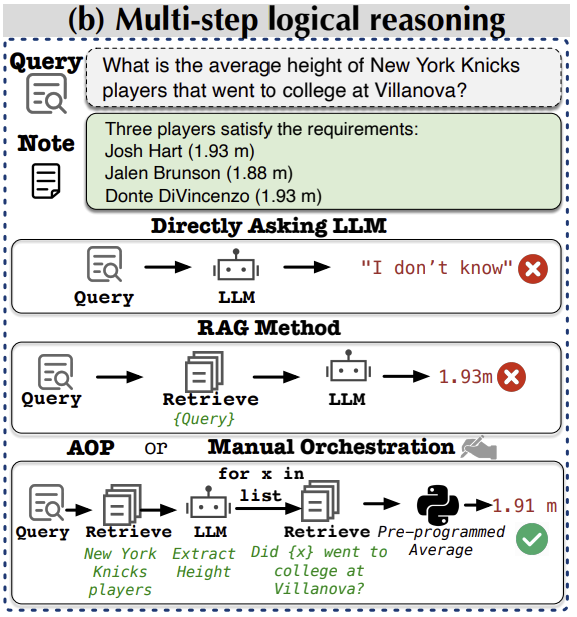
Multi-step reasoning : 여러 단계의 추론이 필요한 task (정확한 정보 가져오기 + 이에 대한 정확한 추론)
-
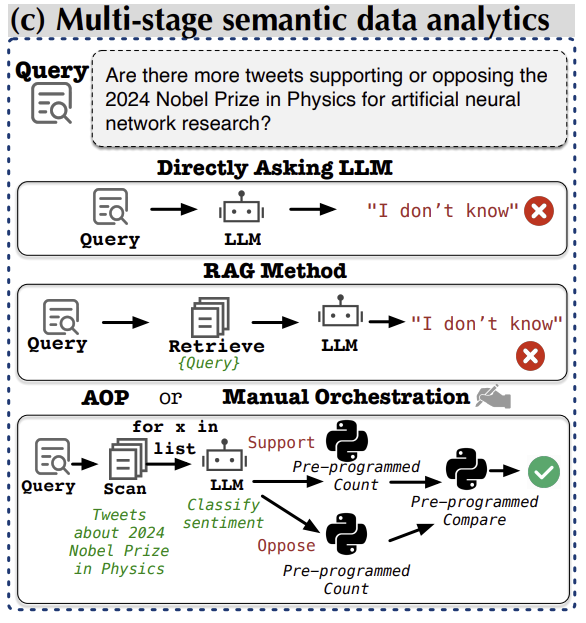
Multi-stage semantic data analytics: Query의 의미를 분석하기 위해서 여러 단계가 요구되는 task
이런 query을 해결할 수 있도록 하기 위해서 기존에는 사람이 직접 query 성격에 맞게 sub-task으로 나누고 prompting, retrieval, pre-programmed steps의 조합을 가진 static한 pipeline을 정의했다. 이런 pipeline은 성능이 좋긴 하지만 다음과 같은 문제점을 가지고 있다.
- 이런 orchestration 과정은 비용이 비싸고,
- pipeline의 한 부분이 잘 작동하지 못해서 이상한 결과를 내놨을 때, pipeline 실행 도중에 이 부분을 유동적으로 변경할 수 없다는 것,
- query의 성격별로 직접 orchestration을 하기에는 너무 비효율적이고 manual orchestration은 다양한 query에 적용될 수 없어서 제한된다는 것이다
AoP: Automated and Interactive LLM Pipeline Orchestration for Answering Complex Queries
$\rightarrow$ AoP는 이런 query을 해결하기 위해서는 결국 사람의 개입 없이 pipeline orchestration이 자동화시키는 것이 필수라고 본 것이다.
이때, 사람이 직접 만든 pipeline이란 무엇인가라는 질문을 답해야 한다. AoP는 pipeline이 그저 여러 semantic operator (의미를 기반으로 작동하는 함수)의 집합이라고 정의하였다. 따라서 LLM에게 정의된 여러 semantic operator들을 제공해준다면 LLM이 자동으로 query을 해결하기 위해 필요한 operator들을 선택하고 pipeline orchestration까지 잘 할 것이라고 주장한다.
그렇다면 operator을 어떻게 정의할 것인지, 문제를 해결하기 위해서 다양한 조합의 operator을 사용할 수 있는데 어떻게 최적의 pipeline을 선택할 것인지, pipeline을 어떻게 알아서 수정하고 평가할 것인지를 설계해야 한다.
AoP는 Semantic operator (의미를 기반으로 한 함수), multi-step 기반 pipeline(plan) 생성, multi-hop retrieval 기반 물리적 연산자, 병행+상호작용 가능한 pipeline execution을 통해 자동화된 pipeline orchestration이 가능하도록 하였다. AoP는 자연어 query을 입력받을 때, 자동으로 필요한 operator을 선택하고, 상호작용 가능하고 효율적인 pipeline을 orchestration을 통해 만들고, 스스로 고쳐가면서 작동하는 framework이라고 보면 된다.
AOP System 구조
AoP는 구조를 layer를 기준으로 분리하였다.
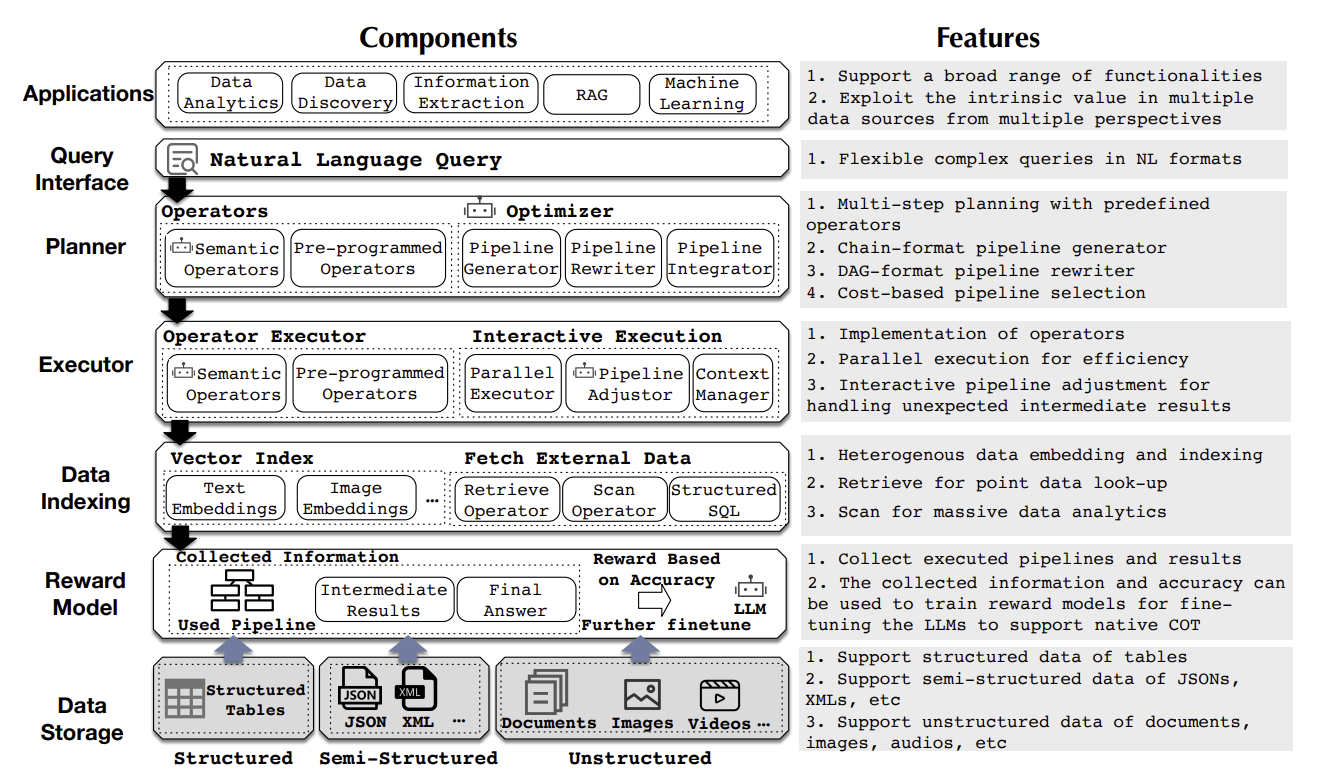
Query Interface
사용자가 자연어(NL) query을 입력하는 layer이다.
Planner
Multi-step planning을 하는 layer이다.
Operators
하나의 기능을 하는 함수 (tool)으로 보면 된다.
Operator는 pre-program이 가능한 operator와 LLM 기반 operator으로 나뉜다.
각 operator마다 description대로 정해진 task을 수행하도록 설계되어있다.
Optimizer
최적의 execution pipeline을 자동으로 생성하는 부분이다.
- Pipeline Generator
NL query와 선택한 operator들을 기반으로 여러 chain pipeline을 생성하는 operator이다.
LLM은 기본적으로 확률을 기반으로 작동하기 때문에 각 pipeline마다 다른 논리 구조를 가질 가능성이 높다. 따라서 여러 개의 후보 chain pipeline을 생성하면 다양한 관점의 해결 pipeline들을 얻을 수 있다.
- Pipeline Rewriter Pipeline Generator가 생성한 chain pipeline들을 Directed Acyclic Graph (DAG) 구조로 재작성하는 operator이다. DAG 구조로 바꿈으로써 병렬 실행 및 operator들이 독립적으로 실행될 수 있다.
- Pipleine Integrator 여러 pipeline에서 나온 결과들을 최종으로 종합해서 최종 답안을 내는 operator이다.
- Cost-Based Pipeline Optimization 생성된 여러 chain pipeline들의 계산량을 계산하여 제일 효율적인 pipeline을 선택하는 operator이다.
Executor
제일 효율적이라고 판단된 pipeline을 실제로 실행하여 최종 답을 도출하는 layer이다.
Operator Executor
Pipeline을 구성하는 각 operator들을 실행하는 역할을 한다.
Interactive Execution
-
Parallel Execution Pre-fetching 등의 방법을 사용하여 operator들을 병렬으로 실행할 수 있게 하는 부분
- Pipeline Adjustor 중간 결과들을 확인해가면서 pipeline을 수정한다. Retrieval을 실패하거나 operator가 예상치 못한 결과를 도출하였을 때 필요하다.
- Context Manager LLM의 context length는 제한되어 있기 때문에 Summarizer operator을 통해 지금까지의 정보를 압축하여 다음 step에 필요한 내용을 보관하게 한다.
Data Indexing
사용자가 제공한 SQL Database, Table, Image 등 데이터를 vector indexing하여 나중에 retrieval과 scanning을 효율적으로 될 수 있게 한다.
Reward Model
Pipeline의 정당성을 평가하기 위해 Process Reward Model (PRM)을 디자인하였다. Pipeline을 구성하는 operator을 하나의 action으로 정의할 때, reward model을 통해 최적의 action을 고르도록 학습시킬 수 있다. 각 execution마다 중간 결과/최종 결과 등을 기록하여 reward model을 만들었다.
Data Storage
데이터들을 저장하는 부분이다.
Semantic Operators
논문에서 정의한 semantic operator들은 총 22개로 logical와 physical level로 구분된다.
- 데이터 수집 및 탐색
- Retrieve: 외부 데이터베이스나 문서에서 질문과 관련된 특정 정보를 가져오기
- Scan: 데이터 소스의 모든 항목을 하나씩 읽어서 filtering 및 transformation
- Link: 서로 다른 형식의 데이터 간에 관계를 찾아 연결합니다. (ex: 표에 나온 팀 이름과 문서에 나온 팀 설명을 매칭)
- 데이터 가공 및 변형
- Extract: 데이터에서 필요한 특정 세부 정보만 뽑아내기
- Summarize: 긴 텍스트를 압축해서 context를 줄이거나 그냥 요약
- Refine: 모호하거나 불필요한 내용을 명확하게 재작성
- Translate: text 번역
- Transform: 데이터의 형식을 변경 (ex: 구조화된 표 데이터를 자연어 설명으로 변환)
- 논리 및 분석 (Logic & Analytics)
- Filter: 기준에 맞지 않는 불필요한 정보를 제거
- OrderBy: Retreived된 정보를 특정 기준에 따라 정렬
- Classify: text나 entity에 label을 부여하고 classification을 수행
- GroupBy: 특정 속성(나이, 지역 등)에 따라 데이터를 sub group으로 나눈다. SQL의 GroupBy와 역할 동일
- Compare: 두 값을 비교 연산자($<, >, =$ 등)나 의미적 유사성을 기준으로 대조
- Aggregate: 합계, 평균, 최댓값 등 통계적인 계산. Insights / dataset의 분포 알아내기 위해 사용
- Set: data 간의 합집합, 교집합, 차집합과 같은 집합 연산
- 추론 및 검증
- Plan: operator들을 어떤 순서로 쓸지 전체 파이프라인을 설계하기
- Evaluate: 정보의 품질이나 질문과의 관련성을 평가 (True/False 또는 확률값으로)
- Explain: 내린 결정의 이유 / 근거를 제시하도록 하여 reflection에 사용
- Integrate: 여러 정보의 진위를 판단하고 결합하여 최종 답변 생성
- Conceptualize: text에서 핵심 개념을 추출하고 단순화. 외부 정보 retrieval 또는 LLM 사용 (ex: 미국 대통령 부인 = 퍼스트 레이디)
- Generate: LLM을 통해 최종 답변을 생성. 다른 operator들이 모두 잘 작동하지 못할 때 쓰는 최종 수단
- Validate: 생성/retrieve된 내용이 맞는지 평가하기 위해 그 내용을 search query로 사용하여 retrieve한다. 그 search query가 실제로 주어진 document 안에 있는지 판단하여 진위 여부를 확인함.
Operator Execution
각 operator을 실행하는 방법은 operator를 어떻게 정의했는지 (그냥 물리적 함수 / LLM)에 따라 달라진다.
-
Prompt-based LLM Execution
LLM을 사용하여 operator을 구성했을 경우에 사용된다. 사용되는 prompt에는 수행할 operator 이름과 정보가 들어간다
The next operator is {Operator}. This operator is to {Operator Description}. Please execute it following the instructions and output the results
-
Pre-programmed Execution 그냥 함수 실행
LLM Pipeline Orchestration Framework
AOP는 query와 operator 설명서를 input으로 받아서 필요한 operator들을 바탕으로 pipeline을 orchestrate하고 중간 결과들을 관찰하면서 pipeline을 스스로 고치는 과정을 최종 답을 얻을 때까지 반복한다.
Automated Pipeline Orchestration
하지만 LLM은 이런 orchestration을 바로 할 수는 없다. 정확히, LLM은 필요한 operator까지는 알아낼 수 있더라도 복잡한 query를 분해해서 계획싸지 짜는 것을 혼자는 하지 못한다.
따라서 본 논문은 이 orchestration을 쉽게 할 수 있도록 LLM이 이미 잘하는 task별로 단계를 나누도록 도왔다.
- LLM은 최적은 아니더라도 chain pipeline 후보는 생성할 수 있고, $\rightarrow$ Generate Initial Pipelines
- 이 후보들을 DAG 구조로 변경하는 것도 할 수 있으며, $\rightarrow$ Rewrite Pipelines
- 여러 DAG을 하나의 pipeline으로 merge하는 것도 할 수 있다. $\rightarrow$ Combine Pipelines
1,2는 LLM의 prompting을 통해서 충분히 할 수 있고 3은 직접 만든 규칙을 전달하여 수행할 수 있다고 한다
Generate Initial Pipelines
사용한 prompt
Query: {Query}. The operators for planning the workflow are as follows:{Operator Explanations}. Please provide some effective and efficient pipelines consisting only of the operators above for answering the query and explain each pipeline
생성된 pipeline은 어떻게 보면 random이기에 여러개를 생성하도록 한 뒤, 최적 pipeline을 고르는 것으로 설계하였다.
이때, 이 pipeline들이 query를 답할 수 있더라도 linear하게 실행되기 때문에 비효율적이다.
Rewrite Pipelines
따라서, DAG 구조로 재작성하는 단계를 거치도록 하였다.
사용한 prompt
Certain operators can be executed in parallel to enhance efficiency. Please rewrite the pipeline as a directed acyclic graph (DAG) to maximize parallel execution without compromising the result quality
Combine Pipelines
이때 각 DAG는 제각각으로 행동하기 때문에 어떤 DAG가 제일 효율적이면서 효과적일지 예측을 할 수 없다. 따라서, 이들의 결과를 합치는 방법을 사용하여 정확성을 높였다.
각 DAG 끝에 Explain operator을 추가하여 각 DAG의 최종 결과를 요약/설명하도록 하였고 이 결과들을 최종적으로 Integrate operator에 넣어서 분석하도록 하고 최종 답을 도출하도록 하였다. 이 Integrate operator는 Best of N을 기반으로 (여러 예측값 중 가장 많이 등장 / 제일 적절한 것을 최종 답으로 선택) 작동한다고 보면 된다.
이런 방법을 통해 터무니없는 결과를 낸 pipeline을 제거할 수 있음
Interactive Pipeline Execution
Query Optimization
Extensions to Intelligent Data Lake Analytics
사용하는 데이터의 형식은 매우 다양한데 이들 사이를 linking하기 위해서는 이 data들을 하나의 구조로 통일시켜야 한다. (이미지와 text 간 비교 / Table과 이미지 간의 비교는 어려움)
각 data의 핵심 entity만 뽑아서 하나의 구조화된 형식으로 바꿀 수는 있지만 이런 방법은 정보가 유실될 가능성이 높다.
따라서 AOP는 하나의 embedding으로 변환하여 모든 종류의 data가 Natural language 요구사항과 similarity search가 가능하다면 좋을 것이라고 주장한다.
–> 이 문제는 gemini embedding 2로 해결 ?????