XLNet Generalized Autoregressive Pretraining for Language Understanding 리뷰
Background
지금까지의 Language modeling 방법은 두 가지로 나뉜다.
- Auto-regressive Language modeling : maximizing the likelihood under forward factorization \(max_{\theta} \, log \, p_{\theta} (x) = \sum_{t=1}^{T}log \, p_{\theta}(x_t \mid x_{<t}) = \sum_{t=1}^{T} log \frac {exp(h_{\theta} (x_{1:t-1})^Te(x_t))} {\sum_{x'} exp(h_{\theta} (x_{1:t-1})^Te(x'))}\)
이때 이 방법은 uni-directional context만 고려하게 된다는 것이 단점이다.
- Auto-encoding Language modeling (BERT): Maximizing the likelihood of reconstructing corrupted input ($\hat x$) \(max_{\theta} \, log \, p_{\theta} (\bar x \mid \hat x) = \sum_{t=1}^{T} m_t \cdot log p_\theta (x_t \mid \hat x) = \sum_{t=1}^{T} m_t \cdot log \frac {exp(H_{\theta} (\hat x)_t ^T) e(x_t)} {\sum_{x'} exp (H_\theta (\hat x)_t^T e(x'))}\)
$x_t$가 masked된 토큰일 때는 $m_t$ = 1이 되고 $H_\theta$는 길이 T의 sequence x를 hidden vectors로 mapping하는 Transformer이다.
두 방법의 장단점은 다음과 같다.
- Independence Assumption BERT는 [mask] token끼리는 영향을 주지 않는다는 가정 하에 language modeling을 한다.
- Input noise BERT에서 pretraining에 사용되는 [mask] token은 finetuning에서는 등장하지 않기 때문에 문제가 생긴다. 이 문제를 pretrain-finetune discrepency라고 한다.
- Context dependency Auto-regressive language modeling을 보면 $h_{\theta} (x_{1:t-1})$는 t까지의 uni-directional context만 고려한다.
논문에서 두 pretraining 방법의 장점만 가진 새로운 pretraining 방법을 고안하였다. 이를 Permutation Language Modeling이라고 한다.
Permutation Language Modeling
길이 T인 text sequence x의 순서를 바꾸면 총 T!개의 순서가 존재한다. 이 모든 순서들에 대해 동일한 parameter로 Auto-regressive Language modeling을 진행하면 Auto-regressive 방법으로 bi-directional context를 학습할 수 있게 된다.
$Z_T$를 length T index sequence [1,2,…, T]의 모든 permutation이라고 하자. $z_t$와 $z_{<t}$는 각각 permutation $z \in Z_T$의 t번째 element와 t-1번째까지의 elements라고 하자. 그렇다면 다음과 같은 식을 세울 수 있다. \(max_{\theta} E_{z \sim Z_T} [ \sum_{t=1}^{T} log \, p_{\theta} (x_{z_t} \mid x_{z<t}) ]\) 이때, $\theta$는 학습을 할 때, 모든 순서들을 보기 때문에 $x_t$는 sequence를 구성하는 다른 모든 token들과의 연관성이 계산되어 bidirectional context를 학습하게 된다. 즉, 이 방법은 어떻게 보면 일반적인 Auto-regressive 방법이므로 BERT가 가지고 있던 independence assumption과 pretrain-finetune discrepency를 해결하면서 bi-directional context까지 학습하는 language modeling 방법인 것이다.
ex) Sequence $x: [x_1, x_2, x_3, x_4]$가 있을 때 $z \sim Z_T = [4,2,1,3]$ 이라면
t=1: $log p_{\theta} (x_4)$ t=2: $log p_{\theta} (x_2 \mid x_4)$ t=3: $log p_{\theta} (x_1 \mid x_2, x_4)$ t=4: $log p_{\theta} (x_3 \mid x_1, x_2, x_4)$
t=4일 때 $x_3$을 예측하는 과정에서 $x_4$를 참고하게 된다. => bidirectional context를 고려할 수 있게 된다.
이때 Standard Transformer를 사용한다면 문제가 생긴다. $x_2$와 $x_1$이 주어질 때 다음 token을 예측하라는 task가 있을 때, context = $[x_1, x_2]$와 attention score가 가장 높은 token이 나와야 하는데 Standard Transformer의 context representation에 어떤 위치에 있는 token을 예측해야 하는지에 대한 정보가 들어있지 않다. 즉, 다음 token이 $x_3$일 때나 $x_4$를 $x_1$와 $x_2$를 바탕으로 softmax를 사용하여 예측할 때 동일한 확률분포가 계산된다.
이를 해결하기 위해서는 Target position을 고려한 context representation을 통해 예측을 해야 한다. Target position aware한 next-token distribution을 계산하기 위해서 계산을 바꾼다.
\[p_{\theta} (X_{z_t} = x \mid x_{z_<{t}}) = \frac {exp (e(x)^T g_{\theta} (x_{z<t}, z_t))} {\sum_{x'} exp (e(x') g_{\theta} (x_{z<t}, z_t)^T)}\]이때, $g_{\theta} (x_{z_{<t}})$은 target position $z_t$까지 고려한 context representation이다.
Target-aware Context Representation
Standard Transformer를 사용하면서 $g_{\theta} (x_{z_{<t}})$를 정의하기 위해서는 다음 모순점을 해결해야 한다.
- Token $x_{z_t}$를 예측하기 위해서는 $g_{\theta} (x_{z_{<t}})$는 내용 정보 $x_t$가 아니라 위치 정보 $z_t$만 들어있어야 한다.
- $x_{z_j}$ with j>t를 예측하기 위해서는 $g_{\theta} (x_{z_{<t}})$는 정확한 context를 제공하기 위해 $x_{z_t}$의 내용도 들어있어야 한다.
즉, Standard Transformer를 사용하면 각 permutation에 대해 modeling을 진행할 때 동일한 parameter $\theta$를 사용하기 때문에 $g_{\theta} (x_{z_{<t}})$에는 $x_t$의 위치 정보 $z_t$만 들어있어야 하면서도 $x_t$의 내용 정보도 들어있어야 하는것이다.
이 문제를 해결하기 위해서 context representation을 두 종류의 representation으로 나누었다.
- Content representation $h_{\theta} (x_{z{\le t}})$ : context와 $x_{z_t}$까지 모두 encode한 representation. $h_{z_t}$로 간결하게 표현한다.
- Query representation $g_{\theta} (x_{z_{<t}}, z_t)$: context $x_{z<t}$와 $x_t$의 위치정보 $z_t$만 encode한 representation. $g_{z_t}$로 간결하게 표현한다.
첫 layer의 query representation은 trainable vector w로 초기화하고 content representation은 그 위치의 단어 embedding으로 초기화한다. 그 이후로는 다음 update 방법으로 갱신된다.
$g$는 계속해서 이전까지의 전체 context와 현재 위치 정보만 갖게 되고 \(g_{z_t}^{(m)} \leftarrow Attention (Q = g_{z_t}^{m-1}, KV = h_{z_{<t}}^{m-1} ; \theta)\) $h$는 계속해서 지금까지의 전체 context를 지니게 된다. h의 update 방법은 Standard Transformer와 동일하다. \(h_{z_t}^{(m)} \leftarrow Attention (Q = h_{z_t}^{m-1}, KV = h_{z_{\le t}}^{m-1} ; \theta)\)
Pretraining 할 때만 g를 사용하고 finetuning을 할 때는 $h$만 사용한다. $g$에서 학습된 모델 parameter $\theta$는 pretraining을 통해 bi-directional context를 고려할 수 있는 능력을 지니게 되고 동일한 parameter가 $h$에 사용되기 때문에 finetuning 할 때 $g$를 사용하지 않아도 동일하게 bi-directional context representation을 얻을 수 있다.
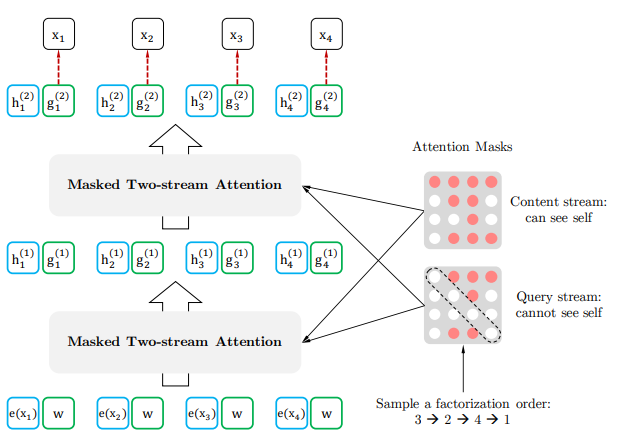
Partial Prediction 도입
\(max_{\theta} E_{z \sim Z_T} [ \sum_{t=1}^{T} log \, p_{\theta} (x_{z_t} \mid x_{z<t}) ]\) 이 objective으로 그대로 학습하는 것은 연산량이 많아지기 때문에 convergence 속도가 느려진다. 연산 overload 문제를 개선하기 위해 각 permutation order의 끝 token들만 예측하는 것으로 objective를 바꿨다. 즉, z를 non-target subsequence $z_{\le c}$와 target subsequence $z_{>c}$으로 나워서 non-target subsequence가 주어졌을 때 target subsequence를 예측하는 likelihood을 최대화하는 방향으로 학습을 시켰다.
최종 objective function \(max_{\theta} E_{z \sim Z_T} [ log p_{\theta} (x_{z_{>c}} \mid x_{z_{\le c}}) ] = E_{z \sim Z_T} [\sum_{t=c+1}^{|z|} log p_{\theta} (x_{z_t} \mid x_{z_{<t}})]\)
이렇게 하면 장점이 추가적으로 non-target subsequence에 대해서는 query representation을 계산하지 않아도 되므로 연산량이 줄어든다.
Transformer-XL의 발상 사용
XL-NET의 objective는 결국 Auto-Regressive에 해당되기 때문에 SoTA Auto-Regressive 모델이었던 Transformer-XL의 recurrence와 relative positional embedding 아이디어를 pretraining에 활용하였다.
Recurrence 적용
처리해야 하는 sequence $S$를 $\tilde x = S_{1:T}$와 $x = \ S_{T+1:\, 2T}$로 나눈 다음에 $\tilde z$를 [1, … ,T]의 permutation, $z$를 [T+1,… , 2T]의 permutation이라고 하였더. $\tilde z$를 바탕으로 첫 번째 subsequence의 content representation을 계산한 다음 이 representation을 다음 subsequence의 content representation을 계산할 때 cache하면 된다. m-th layer의 첫 번째 subsequence의 content representation을 $\tilde h^{(m)}$이라고 할 때 다음 subsequence의 content representation은 다음과 같이 계산하면 된다.
\[h_{z_t}^{(m)} \leftarrow Attention(Q = h_{z_t}^{(m-1)}, KV = [\tilde h^{(m-1)}, h_{z_{\le t}}^{(m-1)}]; \theta)\]이때 positional encoding은 순서가 바뀌지 않은 원래의 sequence의 실제 위치에만 의존하는 것을 알 수 있다. 즉, $\tilde h^{(m-1)}$을 계산되고 나서부터는 $\tilde z$는 고려하지 않아도 되는 것이다. 의도한 것은 이전 segment의 모든 factorization order를 활용하여 현재 segment를 더 효과적으로 처리할 수 있도록 한 것이다. Query representation도 동일하게 계산된다.
Multiple Segments Modeling
QA와 같은 task에서는 여러개의 segment를 처리해야 한다. XLNet을 multiple segment에 대해 pretrain하기 위해서는 BERT와 비슷하게 segment의 concatenation을 하나의 sequence로 처리하고 permutation language modeling을 적용한다. [CLS, A, SEP, B, SEP] 형식의 input을 사용하지만 Next sentence prediction과 같은 task는 필요없기 때문에 사용하지 않았다.
Relative Segment Encodings sequence에서 pair of position i와 j가 주어졌을 때, position 정보를 encoding하기 위해 segment encoding을 사용하였다. 두 position 모두 동일한 segment에 위치하면 segment encoding을 $s_{ij} = s_{+}$으로, 아니라면 $s_{ij} = s_{-}$으로 설정하였다. 즉, 어떤 segment에서 온 것이 중요한 것이 아니라 두 위치의 관계만 modeling하는 Transformer-XL의 relative positional embedding 아이디어를 사용한 것이다. Transformer-XL의 attention score 계산식
\[(u + W_q\,\cdot E_{x_i})^T\,\cdot W_{K,E}\,\cdot E_{x_j} + (v + W_q\,\cdot E_{x_i})^T\,\cdot W_{K,R}\,\cdot R{i-j}\]에서 $(v + W_q\,\cdot E_{x_i})^T\,\cdot W_{K,R}\,\cdot R{i-j}$의 부분을 relative segment encoding을 이용하여 $a_{ij} = (b + q_i)^T \cdot s_{ij}$으로 바꾼 것이다. 이때 b는 학습이 가능한 head-specific bias vector로 generalization 능력을 높여주고 두 개 이상의 segment를 처리해야 하는 task에서는 absolute position 정보는 사용할 수 없기에 relative segment encoding으로 position 정보를 대체하였다.