Transformer-XL Attentive Language Models Beyond a Fixed-Length Context 리뷰
Background
현재 Neural Network를 통해 long term dependency를 고려하는 것은 어렵다. RNN 기반 모델들은 exploding/vanishing gradient 문제가 존재하고 Attention 기반 모델들 (논문에서는 Character level language transformer를 언급)은 RNN을 능가하지만 여러 문제를 갖고 있다.
- Context Fragmentation
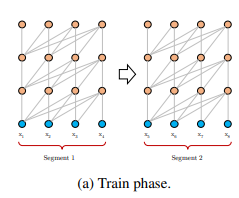
Transformer의 Self attention은 고정된 context length에 대해서만 계산될 수 있어 학습한 context length 범위 외의 내용까지는 고려하지 못하는 구조이다. 또, 고정된 context length 단위로 corpus를 분해하기 때문에 이 과정에서 text의 구조나 semantic boundary가 깨질 가능성이 높다. 따라서 Transformer는 이전 내용을 가져오지 못하기 때문에 첫 token 예측을 잘 하지 못한다. - Padding 사용 비효율성
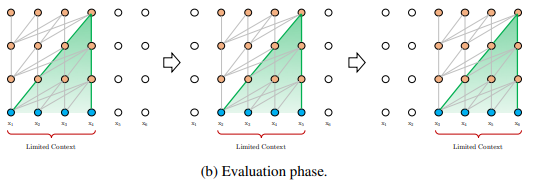
- O($n^2$)의 Inference 시간복잡도
하나의 segment $s_{i-1}$에 대해 hidden state를 계산하고 다음 token $t_i$을 예측하고 나면 다시 $s_i = [s_{i-1} + t_i]$에 대해 hidden state를 다시 계산해야 함.
Context Fragmentation Visualization
Inference 시간 문제 Visualization
Transformer-XL
기존 Transformer의 문제점을 해결하기 위해 크게 두 가지 방법을 사용한다.
- Recurrence: 각 text segment에 대해 hidden state을 다시 계산하는 것이 아니라 이전 segment들의 hidden state을 재사용하여 context fragmentation 문제 해결함
- Effective Relative positional encoding: 더 긴 context 길이의 순서 정보까지 고려하게 해줌
Model
$x = (x_1, x_2, … , x_T)$의 token corpus가 주어졌을 때, objective은 다음과 같다.
\[P(x) = \prod_{t} P(x_t \mid x_{<t})\]학습 가능한 neural network는 context $x_{<t}$을 고정된 크기의 hidden states으로 표현하고 이를 word embedding과 곱해져서 logits를 얻는다. 이 logits 값을 softmax을 통해 vocabulary 전체의 확률 분포로 바꿔 다음 token을 예측한다.
Segment-Level Recurrence with State Reuse
이전 segment의 hidden state를 fix하여 현재 segment의 hidden state을 계산할 때 cache된다. 이를 통해 현재 segment를 처리할 때 이전 segment의 정보를 고려할 수 있게 된다. 이 방법을 통해 long term dependency를 고려할 수 있게 되고 context fragmentation을 해결할 수 있게 된다.
이 내용을 수식으로 표현해보자. $L$ 길이를 가진 두 segment $s_r = [x_{r,l}, … , x_{r,L}]$와 $s_{r+1} = [x_{r+1,l}, … , x_{r+1,L}]$가 존재한다고 하자. 그리고 n번째 layer의 segment $s_r$의 hidden state를 $h_r^n \in R^{L \times d}$ where d = hidden dimension라고 하자. 그렇다면 n번째 layer의 다음 segment $s_{r+1}$의 hidden state $h_{r+1} ^ n$는 다음 방법으로 계산된다.
\[\tilde h_{r+1}^{n-1} = [SG(h_r^{n-1}) \bullet h_{r+1}^{n-1}]\] \[q_{r+1}^n, k_{r+1}^n, v_{r+1}^n = h_{r+1}^{n-1}W_q^T, \tilde h_{r+1}^{n-1}W_k^T, \tilde h_{r+1}^{n-1}W_v^T\] \[h_{r+1}^n = TransformerLayer (q_{r+1}^n, k_{r+1}^n, v_{r+1}^n)\]이때 SG는 Stop Gradient로 미분이 안 되는 고정된 상수로 만드는 함수라고 보면 되고 $\bullet$는 두 hidden state을 concatenate 한 것으로 보면 된다.
이 수식을 직관적으로 설명하면 $\tilde h_{r+1}^{n-1}$은 n-1번째 layer에서 계산한 이전 segment r의 hidden state $h_r^{n-1}$와 현재 segment r+1의 hidden state $h_{r+1}^{n-1}$을 합친 것이다. 이 합쳐진 hidden state를 사용하여 다음 Transformer Layer의 Query, Key, Value를 구성한다. 이때 제일 중요한 것은 Query $q_{r+1}^n$은 현재 segment r+1에 대한 정보만 정보만 지니고 있고, Key, Value인 $k_{r+1}^n$와 $v_{r+1}^n$는 이전 segment의 정보까지 포함한 정보를 지니도록 한 것이다. 즉, Query는 현재 segment의 정보를 가지고 이전 segment 정보까지 고려한 Key에 대해 검색을 하여 Attention score를 계산하는 것이다. 이를 통해 이전 segment 뿐만 아니라 더 이전 정보까지도 고려한 Attention score를 계산할 수 있게 된다.
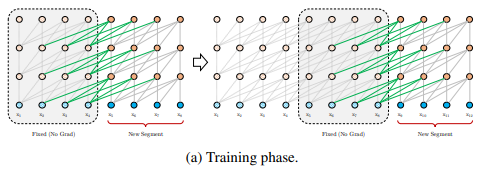
이를 통해 최대 $O(N \times L)$ dependency length까지 고려할 수 있게 되었다. 또, 추론 속도도 높아진다. Vanilla Transformer는 새로운 token을 예측할 때마다 그 token을 기존 context에 다시 포함시켜 self attention을 계산해야 했지만, Transformer-XL은 이전 hidden state을 다시 사용하여 시간을 줄인다.
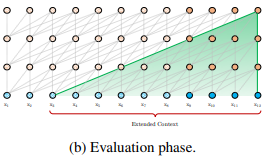
이때, 그림을 보면 알 수 있듯이 충분한 GPU만 있다면 이전 segment 정보 뿐만 아니라 더 과거의 내용까지 고려할 수 있다. 따라서 $h_r^{n-1}$로 표현하지 않고 $m_r^n \in R^{M \times d}$로 표현하기로 하였다.
Relative Positional Encoding
Positional encoding은 정보를 어떻게 재구성하고 어디를 더 참고해야 할 지에 대한 정보를 제공하기 때문에 매우 중요하다. Recurrence를 적용할 때에도 Position 정보를 활용하기 위해서는 이전 segment와 현재 segment를 구분할 수 있어야 한다. 하지만 위치 정보 주입을 기존의 방법 (sinusoidal / learned absolute positional embedding을 더하는 방법)으로 한다면 이 둘은 구별이 불가능하다.
이유: Absolute positional embedding을 더하는 방법을 사용한다고 해보자. $U \in R^{L_{max} \times d}$를 Absolute positional embedding이라고 하고 $E_{s_r}$를 sequence $s_r$의 word embedding sequence라고 하자.
\(h_{r+1} = f(h_r, E_{s_{r+1}} + U_{1:L})\)
$E_{s_r}$와 $E_{s_{r+1}}$은 동일한 positional embedding 값이 더해져서 Transformer가 이를 구별할 수 없게 된다. 즉, $s_r$의 $x_{r,j}$와 $s_{r+1}$의 $x_{r+1,j}$은 구별이 불가능해진다.
따라서 이 연구에서는 relative positional encoding을 사용한다. 이때 Vanilla Transformer처럼 input word embedding에 더해주는 것이 아니라 attention score 계산할 때 주입하기로 했다. 이를 통해서 Query vector가 $x_{r,j}$와 $x_{r+1, j}$를 구분할 수 있게 되어 순서에 맞는 올바른 단어를 검색할 수 있게 된다.
Attention score 변화
Standard Transformer의 query $q_i$와 key $k_j$의 attention score 식은 다음과 같다.
\((W_q \,\cdot (E_{x_i} + U_i))^{T} \,\cdot (W_k \,\cdot (E_{x_j} + U_j))\)
Transformer-XL의 attention score 식은 다음과 같다.
\((u + W_q\,\cdot E_{x_i})^T\,\cdot W_{K,E}\,\cdot E_{x_j} + (v + W_q\,\cdot E_{x_i})^T\,\cdot W_{K,R}\,\cdot R{i-j}\)
변한 것 설명
- 기존 transformer 식 (b)와 (d)에 있는 absolute positional embedding $U_j$을 relative positional embedding $R_{i-j}$로 바꿨다. 이는 어디를 참고해야 하는지 결정할 때 상대적 위치만 필요하다는 intuition을 반영한 것이다. 이때 R는 sinusoidal encoding matrix이다.
- 기존 transformer 식 ( c )에 있는 $U_i^TW_q^T$를 학습 가능한 parameter $u \in R^d$로 바꿨다. 즉, 기존 식에서는 query vector의 위치를 고려하여 attention score를 계산했지만, Transformer-XL에서는 query vector가 어떤 position에 있든지 동일하게 표현되도록 한 것이다. 이렇게 바꾼 이유는 다른 단어들을 향한 attentive bias가 query vector의 위치에 영향을 받지 않도록 하기 위해서이다. (d)의 $U_i^TW_q^T$가 $v \in R^d$로 바뀐 이유도 동일하다.
- Key의 Weight matrix $W_k$를 $W_{k,E}$와 $W_{k,R}$으로 분해하여 content based key vectors와 location based key vectors를 표현하였다.
Transformer-XL attention score 식의 각 항은 직관적인 의미를 지니게 된다.
( a )는 content based addressing으로 query와 key의 내용 상관성을 보여주는 attention score
( b )는 content dependent positional bias로 query의 내용을 바탕으로 key의 어떤 위치를 봐야하는지 보여주는 attention score
( c )는 global content bias로 key 내용의 중요도를 보여주는 attention score
( d )는 global positional bias로 query와 key의 상대적 거리에 대한 중요도를 보여주는 attention score
최종 model 구조
\[\tilde h_{r}^{n-1} = [SG(m_r^{n-1}) \bullet h_{r}^{n-1}]\] \[q_{r}^n, k_{r}^n, v_{r}^n = h_{r}^{n-1}W_q^T, \tilde h_{r}^{n-1}W_k^T, \tilde h_{r}^{n-1}W_v^T\] \[A_{r,i,j}^n = {q_{r, i}^n}^Tk_{r,j}^T + {q_{r, i}^n}^TW_{k,R}^nR_{i-j} + u^Tk_{r,j} + v^TW_{k,R}^nR_{i-j}\] \[a_r^n = Masked-Softmax(A_{r}^n)v_r^n\] \[o_r^n = LayerNorm(Linear(a_r^n) h_r^{n-1})\] \[h_r^n = PositionwiseFeedForward(o_r^n)\]이때 $h_r^0 := E_{s_r}$으로 word embedding sequence이다.