MASS Masked Sequence to Sequence Pre-training for Language Generation 리뷰
Background
Causal language modeling이나 BERT 기반 language modeling은 conditional language generation task에 적합하지 않다. 이런 task에 효과적이기 위해서는 sequence to sequence learning을 기반으로 한 Language Modeling을 해야 한다.
Sequence to Sequence Learning
$(x,y) \in (\mathcal{X}, \mathcal{Y})$은 문장 pair 집합이며 $x = (x_1, x_2, …, x_m)$은 source sentence이고 $y = (y_1, y_2, …, y_m)$는 target sentence라고 하자. 이때, sequence to sequence learning은 $P(y \mid x ; \theta)$를 잘 예측하기 위해 $\theta$를 학습하는 과정이다.
Sequence to sequence learning에 사용하는 주된 구조는 encoder - decoder 구조이다. Encoder를 통해 source sentence를 이해하고 hidden state representation으로 encoding하고, Decoder를 통해 source sentence의 representation와 preceding tokens를 바탕으로 target sentence의 token을 하나씩 생성하도록 하도록 한다.
이 논문은 Transformer를 이용하여 conditional language generation에 효과적인 Sequence to sequence Language Modeling 방법을 소개한다.
MAsked Sequence to Sequence Pre-Training (MASS)
Unsupervised prediction task로 Language modeling 방법을 설계하였다. Unpaired source sentence $x \in \mathcal{X}$가 있을 때, $x^{\backslash u:v}$는 position u에서 v까지의 fragment가 mask된 x이고, $x^{u:v}$는 position u에서 v의 fragment이다. 각 masked된 token은 [MASK] token으로 대체하고 masked sentence의 길이는 바꾸지 않는다.
MASS 는 이때 $x^{\backslash u:v}$ 입력이 주어졌을 때 $x^{u:v}$을 예측하도록 pretrain하는 방법이다. Objective function은 다음과 같다.
\[L(\theta, \mathcal{X}) = \frac {\sum_{x \in \mathcal{X}} log P( x^{u:v} \mid x^{\backslash u:v} )} {|\mathcal{X}|}\] \[= \frac {\sum_{x \in \mathcal{X}} log \prod_{t=u}^{v} P( x_t^{u:v} \mid x_{<t}^{u:v}, x^{\backslash u:v} ; \theta) } {|\mathcal{X}|}\]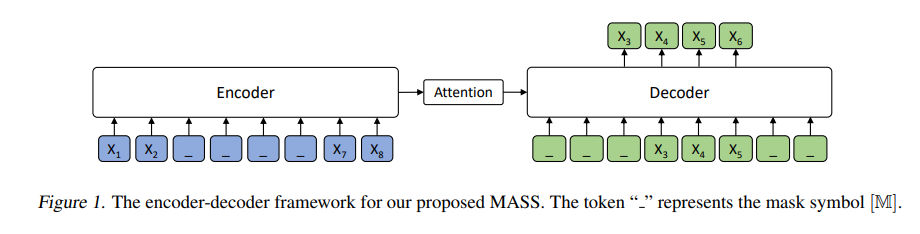
이 figure는 source sentence에서 $x_3, x_4, x_5, x_6$이 masked 되었을 때 pretrain 방법을 시각화한 것이다. Decoder는 Encoder로부터 $x_1, x_2, x_7, x_8$의 representation을 바탕으로 $x_3$부터 $x_6$까지만 예측을 한다. 이때 position 4-6에서부터 $x_3, x_4, x_5$가 순차적으로 input으로 주어지고 나머지 token들 (position 1-3과 position 7-8)은 [MASK] token 형태로 주어진다. 이런 설계는 Encoder와 Decoder를 jointly하게 pretrain하기 위해 설계된 것이다.
BERT, GPT, MASS의 관계
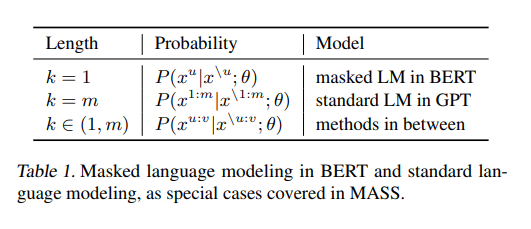
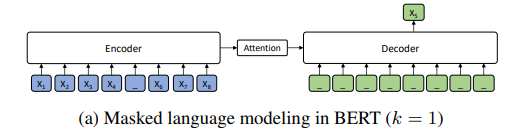
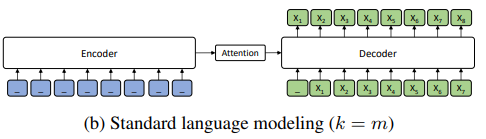
사실은 BERT와 GPT는 MASS의 특별한 case로 해석될 수 있다. 총 mask하는 token 수인 hyperparameter k = v - u + 1의 값의 따라 다양한 pretraining methods와 동일해질 수 있다.
- k=1 일 때
mask하는 token 수가 1개이므로 unmasked source tokens ($x^{\backslash u}$)의 representation이 주어졌을 때 masked token $x^u$를 예측하는 BERT pretraining과 비슷하다.
- k=m일 때
mask하는 token 수가 m개이므로 encoder에서는 모든 token들이 mask 되어있고 decoder는 모든 token들을 차례대로 예측하는 GPT의 Auto-regressive pretraining과 비슷하다.
MASS 특징 정리
MASS의 특징은 Encoder와 Decoder를 conditional language generation task를 위해 jointly하게 pretrain 한다는 것이다. 이는 Sequence to sequence framework를 활용하여 masked된 token들만 예측하도록 함으로써 가능하다.
- Encoder가 unmasked된 token들을 이해하게 하고 Decoder가 Encoder의 representation에서 중요한 정보를 추출하도록 만든다.
- Decoder가 연속적인 token들을 예측하도록 하여 더 나은 language modeling을 하게 한다.
- Encoder에서는 unmasked 된 token들을 Decoder에서는 mask 처리하는 방법은 Decoder가 Encoder의 representation에서 더 중요한 정보들을 추출하는데 집중하게 한다.