Let’s Verify Step by Step 리뷰
Background
LLM은 현재 뛰어난 추론 능력을 가지지만 여전히 hallucination으로 인한 오류가 빈번하다. Hallucination은 특히 multi-step reasoning이 요구되는 영역에서 취약하다. Reasoning 과정에서 하나의 논리적 오류가 발생한다면, 그 이후부터의 추론 과정과 답 도출에 영향을 주기 때문이다.
Hallucination을 없애는 방법 중 효과적인 방법은 reward model을 통한 강화학습이다. Desirable과 Undesirable output을 잘 구별하는 reward model을 학습하여 이 reward을 바탕으로 강화학습을 하면 align이 잘 돼서 hallucination이 줄어든다. 이때 이 방법은 reward model의 성능에 매우 의존적이기 때문에 신뢰성이 높은 reward model을 학습하는 방법은 매우 중요한 연구 주제이다.
Reward model을 학습하는 방법은 크게 두 가지로 나뉜다.
(1) Outcome Supervision
Model이 생성한 CoT의 마지막 결과만 실제 답과 비교하여 학습하는 방법
$\rightarrow$ Outcome supervision은 과정이 틀려도 답만 맞으면 그 과정도 옳다고 학습하는 문제점이 있다.
(2) Process Supervision
Model이 생성한 CoT의 모든 step에 feedback을 받아 학습하는 방법
$\rightarrow$ Process supervision은 더 자세한 feedback을 받을 수 있으며, 오류가 발생한 지점까지 알 수 있고, 사람의 생각하는 과정을 학습해서 alignment 효과가 더 뛰어나다.
하지만 이전 연구에서 Grade School Math 도메인에서 두 방법의 성능을 비교하였을 때, 비슷한 성능을 보였다. 본 논문은 이 의문점을 해결하기 위해 더 세밀한 실험을 설계하였다.
- 더 좋은 base model을 사용
- human feedback 증가
- 더 어려운 수학 문제 도메인 (MATH: 수학 경시대회) 에서 성능을 평가
Methods
Outcome supervision과 Process supervision의 결과를 비교하기 위해 supervision 방법을 한다. Outcome supervision의 경우에는 최종 답만 비교하면 되기 때문에 평가를 automatic하게 할 수 있지만, Process supervision의 경우에는 전체 step을 평가해야 하기 때문에 human labeler를 도입하기로 하였다.
실험은 사용하는 모델의 크기에 따라 Large / Small로 나눈다. Human feedback data의 비용은 비싸기 때문에 small 모델을 활용하는 실험에서는 human feedback을 사용하지 않고 더 큰 reward model을 통해 small model을 supervise하는 방법을 사용하였다.
Scope
각 model scale에서 동일하고 고정된 generator로 답안들을 생성한다. 원래대로라면 학습한 reward model을 바탕으로 generator를 RL로 학습하는 것이 맞지만, generator의 성능 향상은 본 논문의 목표가 아니라 오직 reward model의 학습 방법에만 집중한다고 한다.
Reward model의 성능 평가는 generator의 답안들 중에서 best of N (최고의 답안 찾기)을 통해 순위가 제일 높은 답안을 찾았을 때, 이 답이 실제 답과 일치하는 지를 보는 방법을 사용한다.
Base Model
본 논문에서 Large scale의 경우 모든 모델은 GPT-4 기반으로 한다. 이 모델은 RLHF으로 학습되지 않았으며 오직 next token prediction으로만 pretrain된 모델이다. Small scale의 경우, GPT-4과 동일한 구조를 가지지만, 200배 적은 computation으로 pretrain된 모델이다.
이때, 모든 모델들을 1.5B 크기의 MathMix (수학 관련 토큰들)로 finetuning을 한다. 이전 연구 결과에 따르면 이렇게 수학 도메인에 미리 적응을 시킴으로써 수학 추론 능력이 향상된다고 한다.
추가 pretrain을 한 이유는 아마 generator의 답안이 너무 터무니없으면 reward을 잘못 학습할 수 있기 때문이다.
Generator
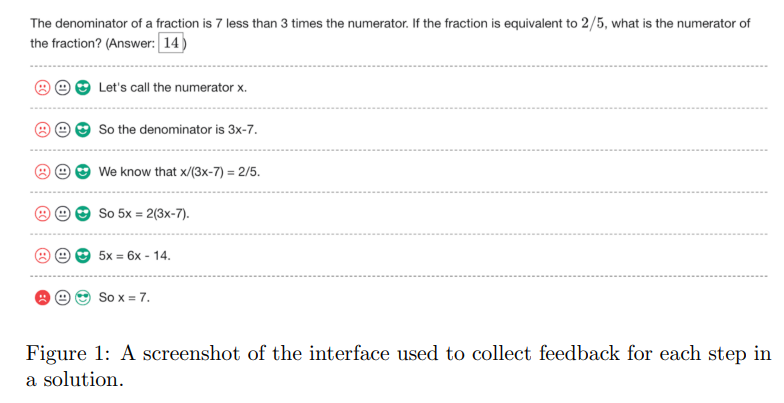
Generator의 출력 형식을 원하는 형식 (각 추론 step을 한 줄로 표현하는 형식)으로 만들기 위해 MATH 학습 데이터에 대해 solution을 생성하도록 하고 이 solution들 중에서 최종 답이 맞은 애들로만 finetuning 시켰다.
Data Collection
Process Supervision에 사용할 data를 만들기 위해서 large scale generator사 생성한 MATH 문제에 대한 step by step 답안들을 human data labeler들에게 제공하였다. Human labeler들은 각 step에 positive / negative / neutral label을 매겼다. Positive은 답이 맞거나 과정이 정당한 step에, negative는 답이 틀리거나 과정이 비합리적인 step에, neutral은 말이 되지만 최적의 step이 아니거나 의미가 없는 step에 부여한다. (문제 재진술, ~을 계산해보겠다, 형식적인 문장이 주된 neutral data이다.)
이때, 모든 solution들을 human labeler들에게 제공한 것이 아니다. Human feedback data는 비용이 비싸기 때문에 human feedback으로부터 최대한의 정보를 얻을 수 있는 solution들만 human feedback을 받아 process supervision dataset을 구성하였다.
뻔한 오류를 가진 답안을 평가하도록 하면, 정밀한 human feedback가 굳이 필요가 없다. Human feedback으로부터 정보를 효율적으로 얻기 위해서는 과정은 맞은 것 같으면서도 오답인 답안으로 학습 데이터의 대부분을 구성해야 한다고 생각하였다. 본 논문은 이런 답안을 convincing wrong answer solutions이라고 부른다. Convincing wrong answer solution을 고르는 방법은 현재 최고의 Process reward model으로부터 높은 점수를 받은 답안들 중 답이 틀린 답안들을 고르는 알고리즘을 사용하였다. 이 dataset은 PRM800K라고 부른다. 이렇게 challenging한 data들만 선별하여 사용하는 방법은 active learning이라고 부른다.
또, 더 발전된 reward model가 순위를 매긴 답안들 중 convincing wrong answer solutions에서는 더 많은 정보를 얻을 수 있을 것(더 매력적인 오답인 답안을 얻을 수 있을 것)이라고 생각해서 학습 iteration마다 Process reward model을 retrain하는 방법도 실험하였다. 즉, 더 교묘한 답안들로 학습을 하면 더 좋은 reward model을 만들 수 있지 않을까라는 가설을 세웠다. 각 iteration마다 generator가 각 문제 별로 N개의 답안을 생성했을 때, top K 필터링을 적용하여 convincing wrong answers들만 human labeler들에게 평가받아 계속 학습시키는 방법을 고안하였다. 하지만 이때, 실제로 human feedback을 받는 것은 비용이 높기 때문에 Small scale model으로 실험을 할 때, human labeler을 large size reward model로 대체하는 방법을 사용했다.
Outcome Supervised Reward Models (ORMs)
Outcome Supervised 방법으로 Reward model을 학습하는 방법은 이전 연구를 따른다. Generator가 문제 별로 고정된 개수의 답안을 생성하도록 하여 학습 데이터를 구성하였다. 이때, 최종 답이 옳은 답안이라면, 전체 과정이 옳다고 label된 data (False positive)까지 포함된 dataset을 사용한다.
ORM을 답안의 각 token이 correct / incorrect 한지 classify하도록 학습하였다. 이때, 답안의 과정이 틀리더라도 답이 옳다면 그 답안의 모든 token의 정답 label은 correct가 되도록 하였다. 이런 dataset을 통해 과정을 고려하지 않는 ORM의 성격을 반영하였다.
ORM의 학습 과정에 사용되는 loss function은 다음처럼 표현할 수 있다.
\[\mathcal{L}_{\text{ORM}} = - \frac{1}{T} \sum_{i=1}^{T} \Big[ y \cdot \log(p_i(\theta)) + (1 - y) \cdot \log(1 - p_i(\theta)) \Big]\]이때, $p_i(\theta)$는 i번째 token이 positive token이라고 예측할 확률이다.
Test time에서 ORM의 prediction은 마지막 token에 대한 label 확률을 답안에 대한 최종 score으로 정의한다.
Process Supervised Reward Models (PRMs)
Process Supervised 방법으로 Reward model을 학습하는 방법은 각 풀이 step의 correctness label (positive, negative, neutral)을 맞추는 log likelihood를 최대화하는 방법을 사용한다.
PRM 학습 과정에 사용되는 loss function을 다음처럼 표현할 수 있다. 일반적인 language modeling이랑 동일한 양상을 따른다.
\[\mathcal {L_{\text{PRM}}} = - \sum_{i=1}^{T} \log p_{\theta}(y \mid x, t_{1:i})\]Test time에서 step level 예측값을 얻기 위해서는 전체 답안에 한번의 forward pass면 충분하다. 다음은 PRM이 평가한 solution의 예시이다.
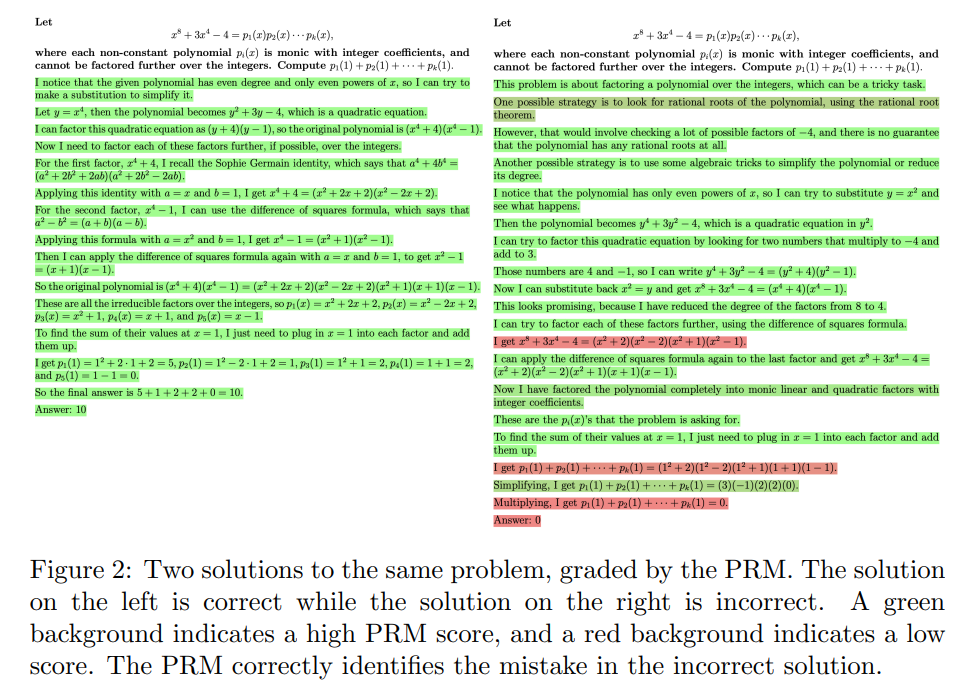
Reward model이 임의의 step에 대해서 평가를 할 때, positive, neutral, negative에 속할 확률을 각각 계산한다. 이때, 계산을 편리하게 하기 위해 neutral label이라고 예측한 확률값은 positive label이라고 예측한 확률값에 더할 것인지 negative label이라고 예측한 확률값에 더할 것인지를 정의해야 한다.
또, Reward model의 성능을 평가하기 위해서 Best-of-N을 수행하기 위해서는 (= 답안들이 받은 점수를 비교하기 위해서는) 답안 전체의 점수를 어떻게 계산할 것인지를 정의해야 한다. Appendix F에 이에 대한 논의가 있다. 본 논문은 한 답안의 점수를 답안의 각 step이 positive일 확률들의 곱으로 정의할 지, 전체 step의 확률 중 제일 작은 확률로 정의할 지 실험하였다. 또, neutral을 positive으로 여기는 것이 좋을지, negative으로 여기는 것이 좋을 지도 실험하였다.
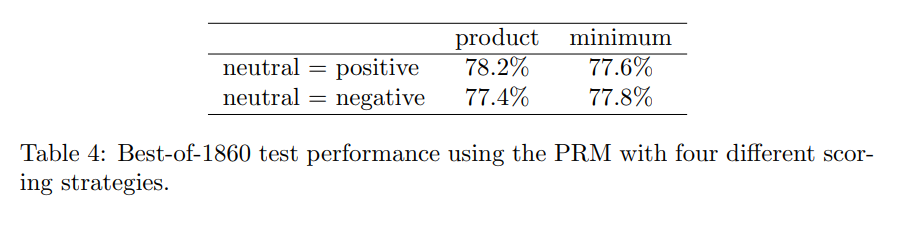
실험 결과, 전체 solution의 점수를 각 step이 부여받은 곱으로 하는 것이 더 좋으며 neutral을 positive으로 여기는 것이 더 성능이 좋게 나온다고 한다.
$\rightarrow$ 각 step의 곱으로 전체 답안의 점수로 정의한다면, 우선 reward model은 짧은 답안 (hallucination이 적은 답안)을 선호하게 되는 bias를 가지게 된다. 또, reward model은 실수를 할 수 있기 때문에 minimum으로 전체 답안의 점수를 결정한다는 것은 합리적이지 않을 수 있다. 반면, 확률들의 곱으로 표현할 경우에는 조건부 확률의 연쇄로 볼 수 있기 때문에 전체 답안이 옳을 확률을 계산하는데에 더 적합하다.
$\rightarrow$ neutral을 negative으로 보면 너무 엄격한 기준을 적용한다고 볼 수 있다. 또, 어떻게 보면 neutral은 풀이 과정을 자연스럽게 연결해주는 과정일수도 있는데 이를 틀렸다고 판단하도록 한다면, 채점 기준이 모호해질 수 있다.
Outcome Supervision과 Process Supervision의 정확한 비교를 위한 고려 사항
step별로 label을 설정할 때, 틀린 step이 처음으로 발견될 때까지만 label을 부여한다. 이 방법으로 outcome supervision과 process supervision이 reward model에게 주는 정보를 조절하여 정확한 비교를 할 수 있게 된다. 자세하게 설명하면, 옳은 답안에 대해서는 두 방법 모두 과정과 답이 다 옳다는 정보를 모델에게 제공한다. 틀린 답안에 대해서는 두 방법 모두 최소 한 개의 잘못된 점이 답안에 존재한다는 정보를 제공한다. 이때, 추가로 process supervision은 잘못된 점의 위치까지 간접적으로 제공하기 때문에 process supervision이 갖는 장점을 부각한 비교를 할 수 있게 된다.
이 방법을 사용한 이유는 또 사람이 풀이가 틀렸는지 맞았는지 판단하는 방법과 유사하기 때문이다. 어떤 풀이의 correctness를 판단하는 것은 풀이에서 제일 빨리 등장하는 틀린 점을 찾는 것과 같기 때문이다.
Large Scale Supervision
Large-scale PRM은 PRM800k의 step level label들로 학습을 한다. Large-scale ORM의 baseline을 최대한 성능이 좋게 하기 위해 generator가 문제 별로 생성한 100개의 답안으로 ORM을 학습시켰다. 즉, ORM의 학습 dataset은 PRM과 겹치지 않고 크기 또한 더 크다.
Large-scale에서 PRM과 ORM의 성능 (Best of N performance, 최선의 답안을 찾아내기)를 비교한 결과는 다음과 같다. 이때, majority voting (제일 많이 나온 답안이 최선의 답) 방법도 baseline으로 추가하였다. 이때, 두 방법 모두 최선의 답안을 구했을 때, 이 답안이 정답 답안과 맞는지를 확인할 때는 최종 답만 비교한다.
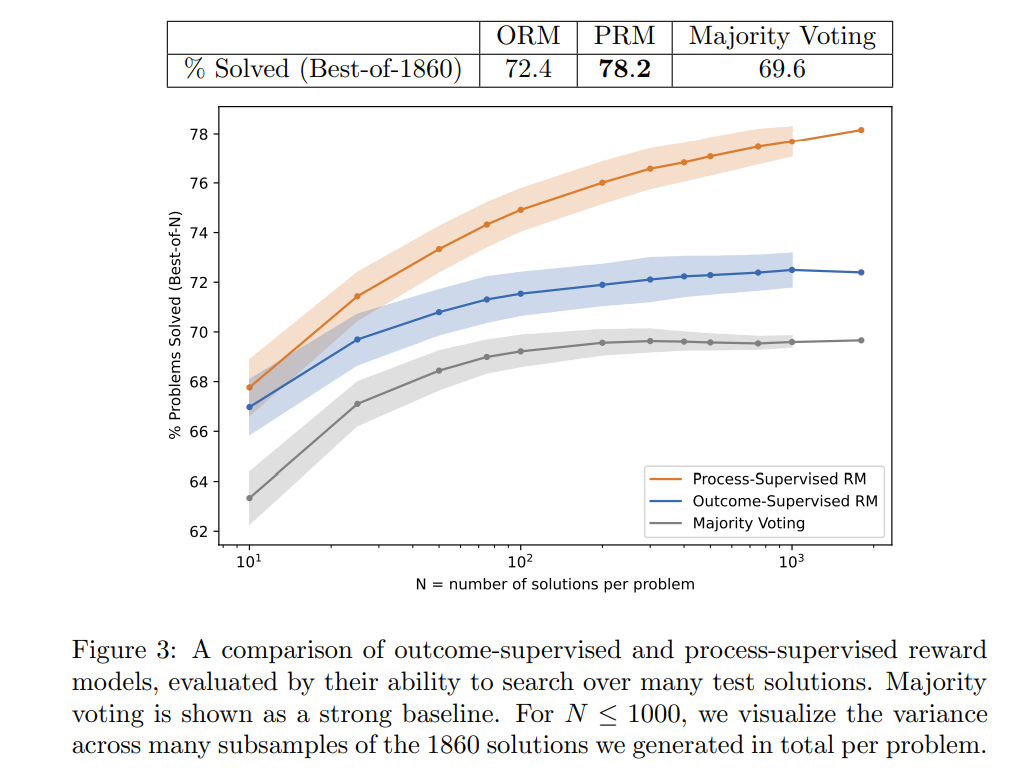
PRM은 두 baseline보다 성능이 좋다. 그리고 답안 후보의 개수(N)가 커질수록 PRM의 성능이 좋아진다는 것을 볼 수 있다. 이 결과를 통해 PRM은 후보가 많더라도 최고의 답안을 가려낼 수 있음을 알 수 있다.
Small Scale Supervision
Small Scale에서 더 다양한 setting을 실험하여 Process supervision의 우수성을 탐구한다.
Process vs Outcome Supervision
본 논문은 사실 Large scale에서의 비교는 타당하지 않을 수 있다고 한다.
- PRM의 dataset 분포는 active learning을 위해 설계되어 있고 크기가 ORM의 학습 dataset보다 작음 $\rightarrow$ PRM 학습 과정이 더 열악함
- ORM은 False positive이 들어있는 답안도 정답 답안이라고 생각하면서 학습하기 때문에 불리함 $\rightarrow$ ORM의 실제 성능보다 낮게 나올 수 있음
타당한 비교를 수행하기 위해서 더 작은 모델에서 더 세밀한 실험 설정을 하였다. Small scale에서는 세 가지의 supervision 방법을 비교한다:
- process supervision from $\text{PRM}_{\text{large}}$
- outcome supervision from $\text{PRM}_{\text{large}}$
- outcome supervision from final-answer checking
(1)의 문제 해결 Small scale에서는 동일한 크기의 답안들로 이루어진 dataset로 학습하도록 하고 오직 supervision의 방법만 달라지도록 하였다. Generator가 문제 별로 1~200개의 답안을 생성하도록 하고 이 답안으로 학습 dataset을 구성하였다. 이때, Process supervision을 하기 위해서 human labeler가 필요하지만 너무 cost가 높기 때문에 human labeler를 large scale process reward model $PRM_{\text{large}}$으로 대체한다. 각 step의 정답 label을 $PRM_{\text{large}}$을 통해 정했다고 보면 된다. 이 방법을 통해 동일한 크기와 내용의 dataset을 얻을 수 있게 되었다. 이 supervision을 process supervision from $PRM_{\text{large}}$이라고 부르기로 하였다.
(2)의 문제 해결 Outcome supervision에서 False positive data를 없애기 위해 답이 맞아도 과정이 틀린 데이터는 Negative으로 label을 바꿔야 한다. 이 과정을 $PRM$을 통해 한다. $PRM_{\text{large}}$가 어떤 답안에 대해 주는 점수가 낮다면 (negative로 인식한다면), 답이 맞더라도 그 데이터의 label을 negative으로 바꾸었다. 이렇게 False positive을 없앤 dataset으로 한 outcome supervision을 outcome supervision from $PRM_{\text{large}}$이라고 부르기로 하였다.
outcome supervision from final-answer checking은 기존과 동일하게 답만 맞으면 data에 positive label을 주어 진행되는 supervision이다.
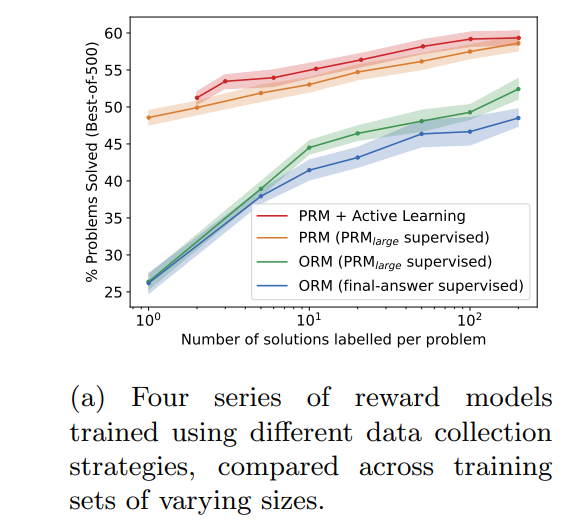
이 실험 결과는 각 supervision 방법으로 학습한 reward model의 best of 500 selection 성능 평가 결과이다. Process supervision이 두 방법보다 우수하고, false positive을 제거한 outcome supervision from $\text{PRM}_{\text{large}}$은 기존의 outcome supervision 방법보다 성능이 좋게 나왔다.
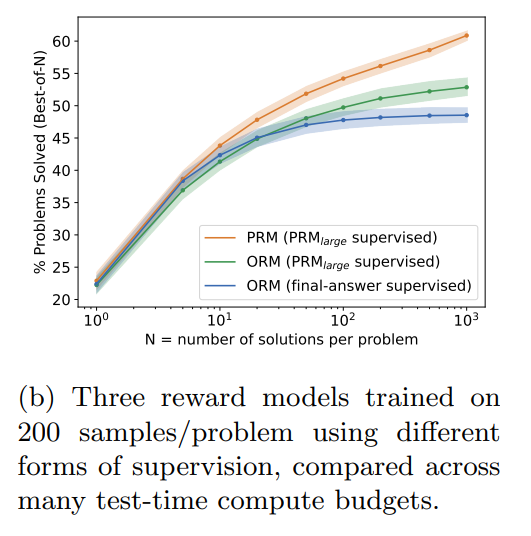
세 reward model의 best-of-N 성능을 N의 크기에 따라 평가한 결과이다. N이 커질수록, $\text{PRM}{\text{large}}$을 적용한 방법의 성능 향상이 커진다는 것을 관찰할 수 있다. 이를 통해 $\text{PRM}{\text{large}}$은 false positive 학습을 방지해주는 역할을 해줘 reward model의 학습 능력을 향상시킨다는 것을 엿볼 수 있다.
Active Learning
Active Learning의 효과를 탐구하기 위해 active learning을 극대화한 학습 dataset을 따로 만들어 학습시킨 process supervision reward model의 성능을 평가한다. small scale reward model $\text{PRM}_{\text{selector}}$으로 문제 별 1000개의 답안 중에서 active learning의 학습 데이터를 구성할 답안 N개를 선택하도록 하였다. N개 중에서 80%는 convincing wrong answers 중에서 점수가 제일 높은 것, 나머지 20%는 답의 맞고 틀리고를 신경쓰지 않고 점수를 제일 높게 받은 답안들로 구성하였다.
$\text{PRM}{\text{selector}}$가 선택한 답안들을 $\text{PRM}{\text{large}}$로 평가하여 label을 부여하였다. 이 과정을 통해 만들어진 dataset은 대부분 (80%) convincing wrong answers을 갖고 있는 답안들로 구성되어 있으면서 틀린 답들에만 분포가 집중되지 않은, 어떻게 보면 정당한 active learning dataset이 된다. 이 dataset으로 학습한 모델의 성능은 다음과 같다.
Active learning을 사용하지 않는 PRM ($\text{PRM}_{\text{large}}$ supervised)과 Active learning을 극대화한 PRM + Active learning의 데이터 크기에 따른 성능 증가율을 비교하면 Active learning을 적용한 PRM + Active learning이 대략적으로 2.6배 더 효율적인 것을 관찰할 수 있다.
이때, active learning dataset을 만들 때, 각 문제 당 너무 많은 답안들을 선택하면 (N을 너무 키우면) 예상한 만큼의 성능이 나오지 않는다. 이 이유는 한 문제 당 나올 수 있는 매력적인 오답의 가짓수는 정해져 있는데 N을 너무 크게 하면 그 중 일부는 매력적인 오답이 아니게 될 수 있기 때문이라고 설명한다.
추가로, $\text{PRM}_{\text{selector}}$을 iterative하게 retrain을 함으로써 더 매력적인 오답 data를 얻어내어 더 세밀하게 정보를 학습할 수 있도록 하는 방법( 선별 기준을 upgrade )을 실험해보았지만 학습이 불안정해지고 성능이 달라지지 않았다. 개인적인 의견으로는 iterative하게 retrain을 하면서 계속 학습 데이터 분포가 달라져서 학습이 불안정해졌다고 생각한다.
Out of Distribution Generalization
ORM과 PRM이 보지 못한 문제들에 대해서 성능이 좋게 나오는지 실험해보았다. 학습 데이터와 간접적으로 관련이 있는 STEM 문제 (AP 물리, AP 화학, 고등학교 수학 문제 AMC10, AMC12)에 대해서 ORM과 PRM이 올바른 답안을 골라낼 수 있는지 평가하였다.
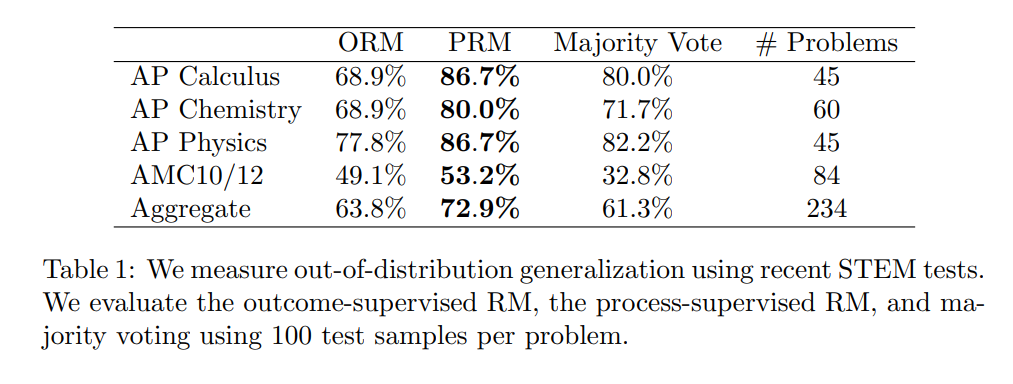
이 실험 결과를 통해 PRM은 보지 못한 문제들 (큰 distribution shift)에서도 성능이 유지된다는 것을 관찰할 수 있다.
Discussion
어디서 틀렸는지를 학습하는 것의 중요성
Outcome supervision은 최종 답안만을 고려하여 정답 label을 만들기 때문에 생기는 문제점이 있다. Generalization이 좋기 위해서는 풀이 과정 중 어디서 오류가 생기는지 파악해야 하는데 Outcome supervision은 이것을 학습하지 못한다. 따라서 outcome supervision은 negative label을 부여하더라도 어디서 틀린 지를 표시해주지 못하기 때문에 negative 데이터로부터 얻을 수 있는 정보가 process supervision과 비교하였을 때 매우 제한적이다.
반면 Process supervision은 몇 개의 step이 옳았는지, 그리고 어디서 틀렸는지에 대한 정보를 얻을 수 있기 때문에 negative label 데이터의 가치가 매우 높다.
Alignment에서의 영향력
Process supervision은 reward model이 인간이 생각하는 방식 (올바른 추론 과정)을 따르도록 하기 때문에 alignment의 정도를 향상시킨다. 또, 사고 방식 자체에 reward을 부여하기 때문에 AI가 올바른 사고방식을 갖도록 할 수 있다.
보통 alignment을 향상시키는 방법은 모델 자체의 성능 (NLP task에 대한 성능)을 저하시키는 경향이 있다. 이런 경우에 Alignment tax를 지불한다는 표현을 사용한다. 하지만 process supervision을 alignment tax를 지불하지 않는다는 것이 특징이다. Process supervision은 AI가 올바른 사고 과정을 갖도록 하면서도 성능 (best of N)이 향상된다. 하지만 고려해야 하는 것은 이 성능 향상이 MATH domain에서만 발생하는 것일 수도 있기 때문에 추가 실험이 필요하다…
Test Set Contamination
MATH의 Test set 문제들은 유명한 수학 경시대회 문제들이기 대문에 온라인 토론 커뮤니티에서 언급되었을 가능성이 높다. GPT-4는 레딧과 같은 커뮤니티 글로 pretrain을 하기 때문에 이 과정에서 Test set을 이미 학습했을 가능성이 존재한다. 이를 반증하기 위해서 generator가 MATH test set 문제들이나 Out of distribution을 실험했을 때 사용한 문제들을 드럽게 못 푼다는 것을 증거로 제시한다. Generator가 거의 한 자릿수의 정답률을 가진 문제들이 많다는 것을 통해 pretraining 과정에서 MATH의 test set을 경험하지 않았다는 것을 보여준다.
Process supervision 방법이 우수하다는 것을 직관적으로 알 순 있다. 하지만 이 논문에서 자세한 실험 설정들을 통해 Process supervision의 방법의 우수함을 증명하는 과정이 재미있었다.