SimPO Simple Preference Optimization with a Reference-Free Reward 리뷰
Background
LLM을 사람의 의도와 align하기 위해서는 human feedback을 학습하는 것이 매우 중요하다. RLHF는 human feedback을 사용하는 성능이 뛰어난 강화학습 방법이다. 하지만 reward model을 학습하고, 그 reward을 최대화하는 최적화된 policy model을 만들어야 하기 때문에 복잡하다.
간단한 알고리즘으로는 DPO가 있다. Reward function을 reparameterize하여 optimal policy를 바로 도출하는 방법을 사용하여 reward model을 따로 학습하는 과정을 없앴다. DPO를 자세하게 설명하면, DPO는 RLHF의 reward function을 $r(x,y) = \beta \log \frac {\pi_{\theta} (y \mid x)} {\pi_{\text{ref}}(y \mid x)} + \beta \log Z(x)$으로 reparameterize하여 optimal policy를 직접적으로 구하였다. 이 reward function을 Bradley Terry Model의 ranking objective: $y_w$을 $y_l$보다 선호할 확률 $p(y_w > y_l \mid x) = \sigma(r(x,y_w) - r(x,y_l))$에 대입하여 negative log likelihood을 통해 DPO의 objective을 도출하였다.
\[-\log (p(y_w > y_l \mid x)) = \mathcal{L_{\text{DPO}}} (\pi_{\theta} ; \pi_{\text{ref}}) = -\mathbb{E_{(x,y_w,y_l) \sim \text{D}}} \left [ \log \sigma (\beta \log \frac {\pi_{\theta}(y_w \mid x)} {\pi_{\text{ref}}(y_w \mid x)} - \beta \log \frac {\pi_{\theta}(y_l \mid x)} {\pi_{\text{ref}}(y_l \mid x)}) \right ]\]DPO는 모델이 선호하는 답안을 비선호하는 답안보다 더 선호하게 만들어서 human의 preference을 학습하도록 하였다.
Simple Preference Optimization: SimPO
여기서 본 논문은 DPO의 문제를 파악하여 더 정확하고 간단한 alignment 방법 SimPO를 소개한다.
DPO와 SimPO의 차이점과 실험 결과를 간략하게 보여주는 결과이다.
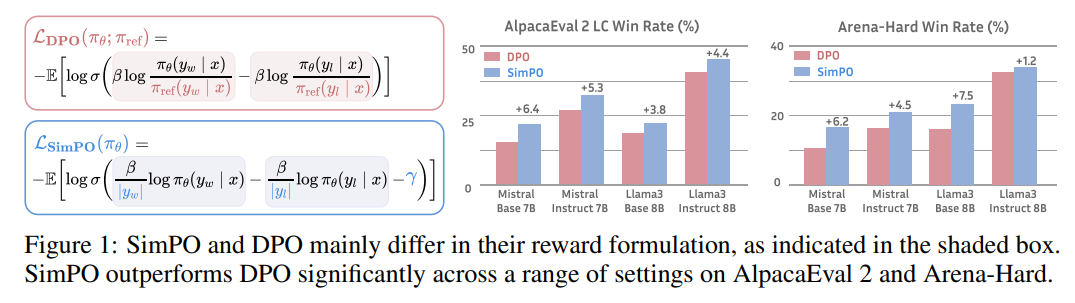
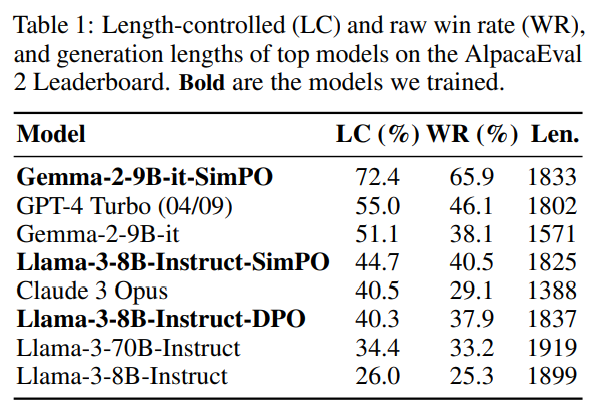
Discrepancy between reward and generation for DPO
DPO에서 정의한 implicit reward function에서
\[r(x,y) = \beta \log \frac {\pi_{\theta} (y \mid x)} {\pi_{\text{ref}}(y \mid x)} + \beta \log Z(x)\]본 논문은 DPO는 $\pi_{\text{ref}}$을 필요로 하여 추가적인 메모리와 연산량을 요구하기 때문에 비효율적이라고 주장한다.
또, DPO의 학습 과정은 desirable 답변의 생성을 guide하는 과정과 엇나간다고 주장한다. DPO는 Bradley Terry의 ranking objective에 최적화되도록 학습되기 때문에 $r(x,y_w) > r(x,y_l)$을 만족하도록 학습이 된다. DPO의 reward 정의 방법을 보면 현재 policy가 reference policy보다 상대적으로 얼만큼 잘하는 지에 따라 달라진다. 이 방법의 문제점은 reference policy가 $y_w$을 생성활 확률이 낮다면, optimal policy가 $y_w$을 생성할 확률이 조금만 높아도 reward가 높게 측정된다는 것이다. Optimal policy는 정의된 reward에 최적화되어 도출되는 것이기 때문에 학습 과정에서 reference model에 대한 상대적 우위을 만족하는데에 학습을 집중한다. 따라서, $y_w$에 부여하는 reward가 높다고 해서 $\pi_{\theta}(y \mid x)$가 $y_w$을 생성할 확률이 무조건 높다고 볼 수가 없다.
하지만 추론을 할 때는 reference model을 사용하지 않고 최적의 답안을 생성하는 log likelihood $p(y_i \mid x, y_{<i})$을 최대화하는 방향을 따른다. 따라서, 학습 과정과 추론 과정 간에 괴리 (discrepancy)가 생긴다. 다르게 말하면 DPO의 학습 과정은 reference 모델에 대한 상대적 우위에 집중하지만, 추론 과정에서는 reference model을 사용하지도 않으면서 desirable 답안을 생성할 절대적인 확률 $p_{\theta}(y_w \mid x)$을 최대화하려고 하는 과정이기 때문에 괴리가 생긴다는 것이다.
결국 DPO로는 $y_w$을 $y_l$보다 더 선호하도록 학습하여도 $y_w$을 생성할 확률이 $y_l$을 생성할 확률보다 높은 것을 보장하지 못하는 모델이 만들어진다는 것이라고 주장한다.
Length-normalized reward formulation
이 discrepancy 문제를 해결하는 방법은 reward을 ranking / 상대적 우위 기반이 아니라 절대적인 $y_w$의 생성 확률을 기반으로 정의하는 것이다. 이때, $y_w$을 생성할 확률을 어떻게 정의할 것인지가 중요하다. Naive하게 생각하면 $y_w$의 생성 확률을 $y_w$을 구성하는 각 token들의 생성 확률의 곱(log likelihood의 합)으로 정의할 수 있다. 하지만 이렇게 reward을 구성하여 학습한다면, 답안의 길이가 길어질수록 $y_w$의 전체 생성 확률은 작아지므로 짧은 답안을 선호하게 되는 bias가 생기게 된다. 또, $y_w$가 $y_l$보다 길 때 $y_w$의 생성 확률을 $y_l$보다 높이기 위해서는 $y_w$의 token들의 생성 확률을 억지로 키우도록 학습될 수 있다. 이 과정에서 성능 저하가 발생한다.
따라서 본 논문은 average log likelihood을 $y_w$의 생성 확률으로 정의한다.
\[p_{\theta}(y \mid x) = \frac {1} {\mid y \mid} \log \pi_{\theta} (y \mid x) = \frac {1} {\mid y \mid} \sum_{i=1}^{\mid y \mid} \log \pi_{\theta}(y_i \mid x, y_{<i})\]이를 기반으로 length-normalized reward을 정의한다.
\[r_{\text{SimPO}}(x,y) = \frac {\beta} {\mid y \mid} \log \pi_{\theta}(y \mid x) = \frac {\beta} {\mid y \mid} \sum_{i=1}^{\mid y \mid} \log \pi_{\theta}(y \mid x, y_{< i})\]모델은 생성을 할 때, 여러 후보 문장들을 만들어보면서 어떤 문장이 가장 말이 되는지 점수를 매겨 제일 높은 점수를 받은 문장을 최종 output으로 선택하는 beam search와 같은 알고리즘을 사용한다. 이때, 본 논문이 정의한 reward (metric)은 beam search에서 답안을 평가할 때 사용하는 기준과 동일하다.
reward는 결국 문장의 평가 결과라고 해석되기 때문에 논문에서 metric이라고 표현한다.
즉, 본 논문이 의도한 바는 생성할 때 최적의 output을 고르는 기준을 학습할 때도 적용하여 optimal policy가 이 기준에 최적화되도록 하면 discrepancy 문제를 완벽히 해결할 수 있다는 것이다.
$\rightarrow$ Reward formulation that aligns with the likelihood metric that guides generation
SimPO의 reward가 갖는 장점을 정리하면
- Reference model을 필요로 하지 않음
- 길이에 대한 bias가 없음
- 학습 과정과 추론 과정 간의 discrepancy가 존재하지 않음
The SimPO objective
SimPO에서도 Bradley Terry Model의 ranking objective을 사용한다. SimPO의 reward 정의 방법을 바탕으로 한 objective는 $y_w$의 절대적인 생성 확률과 $y_l$의 절대적인 생성 확률의 차이를 극대화하도록 학습을 하는 것이다. 이때, SimPO는 Target reward margin $\gamma$을 도입하여 $y_w$을 생성할 확률 ($y_w$에 부여되는 reward)가 $y_l$을 생성할 확률($y_l$에 부여되는 reward)보다 최소 $\gamma$보다 크도록 보장하고자 하였다.
\[p(y_w > y_l \mid x) = \sigma(r(x,y_w) - r(x,y_l) - \gamma)\]SimPO의 최종 objective는 다음과 같다.
\[\mathcal{L_{\text{SimPO}}}(\pi_{\theta}) = - \mathbb{E_{(x,y_w, y_l) \sim \text{D}}} \left [ \log \sigma ( \frac {\beta} {\mid y_w \mid} \log \pi_{\theta}(y_w \mid x) - \frac {\beta} {\mid y_l \mid} \log \pi_{\theta}(y_l \mid x) - \gamma) \right ]\]SimPO를 요약하면 다음과 같다. SimPO는 generation 평가 기준과 적합한 reward을 정의하여 reference model에 대한 의존성을 제거하고 학습 과정과 추론 과정 간의 discrepancy 문제를 해결하였다. 또, target reward margin $\gamma$를 도입하여 desirable output과 undesirable output 간의 구분을 도왔다.
Experimental Setup
Models and Training settings
SimPO와 다른 preference optimization 방법들의 성능을 비교하기 위해 두 모델 family Llama 3-8B, Mistral 7B를 사용한다. 이때, Base 모델과 Instruct 기반 모델을 따로 비교한다.
Base
Base model은 UltraChat-200k dataset을 바탕으로 학습하여 SFT model을 얻는다. 이 SFT model을 바탕으로 UltraFeedback dataset으로 다양한 preference optimization을 적용하여 성능을 비교한다.
Instruct
Instruct model은 이미 Instruction tuned된 모델이다. 이 모델들은 성능은 좋지만 어떤 RLHF 과정을 거쳤는지 모르기 때문에 이 모델들이 가지고 있는 distribution이 불투명하다. 이런 모델들을 base setup처럼 UltraFeedback dataset으로 바로 preference optimization을 적용하려고 하면 모델이 기존에 말하던 방식과 dataset으로 학습시키고자 하는 말하는 방식과 너무 차이가 나서 (big distribution shift가 발생해서) 학습이 잘 안 될 수 있다. 따라서 on-policy와 유사한 방법을 사용한다. UltraFeedback의 prompt만 가져와서 각 모델이 각 prompt에 대한 답변을 5개씩 생성하도록 한다. 그 다음 PairRM이라는 평가 모델을 통해 제일 높은 reward 값을 갖는 답변을 $y_w$, 가장 낮은 reward 값을 갖는 답변을 $y_l$으로 하여 chosen & rejected response pair ($y_w$, $y_l$)을 만든다. 이렇게 만든 dataset으로 preference optimization을 적용한다.
Evaluation Benchmark
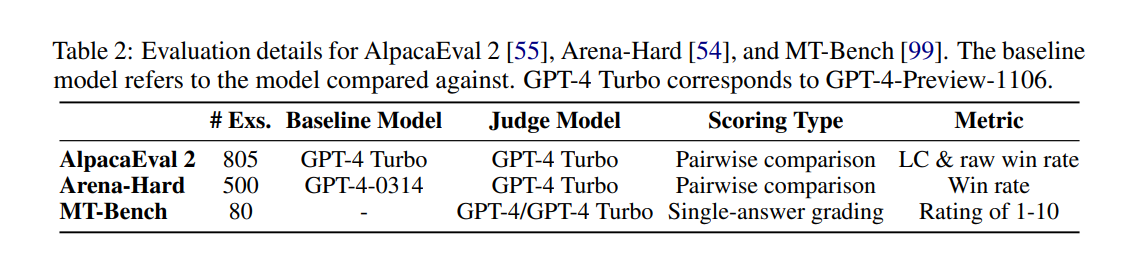
MT-Bench, AlpacaEval, Arena-Hard을 사용한다. 이 benchmark들은 model의 다양한 상황에서의 대화 능력을 평가한다.
Baselines
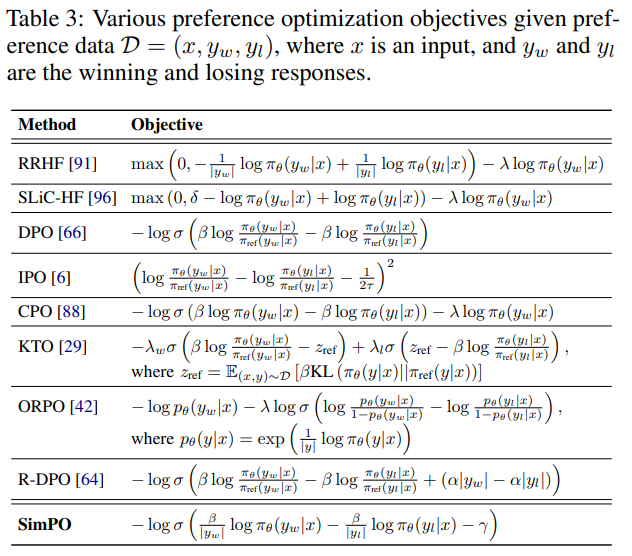
비교 대상들은 다음과 같다.
Experimental Results
Main results and Ablations
SimPO는 다른 preference optimization 방법들보다 성능이 좋다
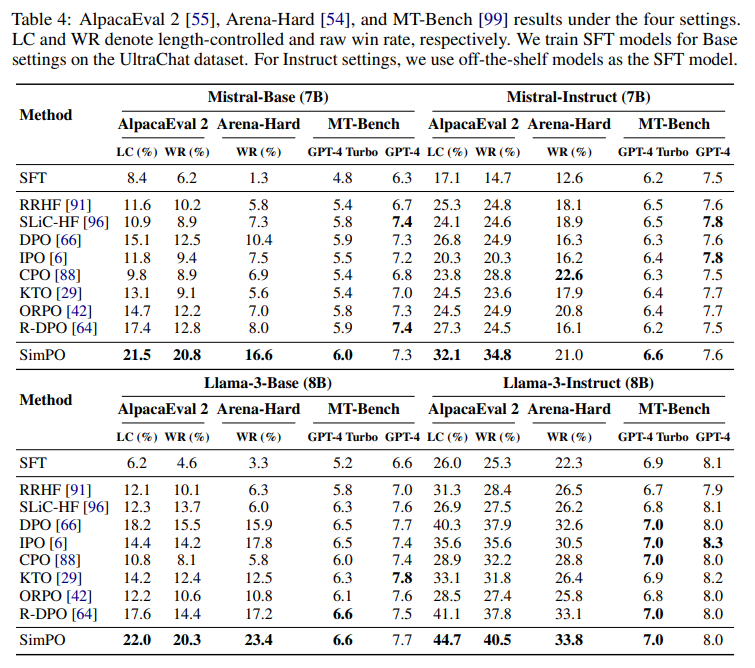
SimPO는 간단하면서도 거의 모든 benchmark에서 일관되게 성능이 좋아서 robust하면서도 effective하다고 볼 수 있다. 이때, CPO 방법이 Arena-Hard benchmark에서 SimPO보다 성능이 좋게 나올 수 있지만, 이 이유는 CPO가 SimPO의 답변보다 평균적으로 50% 더 긴데, Arena-Hard는 모델의 답변에 length penalty를 부여하지 않아 더 긴 generation을 선호하는 경향이 존재하기 때문이다.
Instruct 기반이 Base 기반보다 성능이 좋다
SFT 모델의 성능이 좋을수록, preference pair data의 quality가 좋을수록, preference optimization 효과가 좋다는 것을 보여준다
SimPO의 key design들은 필수이다
SimPO의 length normalization과 target reward margin을 하나씩 제거하여 모델 성능에 얼만큼의 영향을 주는지 관찰하였다.
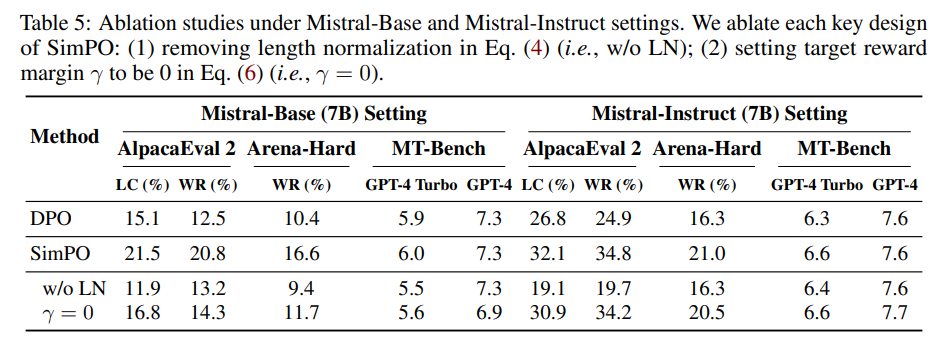
Length normalization을 없앴을 때는 모델의 output은 의미없는 반복을 하여 성능이 매우 저하되었다. Target reward margin을 0으로 설정했을 때도 모델의 성능이 저하되었다. 이를 통해 SimPO의 key design들은 필수라는 것을 알 수 있다.
Depth Understanding
본 논문은 Length Normalization와 Margin term $\gamma$의 중요성, 그리고 왜 SimPO가 DPO를 능가하는지를 설명한다.
Length Normalization (LN)은 Length Exploitation을 방지한다.
Reward model은 긴 답변을 선호하는 bias가 존재한다. 이런 bias를 length exploitation이라고 한다. 이런 현상의 이유로는 dataset 자체에 편향이 존재하기 때문이다. 보통 더 친절한 답변 ($y_w$)는 더 자세하기 때문에 $y_w$보다 길이가 더 길다. 따라서 길이 자체를 desirable 답변의 특징 중 하나라고 학습되는 경향이 존재한다.
Length Normalization이 Length exploitation을 방지하는지 알아내기 위해 두 실험을 수행하였다.
우선 training set의 두 output $y_w$와 $y_l$의 reward와 길이 차이에 대한 관계를 관찰하고자 LN을 적용한 SimPO, LN을 적용하지 않은 SimPO, $\pi_{\text{SFT}}$에서 $y_w$와 $y_l$의 길이 차이에 따른 reward 값 차이를 관찰하였다.
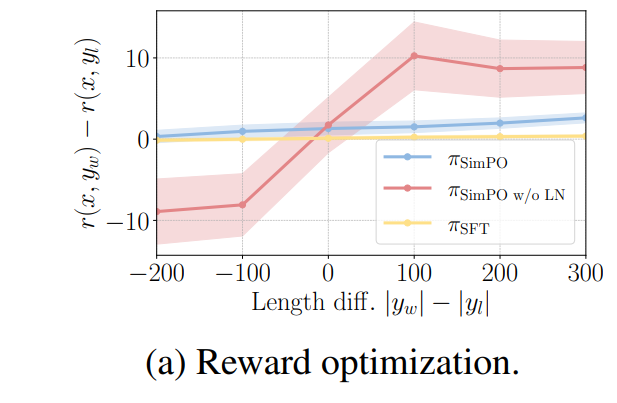
LN을 적용한 SimPO는 길이 차이와 상관없이 desirable output이 받는 reward가 undesirable output이 받는 reward보다 높다. 그리고 $\pi_{\text{SFT}}$보다 reward difference가 크다. 하지만 LN을 적용하지 않는 SimPO을 적용했을 때는 desirable output의 길이가 undesirable output의 길이보다 짧은 경우에는 reward 차이가 음수가 되고 반대 상황에서는 reward 차이가 양수가 되는 length exploitation이 관찰되었다. 이를 통해 LN은 길이와 상관없이 정확한 reward를 계산할 수 있도록 해주며 reward의 차이 또한 다른 방법들보다 키운다는 것을 알 수 있다.
그 다음, 생성하고자 하는 답변의 길이와 average log likelihood 값의 관계를 관찰하였다.
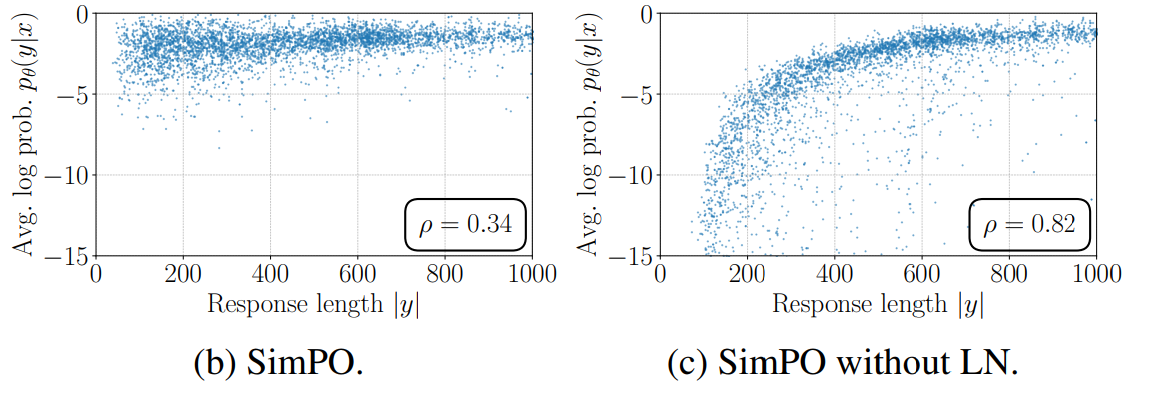
LN을 적용한 SimPO는 답변의 길이와 상관없이 average log likelihood가 일정하다는 것을 통해 사람이 원하는 desirable output을 자연스럽게 생성하고 있다고 볼 수 있다. 하지만 LN을 적용하지 않은 SimPO는 답변의 길이가 긴 답변일 수록 그 답변을 생성할 확률이 올라갔다. 즉, 길이가 긴 답변에게 reward를 많이 주는 length exploitation을 가지고 있다는 것을 보여준다. 따라서, LN은 length exploitation을 방지하는 효과가 있음을 알 수 있다.
Spearman correlation은 두 변수에 통계적 의존성이 존재하는지 알려주는 상수이다. 1에 가까울수록 비례 관계에 있다고 본다. 이때, LN을 사용하지 않은 SimPO의 spearman correlation이 1에 가까운 것을 통해 length exploitation이 존재함을 알 수 있다.
SimPO에서 Target Reward Margin의 영향력
SimPO에서 Target Reward Margin의 영향력을 관찰하기 위해 한 첫 번째 실험은 $\gamma$의 크기에 따라 reward을 정확히 부여하는지 보고 AlpacaEval2에서의 성능을 측정하였다. Reward을 잘 부여하는지에 대해 평가하기 위해서 dataset에서의 $y_w$이 $y_l$보다 더 많은 reward을 받도록 하는지에 대한 accuracy 값을 측정하였다.
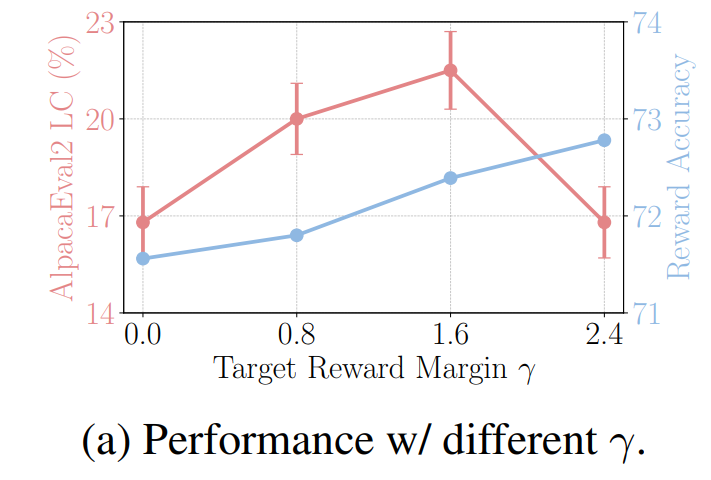
실험 결과, $\gamma$값이 증가함에 따라 reward accuracy 값을 증가하였다. 이를 통해 reward 차이가 더 큰 margin을 갖도록 강제하는 것은 reward accuracy의 증가에 영향을 준다는 것을 알 수 있다. 하지만, AlpacaEval2에서는 $\gamma$ 값이 증가할 때, win rate도 증가하다가 감소하는 현상을 보인다. 이를 통해 generation quiality는 오직 $\gamma$ 값에만 의존하지 않는다는 것을 알 수 있다.
$\gamma$ 값에 따라 $r(x,y_w) - r(x, y_l)$와 $p_{\theta}(y_w \mid x)$의 분포도 시각해보았다.
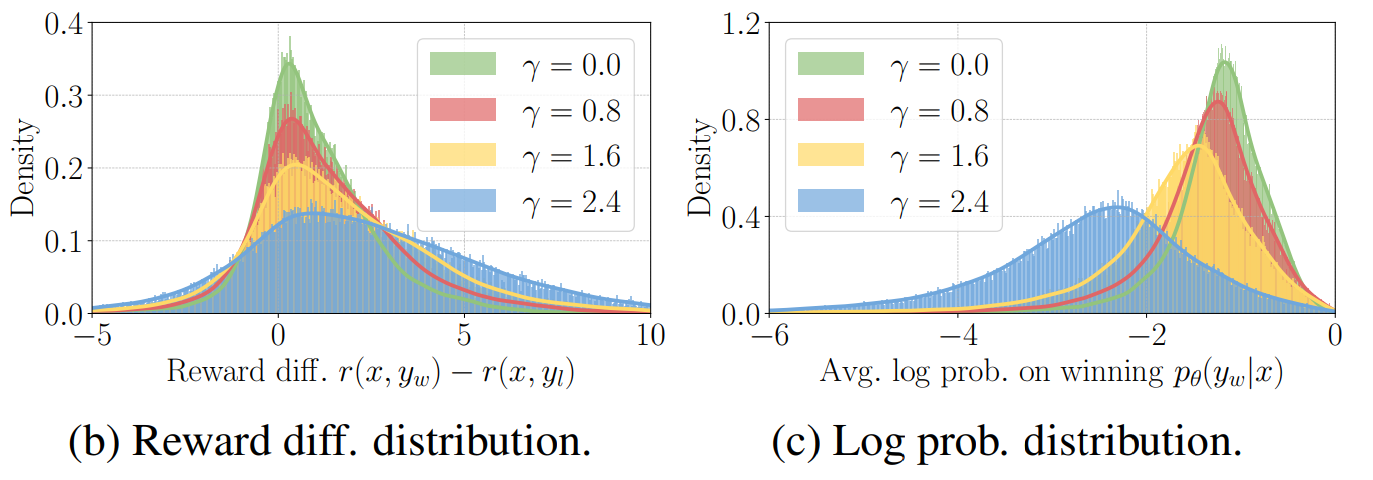
$\gamma$ 값이 커질수록, 두 분포 모두 flatten되는 경향이 존재한다. 그리고 $r(x,y_w) - r(x, y_l)$의 분포는 positive 쪽으로 움직이는 경향이 있는 반면 $p_{\theta}(y_w \mid x)$의 분포가 왼쪽으로 쏠리는 경향이 존재한다.
$r(x,y_w) - r(x, y_l)$의 분포가 flatten되는 현상은 두 답안이 받는 reward을 극단적으로 잘 구분할 수 있게 된다는 것이다. 하지만 $p_{\theta}(y_w \mid x)$의 분포가 flatten된다는 것은 모델이 어떤 prompt x가 주어졌을 때, desirable 답안 $y_w$을 생성할 확신이 줄어들었다는 것을 의미한다. 즉, 모델의 generation quality가 떨어졌다는 것을 의미한다. 심지어 분포가 왼쪽으로 쏠린다는 것을 통해 model의 성능이 떨어졌다는 것을 의미한다. 따라서, reward accuracy를 높이도록 강제하는 것 ($\gamma$ 크기를 키우는 것)은 꼭 model의 성능 향상을 야기하지 않기 때문에 적절한 $\gamma$ 값을 구해야 한다고 주장한다.
DPO vs SimPO
SimPO와 DPO를 두 방법의 gradient, likelihood-length 관련성, reward formulation, reward accuracy, algorithm efficiency에 대해 비교한다.
Gradient Analysis
SimPO와 DPO의 gradient는 다음과 같다.
\[\nabla_{\theta} L_{\text{SimPO}}(\pi_{\theta}) = -\beta \mathbb{E}_{(x, y_w, y_l) \sim D} \left[ s_{\theta} \cdot ( \underbrace{\frac{1} {\mid y_w \mid} \nabla_{\theta} \log \pi_{\theta}(y_w \mid x)}_{\text{increase likelihood on } y_w} - \underbrace{\frac{1}{\mid y_l \mid} \nabla_{\theta} \log \pi_{\theta}(y_l \mid x)}_{\text{decrease likelihood on } y_l} ) \right]\] \[\nabla_{\theta} L_{\text{DPO}}(\pi_{\theta}) = -\beta \mathbb{E}_{(x, y_w, y_l) \sim D} \left[ d_{\theta} \cdot ( \underbrace{\nabla_{\theta} \log \pi_{\theta}(y_w \mid x)}_{\text{increase likelihood on } y_w} - \underbrace{\nabla_{\theta} \log \pi_{\theta}(y_l \mid x)}_{\text{decrease likelihood on } y_l} ) \right]\]이때, $s_{\theta}$와 $d_{\theta}$는 다음과 같다.
\[s_{\theta} = \sigma \left( \frac{\beta}{\mid y_l \mid} \log \pi_{\theta}(y_l \mid x) - \frac{\beta}{\mid y_w \mid} \log \pi_{\theta}(y_w \mid x) + \gamma \right), d_{\theta} = \sigma \left( \beta \log \frac{\pi_{\theta}(y_l \mid x)}{\pi_{\text{ref}}(y_l \mid x)} - \beta \log \frac{\pi_{\theta}(y_w \mid x)}{\pi_{\text{ref}}(y_w \mid x)} \right)\]두 방법의 gradient 차이점은 다음과 같다.
- SimPO의 gradient weight $s_{\theta}$는 reference model을 필요로 하지 않고 policy $y_l$에게 $y_w$보다 더 높은 likelihood을 갖게 될수록 값이 커져 더 큰 update를 한다.
- SimPO의 gradient 값은 length normalized 되어있지만 DPO는 따로 normalize 되어있지 않다. 이런 이유 때문에 DPO의 empirical findings에서 DPO는 length bias를 가지고 있다고 주장한다. Training batch 안에는 다양한 길이의 sequence들이 존재한다. 이때, 상대적으로 더 긴 sequence로 학습을 할 때, gradient의 magnitude가 (음수 쪽으로) 더 커지기 때문에 길이가 긴 sequence의 특성을 더 중점적으로 학습하게 된다는 것이다. 반대로 이런 이유 때문에 SimPO는 length에 대한 bias가 존재하지 않는다.
DPO는 내재적으로 length normalization을 한다.
DPO는 reward를 $r(x,y) = \beta \log \frac {\pi_{\theta} (y \mid x)} {\pi_{\text{ref}}(y \mid x)} + \beta \log Z(x)$으로 정의해서 length normalization을 위한 항이 없지만 optimal policy와 reference policy의 로그 비율으로 최적화하는 것이 간접적으로 length normalization 역할을 하는 것을 실험으로 알 수 있다.
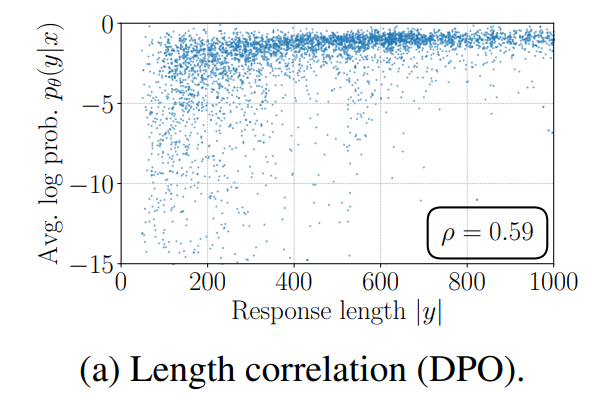
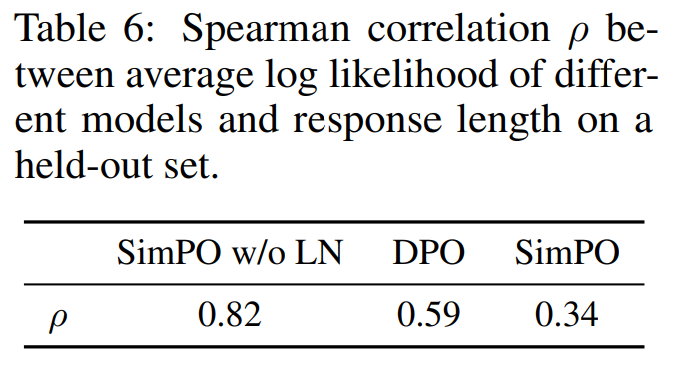
앞선 실험처럼 DPO의 average log likelihood와 답변 길이의 Spearman correlation을 구하면 0.59로 LN을 하지 않은 SimPO보다 훨씬 낮다.
DPO의 reward에 대한 최적화는 generation likelihood에 대해 최적화하는 것과 다르다
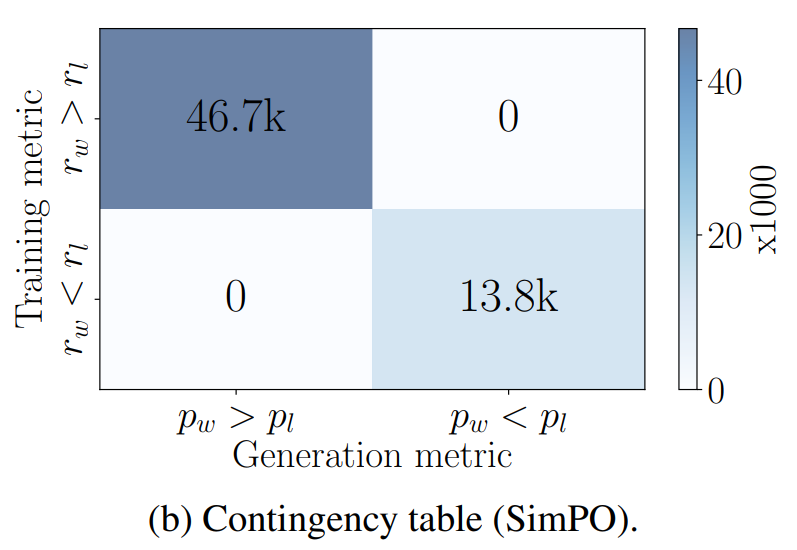
앞서 DPO의 학습 과정 (reward formulation)과 추론 과정 간에 discrepancy가 존재한다고 했다. 본 논문은 이 주장에 대한 근거를 실험으로 증명하였다.
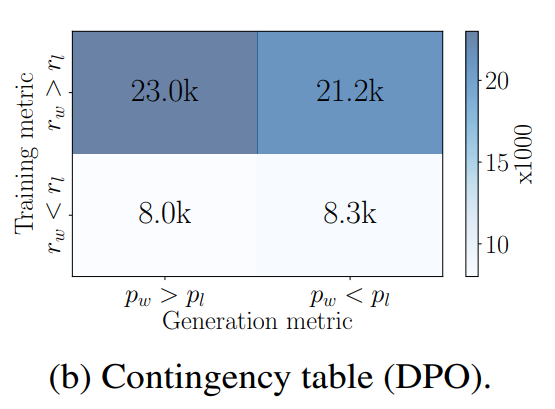
UltraFeedback dataset에서 $r(x,y_w) > r(x,y_l)$을 만족하는 data 중에 50%에서 DPO는 $p_{\theta}(y_w \mid x) < p_{\theta}(y_l \mid x)$, 즉 undesirable output을 생성하는 확률이 더 높았다.
반면에 SimPO는 추론 과정과 align되는 reward formulation을 통해 $r(x,y_w) > r(x,y_l)$을 만족하는 data에서 100%로 $p_{\theta}(y_w \mid x) > p_{\theta}(y_l \mid x)$의 결과를 보여준다.
DPO lags behind SimPO in terms of reward accuracy
SimPO와 DPO의 reward formulation으로 data의 의도된 reward을 잘 맞추는지 평가하였다.
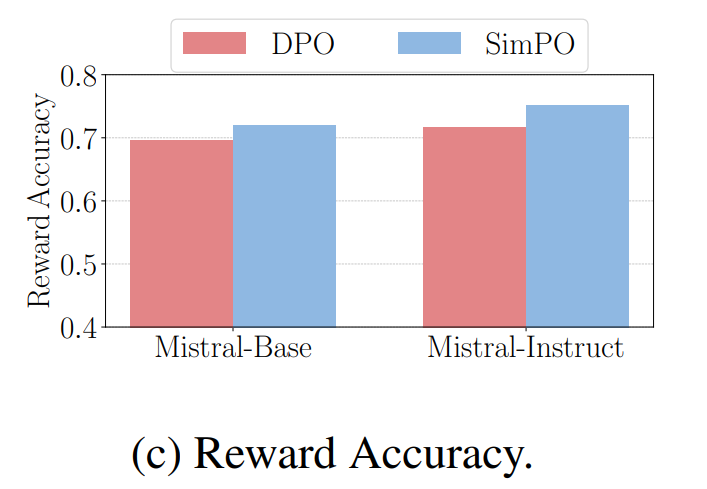
실험 결과, SimPO의 reward accuracy가 항상 높았다. 이를 통해 SimPO의 reward formulation은 generalization 능력이 더 좋으며 더 high quality generation을 유도함을 알 수 있다.
KL divergence of SimPO and DPO
Policy optimization 방법들은 보통 KL divergence 값을 penalty로 사용하여 policy model이 reference model에서 너무 벗어나지 않게 해서 안정적인 학습을 수행한다. 따라서, SimPO와 DPO의 KL divergence 값을 따로 계산하여 두 방법 모두 안정적인 학습을 할 수 있는지 관찰하였다.
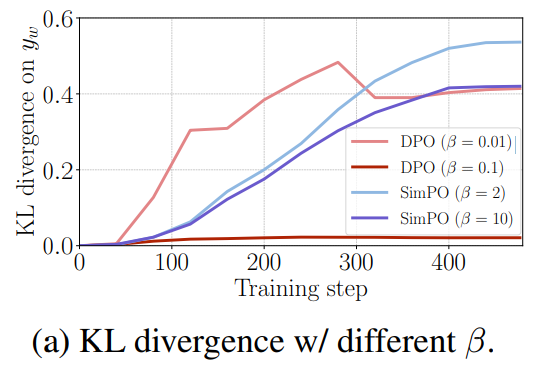
SimPO는 KL divergence penalty나 reference model에 대한 regularization을 하지 않아도 KL divergence가 낮게 유지되는 것을 관찰할 수 있다. 그리고 $\beta$ 값이 클 때, KL divergence 값이 비교적 낮게 유지되는 것을 통해 안정적인 학습을 할 수 있음을 알 수 있다.
$\beta$ 값에 따라 AlpacaEval2 LC win rate 성능도 측정하였다.
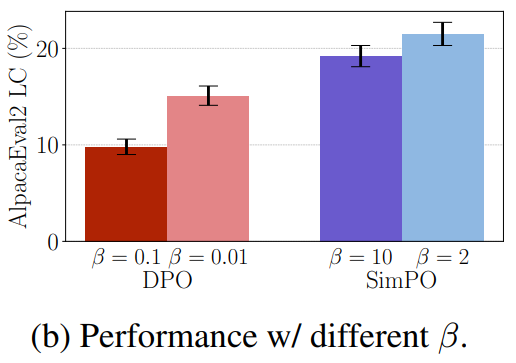
이때, $\beta$값이 작을수록 성능이 좋게 나왔다. 즉, KL-divergence 값이 작아져 reference 값과 더 멀어졌을 때 성능이 더 좋게 나왔다. 이 이유로는 본 논문은 reference policy의 성능이 좋지 않은 경우에는 조금 벗어나도록 학습해야 더 좋은 optimal policy를 만들 수 있다고 주장한다.
SimPO는 $\beta$ 값을 잘못 설정하면 reward hacking으로 인해 불안정하게 학습이 되어 성능 저하가 유발될 수 있다고 한다. 따라서, SimPO는 어느정도 KL-divergence 값을 낮게 유지할 능력이 내재되어있지만 직접적으로 KL divergence penalty를 주는 DPO보다는 안정성이 떨어진다고 볼 수 있다.
SimPO is more memory and compute-efficient than DPO
SimPO는 reference model을 사용하지 않기 때문에 더 효율적이다. SimPO와 DPO의 효율성을 비교하기 위해 두 방법의 자원 사용량을 측정하였다.
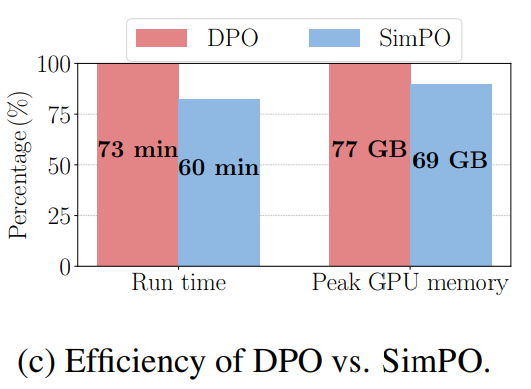
SimPO는 DPO보다 run time이 20% 적으며 GPU memory 사용량은 10% 적다고 한다.