ORPO Monolithic Preference Optimization without Reference Model 리뷰
Background
LLM이 general한 domain application에 사용되기 위해서는 Instruction tuning과 Preference alignment를 해야 한다. Instruction tuning은 자연어로 된 지시사항을 따르도록 LLM을 학습시키는 과정이다. 하지만 말을 잘 듣더라고 해롭거나 비윤리적인 답안을 생성할 수 있다. 이런 문제를 해결하기 위해 Preference alignment 과정을 거친다. Preference alignment은 LLM의 답안을 인간이 선호하는 답안과 일치시키는 과정이다. 이 과정은 더 사실에 기반하여 output을 생성하도록 하기 때문에 harm을 줄이는 것 뿐만 아니라 다른 NLP task (QA, summarization, …)의 성능도 향상시킨다.
대부분의 Preference alignment 방법의 초기 단계에서 Language model에게 우수한 답변이란 무엇인지 학습시키기 위해 supervised fine-tuning(SFT)을 사용한다. SFT의 역할은 모델이 input에 대해 적합한 token을 생성할 확률을 높여 모델이 ‘우수한 답변’이라는 domain에 익숙해지도록 하는 것이다.
이때, 기존의 Preference alignment 방법론에는 크게 두 문제점이 존재한다.
- 기존의 preference alignment 방법은 여러 과정을 거쳐야 하기 때문에 복잡하다. RLHF와 DPO의 과정을 visualize하면 다음과 같다.
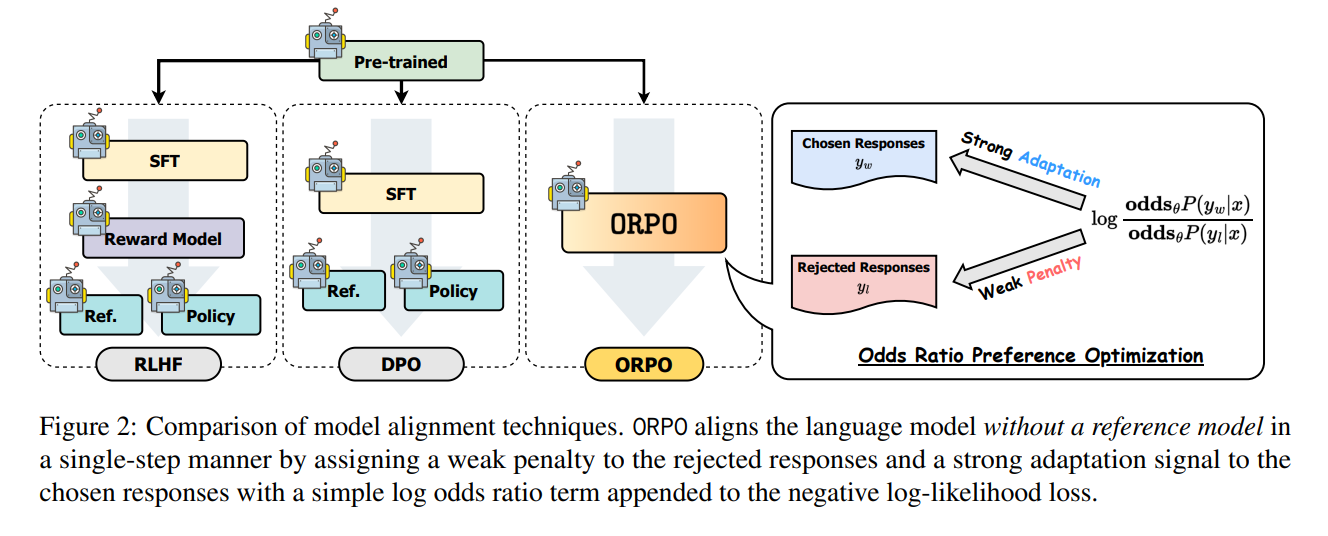
- Preference alignment의 SFT 과정에서 Input에 적합한 token의 생성 확률만 높이면 될 줄 알았지만 사실 input에 적절하지 않은 token의 생성 확률도 높아진다는 것이다. 이 이유는 SFT의 loss function (Cross Entropy Loss)을 통해 직관적으로 파악할 수 있다.
Cross entropy loss는 정답 token에 대한 확률값을 최대화하는 것이고 정답이 아닌 token에 대한 확률값에 대해서는 loss를 계산하지 않는다. 따라서 잘못된 token을 예측했을 때, 모델에 직접적인 penalty를 부여하지 않는다. 즉, SFT의 objective function에는 정답 token을 맞출 확률을 높여야겠다는 목표는 있지만 오답 token을 예측할 확률을 낮춰야겠다는 목표는 없다는 것이다. 따라서, 일반적인 SFT를 하면 정답 token뿐만 아니라 오답 token을 생성할 확률도 같이 올라가게 되어 선호될 답변만 생성하고자 하는 preference alignment와 적합하지 않다.
실제 실험 결과, SFT를 preferred output data로 하면서 학습 과정 동안의 preferred output과 dispreferred output을 생성할 log probability 값을 관찰하였다.
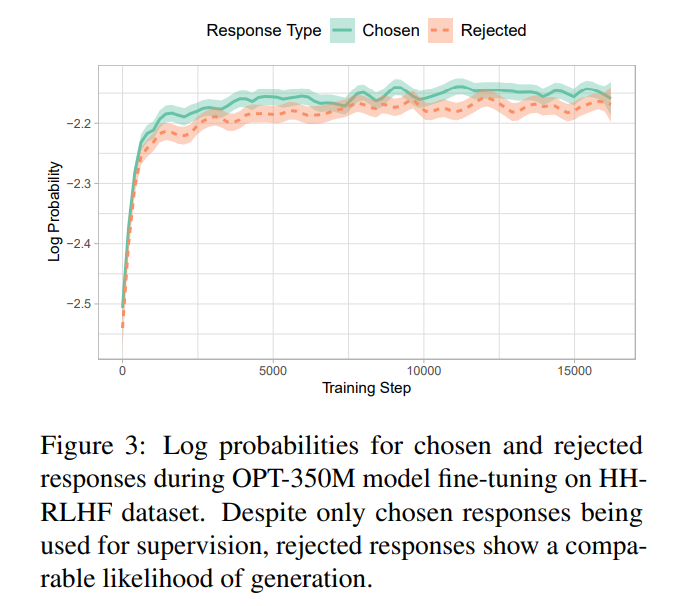
학습이 진행됨에 따라 실제로 preferred output과 dispreferred output을 생성할 log probability 값은 같이 증가하였다. 이 결과를 통해 Cross Entropy 기반 SFT는 모델을 원하는 domain (preferred output)에 적응시키는 역할을 잘 하지만 잘못된 예측에 대한 penalize를 하지 못하기 때문에 dispreferred ouput을 생성할 확률도 같이 오르게 된다는 것을 알 수 있다.
Odds Ratio Preference Optimization (ORPO)
본 논문은 desired output을 생성할 확류은 늘리고 그와 동시에 undesired output을 생성할 확률은 낮추는 preference alignment 방법론을 소개한다.
LLM의 repetition을 방지하려는 연구에서 SFT의 loss function에 penalty 항을 추가하여 최근에 생성한 token을 다시 생성하면 penalty 값을 증가시켜 우수한 결과를 얻었다. 이렇게 Loss function에 penalty 항을 추가하는 방법의 우수성을 바탕으로 ORPO가 고안되었다.
ORPO Objective
ORPO는 SFT의 Negative log likelihood loss에 odds ratio-based penalty를 추가하여 비선호 답변을 생성할 확률을 낮출 수 있다. 또, 기존의 alignment 방법들과 다르게 단일 구조를 가진다.
Odds는 무엇을 하는 확률이 그것을 안 하는 확률보다 얼마나 큰 지를 나타낸다. Language generation에서 input sequence x가 주어졌을 때 길이 m의 답안 y를 생성할 average log likelihood는 다음과 같다.
\[\log p_{\theta}(y \mid x) = \frac {1} {m} \sum_{t=1}^{m} \log p_{\theta} (y_t \mid x, y_{<t})\]그렇다면 $odds_{\theta}(y \mid x)$ (y를 생성할 확률과 y를 생성하지 않을 확률의 비)는 다음과 같다.
\[odds_{\theta}(y \mid x) = \frac {p_{\theta} (y \mid x)} {1 - p_{\theta} (y \mid x)}\]본 논문은 선호 output을 생성할 $odds_{\theta}(y_w \mid x)$와 비선호 output을 생성할 $odds_{\theta}(y_l \mid x)$의 비 $OR_{\theta} (y_w, y_l)$을 통해 input x에 대해 비선호 output보다 선호 output을 생성할 가능성이 얼마나 높은지를 표현한다. 즉, $OR_{\theta} (y_w, y_l)$을 최대화하는 방향으로 학습을 하면 선호 output 생성 확률을 늘리는 동시에 비선호 output 생성 확률은 줄어드는 방향으로 parameter가 update 될 것이라는 것을 주장하는 것이다.
\[OR_{\theta} (y_w, y_l) = \frac {odds_{\theta}(y_w \mid x)} {odds_{\theta}(y_l \mid x)}\]ORPO의 loss function은 두 부분 $\mathcal{L_\text{SFT}}, \mathcal{L_\text{OR}}$으로 구성된다.
\[\mathcal{L_\text{ORPO}} = \mathbb{E_{x, y_w, y_l}} \left [ \mathcal{L_\text{SFT}} + \lambda \cdot \mathcal{L_\text{OR}} \right ] = \mathbb{E_{x, y_w, y_l}} \left[ -\log p_{\theta}(y_w \mid x) - \lambda \cdot \log \sigma (\log \frac {odds_{\theta}(y_w \mid x)} {odds_{\theta}(y_l \mid x)}) \right]\]ORPO의 loss function을 직관적으로 이해하면 다음처럼 이해할 수 있다. $\mathcal{L_\text{SFT}}$을 최소화하는 과정을 통해 desired domain (선호되는 output)에 적응하도록 하고 $\mathcal{L_\text{OR}}$을 최소화하는 과정을 통해 undesired generation을 막을 수 있다. 이전 방법은 $p(y_w \mid x)$을 높이는데만 집중하기 때문에 $y_l$을 생성할 확률도 높아졌지만, ORPO는 $y_l$을 생성할 확률이 올라가면 loss ($\mathcal{L_\text{OR}}$)가 커지기 때문에 penalize 된다.
Gradient of ORPO Objective
$\mathcal{L_\text{OR}}$의 gradient를 통해 ORPO을 더 잘 이해할 수 있다.
Gradient 계산 과정
$g(x, y_w, y_l) = \frac {odds_{\theta}(y_w \mid x)} {odds_{\theta}(y_l \mid x)}$ 이라고 할 때
\[\nabla_{\theta} \mathcal{L_\text{OR}} = \nabla_{\theta} \log \sigma ( \log \frac {odds_{\theta}(y_w \mid x)} {odds_{\theta}(y_l \mid x)}) = \nabla_{\theta} \log \sigma (\log g(x, y_w, y_l)\]\[\nabla_{\theta} \mathcal{L_\text{OR}} = \sigma(-\log g(x, y_w, y_l)) \cdot \nabla_{\theta} \log g(x, y_w, y_l)\] \[\nabla_{\theta} \mathcal{L_\text{OR}} = \frac {1} {1 + e^{\log g(x, y_w, y_l)}} \cdot \nabla_{\theta} \log g(x, y_w, y_l)\] \[\nabla_{\theta} \mathcal{L_\text{OR}} = \frac {1} {1 + g(x, y_w, y_l)} \cdot \nabla_{\theta} \log g(x, y_w, y_l)\] \[\nabla_{\theta} \mathcal{L_\text{OR}} = \frac {1} {1 + \frac {odds_{\theta}(y_w \mid x)} {odds_{\theta}(y_l \mid x)}} \cdot \nabla_{\theta} \log g(x, y_w, y_l)\] \[\nabla_{\theta} \mathcal{L_\text{OR}} = (1 + \frac {odds_{\theta}(y_w \mid x)} {odds_{\theta}(y_l \mid x)})^{-1} \cdot \nabla_{\theta} \log g(x, y_w, y_l)\]이때 $\log \sigma(x) ‘ = \frac {\sigma ‘ (x)} {\sigma(x)} = \frac {\sigma(x) \cdot (1 - \sigma(x))} {\sigma(x)} = 1 - \sigma(x) = \sigma(-x)$이므로
이때 $\nabla_{\theta} \log g(x, y_w, y_l)$을 구하면
\[\nabla_{\theta} \log g(x, y_w, y_l) = \nabla_{\theta} \left [ \log odds_{\theta}(y_w \mid x) - \log odds_{\theta}(y_l \mid x) \right ]\]\[= \nabla_{\theta} \left [ \log p_{\theta}(y_w \mid x) - \log (1-p_{\theta}(y_w \mid x)) - \log p_{\theta}(y_l \mid x) + \log (1 - p_{\theta}(y_l \mid x)) \right ]\]$odds_{\theta}(y \mid x) = \frac {p_{\theta} (y \mid x)} {1 - p_{\theta} (y \mid x)}$이므로
계산을 쉽게 하기 위해 $\nabla_{\theta} \log(1 - p_{\theta}(y \mid x))$을 구해보자
\(\nabla_{\theta} \log(1 - p_{\theta}(y \mid x)) = \frac {\nabla_{\theta} (1 - p_{\theta}(y \mid x))} {1 - p_{\theta}(y \mid x)} = \frac {- \nabla_{\theta} (p_{\theta}(y \mid x))} {1 - p_{\theta}(y \mid x)} = - \frac {p_{\theta}(y \mid x)} {(1 - p_{\theta}(y \mid x))} \cdot \frac {\nabla_{\theta} p_{\theta}(y \mid x)} {p_{\theta}(y \mid x)}\)
이때 $\nabla_x log f(x) = \frac {\nabla_x f(x)} {f(x)}$이므로
\[\nabla_{\theta} \log(1 - p_{\theta}(y \mid x)) = -odds_{\theta} (y \mid x) \cdot \nabla_{\theta} \log(p_{\theta} (y \mid x))\]
\[\nabla_{\theta} \log g(x, y_w, y_l) = \nabla_{\theta} \left [ \log odds_{\theta}(y_w \mid x) - \log odds_{\theta}(y_l \mid x) \right ]\] \[\nabla_{\theta} \log g(x, y_w, y_l) = \nabla_{\theta} \left [ \log p_{\theta}(y_w \mid x) - \log (1-p_{\theta}(y_w \mid x)) - \log p_{\theta}(y_l \mid x) + \log (1 - p_{\theta}(y_l \mid x)) \right ]\] \[\nabla_{\theta} \log g(x, y_w, y_l) = \nabla_{\theta} \left [ \underbrace {\log p_{\theta}(y_w \mid x) + odds_{\theta} (y_w \mid x) \cdot \log(p_{\theta} (y_w \mid x))}_{\text{$\log p_{\theta}(y_w \mid x)$ 에 대해 묶음}} - \underbrace {\log p_{\theta}(y_l \mid x) - odds_{\theta} (y_l \mid x) \cdot \log(p_{\theta} (y_l \mid x))}_{\text{$\log p_{\theta}(y_l \mid x)$ 에 대해 묶음}} \right ]\] \[\nabla_{\theta} \log g(x, y_w, y_l) = \nabla_{\theta} \left [ (1 + odds_{\theta} (y_w \mid x)) \cdot \log p_{\theta}(y_w \mid x) - (1 + odds_{\theta} (y_l \mid x)) \cdot \log p_{\theta}(y_l \mid x) \right ]\]이 값을 $\nabla_{\theta} \log g(x, y_w, y_l)$식에 대입하면
이 값을 $\nabla_{\theta} \mathcal{L_\text{OR}} = (1 + \frac {odds_{\theta}(y_w \mid x)} {odds_{\theta}(y_l \mid x)})^{-1} \cdot \nabla_{\theta} \log g(x, y_w, y_l)$에 대입하면
\[\nabla_{\theta} \mathcal{L_\text{OR}} = (1 + \frac {odds_{\theta}(y_w \mid x)} {odds_{\theta}(y_l \mid x)})^{-1} \cdot \nabla_{\theta} \left [ (1 + odds_{\theta} (y_w \mid x)) \cdot \log p_{\theta}(y_w \mid x) - (1 + odds_{\theta} (y_l \mid x)) \cdot \log p_{\theta}(y_l \mid x) \right ]\]\[\nabla_{\theta} \mathcal{L_\text{OR}} = \underbrace {(1 + \frac {odds_{\theta}(y_w \mid x)} {odds_{\theta}(y_l \mid x)})^{-1}}_{\text{$\delta(d)$}} \cdot \underbrace {(\frac {\nabla_{\theta} \log p_{\theta} (y_w \mid x)} {1 - p_{\theta}(y_w \mid x)} - \frac {\nabla_{\theta} \log p_{\theta} (y_l \mid x)} {1 - p_{\theta}(y_l \mid x)})}_{\text{$h(d)$}}\]$(1 + odds_{\theta} (y_w \mid x)) = 1 + \frac {p_{\theta}(y_w \mid x)} {1 - p_{\theta}(y_w \mid x)} = \frac {1} {1 - p_{\theta}(y_w \mid x)}$이므로
ORPO의 gradient는 두 부분, $\delta(d)$와 $h(d)$ 으로 이루어져있다. 각 부분의 역할은 직관적으로 해석될 수 있다.
- $\delta(d)$ : favored response를 생성할 odds가 disfavored responses의 odds보다 상대적으로 높다면, $\delta(d)$의 값은 0으로 수렴하게 되어 update의 정도가 작아진다. 하지만 disfavored responses의 odds가 상대적으로 더 높다면, $\delta(d)$의 값은 증가하여 parameter update를 가속화한다. 일종의 penalty term의 역할을 한다고 볼 수 있다.
- $h(d)$ : $p_{\theta}(y_w \mid x)$가 클수록 h(d)의 첫 term 크기를 증폭시키기 때문에 favored response distribution으로 더욱 향하도록 한다. domain specific adaptation의 역할을 한다고 볼 수 있다.
실험 결과
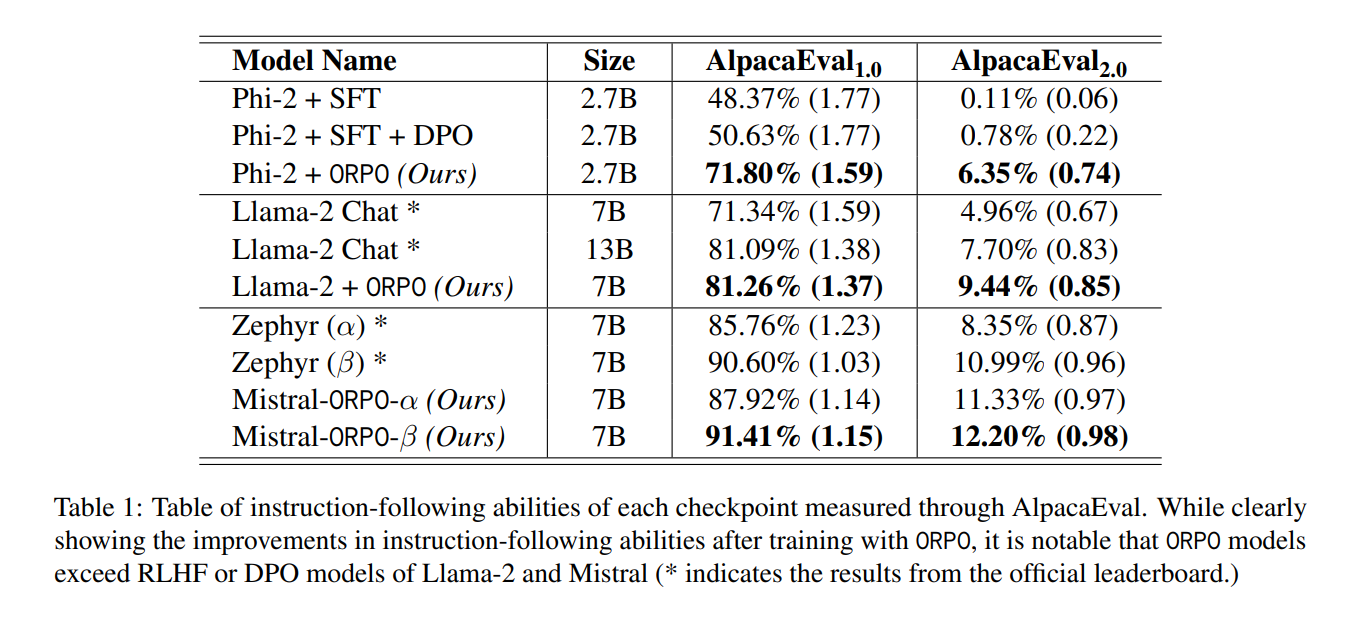
Single Turn Instruction Following
Phi 기반 모델
- Phi-2 (2.7B) + ORPO는 Llama2-Chat (7B, 13B)보다 alignment 성능 뛰어남
- Phi-2 (2.7B) + ORPO는 다른 Phi + $\alpha$ 모델보다 alignment 성능 좋음
Llama 기반 모델
- RLHF으로 align된 Llama2-Chat(7B, 13B)보다 Llama2-Chat(7B) + ORPO가 alignment 성능 좋음
- DPO 또는 RLHF로 1 epoch만큼 Llama 모델들을 align 시켰는데 이때, 이 모델들은 평가가 불가능한 답변을 내놓을만큼 align이 제대로 안 되어 있었다. 하지만 ORPO로 1 epoch만큼 align 시켰을 때는 align이 어느 정도 되어 있었다. 이를 통해 $h(d)$ 항이 domain adaptation을 가속화하여 1 epoch만큼만 학습을 하여도 align 성능이 좋아지도록 하였음을 관찰할 수 있다.
Mistral 기반 모델
- ORPO (Mistral-ORPO-$\alpha$)가 SFT + DPO보다 성능이 높고, 더 좋은 품질의 data로 학습했을 때 (Mistral-ORPO-$\beta$)는 성능이 더 좋아짐
Multi-Turn Instruction Tuning
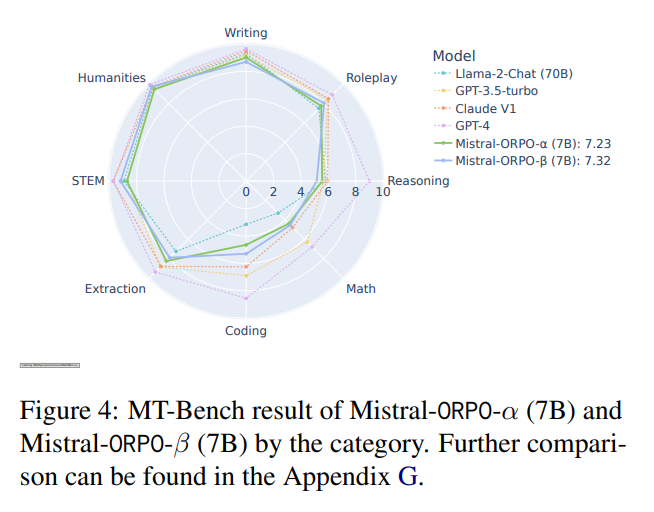
Multi-turn 대화 data를 접해보지 않았어도 Mistral-ORPO-$\alpha$ 7B, Mistral-ORPO-$\beta$ 7B는 Llama-2-Chat (70B)와 비슷한 성능을 보인다.
Reward Model Winrate
ORPO와 다른 alignment method들의 scalability에 따른 winrate를 비교하였다. 다음 Table은 HH-RLHF dataset에서 각 alignment 방법들로부터 추출된 답안이 받는 reward 값의 winrate를 비교한 것이다.
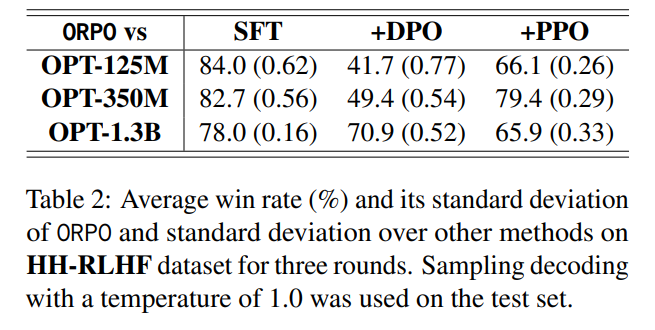
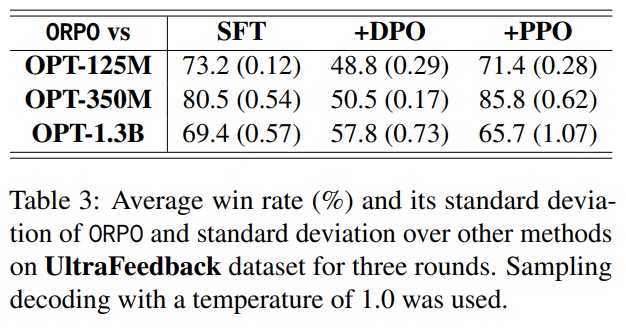
ORPO의 win rate는 SFT와 PPO와 격차가 가장 크고, 크기가 증가함에 따라 DPO와의 격차가 커지는 경향을 보인다. UltraFeedback dataset에서 비교한 결과도 비슷한 양상을 보인다.
Reward Distribution
각 alignment 방법으로 생성된 답안들이 받는 reward의 분포를 관찰하였다.
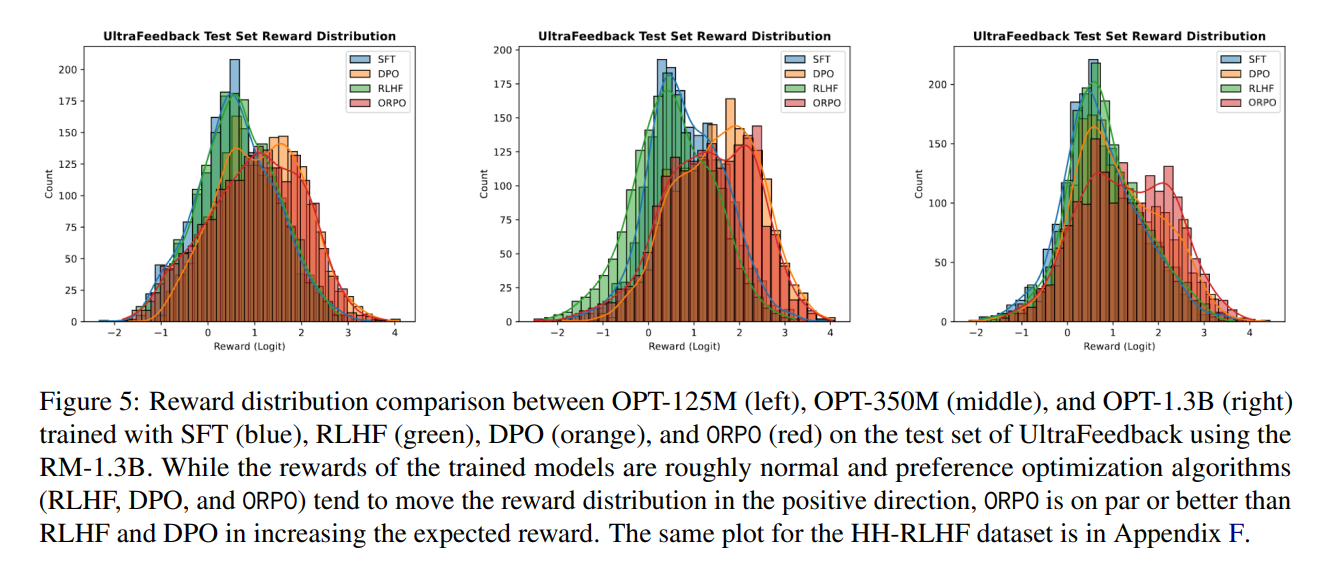
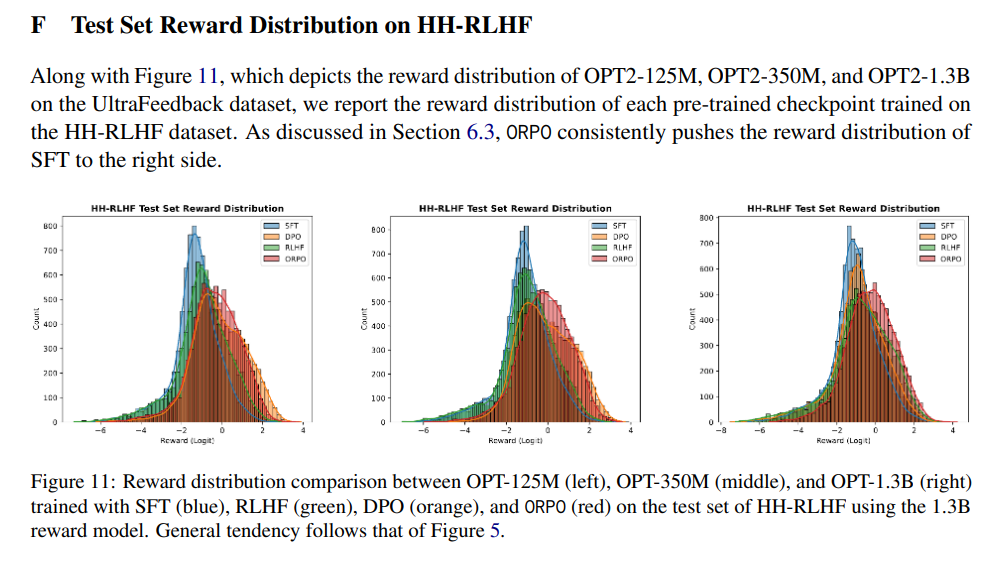
SFT로 align된 답안들의 reward 분포를 기준으로 했을 때, PPO, DPO, ORPO 모두 reward 분포가 오른쪽으로 쏠린 현상이 관찰된다. 하지만 쏠린 정도와 모양은 서로 다르다.
RLHF (PPO + SFT)의 경우, 보상 기댓값이 낮고 (오른쪽 shift 정도가 낮음) 비정상적인 특징을 가진다. RLHF의 reward model로는 350M 크기를 사용했는데 reward distribution 계산에 사용된 reward model은 1.3B 크기이므로 350M reward model에 최적화된 답안은 1.3B 크기의 reward model 입장에서 볼 때는 reward가 maximize되지 않는 답안인 것이다. 이로 인해 보상 기댓값이 전체적으로 낮게 측정 되었다고 본다. 이처럼 RLHF 방법은 reward model에 극도로 의존적이기 때문에 불안정하다.
ORPO가 제일 오른쪽으로 쏠린 것을 통해 ORPO가 우수한 preference alignment 방법이라는 것을 알 수 있다.
Lexical Diversity
어떤 모델이 input에 대한 답변의 다양성이 낮다는 것은 input 별로 보상이 높게 나오는 패턴을 학습했다는 의미로 볼 수 있다. 즉, 획일화된 답변만 생성할 수 있다는 것은 일반화 성능이 매우 떨어진다고 해석된다. 따라서, 모델의 어휘적 다양성을 관찰함으로써 모델의 일반화 성능을 엿볼 수 있다.
본 논문은 어휘적 다양성을 각 input 별 답안의 diversity (Per Input Diversity)와 임의의 input이 주어졌을 때 답안의 diversity (Across Input Diversity)로 나누어서 관찰한다. 다양성을 측정하는 metrics는 다음과 같다.
i번째 input에 대해 여러 답변들의 집합 $O_{\theta}^{i}$
\[O_{\theta}^{i} := \{ y_{j} \sim \theta(y \mid x_i) \mid \text {j=1,2, ... k} \}\]집합 내에서 각 답변들 간의 cosine similarity의 평균 $D(O_{\theta}^{i})$
\[D(O_{\theta}^{i}) = \frac {1} {2} \cdot \frac {\sum_{i=1}^{N-1} \sum_{j=i+1}^{N} \cos(h_i, h_j)} {N \cdot (N-1)}\]이때 두 종류의 어휘적 다양성을 다음과 같이 계산한다.
Per Input Diversity (PID)
질문 별 output의 diversity의 평균값을 통해 하나의 input에 대한 output의 diversity의 근사값을 계산한다.
\[\text{PID}_D(\theta) = \frac {1} {N} \sum_{i=1}^{N} D(O_{\theta}^{i})\]Across Input Diversity (AID)
여러 input에 대한 여러 답변들의 합집합의 diversity 계산을 통해 전체적인 diversity를 계산한다.
\[\text{AID}_D(\theta) = D ( \cup_{i=1}^{N} O^{i}_{\theta, j=1})\]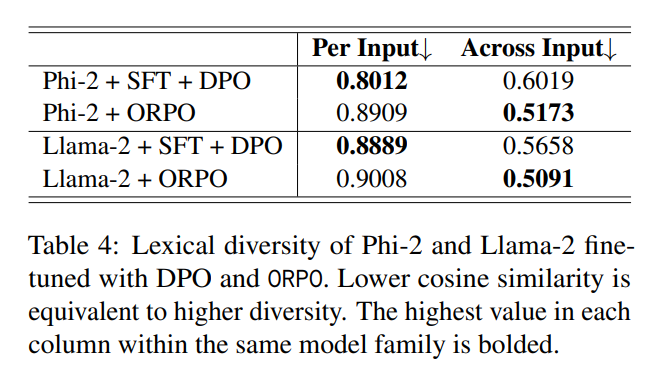
ORPO는 AID 값은 높으면서 PID 값은 낮기 때문에 일반화 성능이 높으면서 선호되는 답변 (input domain에 특화된 답변)만 한다고 볼 수 있다.
Discussion
Probs Ratio vs Odds Ratio
preferred와 dispreferred output의 Odds Ratio의 차이를 최대화하는 방법이 Probs Ratio 차이를 최대화하는 방법보다 왜 더 align을 잘 시키는가에 대한 이유를 제시한다. Odds ratio가 probs ratio보다 우수한 이유는 안정성에 있다고 한다.
Odds ratio는 model의 선호도 이해에 더 집중되어 있고 Probs ratio는 너무 극단적으로 desired와 undesired를 구분하려고 하여 불안정하다.
Odds ratio와 Probs ratio의 차이에 대한 이해를 돕기 위해 시각적으로 비교하였다. 두 값 $X_1, X_2$을 정규분포에서 sample하여 log prob ratio 식과 log odds ratio 식에 대입하여 각 ratio의 분포를 시각화하였다.
Prob ratio 값 계산
\[Y \sim \beta (\log X_1 - \log X_2)\]Odds ratio 값 계산
\[Y \sim \log \frac {X_1} {1 - X_1} - \log \frac {X_2} {1 - X_2}\]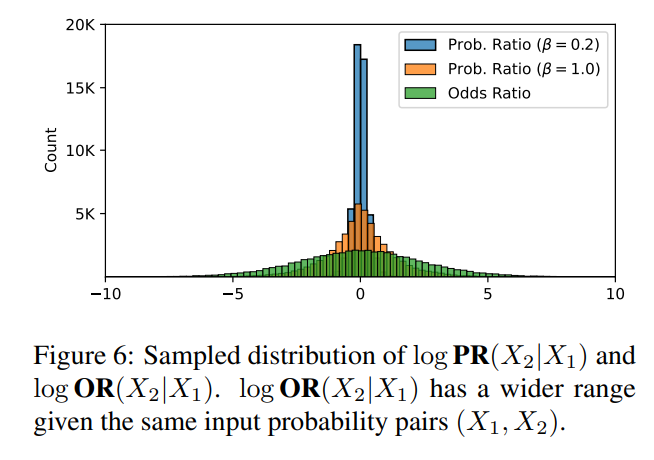
Ratio의 크기가 클수록 loss의 값은 작아지기 때문에 안정적으로 ratio의 크기가 커질 수 있다면, 그 ratio가 alignment에서 더 우수하다고 볼 수 있다.
Odds ratio의 분포는 우선 값의 범위가 넓다. 그리고 Odds ratio 값은 자기만의 증폭제 ($\frac {1} {1 - X}$)가 있기 때문에 preferred response domain에 어느정도 적응되어 있다면 dispreferred response를 생성할 확률을 조금만 억압해도 ratio 값이 커져 alignment가 안정적으로 잘 된다.
반면 Prob ratio의 분포는 값의 범위가 집중되어 있다. 이때, ratio의 값을 최대한 키우기 위해서 제한된 범위 안에 정답과 오답을 생성할 확률의 차이를 억지로 벌리려고 시도하게 된다. 이렇게 학습이 된다면 input에 대해 적합하진 않지만 정상적으로 작성된 output에 대해서도 reward를 최소화하게 되며 결국 모델 성능 자체의 저하가 발생하게 된다.
$\rightarrow$ 따라서, Odds Ratio를 사용하는 것이 더 정당하다.
$\mathcal{L_{\text{OR}}}$을 최소화하는 것의 의미
$\mathcal{L_{\text{OR}}}$을 최소화하는 학습 과정동안 desired와 undesired output의 log probability와 log odds ratio 값을 관찰하였다.
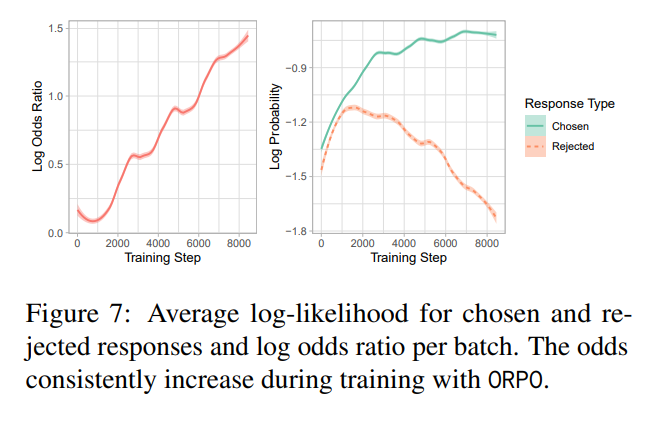
Log odds ratio가 증가할 때, log probability of desired output은 증가하면서 undesired output의 log probability 값은 감소하는 것을 볼 수 있다. 이를 통해 ORPO는 SFT의 domain adaptation의 역할을 충실히 하면서 (desired output을 잘 학습하면서) penalty term $\mathcal{L_{\text{OR}}}$을 통해 undesired generation은 잘 배제한다고 볼 수 있다.
Computational Efficiency
ORPO는 reference model을 필요로 하지 않기 때문에 다른 방법보다 메모리와 계산 요구량이 적다. RLHF와 DPO의 경우, $\frac {\pi_{\theta}(y_w \mid x)} {\pi_{\text{ref}}(y_w \mid x)} - \frac {\pi_{\theta}(y_l \mid x)} {\pi_{\text{ref}}(y_l \mid x)}$을 계산해야 하기 때문에 각 training step에 4번의 forward step을 수행해야 하며 학습되는 모델의 크기와 동일한 크기의 reference model을 저장하고 있어야 한다. 반면, ORPO는 $\pi_{\theta}(y_w \mid x)$와 $\pi_{\theta}(y_l \mid x)$ 값만 알면 되기 때문에 다른 alignment 방법들보다 forward pass가 절반만 요구되고 reference model을 사용하지 않게 때문에 메모리 사용량도 상대적으로 절반만 요구된다.
기존의 probs ratio에서 벗어나 새로운 개념인 odds ratio를 통해 reference model을 사용하지 않고도 alignment 방법을 고안해낸 것이 인상적이었다.