Character Level Language Modeling with Deeper Self-Attention 리뷰
Transformer-XL에서 언급되었기에 한번 읽어보았다.
Background
Character-level language modeling의 주된 어려움은 다음과 같다.
- Vocabulary 학습 범위가 매우 넓음
- Character 간 time dependency가 큼
- 매 timestep마다 character를 예측하는 과정은 단어를 예측하는 과정보다 더 많은 연산을 요구함
이 Character-level language modeling을 하기 위해서 기존에는 짧은 길이의 mini-batches of text sequences를 RNN에 학습시켰다. Batch sequence보다 긴 context를 이해할 수 있도록 하기 위해 training batches를 순서대로 모델에 제공하고 이전 batch를 학습하여 얻은 hidden state를 다음 batch를 학습할 때 모델에 넣었다. 이 방법은 학습 과정이 복잡하고 실제 연구에 따르면 이 방법으로 학습된 모델은 사실 long-term context를 사용하지 못하고 최대 200 token까지만 고려할 수 있다고 한다.
Character Transformer Model
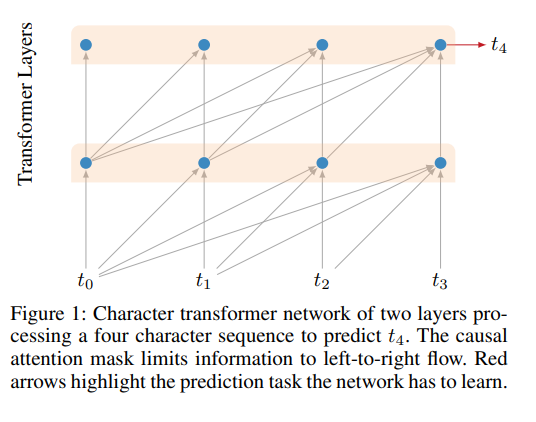
이 논문에서는 기존에 Character-level language modeling에 사용되는 RNN 구조를 버리고 Transformer 구조를 사용하여 문제를 해결하였다. Transformer는 RNN과 달리 임의의 위치에서 정보를 즉각적으로 가져올 수 있기 때문에 학습 데이터를 구성할 때 순서대로 구성하지 않아도 되고, 이전 batch를 처리한 hidden state를 다음 batch를 처리하는 연산에 전달하지 않아도 된다.
Character-leveling modeling에 사용되는 objective는 다음과 같다.
\[Pr(t_{0:L}) = P(t_0) \prod_{i=1}^{L} Pr(t_i \mid t_{0:i-1})\]조건부 확률분포 $Pr(t_i \mid t_{0:i-1})$을 계산하기 위해서 Transformer를 사용하여 character sequence $t_{0:i-1}$을 처리한다. 이 논문에서는 64개의 Transformer Layer (multihead self attention sub layer + FFN)을 사용하여 모델을 구성한다.
Auxiliary losses
논문에서는 일반적인 Transformer를 사용하지 않는다. 연구에 따르면 Transformer layer를 10개 이상 사용할 경우, convergence가 느려지고 정확도가 저하된다고 한다. 여기서 논문의 특징은 Deep transformer network를 사용하면서도 이 문제를 해결하기 위해 auxiliary losses를 사용한다는 것이다. 이 연구에서 보조적인 loss들을 도입하여 convergence를 빠르게 하도록 하였다. 이 loss들은 또 regularizer의 역할을 하여 accuracy에 도움을 줄 거라고 예상했다.
보조적인 loss들은 각각 다른 decay schedule을 가지고 network의 total loss에 각 weight만큼 곱해져서 더해졌다.
1) Multiple positions
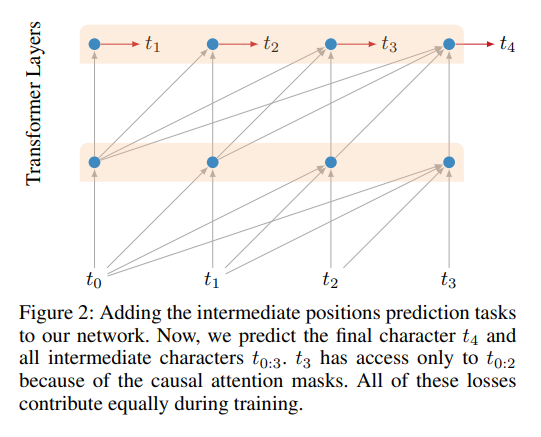
| 원래는 $t_i$를 예측하기 위해서 $t_0 ~ t_{i-1}$으로 하나의 예측값을 계산하지만 이 논문에서는 final layer의 모든 position에서 다음 token을 예측하게 하여 총 | $L$ | 번의 예측을 하도록 하였다. 이 예측값과 실제 token 값을 통해 auxiliary loss를 구성하였다. 이 방법으로 model이 small context 내에서 다음 character를 예측하도록 하였다고 생각하면 된다. |
2) Intermediate Layer Losses
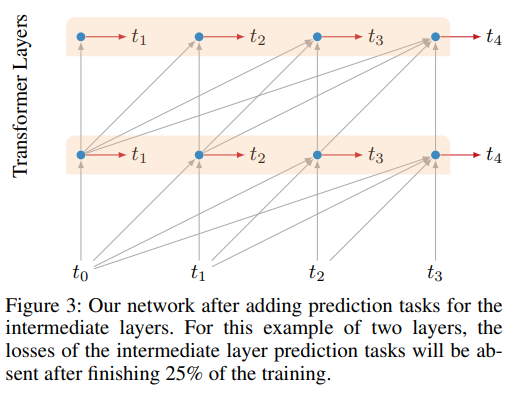
마지막 layer 뿐만 아니라 intermediate layer들에도 Next token 예측을 하게 하여 더 많은 loss들을 만들었다. 이때, 초반의 layer 일수록 예측값의 신뢰도가 떨어지기 때문에 이 layer에서 계산한 loss들의 weight는 작게 하였다. 이를 generalize하면 총 N개의 layer가 존재한다면, i번째 layer는 $\frac {i} {2N}$번째 training step까지만 관여하도록 하였다. 즉, 모든 intermediate layer loss는 학습 절반 이후부터는 사라진다.
3) Multiple Targets
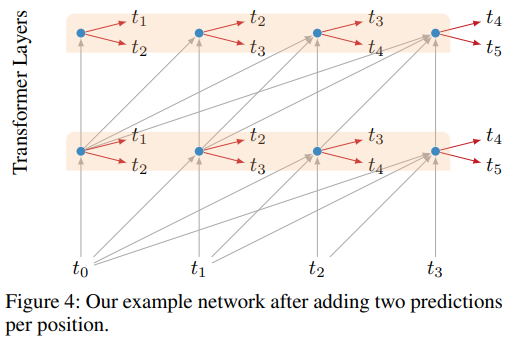
각 position에서 하나의 예측이 아니라 여러개의 예측을 하도록 하였다.
Positional Embeddings
추가적으로 tranformer layer를 너무 깊게 구성하다보면 초반에 더해주는 positional embedding 값을 활용하지 못할 거 같아서 순서 정보가 손실될 가능성을 고려하였다. 이를 해결하기 위해 기존 transfomer 모델이 사용하는 sinusoidal position signal을 사용하지 않고 각 layer에 input sequence가 들어가기 전에 learned positional embedding을 더해서 순서 정보가 손실되지 않도록 하였다.