Tactile Modality Fusion for Vision-Language-Action Models 리뷰
Background
Tactile을 VLA에 도입하기 위해서는 tactile encoder으로 tactile 정보를 처리한 token들을 VL token에 concat하거나 대량의 데이터로 pretraining을 하려고 한다. 하지만 추가적인 연산량을 요구하고, pretraiining을 위한 데이터는 부족하고, 별도의 tactile encoder을 학습해야 하기 때문에 문제를 겪는다.
따라서 TacFiLM은 FiLM을 통해서 visual feature을 tactile 정보로 condition 할 수 있도록 하는 fine-tuning 방법을 사용한다. 추가적인 cross modal fusion module을 도입하지 않아도 되고 처리하는 token 양이 늘어나지 않기 때문에 model의 pretrained prior을 유지할 수 있다는 장점을 갖고 있다.
Methodology
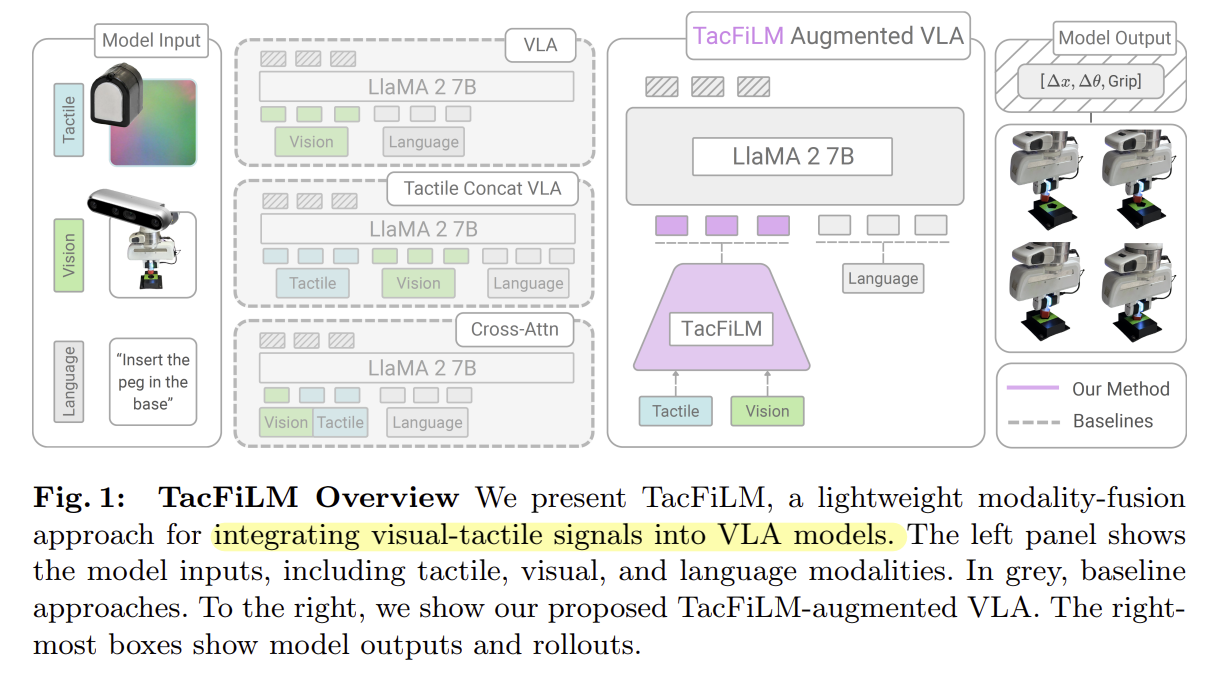
Policy Architecture
Tactile 정보를 효과적으로 사용하기 위해서 modality addition이 아니라 fusion 방법을 사용한다. Policy와 modality encoder을 같이 학습시키는 것이 아니라 pretrained tactile representation을 사용하고 기존 VLA model의 visual language prior을 유지하도록 하는 것이다.
각 time step에서 image input이랑 language prompt는 똑같이 처리되면서 tactile은 pretrained 모델을 사용하여 embedding으로 변환한다. 이 embedding은 intermediate vision representation 을 condition 하도록 사용되어 fusion이 가능하도록 한다.
이 tactile condition된 visual feature는 일반적인 방법대로 LLM이 text token과 같이 처리된다. 이 방법은 VLA가 pretraining과 달라진 것 없이 visual, tactile, language 정보를 jointly하게 처리하게 해준다는 장점을 가지고 있다.
FiLM Based Fusion
Feature wise Linear Modulation은 backbone을 auxiliary signal으로 condition할 수 있도록 channel 별 scale + shift parameter $\gamma, \beta$ 을 배우는 것이다. 이를 통해서 기존 intermediate activations 값은 auxiliary signal에 맞게 feature wise affine transformation이 적용되어 fusion이 가능해지는 것이다.
이때의 auxiliary signal은 visuotactile image의 pretrained embedding이다. 이 embedding이 바로 사용되는 것은 아니고 average pooling을 통해 embedding $z_t$ 로 축소된다.
직관적으로 scale, shift parameter을 학습함으로써 tactile $z_t$ 상태일 때 visial representation을 어떻게 변형시켜야 할까, 어디를 강조시켜야 할까를 학습한다고 보면 된다.
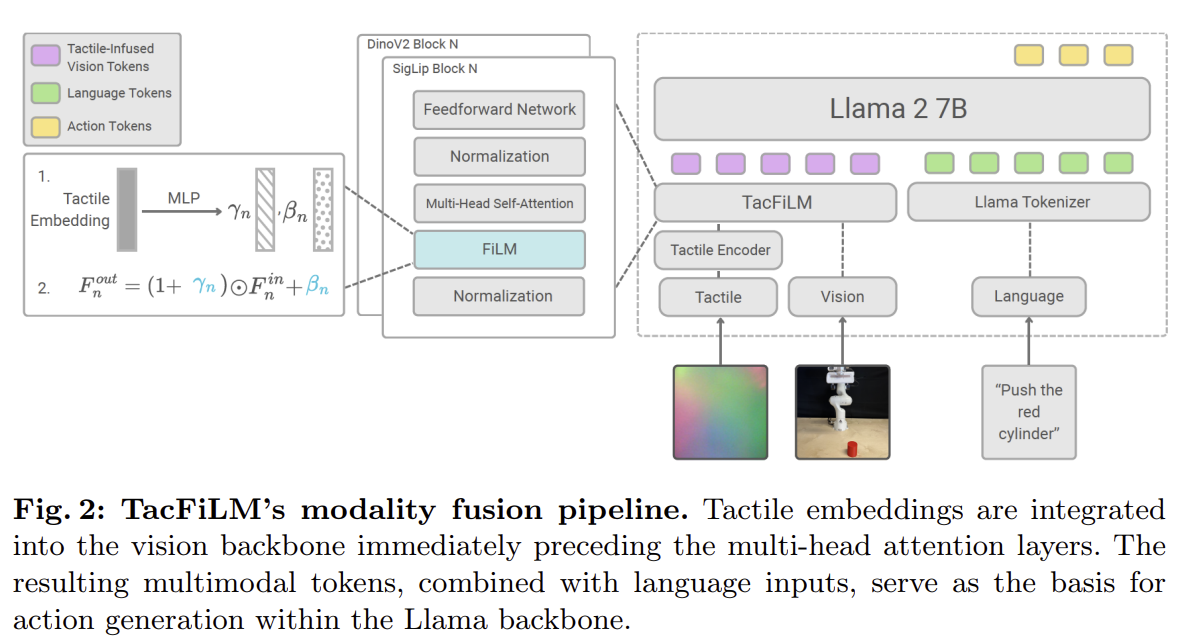
FiLM은 multi-head self attention 전, normalize을 한 뒤에 적용이 된다.
\[\text{FiLM}\left(F_n \mid \gamma_n, \beta_n\right) = F_n \odot (1 + \gamma_n) + \beta_n\]Channel 별 scale과 shift는 전체 feature map에 적용되며 처음에는 scale과 shift parameter을 0으로 초기화한다. 따라서 처음에는 near identity으로 condition이 되도록 하였다.
FiLM의 방법론은 Action을 추론할 때 추가 token 연산이 요구되지 않으면서 효과적인 fusion이 가능하도록 해주고 affine transformation을 통해 low dimensional global tactile bias을 주입할 수 있게 된다.
Pretrained Tactile Representations
Tactile encoder을 finetuning 없이 pretrained embedding 그대로 사용해서 condition 하기 때문에 어떤 pretrained tactile encoder을 사용하는지가 중요하다. 따라서 서로 다른 pretraining objective으로 pretrained된 두 개의 tactile encoder으로 실험을 한다.
T3
T3는 두 개의 pretraining 단계를 사용한다. 처음에는 Tactile image의 patch 일부를 masking해서 원본으로 복원되도록 하는 MAE loss으로 pretrain된다. 그 다음에는 supervised multi-task learning을 통해 여러 tactile downstream task에 대해서 학습이 된다.
Sparsh
Sparsh는 여러 종류가 존재한다.
-
Sparsh-MAE
Masked tactile image의 reconstruct하도록 학습이 된다.
-
Sparsh-DINO
Teacher와 student가 서로 다른 augmentation을 본 뒤에 latent representation이 일치하도록 self-distillation을 한다.
-
Sparsh-IJEPA
Visible tactile context에서 masked region의 pixel이 아니라 latent representation을 예측하도록 하는 방법이다.
Training
본 논문은 VLA가 specialized task을 배우기 위한 precision이 부족하다고 주장한다. 따라서 LoRA을 사용해서 efficient finetuning을 통해서 generalist model을 tactile domain에 특화시키는게 적절하다고 주장한다. LoRA는 linear layers에만 적용하고 FiLM layer는 scratch부터 학습을 한다. 이때 대부분의 모델은 freeze하기 때문에 visuotactile modality을 inject에 유리하다.
Result
기존 VLA에 tactile 정보를 injection하는 방법들을 비교한다. Baseline으로는 기존 모델인 OpenVLA-OFT, Tactile token을 concatenate 하는 방법, 그리고 cross attention을 하는 방법 (Visual patch embedding이 query가 되고 tactile token이 KV을 구성)을 사용한다.
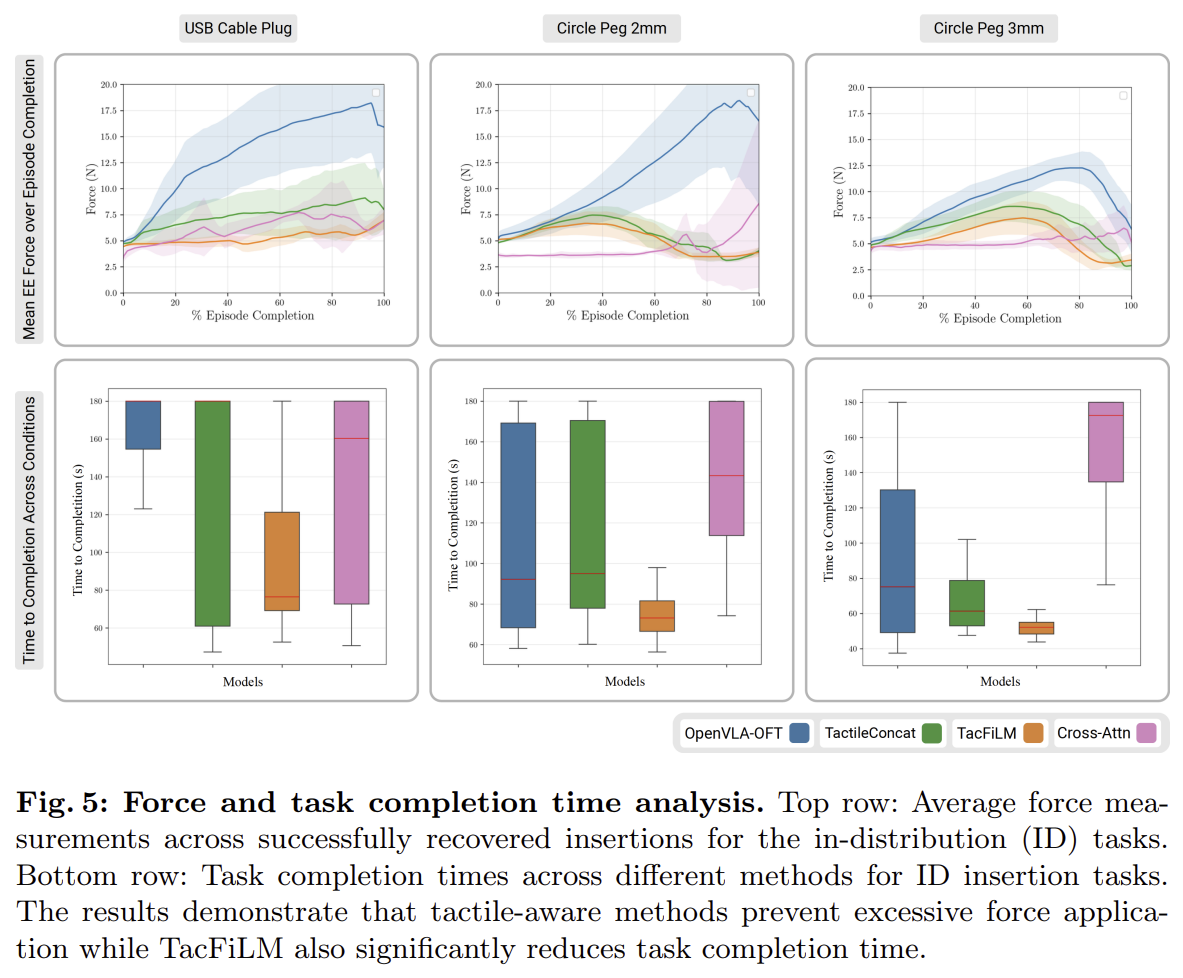
FiLM 방법이 completion time variance가 가장 작고 사용하는 force도 잘 분배된다. 반면다른 방법론들은 높은 time completion과 force가 들쭉날쭉하다.
다음 실험은 FiLM을 적용하는 지점과 vision occlusion에 대한 ablation study이다.
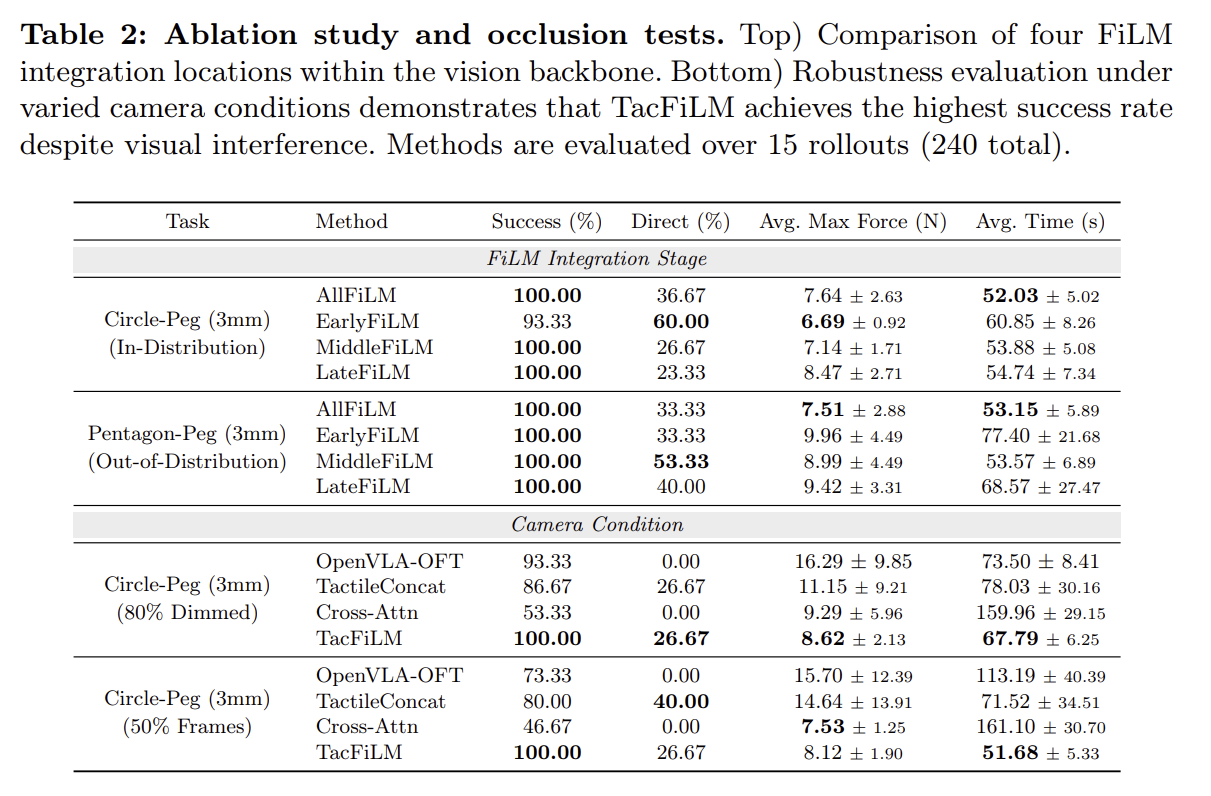
Dimming이나 frame 수 자체를 줄이면 tactile 정보에 자연스럽게 더 잘 의존하게 된다. 이때 두 occlusion 상황에서 TacFiLM이 가장 성공률이 높다. 이를 통해 TacFiLM이 VLA에 tactile 정보를 가장 효과적으로 inject 한다고 볼 수 있다.
다음 실험은 Tactile encoder에 따른 성능 ablation study이다.
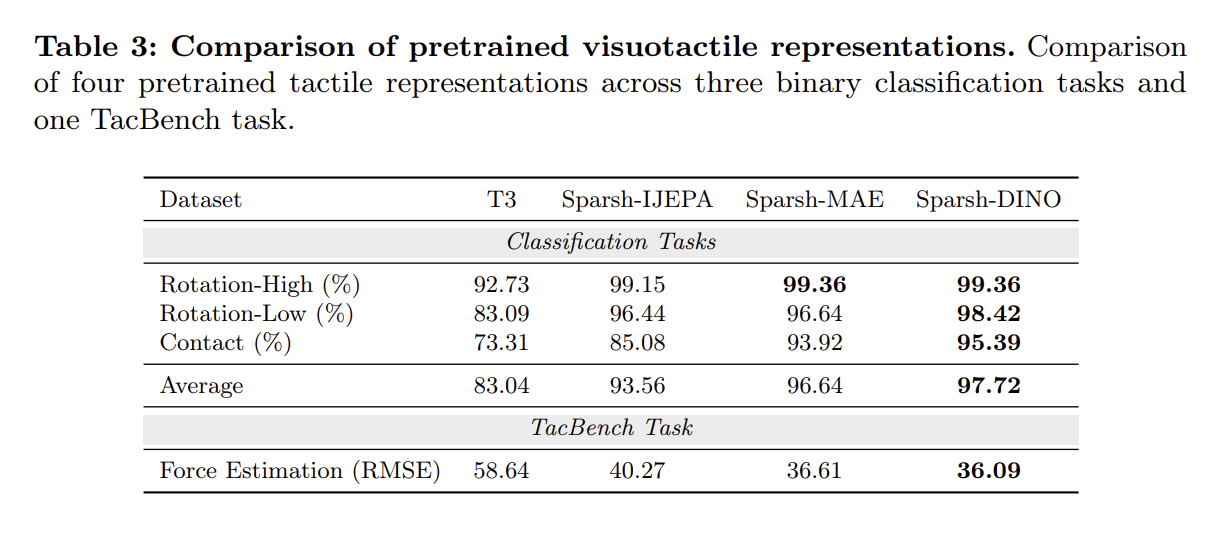
Tactile encoder의 variation에 대한 성능을 평가하기 위해서는 tactile encoder의 embedding에 무슨 정보가 담기는지를 확인해야 하기 때문에 간단한 binary classification task을 새로 구성하였다.
-
Rotation-high,low : Gripper가 잡은 peg가 처음 자세에서 회전했는지를 판단하는 이진 분류 task이다.
-
Contact: Peg가 접촉 중인지 아닌지를 분류
-
Force Regression: Sparsh TacBench의 task을 force 예측 task이다.
결론적으로 Sparsh-DINO가 제일 좋았다. Sparsh-DINO는 동일한 tactile sample을 다양하게 augment 한 뒤, 이들이 비슷한 representation을 갖도록 학습을 한다. 이 pretraining 방법이 어떻게 보면 다양한 tactile situation에서도 동일한 정보를 뽑도록 하는 방법이기 때문에 tactile 정보를 더 효과적으로 담을 수 있다. 이때, loss을 representation space에서 계산하고 update되기 때문에 MAE 방법론보다 유리하다. (world model 연구에서도 동일한 얘기를 함)