AT-VLA: Adaptive Tactile Injection for Enhanced Feedback Reaction in Vision-Language-Action Models 리뷰
Background
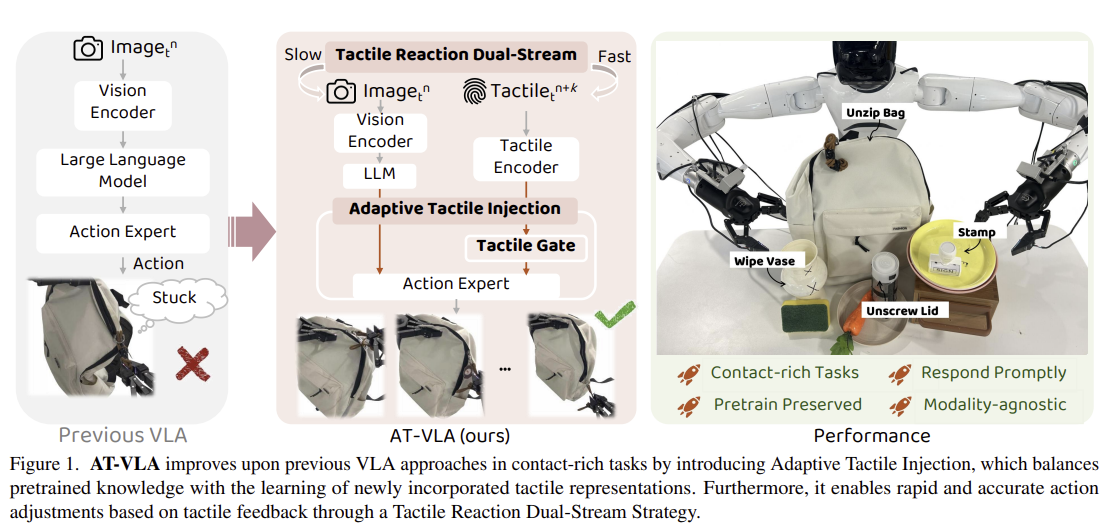
VLA의 VLM은 속도가 느리기 때문에 frequency가 빠른 tactile 정보를 제때에 반영하지 못한다. 또, VLM에 tactile modality을 추가하려고 하면 pretraining 때와 다른 분포가 들어와서 문제가 생길 수 있다.
따라서 본 논문은 tactile 정보를 adaptive하게 injection하는 것을 목표로 한다. Tactile 정보가 정말 필요할 때만 injection을 하여 pretrained 분포와의 차이를 최소화한다. 또, tactile 정보의 특징에 맞게 빠르게 반영시키도록 한다. 이것을 가능하게 하기 위해서 Tactile Reaction Dual-Stream mechanism 을 도입한다. Tactile 신호를 처리하는 stream과 vision-language stream을 분리하여 전자는 빠르게, 후자는 느리게 작동하도록 하였다.
AT-VLA
Framework of AT-VLA
Problem Formulation
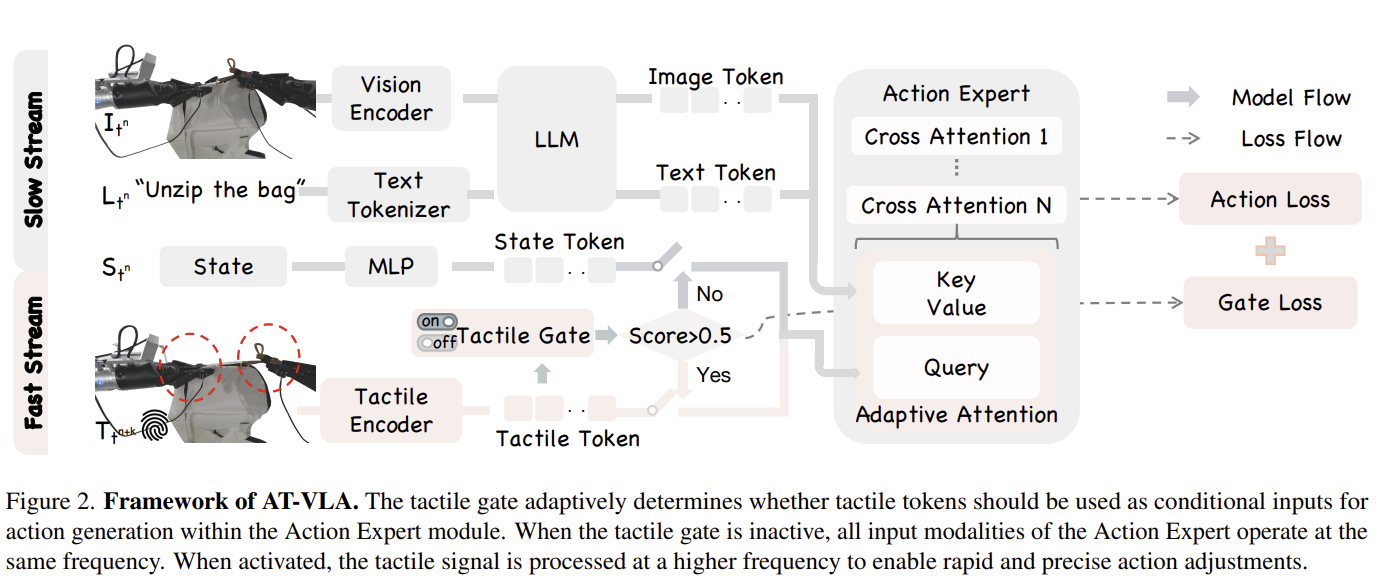
Policy가 Image observation $I =$ {$I_h, I_r, I_l$} (head, right wrist, left wrist) , language instruction L, tactile feedback T, proprioceptive state S을 입력받는다고 하자. 이때 사용하는 tactile feedback으로는 tactile sensor 값으로 추출한 force 값이다.
Policy는 input을 처리해서 action chunk A을 생성한다.
\[A = \pi_{\theta} (I, L, T, S)\]Model Instantiation
AT-VLA의 목표는 기존의 VLA에 최소한의 수정으로 tactile injection을 하는 것이다. 따라서 GO-1을 base VLA으로 설정하고 tactile 정보를 처리할 별도의 tactile encoder을 도입한다.
Adaptive Tactile Injection
Tactile을 바로 사용하도록 했을 때 policy에 생기는 문제를 알아보기 위해서 action expert을 tactile 정보 없이 finetune하는 방법이랑 tactile encoder의 output을 action expert에 condition하여 vision language token들과 같이 처리하도록 finetune하는 방법을 비교해봤다고 한다. 이때, 후자 방법은 attention distribution도 망가지는 것으로 보아 pretrained 지식에 부정적인 영향을 준다고 한다.
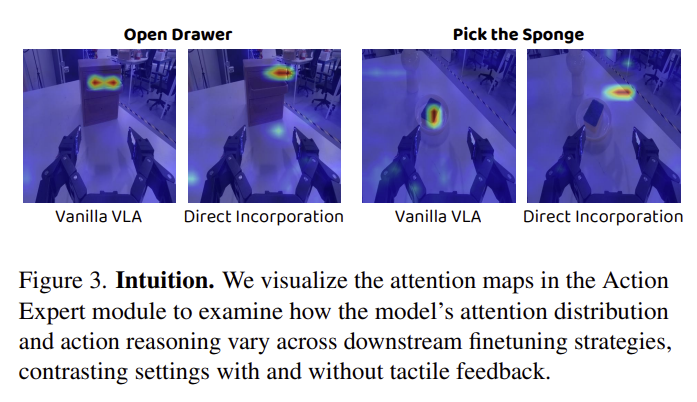
따라서 tactile 정보가 사용될 지점 및 시점을 dynamic하게 gating으로 결정하여 adaptive cross attention을 하도록 하는 것이 중요하다고 주장한다.
Tactile Gating
직관적으로 tactile 정보를 사용해야 할 때는 contact가 존재할 때이다. 따라서 Tactile Gate은 robot이 물체와 contact가 존재할 때를 탐지하여 tactile feedback 사용 여부를 결정해야 한다.
Tactile encoder가 tactile token $z_T$ 을 얻었을 때 Tactile gate은 contact가 존재하는지의 여부를 출력한다. 이때 이 gate을 학습하게 위해서 data의 non-contact frame은 0, contact frame은 1으로 label하였다. (binary cross entropy objective 사용)
Adaptive Cross Attention
Tactile gating을 사용하게 되면 action expert는 tactile gating이 활성화될 때와 안 될 때 모든 상황을 처리할 수 있어야 한다. 이것이 가능하도록 하기 위해 adaptive cross attention을 도입한다.
Tactile gate가 활성화되지 않았을 때는 Cross attention에서 image token $z_I$ 와 language token $z_L$ 이 Key, value가 되고 state token $z_S$ 는 query가 된다. (GO-1에서는 robot state token이 query임) 반면, tactile gate가 활성화 되었을 때는 tactile token $Z_T$가 query가 되어 cross attention을 진행한다. 이 방법을 통해 contact가 존재하지 않을 때는 model input과 architecture에는 변화를 주지 않고 contact가 존재할 때만 tactile feedback을 action generation conditioning으로 사용하는 것이다. 이와 동시에 모델이 처리해야 하는 token 길이를 늘리지 않고 pretrained에서 경험한 길이 그대로 사용하기 때문에 OOD가 나지 않는다.
Effective Tactile Reaction Dual-Stream
Tactile 정보를 사용할 때 고려해야 하는 가장 중요한 정보는 tactile frequency이다. Tactile이 입력되는 주기는 이미지와 다르게 짧기 때문에 전체적인 상황을 이해하면서 tactile에 대해 빠르게 대응하는 방법이 필요하다.
Tactile에 대한 빠른 reaction이 가능하도록 하기 위해 input modality 처리 stream을 두 가지로 나눈다. 하나는 느린 stream으로 vision과 langauge을 처리하는 것, 다른 하나는 빠른 stream으로 tactile feedback을 즉각적으로 처리하는 것이다.
느린 stream이 timestep $t_n$에 처리한 정보는 $t_n:t_{n+H}$ 까지 사용할 수 있다. 따라서 이 정보는 action generation을 H time steps 동안 guide해주는 역할을 한다. 반면 빠른 stream은 다르다. 따라서, 느린 stream의 cache는 H 시간동안 고정하고 action expert는 가장 최근 $t_{n+k, 0<k<H}$ 마다의 tactile feedback을 통해 행동을 다시 생성하여 reactive 하게 만든다.
Training Objectives and Inference Pipeline
모든 학습 objective을 동시에 사용한다.
\[\mathcal{L} = \mathcal{L}_a + \lambda_1 * \mathcal{L}_g\]이때 $\mathcal{L}_a$은 action generation loss, $\mathcal{L}_g$는 gating loss이고 $\lambda_1$ 은 0.01으로 설정하여 loss scaling을 한다.
추론을 할 때 tactile gate가 비활성일 때는 일반적인 VLA와 같고 활성일 때는 tactile과 vision의 asynchronous frequency가 시작된다. 이때, vision 정보가 1번 처리될 때마다 tactile 정보는 3번 처리되게 만들어서 성능과 효율을 balancing 하였다.
Result
-
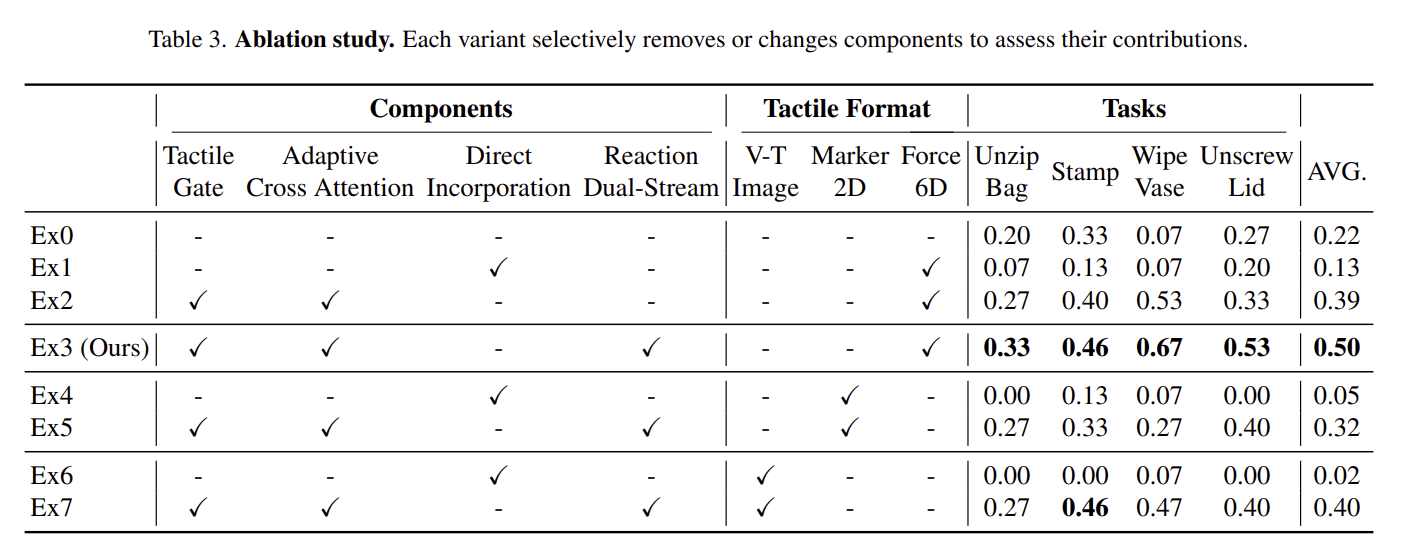
Tactile 정보를 항상 사용하는 것보다 gating과 adaptive cross attention을 적용하는 것이 결과가 훨씬 좋다. 또, 항상 사용하는 것은 아예 사용하지 않는 것보다 성능이 좋지 않았다.
-
Marker 값 / V-T image 을 사용하는 것보다 force 값을 사용하는 것이 좋았다.
-
Two stream 방법론이 action을 아무래도 즉각적으로 refine을 해주는 역할을 해서 성능이 가장 좋게 나온다.