Real-Time Execution of Action Chunking Flow Policies 리뷰
Background
Action chunking은 high frequency control task에 적합하지만 latency 문제가 존재한다. Latency 문제란 한 chunk을 생성한 뒤에 다른 chunk을 생성하기까지의 시간적 gap을 의미한다.
Action policy는 timestep을 t라고 하고 prediction horizon (예측한 action이 사용되는 시간)을 H, 예측한 action chunk을 $A_t$ 라고 정의할 때 $\pi(A_t \mid O_t)$ 으로 정의된다.
이 action policy가 roll out 될 때는 첫 s $\le$ H action이 실행된다. 이때 s를 execution horizon이라고 정의한다.
Execution horizon이 길수록 policy가 새로운 observation에 덜 민감해진다. 반면, 짧으면 jumping, jerky 행동을 보이면서 행동들이 불연속적이게 된다.
이를 flow matching action expert의 측면에서 자세하게 봐보자. Random Gaussian noise $A_t^0$ 에서 시작해서 flow의 velocity field $v_{\pi}$ 가 timestep $\tau = 0 \rightarrow 1$ 으로 가면서 정답 action을 도출하는 방향을 알아낸다.
\[A_t^{\tau+\frac{1}{n}} = A_t^\tau + \frac{1}{n} v^\pi\left(A_t^\tau, o_t, \tau\right)\]이때 n은 denoising step 수이다.
본 논문은 Real time inference 가 가능하도록 하고자 한다. 이론적인 real time inference가 가능하려면 어떤 조건을 만족해야 할까?
$\triangle t$ 을 controller의 sampling period이라고 하고 $\delta$ 을 action chunk 생성에 걸리는 시간이라고 하자. Action policy가 real-time이 되어 action이 끊기지 않고 새로운 observation이 생길 때마다 responsive하게 되기 위해서는 $\delta \le \triangle t$ 을 만족하면 된다. 하지만 이 조건은 VLM의 처리 속도 때문에 VLA가 만족시킬 수 없는 조건이다. 또, mobile manipulation으로 deploy 될 때는 network의 병목으로 더 느려진다.
여기에 추가로 naive하게 synchronous inference에서는 execution horizon이 끝난 뒤에 다음 action chunk을 생성한다. $\delta > \triangle t$ 조건에서는 새로운 action chunk을 생성하기까지의 pause가 execution을 느리게 할 뿐만 아니라 robot의 dynamic까지 바꾸기 때문에 distribution shift가 생길 가능성이 있다. 따라서 real time inference를 최대한 구현하기 위해서는 asynchronous inference가 가능해야 한다.
Asynchronous inference는 이전에 생성한 action 실행이 끝나기 전에 inference을 시작하여 생성된 새로운 action이 이어서 실행되도록 하는 것이다.
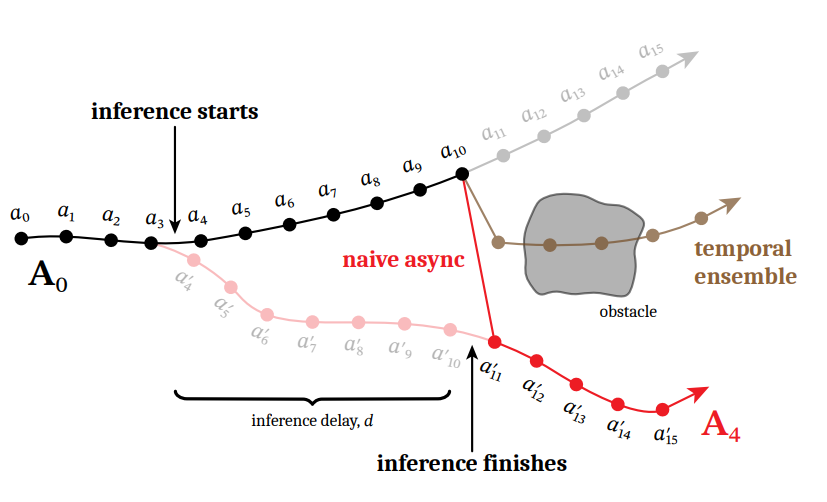
하지만 asynchronous inference을 naive하게 구현했을 때도 문제가 생긴다. d를 policy의 inference에 걸리는 controller timestep $\frac {\delta} {\triangle t}$ ($O_t$ 을 받고 새로운 $A_t$ 가 생성되기 전까지의 controller timesteps)이라고 하자.
$a_{t’ \mid t}$ 을 $o_t$ 기반 action chunk $A_t$ 의 ($t’-t$) 번째 action이라고 하자. $A_0$ 이 실행 중이고 execution horizon이 s라고 할 때 asynchronous inference는 s-d에서 시작해야 한다. 그래야 s에 도달하기 전에 d 시간동안 새로운 action chunk을 만들 수 있기 때문이다.
그렇다면 d $\le H - s$ 을 만족하기만 한다면 execution horizon이 끝나기 전에 새로운 action chunk $A_{s-d}$ 가 생기게 되기에 항상 real time asynchronous inference가 가능하다고 볼 수 있다. 하지만 여기서의 문제는 새로운 action chunk을 생성했을 때의 observation이다. s-d 에서의 observation을 사용해서 만든 action인데 이 action이 실제로 사용되는 시간대는 s이기 때문에 이 action은 s-d와 s 사이에 어떤 일이 일어났는지 모르고 생성된 action이기 때문이다. 이로 인해 naive한 asynchronous inference에서는 $a_{s-1 \mid 0}$ 과 $a_{s \mid s-d}$ 사이에 discontinuity 및 OOD가 발생한다.
Methodology
Real time Chunking via Inpainting
Real time에 적합한 aynchronous inference가 가능하기 위해서는 $s-d$ 에 생성된 new action chunk은 이전 action chunk와 연속적이어야 하며 $s-d$ 에서의 observation이 아니라 새로운 observation을 반영할 수 있어야 한다.
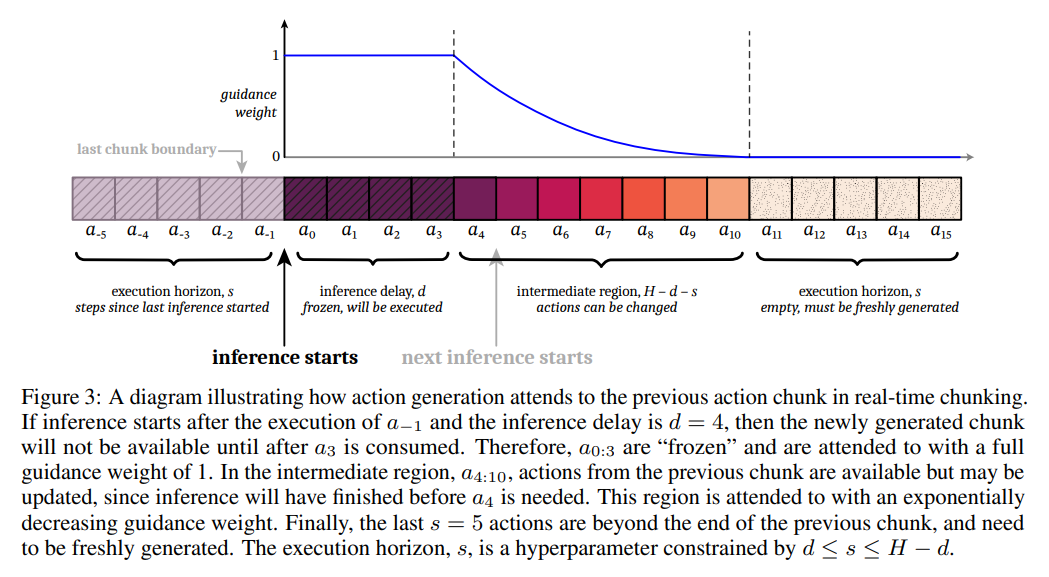
따라서 본 논문은 이 문제를 inpainting 문제라고 정의한다. 새로운 action chunk가 정당하기 위해서는 $A_{s-d}$ 와 $A_0$ 에서 중복되는 timestep을 활용해야 한다. Asynchronous inference는 timestep s-d에서 시작을 한다고 하자. 그럼 timestep s-d 부터 실행해야 할 action $A_{s-d}$ 가 생성이 되는데 이때부터의 $A_{s-d}$ 에서 맨 앞 d timestep 동안의 action은 실행이 불가능하다. 왜냐하면 $A_{s-d}$ 을 inference하는데 걸린 시간 d동안 이미 이전 action chunk가 실행되었을 것이기 때문이다.
즉, 이 중복되는 timestep에서의 action은 new action chunk을 생성할 때 바꿀 수가 없는 action이기 때문에 freeze해도 되는 것이다. (확정인 action)
따라서 걱정해야 하는 것은 $A_{s-d}$ 에서 d timestep 이후의 action이 freeze된 action과 consistent하게만 하면 되는 것이다.
일부 (Freeze된 action)을 통해 나머지를 채워나가는 inpainting과 비슷하다
Inference-Time Inpainting with Flow Matching
그렇다면 freeze된 action을 바탕으로 나머지 action을 생성하기 위해서는 어떻게 해야 할까? 본 논문은 denoising step의 velocity을 수정한다. 그럼 얼만큼 수정할 것인가?
Impainting을 통해서 원하는 결과는 이전 action chunk와 최대한 이어지는 새로운 action chunk이다.
Denoising step에서 policy가 학습한 denoising 방향이 $v(A_{t}^{\tau}, o_t, \tau)$ 라고 할 때, 이 방향으로의 최종 estimated action chunk는 $\hat A_t^1 = A_t^{\tau} + (1-\tau) v(A_t^{\tau}, o_t, \tau)$ 이다.
Y = s-d 시점부터의 이전 action chunk $\hat A_t^1$ = s-d 시점에서 새로 inference한 action chunk
새로운 action chunk와 Y의 차이는 Y - $\hat A_t^1$ 으로 표현할 수 있기 때문에 결국 이 차이는 새로운 action chunk이 이전 action과 이어지도록 하기 위해 수정해야 하는 정도로 이해할 수 있다. 따라서 본 논문은 새로 생성되는 action chunk denoising 과정에서 velocity가 Y와 비슷해지도록 velocity 차원에서 수정한다.
하지만 $\hat A_t^1$ 가 아예 Y가 되도록 하면 안 된다. $\hat A_t^1$ 은 최신의 observation을 바탕으로 생성된 새로운 action이기 때문에 미래 정보는 $\hat A_t^1$ 의 action이 더 뚜렷하다. 본 논문은 이 intuition을 반영하기 위해 mask W을 도입한다. 이 mask W는 이전 action chunk의 얼만큼을 새로운 action chunk에 반영할 것인지를 설정하는 역할을 한다.
\[v_{\Pi\mathrm{GDM}} \left( A_t^\tau,o_t,\tau \right) = v \left( A_t^\tau,o_t,\tau \right) + \min \left( \beta, \frac{1-\tau}{\tau r_\tau^2} \right) \left( Y-\hat{A}_t^{1} \right)^{\top} \operatorname{diag}(W) \frac{\partial \hat{A}_t^{1}} {\partial A_t^\tau}\]이 수식은 weighted reconstruction error으로부터 얻을 수 있다. \(\mathcal{L}_{\mathrm{rec}} = \frac{1}{2} \left( Y-\hat{A}_t^{1} \right)^{\top} \operatorname{diag}(W) \left( Y-\hat{A}_t^{1} \right)\) 이 weighted reconstruction error을 줄이는 방향을 얻기 위해서는 이 error을 $A^{\tau}$ 으로 미분하면 된다. \(\nabla_{A_t^\tau}\mathcal{L}_{\mathrm{rec}} = - \left( Y-\hat{A}_t^{1} \right)^{\top} \operatorname{diag}(W) \frac{\partial \hat{A}_t^{1}} {\partial A_t^\tau}\) 이 방향을 기존의 학습된 velocity에 더함으로써 이전 action chunk와 이어지도록 하는 것이다.
Soft Masking for Improved Cross-Chunk Continuity
W을 어떻게 정의했는지에 따라 성능이 많이 달라졌다고 한다.
이전 action chunk에서 freeze하는 action은 d개인데 이 d가 작을수록 guidance signal이 약해지기 때문에 새로운 action chunk는 여전히 continuity가 만족이 안 될 수 있다.
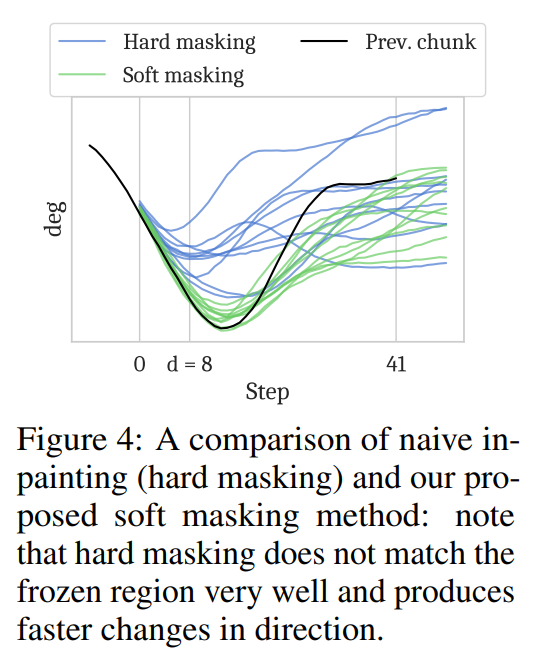
앞 d개의 action만 사용했을 때인 hard masking을 보면 prev action chunk와 discontinuous하다는 것을 볼 수 있다.
따라서 freeze되는 aciton의 수를 d개로만 한정하지 않고 이전 action chunk과 new action chunk에서 겹치는 H-s 개의 action 전체를 freeze하는 방향으로 하였다.
이것을 가능하게 만들기 위해서 soft masking을 구현하였다고 한다. 첫 d개의 action은 1의 weight을 갖도록 하고 뒤로 갈수록 새로운 action chunk에 덜 반영되도록 exponential decaying weight을 갖게 하였다.
\[W_i = \begin{cases} 1, & \text{if } i < d, \\[4pt] c_i \dfrac{e^{c_i}-1}{e-1}, & \text{if } d \le i < H-s, \\[8pt] 0, & \text{if } i \ge H-s, \end{cases}\] \[c_i = \frac{H-s-i}{H-s-d+1}, \qquad i \in \{0,\ldots,H-1\}.\]