Spline Policy: A Structured Representation for Robot Policies 리뷰
Background
Imitation learning은 robot policy 학습의 central paradigm이다. 이 방법을 적용하는 policy model로는 ACT, Diffusion, Flow matching 등이 존재한다. 이때 이 방법을 모두 action chunk으로 행동을 생성하는데 이때 action chunk는 어떻게 보면 “fixed” horizon sequence이다. 즉, 시간 측면에서는 discrete하다. 또, 이렇게 생성된 action chunk는 structured하지 않고 temporal 특징이 없다. 따라서, 연속성, 속도, boundary conditions가 존재하지 않는다.
이와 동시에 motion을 구조적으로 표현하기 위해 motion primitive이라는 표현 방법이 존재한다. Motion primitive는 구조를 표현하는 parameter들을 사용하여 control, 최적화, trajectory editing이 가능하게 만든다.
본 논문은 이를 바탕으로 multimodal behavior learning 및 perception을 잘 처리하는 imitation learning과 구조적으로 motion을 표현할 수 있는 motion primitive의 장점을 모두 가진 policy을 만들어보고자 한 것이다. 이 poliocy를 spline policy라고 한다.
Spline Policy as a Structured Representation
Spline policy는 거창한 것이 아니고 그저 policy의 output 표현 방법만 spline이라는 것으로 바꾼 것이다. Spline은 곡선의 종류로 robot의 end effector가 물체와 상호작용하는 곳 (operational space)에서의 곡선인 것이다.
따라서 backbone의 perception/multimodal 처리 능력은 그대로 사용하면서 output은 continuous한 trajectory로 변경하는 것이다.
그렇다면 spline이 갖는 장점이 무엇일까?
- Spline은 연속적인 trajectory을 적은 geometric parameter (control point) 으로 정의할 수 있다.
- Local editing, 연속성, 속도 가속도 구하기와 같은 operation도 가능하다. 어떻게 보면 operational space에서의 연속적인 함수를 정의하는 것이기에 Hz을 신경쓰지 않아도 된다.
조금 더 수학적으로 이해해보자면 spline이 어떻게 적용되는 것인지 알 수 있다.
일반적인 action policy $\epsilon_{\theta}$ 는 고정된 N개의 action을 출력한다.
\[\epsilon_{\theta} (o) = a_{\text{1:N}}\]이때 o는 multimodal observation이다. 하지만 N개의 고정된 action만 출력하는 것은 단점이 존재한다. 정해진 Hz 단위로 action을 출력하기 때문에 속도/가속도의 직접적인 내재화가 없고, constraint 걸기 어려우며, trajectory 별 editing이 불가능하다.
반면 spline policy는 동일한 backbone $\epsilon_{\theta}$ 을 사용하면서 concatenated 된 spline parameters을 예측하는 것이다. 여러 개의 spline들이 이어붙여져 하나의 긴 trajectory을 생성하는 것이다.
\[\epsilon_{\theta}(o) = w_{\theta} (o)\]예측한 spline parameter들에 spline basis $\phi(t)$ 을 적용하여 continuous한 trajectory $f_{w_\theta(o)}(t)$ 가 나오는 것이다.
\[f_{w_\theta(o)}(t) = \phi(t) w_\theta(o)\]이때 spline basis $\phi(t)$ 라는 것은 시간 t에 따른 spline control point의 중요도를 알려주는 것이고 $f_{w_\theta(o)}(t)$ 는 time t에서 spline basis을 바탕으로 한 decoded된 trajectory이다.
사용하는 spline의 종류에 따라 trajectory의 특징이 달라진다 (smoothness 등등) 본 논문은 piecewise quadratic splines 중 Bernstein representation으로 고정한다.
Bernstein Representation은 어떤 spline segment i에 대해 local phase을 $\tau \in $ [ 0,1 ] 이라고 할 때 전체 spline을 다음과 같이 표현한다.
\[f_{\theta,i}(\tau) = (1-\tau)^2 w_{i}^1 + 2(1-\tau)\tau w_{i}^2 + \tau^2 w_{i}^3 \quad \tau \in [0, 1]\]이때 $w_{n,i}$ 가 control point이다.
이 수식의 구성은 사실 간단하다 $w_{i}^1$ 와 $w_{i}^2$ 간의 linear interpolation을 한번 적용하면 $l_1 = (1 - \tau) w_{i}^1 + \tau w_{i}^2$ $w_{i}^2$ 와 $w_{i}^3$ 간의 linear interpolation을 한번 적용하면 $l_1 = (1 - \tau) w_{i}^2 + \tau w_{i}^3$ 이 두 interpolation을 합치면 $(1-\tau)^2 w_{i}^1 + 2(1-\tau)\tau w_{i}^2 + \tau^2 w_{i}^3$ 이 생긴다
$\tau$ 을 local phase라고 하는 이유는 직관적으로 $\tau = 0$ 일 때는 $f_{\theta,i}(\tau) = w_{i}^1$, $\tau = 1$ 일 때는 $f_{\theta,i}(\tau) = w_{i}^3$, $\tau = \frac{1} {2}$ 일 때는 $f_{\theta,i}(\tau) = \frac{1} {4} w_{i}^1 + \frac{1} {2} w_{i}^2 + \frac{1} {4} w_{i}^3$ 이 되기 때문이다.
Spline Policy Characteristics
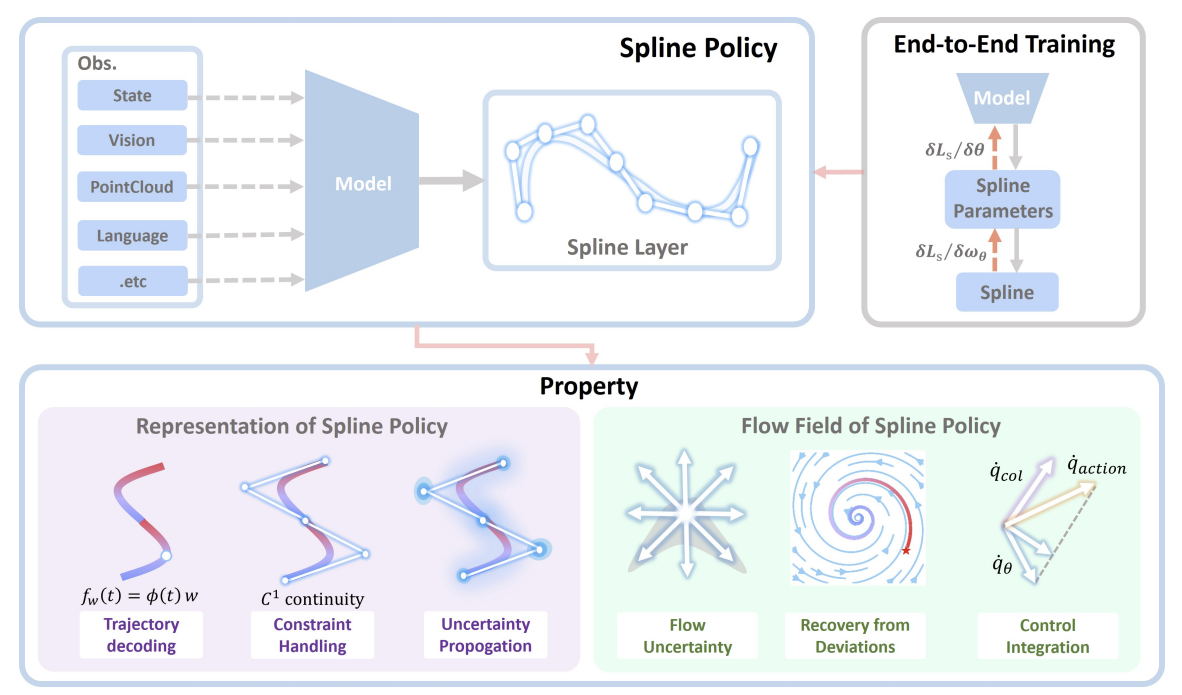
Temporally Flexible Decoding
Spline policy는 이처럼 하나의 연속적인 curve을 형성하는 것이기 때문에 어떤 temporal resolution (Hz) 이든 뽑아서 사용할 수 있다. 즉 학습된 policy와 controller query rate 간의 sync을 따로 맞추지 않아도 되고 동일한 spline parameter에서 coarse planning 등이 가능하게 된다.
또 spline은 $\tau$ 에 대해서 미분이 가능하기 때문에 controller가 필요로 한다면 속도 / 가속도 정보도 제공할 수 있게 된다.
그리고 원하는 smoothness에 맞게 연속성 constraint을 줄 수 있다. 즉, spline으로부터 trajectory을 decoding 할 때 원하는 형태 및 특징을 가지게 할 수 있다는 것이다.
Constraint Handling
Constraint을 줄 때 그저 control points, 즉 action expert가 예측하는 spline parameter level에서 조절할 수 있다.
예를 들어 $c_0$ 연속성을 원할 때 $w_{i}^3$ = $w_{i+1}^1$ 을 만족하도록 contraint을 주면 되고 $c_1$ 연속성을 원할 때는 $\frac{w_{i}^3 - w_{i}^2} {\Delta t_{i}} = \frac{w_{i+1}^3 - w_{i+1}^2} {\Delta t_{i+1}}$ 을 만족하면 된다.
미분 과정을 정리하면 다음과 같다.
\[f_{\theta,i}(\tau) = (1-\tau)^2 w_i^1 + 2(1-\tau)\tau w_i^2 + \tau^2 w_i^3, \quad \tau = \frac{t - t_i}{\Delta t_i}\]
\[\frac{d f_{\theta,i}}{d\tau} = -2(1-\tau)w_i^1 + (2 - 4\tau)w_i^2 + 2\tau w_i^3 = 2(1-\tau)(w_i^2 - w_i^1) + 2\tau(w_i^3 - w_i^2)\]
\[\frac{d f_{\theta,i}}{dt} = \frac{d f_{\theta,i}}{d\tau} \frac{d\tau}{dt} = \frac{1}{\Delta t_i} \left[ 2(1-\tau)(w_i^2 - w_i^1) + 2\tau(w_i^3 - w_i^2) \right]\]
\[\left. \frac{d f_{\theta,i}}{dt} \right\vert{}_{\tau=1} = \frac{2(w_i^3 - w_i^2)}{\Delta t_i}\]
\[\left. \frac{d f_{\theta,i+1}}{dt} \right\vert{}_{\tau=0} = \frac{2(w_{i+1}^2 - w_{i+1}^1)}{\Delta t_{i+1}}\]
\[\left. \frac{d f_{\theta,i}}{dt} \right\vert{}_{\tau=1} = \left. \frac{d f_{\theta,i+1}}{dt} \right\vert{}_{\tau=0}\]
\[\frac{2(w_i^3 - w_i^2)}{\Delta t_i} = \frac{2(w_{i+1}^2 - w_{i+1}^1)}{\Delta t_{i+1}}\]
\[\frac{w_i^3 - w_i^2}{\Delta t_i} = \frac{w_{i+1}^2 - w_{i+1}^1}{\Delta t_{i+1}}\]
더 신기한 특징은 safety / constrained 된 policy가 보장된다는 것이다. 수학적으로 policy가 예측한 몇 개의 control point에만 제약을 걸면 control point들을 잇는 모든 trajecory가 안전 (under contraint) 하게 된다.
Bernstein representation의 spline basis $\phi(t)$ 의 값만 보면 $(1-\tau)^2, 2(\tau - \tau^2), \tau^2$ 이다. 즉, $\tau \in $ [0,1) 에서 spline basis의 값들은 항상 양수이고 모두 1보다 작다. 또, 이들의 합은 항상 1이다. 따라서 이 세 control points가 이루는 삼각형 안 (convex hull) 에는 무조건 spline trajectory가 존재하게 된다. 여기에 더해서 control points가 convex set $C_i$ 에 존재하게 constraint을 두면 전체 spline 자체 또한 $C_i$ 에 존재하게 된다. ex) Convex set: [0,10] 으로 정의했을 때 $w_i = 2,5,3$ 이고 spline basis가 0.2, 0.5, 0.3이라고 할 때 위치는 무조건 5.3이다. 즉 무조건 convex set 안에 존재하게 된다
또 derivative $\frac{d f_{\theta,i}}{d\tau} = -2(1-\tau)w_i^1 + (2 - 4\tau)w_i^2 + 2\tau w_i^3 = 2(1-\tau)(w_i^2 - w_i^1) + 2\tau(w_i^3 - w_i^2)$ 이므로 control point의 차이만으로 velocity에 constraint을 적용할 수 있다.
쉽게 설명하면 control point에 걸리는 constraint는 spline trajectory에 동일한 contraint을 거는 것과 동일하다.
Uncertainty Propagation
Action policy는 observation o을 바탕으로 예측을 하기 때문에 observation noise으로부터 직접적인 영향을 받는다. Spline policy도 똑같다. Spline parameter들도 결국 $w_{\theta} (o)$ 로 얻어지기 때문이다.
Observation noise을 Gaussian noise이라고 가정하자. 그렇다면 spline parameter의 분포를 표현하면 다음과 같다.
\[w_\theta(o) \sim \mathcal{N}(\mu_w, \Sigma_w)\]$\mu_w$ 은 spline parameter의 평균, $\Sigma_w$ 은 spline parameter의 분산이므로 $\Sigma_w$ 가 높을수록 noise의 정도 / 불확실성의 정도가 높다는 것을 의미한다.
Spline trajectory도 결국 spline parameter의 linear projection (spline basis에 의한 projection) 이기 때문에 spline trajectory도 Gaussian 분포로 표현될 수 있다.
\[f_{w_\theta(o)}(t) \sim \mathcal{N}\left(\phi(t)\mu_w, \phi(t)\Sigma_w\phi(t)^\top\right)\]이때 spline trajectory의 분산, 즉 trajectory의 불확실한 정도를 바탕으로 trajectory의 구간별 불확실성 정보를 얻을 수 있고 이 값이 높다면 구간별 추가적인 observation, 속도 감소, replanning을 도입할 수 있다.
Policy Integration
그럼 spline policy가 어떻게 기존 policy들에 적용될 수 있을까?
Policy 자체의 구조가 바뀌는 것이 아니라 Output head, prediction head, decoding layer만 바뀌어서 spline parameter만 예측하도록 하는 것이기 때문에 아무 영향 없이 적용이 가능하다고 주장한다. 즉, output interface만 바꾸는 것이다.
학습 과정을 자세히 보면
\[\mathcal{L}_s = \frac{1}{N} \sum_{i=1}^{N} \left\| f_{w_\theta(o)}(t_i) - f_d(t_i) \right\|^2\]Data에 정답 spline parameter가 없더라도 학습이 가능하다. 왜냐하면 spline parameter로 얻은 trajectory로 기존 objective의 predicted action chunk을 대체하면 되기 때문이다.
\[\frac{\partial \mathcal{L}_s}{\partial \theta} = \frac{\partial \mathcal{L}_s}{\partial f_{w_\theta(o)}} \frac{\partial f_{w_\theta(o)}}{\partial w_\theta(o)} \frac{\partial w_\theta(o)}{\partial \theta}\]
첫 번째 부분은 spline trajectory와 실제 trajectory의 gradient, 두 번재는 spline parameter 변화로 인한 trajectory 변화, 세 번째는 neural network $\theta$ 가 spline parameter을 잘 맞추도록 하는 gradient이다.
Flow Field Realization
Spline을 사용함으로써 얻을 수 있는 다른 특징은 closed loop execution을 위한 spatial flow field을 형성할 수 있다는 것이다. Flow field 관점에서는 spline trajectory을 시간에 대한 경로로 보는 것이 아니라 robot의 operational space (state space) 상에 놓인 하나의 geometric object / 경로라고 본다.
이때 이 object에 distnace field을 구축하면 robot state가 원래 예측한 spline trajectory와 어긋나더라도 closed loop으로 어긋난 것을 고칠 수 있게 된다. 이게 왜 가능하나면 직관적으로 spline trajectory을 하나의 geometric object으로 보기 때문에 어긋난 robot state을 이 trajectory에 투영 (projection) 시키면 된다는 것이다.
더 수학적으로 얘기하면 $f_{\theta}$ 을 spline policy가 예측한 spline trajectory라고 했을 때 $P_{f_\theta}(x)$ 을 query robot state x을 예측한 spline trajectory으로 투영해준다고 하자.
그럼 현재 query robot state x가 주어졌을 때 $P_{f_\theta}(x) = (t_{\theta}(x), x_{\text{proj}})$ 을 얻을 수 있다.
$t_{\theta}(x)$ 은 x로부터 가장 가까운 spline point가 spline의 어느 phase에 있는지, $x_{\text{proj}}$ 은 spline trajectory에서의 실제 위치를 의미한다.
이 projection을 수학적으로 표현하면 $x_{\text{proj}}$ 으로부터 x까지의 거리는 $x - x_{\text{proj}}$ 이므로 $x_{\text{proj}}$ 에서 x로 가는 단위 방향 벡터는 $n_\theta(x) = \frac{x - x_{\text{proj}}}{|x - x_{\text{proj}}|}$ 이다.
이 projection으로부터 flow field을 정의할 수 있다. Flow field $F_{\theta}(x)$ 는 spline의 진행 방향 (progression) 과 spline으로부터 끌어들이는 attraction 방향의 합이다.
\[F_{\theta}(x) = v_{\text{attr}}(x) + v_{\text{prog}}(x)\]이때 $v_{\text{att}}(x) = \alpha(x) n_\theta(x), \quad v_{\text{prog}}(x) = \beta(x) \dot{f}_\theta(x)$ 으로 정의된다.
$\alpha(x) \le 0$ 인데 그 이유는 $n_\theta(x)$ 가 $x_{\text{proj}}$ 에서 x으로 가는 방향이기 때문이다. 근데 그냥 식 이뻐보이려고 이렇게 정의한 것 같다.
$\alpha (x)$ 는 단순한 상수가 아니라 x에 대해서 변하는 함수라는 것을 알 수 있는데 이는 현재 robot state x가 예측된 spline trajectory으로부터 멀수록 크기가 커져서 더 많은 attraction이 생기게 하는 relative coefficient이기 때문이다.
Local Correction and Perturbation Recovery
Flow field realization의 핵심은 내 생각에는 state dependent correction이 가능하다는 것이다. 이건 기존의 action policy가 하지 못하는 것이다. 예를 들어 pick and place을 할 때 grasp을 하지 않았음에도 place을 하러 가는 행동을 보일 때가 존재한다. 하지만 내 생각에는 flow field을 사용하면 state을 predicted curve geometry (state space에서의 trajectory)로 이끌어주기 때문에 이 spline이 무엇을 예측할지, 무엇을 나타낼 지 잘 정의한다면 이런 문제가 발생하지 않을 것이라고 생각한다.
하지만 논문에서도 강조하는 것은 spline을 처음부터 잘못 예측했을 경우, 그 spline을 수정할 수 있게 해주는 것은 아니라는 것이다.
Uncertainty Propagation in Flow Field
Flow field realization에서도 observation의 불확실성을 토대로 flow field의 불확실성을 알아낼 수 있다. 이때 Flow field $F_{\theta}(x)$ 은 normal direction, tangential progession의 합으로 인해 observation으로부터 linear한 transformation이 아니기에 Monte Carlo Sampling으로 flow field의 분포를 예측해야 한다.
Monte Carlo Sampling이란 불확실한 분포로부터 여러 sample을 뽑아내서 분포를 직접 구하는 방법이다. Observation 분포가 불확실하다고 가정을 함으로 이 방법론을 적용할 수 있다. Observation 분포로부터 여러 samples ${o^{(m)}}{m=1}^M$ 을 뽑아서 spline parameters $w\theta(o^{(m)})$ 와 decoded splines $f_\theta^{(m)}$ 을 얻었다고 하자. 각 sample된 spline으로 flow field을 얻는다고 할 때 그럼 flow field의 분포는 다음처럼 된다.
\[\mu_F(x) = \frac{1}{M} \sum_{m=1}^M F_\theta^{(m)}(x)\] \[\Sigma_F(x) = \frac{1}{M} \sum_{m=1}^M \left( F_\theta^{(m)}(x) - \mu_F(x) \right)\left( F_\theta^{(m)}(x) - \mu_F(x) \right)^\top\]이로부터 observation uncertainty가 추론된 dynamics에 얼마나 영향을 주는지 수치로 표현할 수 있게 된다.
Integration with Robot Control
Flow field realization은 spline output을 time indexed trajectory에서 state dependent vector field로 바꾸기 때문에 학습된 행동이 obstacle avoidance/task constraint 가 존재하는 closed loop에서 더 suitable 해진다.
그렇다면 state space (operational space)에서 collision avoidance 능력을 어떻게 실제 robot controller의 joint space으로 옮길 수 있을까?
우리가 아는건 state space (operational space)에서의 query x가 주어졌을 때 task을 수행하기 위해 가야할 방향/속도가 $F_{\theta}(x)$ 라는 것만 안다. 하지만 우리는 joint space에서의 방향을 알아야 하기 때문에 이 두 space 간의 transformation을 알아야 한다.
Robot joint space (configuration space)을 q라고 하고 $x = \psi(q)$ 을 operational space에서의 task variable이라고 하고 $\mathbf{J}_{\psi}$ 을 q을 얼만큼 움직였을 때 end effector 위치 x가 얼만큼 움직이는지를 mapping 해주는 행렬이라고 하면 다음 식이 만족한다.
\[\dot{x} = \mathbf{J}_{\psi} (q) \dot{ q}\]이때 spline policy가 실제로 예측하는 것은 end effector의 움직임 $\dot{x}$ 이기에 실제 deploy 되기 위해서는 $\dot{ q}$ 로 변환되어야 한다. 따라서 이 Jacobian의 inverse가 필요하기에 operational space을 configuration space으로 mapping 해주는 $\mathbf{J}_\psi^\dagger$ : Moore Penrose pseudo inverse을 사용한다.
따라서 최종 configuration-space velocity는 다음 식으로 얻을 수 있다.
\[\mathbf{\dot{q}}_\theta = \mathbf{J}_\psi^\dagger(\mathbf{q}) \mathbf{F}_\theta(\boldsymbol{\psi}(\mathbf{q}))\]Jacobian에 inverse을 바로 적용하지 못하는 이유은 robot joint space의 차원과 end effector의 state space 차원이 다르기에 pseudo Inverse을 사용하는 것이다.
이때 특히 Moore Penrose pseudo inverse는 해가 여러개일 때 joint 움직임이 가장 작은 해를 선택하게 해주는 특징을 갖고 있다.
이때 이 $\mathbf{\dot{q}}\theta$ 는 $F{\theta}$ 을 joint space에 mapping 한 것이다. 하지만 Flow field realization을 적용했을 때 더 좋은 점은 closed loop으로 collision avoidance가 되도록 할 수 있으며 이 collision avoidance을 우선순위에 둘 수 있다는 것이다.
$\Gamma_{\text{SDF}}(x, q)$ 을 robot과 방해물 간의 signed 거리라고 할 때 q에 따른 avoidance velocity는 다음과 같이 정의된다.
\[\dot{q}_{\text{col}} = \rho(x, q) \nabla_q \Gamma_{\text{SDF}}(x, q)^\top\]$\rho(x, q)$ 는 repulsive motion을 활성화/scaling 하는 정도로 장애물과 멀면 0이 된다고 생각하면 된다.
$\nabla_q \Gamma_{\text{SDF}}(x, q)^\top$ 는 q가 어디로 움직여야 장애물과의 거리가 빨리 증감하는지 / 장애물에서 가장 빠르게 멀어지는 joint 방향을 의미한다고 생각하면 된다.
이 avoidance velocity에 우선순위를 주고싶다면 avoidance $\rho(x, q)$ 가 active일 때, 즉 $\rho(x, q)$ > 0 일 때 $\mathbf{\dot{q}}\theta$ 에서 $\dot{q}{\text{col}}$ 에 반대되는 $\mathbf{\dot{q}}\theta$ 을 없애기만 하면 되는 것이다. 그러기 위해서 본 논문은 null space projection을 사용한다. $\nabla_q \Gamma{\text{SDF}}(x, q)$ 으로 Null space projection을 $\mathbf{\dot{q}}_\theta$ 에 적용하면 collision을 막기 위한 방향과 flow field 자체의 방향과 상쇄가 안 되고 collision avoidance 방향이 우선순위가 된다.
\[\dot{q}_{\theta,\text{proj}} = \left( I - \nabla_q \Gamma_{\text{SDF}}^\dagger \nabla_q \Gamma_{\text{SDF}} \right) \dot{q}_\theta\]최종 action 방향은 다음과 같이 정의된다.
\[\dot{q}_{\text{action}} = \dot{q}_{\text{col}} + \dot{q}_{\theta,\text{proj}}\]