Training Strategies for Efficient Embodied Reasoning 리뷰
Background
VLA의 generalization 능력을 높이기 위해서 LLM처럼 CoT reasoning을 추가한다.
CoT의 원리는 model이 최종 답을 예측하는 것보다 쉬운 중간 과정을 예측하도록 해서 model의 성능을 높이는 것이다. 이 방법은 특히 Language model의 수학 해결 능력을 향상시키는데 큰 도움을 준다.
하지만 학습 데이터에 CoT label을 직접 추가해야 해서 cost가 높고 모델이 추론을 할 때도 thought을 생성하면서 추론을 해야 하기 때문에 실제로 사용될 때는 너무 느려진다는 단점이 존재한다.
또 CoT가 왜 VQA나 robotics에 유용한지 원인을 알려주는 연구가 없다.
본 논문은 그래서 왜 CoT reasoning data로 학습시키는 것이 generalization 능력을 높이는지를 알아보고 이 실험 결과를 통해서 cost가 낮으며 단점이 완화된 CoT 학습 방법 ECoT-Lite 을 소개한다.
Embodied chain-of-thought reasoning
Robotics의 CoT에서 사용하는 중간 과정 (reasoning)의 예시로는 goal을 나눈 subtask들, robot goal/motion 정보가 들어간 representation, 또는 task와 관련있는 정보를 생성하는것 (object bounding boxes, semantic keypoints)이 있다.
본 논문은 이런 reasoning을 하도록 VLA을 학습시키는 것은 결국 represenation learning과 동일하다고 본다.
예를 들어 base model을 egocentric/embodied data로 pretraining 했을 때 이 representation들이 low level control에 더 적합해진다는 연구가 있다.
그리고 이런 reasoning 중에서 본 논문은 Embodied Chain of Thought Reasoning (ECoT) = 최종 action을 생성하기 전에 reasoning text을 생성하도록 하는 것 의 효과에 집중한다고 한다.
이런 reasoning text는 다음 그림처럼 subgoal image, object bounding boxes, sub actions을 text으로 표현한 것이다.
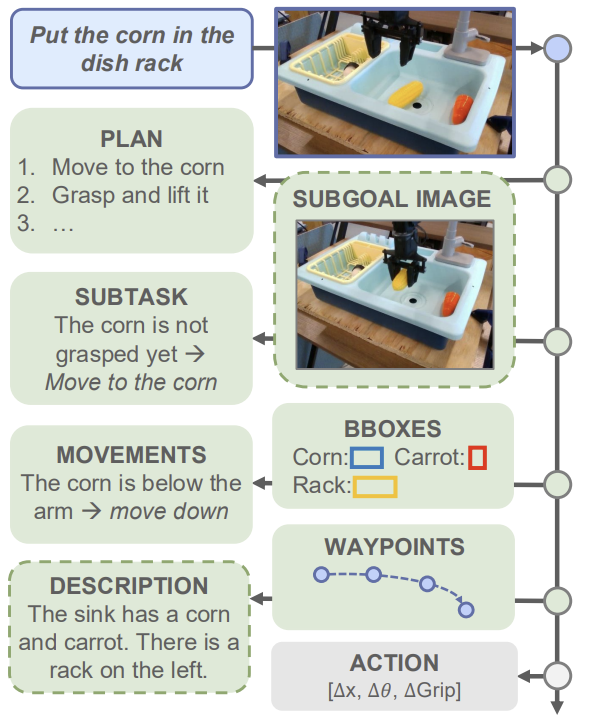
Reasoning text으로 학습을 할 때 우선 action trajectory 별로 reasoning label이 필요하다. 또, 학습을 할 때 reasoning text는 각 reasoning step의 action token들이 prepend되어 [ $r_1,r_2, … ,r_m,a_1,a_2,…,a_n$ ] 가 되고 VLM의 pretraining처럼 next token prediction objective으로 학습된다. 그럼 inference 때도 observation을 바탕으로 reasoning text을 decoding 한 뒤에 action token들을 decoding 해야 하기 때문에 speed도 느려진다. 이런 문제를 본 논문은 집중한다는 것이다.
Why Does Embodied Chain-of-Thought Reasoning Improve Performance?
아무튼 그럼 Embodied CoT Reasoning이 performance을 왜 높여주는 것일까?
이런 이유에 대한 가설로는 3개가 존재한다.
-
Hypothesis 1: Embodied reasoning improves representation learning
첫 번째 가설은 Model이 additional 정보인 reasoning 까지 학습하도록 하는 것이 model의 representation의 quality를 향상시킨다는 것이다.
이 가설이 맞다면, 이미 학습했을 때 model의 represenation이 reasoning 정보까지 capture 했을 것이기 때문에 추론할 때는 이런 reasoning을 생성할 필요가 없게 된다. 이 represenation을 추가 text 생성 없이 action expert에 직접 전달해도 action expert는 reasoning 정보까지 capture된 context을 받기 때문이다.
-
Hypothesis 2: Embodied reasoning provides learning curriculum
두 번째 가설은 model이 reasoning까지 학습하도록 하는 과정은 어떻게 보면 curriculum learning처럼 처음에는 observation을 바탕으로 직관적인 / 쉬운 reasoning task을 먼저 학습하도록 한 다음에 observation을 바탕으로 최종 action까지 학습하게 하는 것으로 볼 수 있다는 것이다. 즉, 이 과정이 모델이 먼저 observation에서 useful한 feature을 얻는 방법을 알게 한 다음에 image -> action을 할 수 있게 하는 과정이라는 것이다. 이를 통해서 model이 image to action mapping을 더 general하게 잘할 수 있다고 보는 것이다.
이 가설이 맞다면 이미 model이 image -> action을 잘 하게 된 것이므로 굳이 inference 때도 reasoning을 생성하는 과정을 거치지 않아도 된다는 것이다.
-
Hypothesis 3: Embodied reasoning increases effective model expressivity
세 번째 가설은 reasoning을 추가함으로써 VLA가 처리하는 sequence of tokens가 길어짐으로 학습과 추론을 할 때 더 연산을 많이 하게 되고 이를 통해 자연스럽게 모델의 expressiveness가 높아진다는 것이다.
이 가설은 language / vision-language model에서 추가 정보 없이 그저 처리해야 하는 token의 수를 늘리면 성능이 더 좋아진다고 하는 일부 연구들과 align된다.
이 가설이 맞다면 extensive reasoning annotation이나 처리를 하지 않고 추가적인 token들만 추가해서 학습시키는 것이 VLA domain에서도 유효할 것이다.
ECoT-Lite: Practical Training Recipes for Embodied Reasoning Policies
본 논문은 위 가설들을 검증하기 위해 VLA을 위한 간단한 embodied CoT 학습 방법을 제시한다. 이 방법을 ECoT-Lite라고 정의하며 기존의 ECoT 방법들의 generalization 능력을 최대한 유지시키면서 cost가 높은 annotation 과정이나 high latency inference와 같이 단점을 없애는 방법이라고 이해하면 된다.

Reasoning pre- or co-training
Hypothesis 1로부터 도출된 ECoT Lite는 VLA을 reasoning data에 대해 pre/co training 시켜서 policy의 represenation의 quality을 높이는 방법이다.
Pretraining 때는 VLM이 우선 reasoning만 예측하도록 학습한 다음에 action만 예측하도록 학습하도록 하는 방법이다. Co-Training은 VLM의 학습 데이터의 절반은 reasoning만, 나머지는 action만으로 구성한 다음에 동시에 학습시키는 것이다.
그리고 추론할 때는 pretrained와 co-trained policy는 일반적인 VLA처럼 별도의 reasoning을 시키지 않게 하여 low latency을 갖게 한다.
Test-time reasoning dropout
Hypothesis 1으로부터 도출된 다른 ECoT Lite는 학습할 때 일반 ECoT처럼 reasoning 정보를 예측하면서 action까지 예측하도록 하는 것이다. 이때 다른 점은 일부 data에 대해서만 reasoning 정보가 없도록 dropout을 적용한다는 것이다.
이를 통해서 pre/co-training처럼 inference time 때 reasoning 예측을 안 하게 하면서 (dropout 데이터로 인해 가능) 학습할 때는 reasoning까지 사용하도록 하여 representation의 quality을 높이도록 한다.
Reasoning “scaffolding”
Hypothesis 2로부터 도출된 ECot Lite 방법은 reasoning이 제공하는 중간 정보가 어려운 observation→action 학습을 쉽게 만들어주는가를 검증하기 위해서다.
Curriculum 쉬운 문제 = (Observation, Reasoning) $rightarrow$ Action 어려운 문제 = (Observation) $rightarrow$ Action
따라서 이 ECoT Lite 방법은 reasoning을 제공하되 reasoning 자체는 예측하지 않게 해서 reasoning이 주는 정보가 정말로 action을 잘 예측하도록 하는 것인지 확인한다. 이때도 일부 data에는 dropout을 사용해서 직접적인 observation to action mapping이 가능하도록 하였다. 이를 통해서 실제 inference 때도 low latency가 가능하도록 한 것이다.
Thinking Tokens
Hypothesis 3로부터 도출된 ECoT Lite 방법은 실제 reasoning annotation 없이 비어있는 추가 “thinking” token들을 prepend해서 더 긴 sequence token들을 학습/추론할 때 처리하게 해서 expressiveness을 높이는 것이다.
Experiments
본 논문은 실험을 통해 다음 세 질문에 대해서 답을 구하려고 한다.
-
ECoT-Lite를 일반 VLA와 ECoT와 비교했을 때 성능이 어떻게 달라지는가?
-
세 Hypothesis 중에서 어떤게 가장 적절할까? 그리고 가장 적절한 hypothesis을 바탕으로 Embodied reasoning이 왜 policy generalization 성능을 높여줄까?
-
어떤 상황에서 어떤 embodied reasoning strategy을 사용해야 할까?
ECoT-Lite Enables Generalizable Policies with Fast Inference
LIBERO 90에 대해서 평가를 했을 때 다음 결과를 보인다.
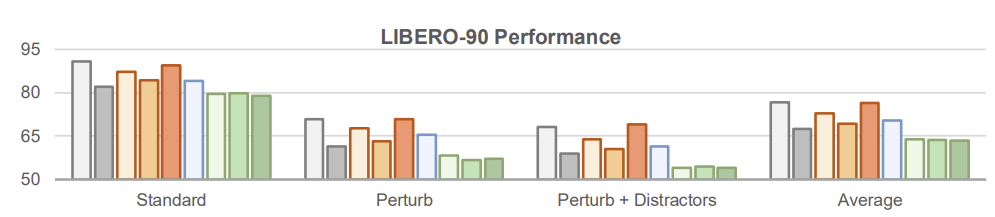
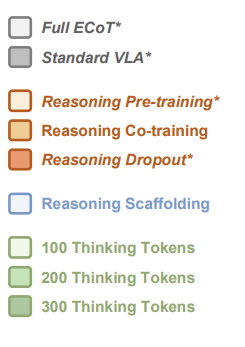
ECoT가 가장 좋고 그 다음으로는 Reasoning dropout, 그 다음으로는 Reasoning Pretraining policy가 가장 좋게 나온다.
Bridge에서도 평가했을 때도 Reasoning dropout과 reasoning pretraining policy 둘다 ECoT-Lite 중에서는 가장 좋은 성능을 보인다. 하지만 이 데이터셋에서는 Reasoniong dropout가 효과적이지 않았다.
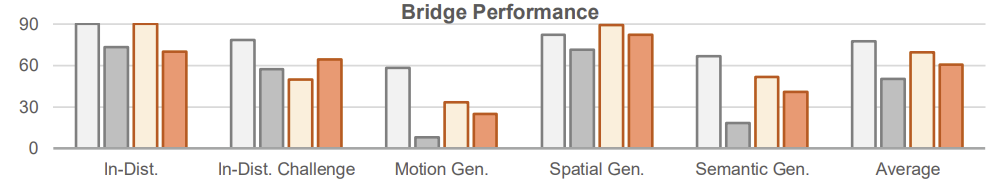
**이때 두 방법 모두 일반 ECoT보다 성능이 낮지만 속도가 3배 더 빠르다고 한다. **
Hypothesis 1: Representation Learning Results
Hypothesis 1 기반 ECoT-Lite 방법론들은 모두 non reasoning VLA보다 성능이 다 좋게 나온다. 이 결과로부터 reasoning data에 대해서 학습을 하는 것이 일반 action prediction보다는 성능이 더 좋아질 것이라고 볼 수 있다.
이떄, pre/co-training 방법론들을 비교했을 때 reasoning co-training은 +1.9% 향상만 있지만 reasoning pre-training은 +5.4%만큼 성능 향상을 야기하였다.
그렇다면 왜 pretraining이 baseline보다 결과가 좋을까?
Reasoning에 대해 pre-training 하는 것이 결국 model의 represenation이 reasoning features을 capture하도록 하기 때문이다. 이 pretraining 과정에서 model은 context으로부터 action을 얻기 위한 중요한 reasoning features을 뽑아내는 학습을 하기 때문에 순수한 pretraining보다는 더 rich한 representation을 얻을 수밖에 없다.
그렇다면 왜 pretraining이 co-training보다 결과가 좋을까?
Co-training도 학습을 하면서 reasoning을 생성하기 때문에 이 방법에서도 representation이 rich해질 것이다. 하지만 co-training은 context -> action mapping과 context -> reason -> action mapping을 동시에 하기 때문에 이미 reasoning features을 뽑기 전에 성능이 좋지 않은 context -> action mapping을 이미 학습했을 것이다. 따라서 context -> reason mapping을 먼저 배우고 context -> reason -> action mapping 을 학습하는 pre-training보다는 더러운(?) mapping을 학습하기 때문에 Co-training이 성능이 더 좋지 않다는 것이다.
Test time 때 Reasoning은 그럼 생성하지 않아도 되는걸까?
가장 성능이 좋았던 Dropout policy는 LIBERO 90에 대해서 reasoning을 test time 때 생성하지 않아도 결과가 좋았다. 하지만 Bridge에 대해서 평가했을 때는 그렇지 않았다. 왜 그랬을까?
$\rightarrow$ 왜냐하면 Libero 90은 reasoning, 즉 전환 시점이 너무 단순하기 때문이다. 또, environment의 종류도 다양하지 않다. 따라서 학습을 하면서 어떻게 보면 reasoning 정보가 memorize된 경향이 존재했을 것이라고 주장한다.
Bridge는 environment가 너무 다양하기 때문에 reasoning 정보가 memorize 되지 않았다.
그래서 본 논문은 inference 때 dropout policy로 reasoning까지 출력하도록 하여 성능을 비교해보았다.
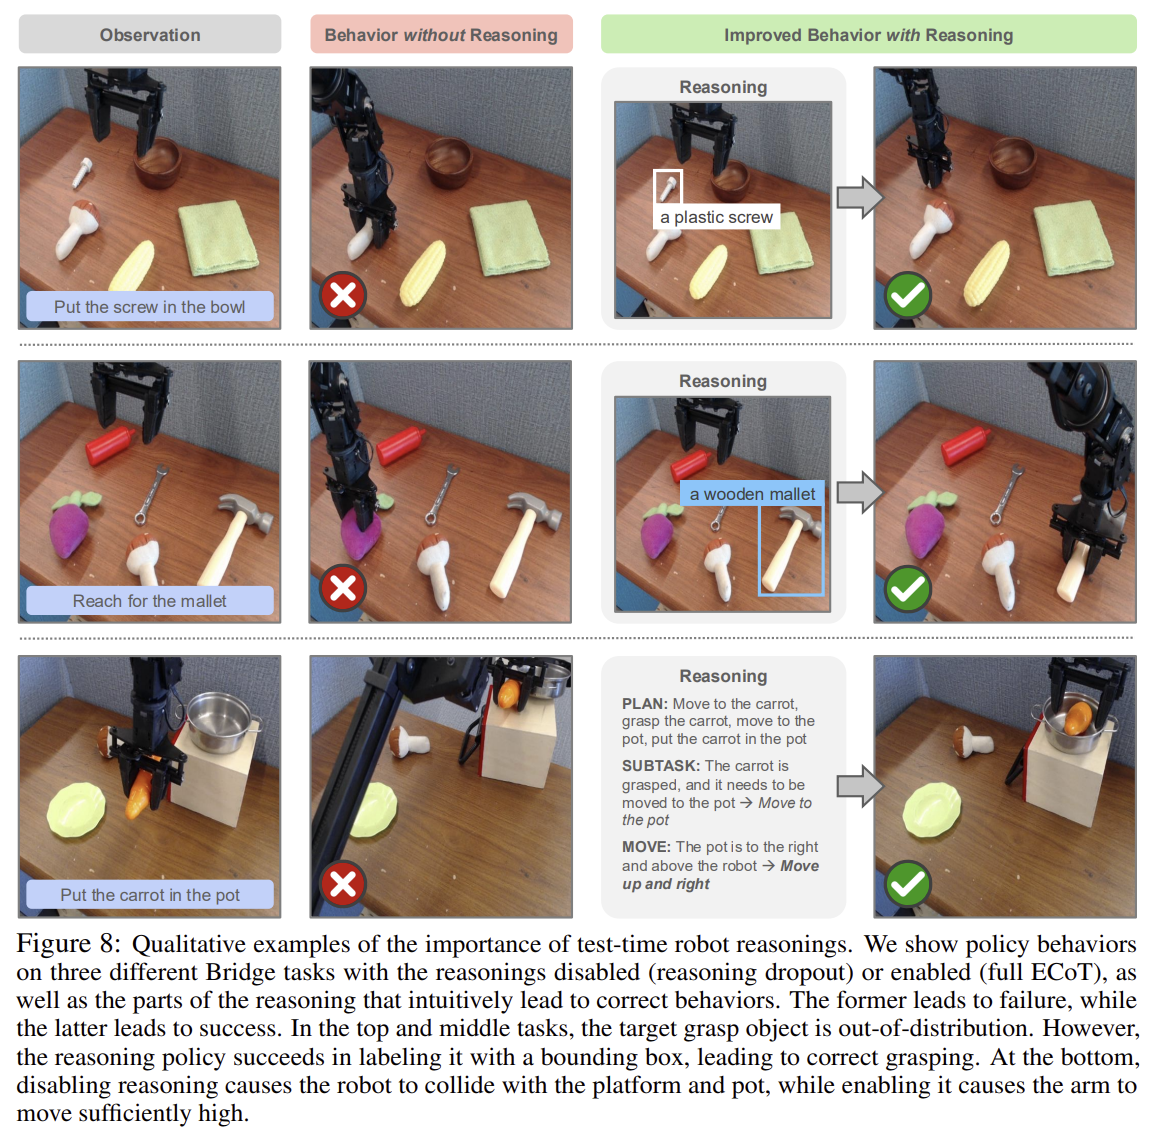
그 결과 reasoning을 출력했을 때 성능이 훨씬 좋아졌다. Dropout policy가 보통 실패를 하는 이유가 적절하지 않은 object을 집거나 다른 물체들과 충돌했을 때인데 reasoning을 통해서 더 자세한 정보를 받게 되었을 때는 이런 문제가 생기지 않았다.
Hypothesis 2: Learning Curriculum Results
Hypothesis 2을 바탕으로 한 ECoT-Lite 방법은 baseline보다 +2.9% 성능 향상을 보여준다.
Reasoning을 context 정보로 주어서 observation -> action mapping 학습을 쉽게 해준 다음에 observation -> action mapping 학습을 하는 것이 성능 향상을 야기했다는 점에서 hypothesis 2을 어느정도 지지한다고 볼 수 있다.
Hypothesis 3: Improved Expressivity Results
단순히 token length을 늘려서 VLM represenation의 expressivity을 늘리는 방법은 baseline보다 오히려 3.8% 낮은 성능 저하를 야기하였다. 즉, Language model 연구와는 다른 양상을 보였다.
이 뜻은 robot reasoning은 policy의 expressivity와는 큰 관련이 없고 semantic하게 유의미한 reasoning steps을 학습하고 context로부터 뽑아내는 것에 있다고 볼 수 있다.
Which Robot Reasoning Approach is Best for My Problem?
Full ECoT
- 성능은 가장 좋음
- 하지만 inference가 가장 느림
- reasoning text를 매번 생성해야 해서 control frequency가 낮아짐
- 따라서 최고 성능이 가장 중요하고 latency를 감수할 수 있을 때 적합
Reasoning Dropout
- inference에서는 일반 VLA처럼 바로 observation → action 가능해서 빠름
- LIBERO처럼 비교적 좁고 반복적인 task domain에서는 full ECoT와 거의 같은 성능
- 필요하면 test-time에 reasoning을 다시 켤 수도 있음
- 단점은 학습 방식이 ECoT와 거의 같아서 학습 자원/메모리 요구량도 비슷함
- 따라서 좁은 task domain이나, test-time reasoning을 선택적으로 켜고 싶을 때 적합
Reasoning Pre-training
- Bridge처럼 task와 환경이 더 다양한 domain에서는 reasoning dropout보다 대체로 더 좋았음
- 먼저 reasoning prediction을 학습하고, 그다음 action prediction을 학습하기 때문에 training step이 더 많이 필요함
- 대신 reasoning과 action이 반드시 같은 데이터에 paired되어 있을 필요가 없음
- reasoning과 action을 한 context 안에서 같이 넣지 않기 때문에 training datapoint당 메모리 사용량도 더 적음
- 따라서 다양한 task domain, unpaired reasoning data가 있을 때, 또는 더 긴 training을 감수할 수 있을 때 적합