Contrastive Representation Regularization for Vision-Language-Action Models 리뷰
Background
VLM이 action에 특화되도록 하는 방향의 연구가 많다. 예를 들면, FAST tokenizer을 사용해서 action prediction loss을 VLM 학습에도 반영한다던지, VQA에 대해 학습을 한다던지, joint training을 한다던지가 있다. 하지만 이런 방법들은 training stage을 여러 개로 둬야 하는 문제 및 dataset curation이 필요하다던지의 문제가 존재한다.
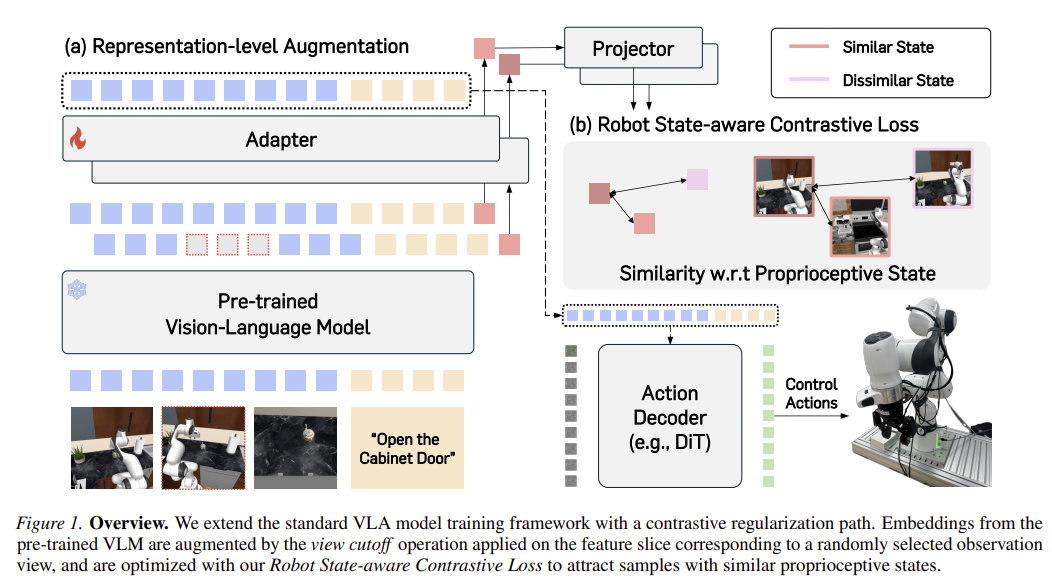
따라서 본 논문은 contrastive learning을 사용해서 일반적인 VLA의 학습 과정 구성을 바꾸지 않으면서 VLM의 representation이 action prediction에 특화되도록 하였다.
Robot State-Aware Contrastive Loss (RS-CL)
Contrastive learning을 통해서 VLM이 robot action prediction에 특화되도록 하기 위해서 특히 proprioceptive states 정보를 capture 하도록 집중하였다.
Vision Language Action model
이 논문에서 사용하는 VLM 구조는 GROOT 1.5 계열을 따라간다.
VLA가 예측하는 action chunk을 $A_t = [a_t, a_{t+1}, \dots, a_{t+H}]$, 서로 다른 V개의 observation을 $O_t^V = {o_t^1, o_t^2, \dots, o_t^V}$, task instruction을 c, robot의 proprioceptive state을 q라고 정의했을 때 VLA는 multimodal input [ $O^V_t, c$ ] 을 vlm으로 representation을 얻어서 action decoder에게 전달한다.
이때, 본 논문은 GROOT 1.5 계열을 사용하기 위해서 adapter module $f_\phi$ 을 사용한다. $f_\phi$ 는 VLM의 representation을 하나의 representation으로 압축하여 action expert에게 전달한다.
\[h = f_\phi^{\text{VLM}}(O_t^V, c) \in \mathbb{R}^{N \times d_{\text{model}}}\]학습될 때 VLM 자체에는 action gradient가 가지 않고 adapter module에만 전달되도록 하여 VLM의 generalizability는 유지하면서 action에 특화되도록 하는 구조로 보인다.
Action decoder $D_{\theta}$ 는 h와 q을 condition으로 받아서 $A_t$ 을 생성한다. 이때 본 논문은 action decoder로 DiT를 사용하고 flow matching objective으로 학습을 한다.
\[\mathcal{L}_{\text{FM}}(\theta, \phi) = \mathbb{E}_s \left[ \left\| D_\theta(h, A_t^s, q) - (\epsilon - A_t) \right\|_2^2 \right]\]이때 $A_t^s = s A_t + (1 - s)\epsilon$ 을 만족하고 추론을 할 때는 random Gaussian noise $\epsilon \sim \mathcal{N}(0, I)$ 에서부터 $A_t$ 을 생성한다.
Robot State Aware Contrastive Loss
VLM은 web scale data으로 pretrain이 주로 되기 때문에 VLM의 representation이 시각적인 정보에 지배적인 특징을 가지고 있다. 그래서 RoboCasa Kitchen에 대해서 Pretrained된 VLM의 representation을 시각화해보면 다음과 같이 robot state을 고려하지 않는 시각적인 유사도 (배경 유사도 및 물체 유사도)를 바탕으로 clustering이 된다.
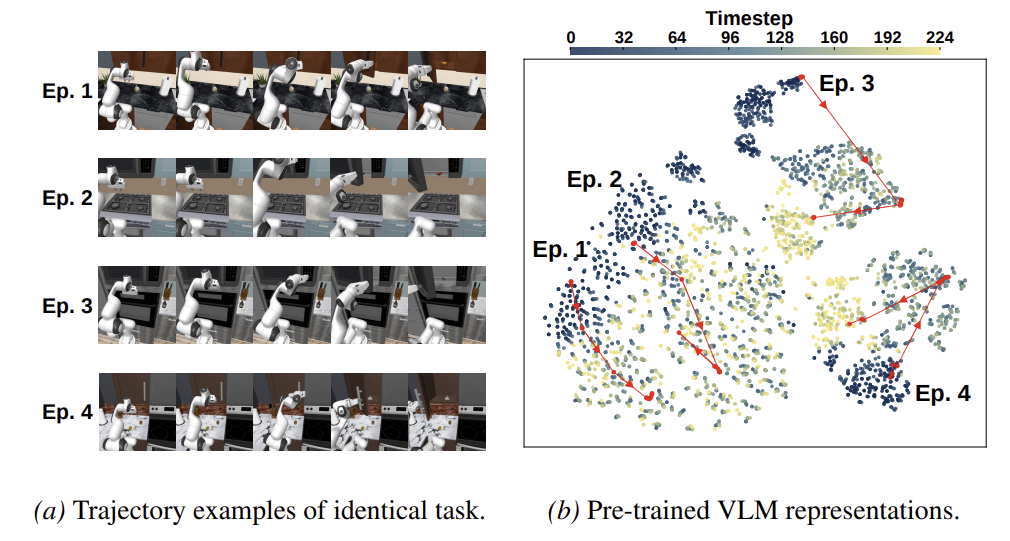
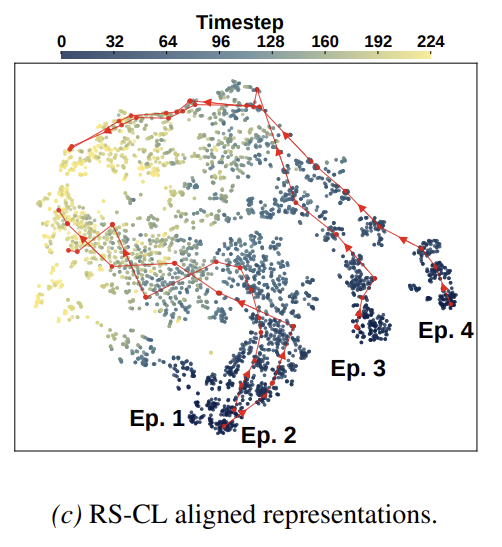
하지만 RS-CL을 적용하면 clustering이 robot state을 바탕으로 된다. 또, 동일한 task들에서 episode가 끝날 때 동일한 지점으로 converge 한다는 것으로부터 효과가 증명된다.
VLM embeddings 압축시키기
VLM의 embedding $h \in \mathbb{R}^{N \times d_{\text{model}}}$ 에서 N의 크기가 너무 크기 때문에 contrastive learning에 사용되기에는 computational cost가 높다 (similarity 계산을 해야하기 때문에). 이를 줄이기 위해서 learnable summarization token u $/mathbb{R}^{1 \times d_{\text{model}}}$ 를 사용한다.
구체적으로는 u가 VLM의 output에 append되어 adapter $f_\phi$ 에 들어간다.
\[[h, w] = f_\phi^{\text{VLM}}(O_t^V, c) \oplus u\]이로부터 출력되는 w가 summarization 결과가 되고 lightweight projector $g_\psi$ 안에 들어가서 contrastive learning을 위한 embedding이 $z = g_\psi(w)$ 이 된다. 이때 h는 여전히 action decoder을 위한 context으로 들어간다.
Incorporating robot states into contrastive learning
그렇다면 이 z을 사용해서 어떻게 robot state을 고려하는 contrastive learning을 할까?
VLM의 representation에 robotic signal이 내재되기 위해서 contrastive learning에 사용되는 pair data의 proprioceptive state 간의 거리를 soft weight으로 사용해서 학습한다. 따라서 proprioceptive state가 가까울수록 더 많은 weight을 부여 받아서 representation space에 더 가까이 있게 된다.
Contrastive learning의 loss을 보면 다음과 같다.
\[\mathcal{L}_{\text{RS-CL}}(\phi, \psi) = -\sum_{i,j=1}^{B} w_{ij} \log \frac{e^{\text{sim}(z_i, \tilde{z}_j) / \tau}}{\sum_{k=1}^{B} e^{\text{sim}(z_i, \tilde{z}_k) / \tau}}\]이때 ${\tilde{z}j}{j=1}^B$ 는 ${z_i}_{i=1}^B$ 의 augmented batch다. 그리고 similarity는 cosine similarity을 사용한다.
여기서 weight $w_{ij}$ 는 다음처럼 정의되어 proprioceptive state $q_i$, $q_j$ 간의 상대적 거리를 계산한다. 이 상대적 거리가 높을수록 weight는 커진다.
\[w_{ij} = \frac{\exp\left(-\|\mathbf{q}_i - \mathbf{q}_j\|^2 / \beta\right)}{\sum_{k=1}^{B} \exp\left(-\|\mathbf{q}_i - \mathbf{q}_k\|^2 / \beta\right)}\]최종 objective는 flow matching loss와 RS-CL loss로 구성된다.
\[\mathcal{L} = \mathcal{L}_{\text{FM}} + \lambda \mathcal{L}_{\text{RS-CL}}\]Representation augmentation for Contrastive pairs
${\tilde{z}j}{j=1}^B$ 는 ${z_i}_{i=1}^B$ 의 augmented batch 라고 정의했었는데 이 augmentation을 어떻게 했고 왜 했을까?
Contrastive learning을 하기 위해서는 negative sample보다 positive sample을 모으는 것이 중요하다.
아마도 negative sample은 in batch negative sampling으로 해결 가능하기 때문
하지만 robot dataset에서 어떤 data들이 비슷한 robot proprioceptive state을 갖고있는지 알아내기가 어렵다. 그래서 본 논문은 안정적인 positive pair을 얻기 위해서 VLA의 vlm이 여러 시점의 카메라 정보를 사용한다는 것으로부터 augmentation 방법론을 생각해낸다.
동일한 데이터에서 생긴 VLM의 representation이라고 하더라도 그 representation에서 view 중 하나를 mask out하면 동일한 proprioceptive state을 가지면서 다른 representation data을 만들 수 있다.
이렇게 representation level에서 augmentation을 하지 않고 VLM에 들어가는 image view point을 없애면 pair dataset을 만들기 위해서 VLM을 여러번 호출해야 해야 한다.
Experiments
Fine-tuning Experiments
Simulation Experiment
RS-CL이 SOTA VLA 모델의 fine-tuning에 도입되었을 때 어떤 효과를 보여줄 수 있는지 먼저 보여준다. 예를 들어 pi 0.5 모델은이미 action prediction에 특화되도록 large scale data로 학습되었음에도 불구하고 RS-CL을 사용하면 성능 향상이 된다는 것을 보여주고자 하는 것이다.
사용하는 평가 데이터셋으로는 RoboCasa Kitchen과 LIBERO이다.
RoboCasa Kitchen에 대해서는 다음 성능을 보인다.
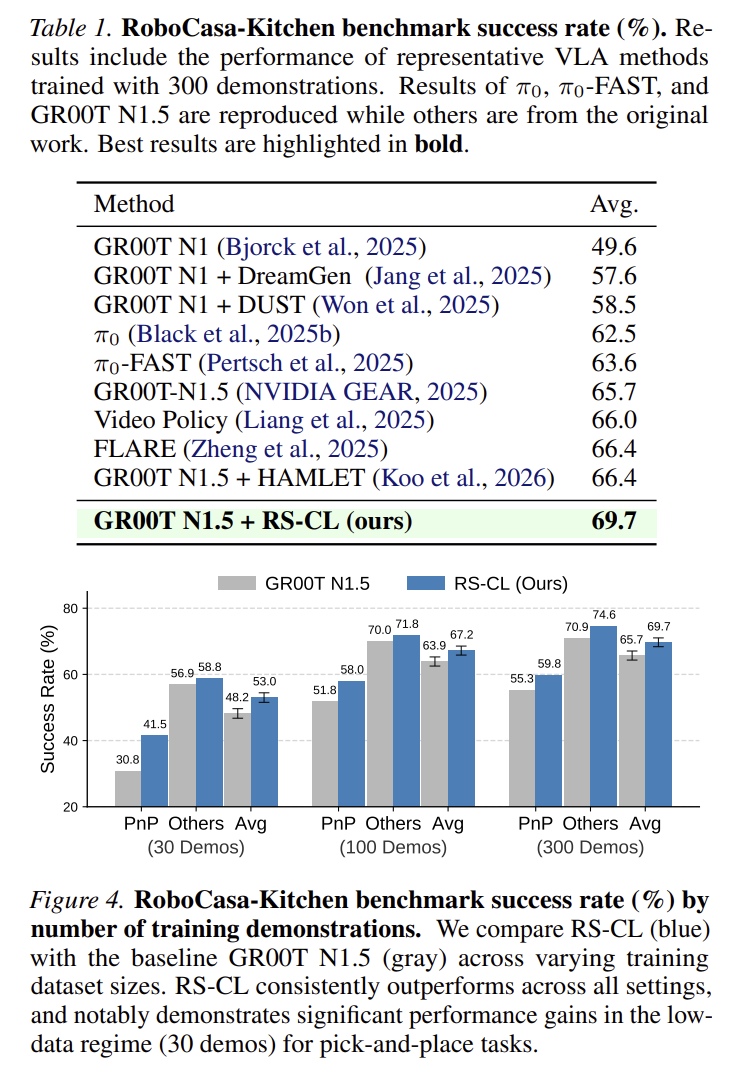
우선 RS-CL을 적용한 모델이 전체적인 성능이 가장 높다는 것을 알 수 있다. 또, 다른 finetuning scheme (ex: HAMLET) 을 적용한 것보다도 높다. 그리고 특히 pick and place에서 높은 성능을 보인다는 것을 알 수 있는데 이는 RS-CL이 VLM representation에 robot propioceptive states을 내재시키도록 해서 더 precise한 action을 생성해도록 해준다고 볼 수 있다.
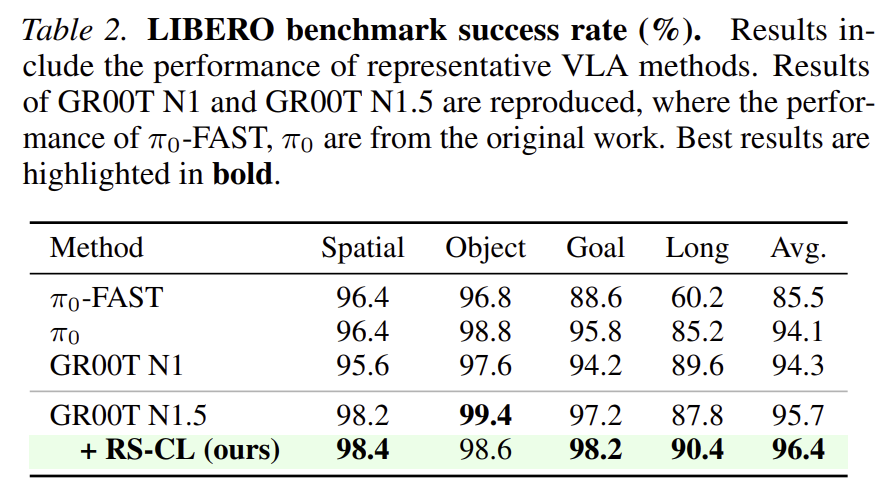
LIBERO에 대해서도 GROOT N1.5보다 전체적인 성능이 더 좋다.
Real Robot Experiment
7 DoF에서의 real world 실험도 진행하였다. Task으로는 대체로 pick and place으로 구성되었다. 이때 다양한 환경 변화에도 generalization이 잘 되는지 실험하였다.
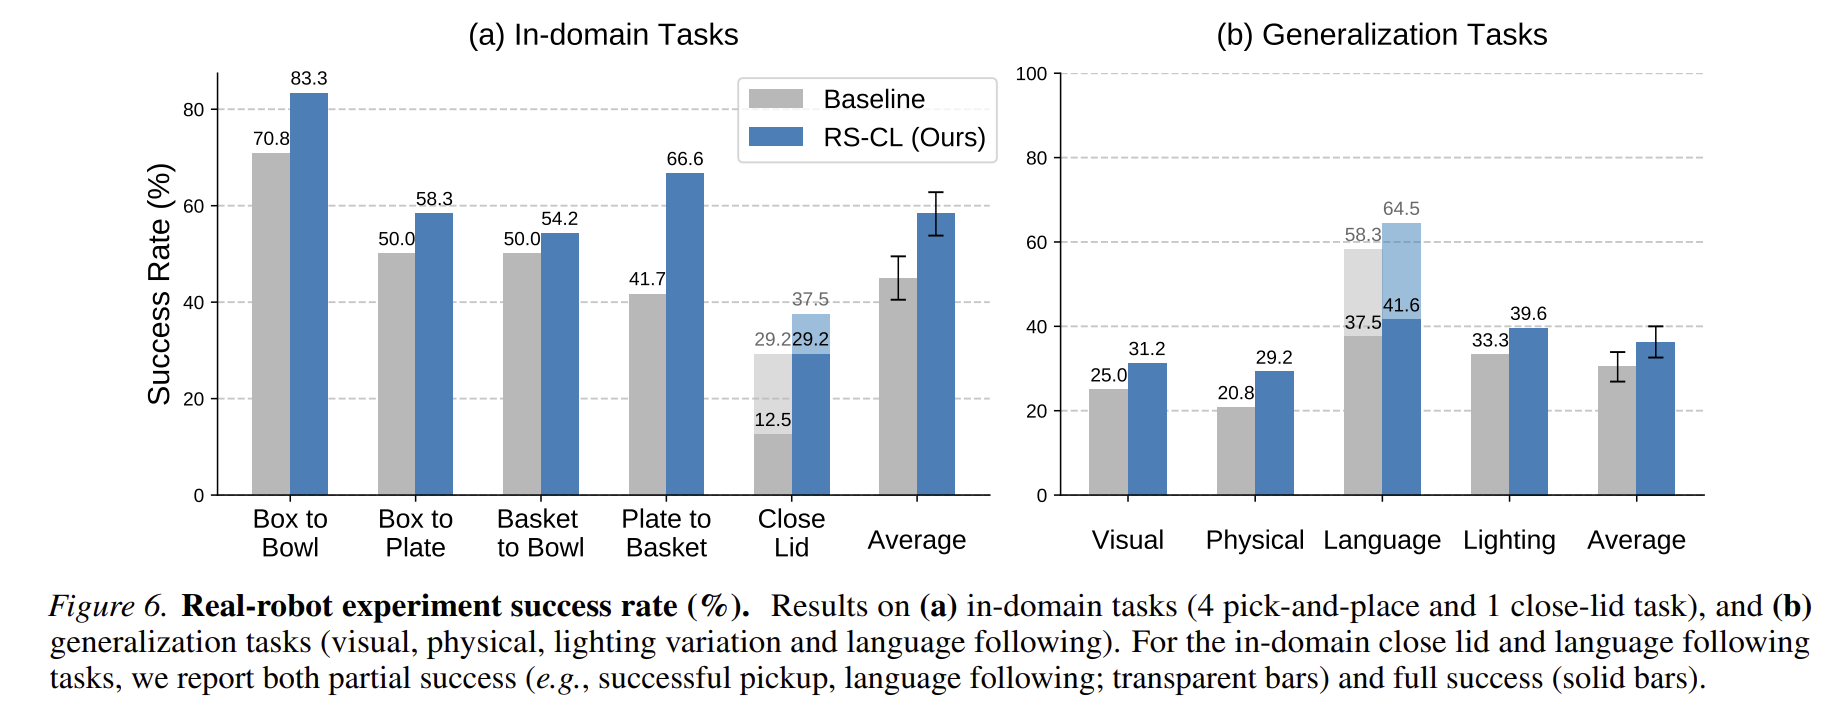
결과를 통해 RS-CL이 효과적이라는 것을 알 수 있다. 이런 높은 정확도와 generalization 능력은 우선 proprioceptive supervision을 학습에 사용했기 때문에 더 정확한 positioning이 가능해졌다고 볼 수 있다. 또, view cutoff augmentation으로 인해 view가 달라지더라도 안정적인 representation을 만들도록 해줬기 때문이라고 볼 수 있다.
From-Scratch Experiments
VLA에서 시작하지 않고 pretrained된 VLM backbone (Qwen 2.5-VL, SigLIP2)에 RS-CL을 적용하여 from scratch에 적용했을 때의 성능을 평가한다. 이로부터 pretrained VLM이 robotic signal을 잘 capture하지 못한다는 가설과 robot proprioceptive state을 바탕으로 contrastive learning을 함으로써 robot action prediction에 특화될 수 있다는 가설을 검증하였다.
Pretrained VLM에 random initialize된 action decoder을 붙여서 Contrastive learning을 적용했을 때 성능이 더 좋아지는지 평가한다.
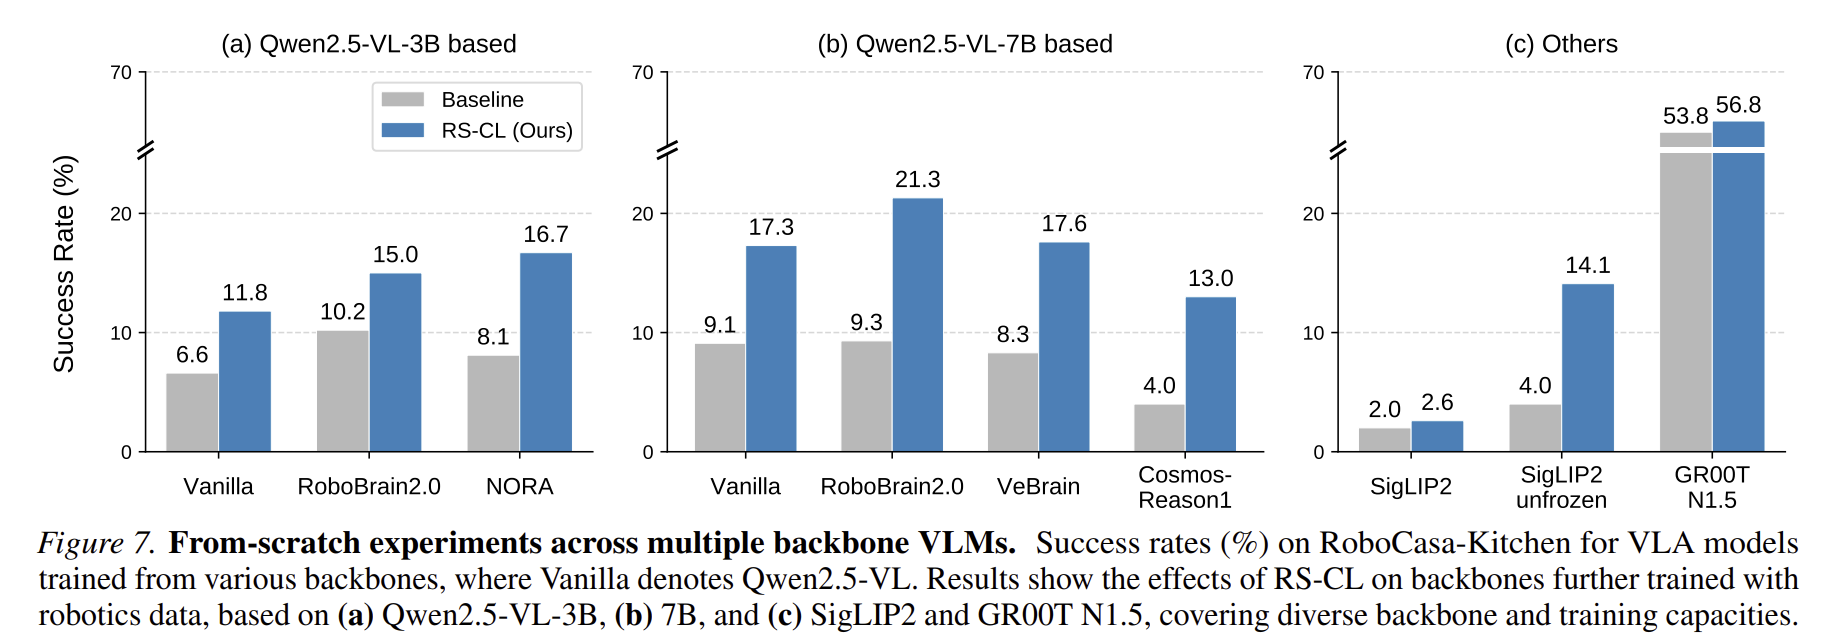
RS-CL을 적용한 모델들 모두 더 성능이 좋아졌음을 알 수 있다. 또, SigLIP2에서는 backbone을 unfreeze 했을 때 더 큰 성능 향상을 보였다.
또, GROOT 1.5의 VLM (Eagle 2.5 VLM은 grounding과 reasoning 능력이 매우 높음)에서도 동일한 성능 향상을 보인다는 것을 통해 robotics specific training (VQA 등) 만으로는 general purpose VLM representation과 action prediction을 위한 VLM representation 간의 gap을 줄일 수 없다는 것을 알 수 있다.