RoFormer Enhanced Transformer With Rotary Position Embedding 리뷰
Background
Self Attention은 position 정보를 word embedding에 결합하여 query, key, value의 representation을 얻는다.
\[q_m = f_q(X_m, m)\] \[k_n = f_k(X_n, n)\] \[v_n = f_v(v_n, n)\]그리고 이 representation을 사용하여 attention score $a_{m,n}$을 계산하여 최종 output을 얻는다.
\[a_{m,n} = \frac {exp(\frac{q_m^Tk_n} {\sqrt d})} {\sum_{j=1}^{N} exp(\frac{q_m^Tk_j} {\sqrt d})}\] \[o_m = \sum_{n=1}^{N} a_{m,n} v_n\]본 논문은 기존과 다른 Transformer based position encoding 방법인 RoPE (Rotary Position Embedding) 을 제시한다. 기존에 사용되는 방법들은 Absolute position 정보 또는 Relative position 정보를 주입하기 위해 positional embedding을 word embedding에 직접 더하여 Representation 함수 $f$를 설계한다.
Absolute Position Embedding
Trainable vector $p_i$나 이미 정의된 함수값을 word embedding에 더해서 위치 정보를 주입하는 방법이다. 이때 주입되는 위치 정보는 단어가 sequence 내에서 몇 번째 단어에 속하는지를 의미하는 absolute position 정보이다.
\[f_{t : t \in q,k,v} (x_i, i) := W_{t: t \in q,k,v} (x_i + p_i)\]보통 $p_i$의 값으로는 sinusoidal function을 사용한다.
\[p_{i,2t} = sin(k / 10000^{2t/d})\] \[p_{i,2t+1} = cos(k / 10000^{2t/d})\]하지만 Absolute positional 정보는 Generalization 능력이 떨어진다는 단점이 존재한다. 예를 들어, context length가 256 token인 data에 대해서만 학습한 모델에 그 length를 초과하는 입력값이 들어가게 되면 256보다 큰 absolute position 값을 가지는 token을 이해하는 능력이 떨어지게 된다.
Relative Position Embedding
말 그대로 두 token 간의 위치 값의 차이를 word embedding에 더해서 위치 정보를 주입하는 방법이다. 다음은 Relative positional embedding을 사용하는 연구들이다.
Self-Attention with Relative Position Representations
\[f_q(x_m) := W_q x_m\] \[f_k(x_n, n) := W_k ( x_n + \tilde p_{r}^{k})\] \[f_v(x_n, n) := W_q ( x_n + \tilde p_{r}^{v})\]이때, $\tilde p_{r}^{k}$와 $\tilde p_{r}^{v}$는 trainable relative position embedding이다. r = $clip(m-n, r_{min}, r_{max})$로 m과 n의 상대적 거리를 표현하였다. clip을 한 이유는 너무 먼 두 단어는 서로 관련이 없을 가능성이 높다는 직관을 반영하기 위해서다.
Transformer-XL: Attentive language models beyond a fixed-length context
이 논문의 저자는 attention score를 구하는 식을 전개한 뒤 변화를 주었다.
다음은 word embedding에 absolute positional embedding $p_m, p_n$을 더하여 계산한 Attention score 식을 전개한 것이다.
Transformer-XL의 저자는 absolute position embedding $p_n$을 sinusoid-encoded relative position embedding $\tilde p_{m-n}$으로 대체하였다. 또, query의 위치 정보는 의미가 없고 query의 내용에 따라 attention score가 변해야 한다는 발상을 표현하기 위해 세 번째와 네 번째 항의 $p_m$을 trainable vector $u$와 $v$로 대체하였다. 마지막으로 key의 embedding matrix을 위치 embedding matrix와 내용 embedding matrix으로 분리하였다.
\[q_m^T k_n = x_m^TW_q^TW_kx_n + x_m^TW_q^T\tilde W_k \tilde p_{m-n} + u^TW_q^TW_kx_n + v^TW_q^T\tilde W_k\tilde p_{m-n}\]Exploring the limits of transfer learning with a unified text-to-text transformer
이 논문에서는 absolute position과 단어의 관계는 미미하다는 연구 결과를 바탕으로 기존 attention score 계산식의 두 번째와 세 번째 항을 없앴다. 단어의 내용과 absolute position이 관련된 정도가 attention score에 반영되지 않도록 내용을 project하는 matrix (W)와 위치를 project하는 matrix (U)를 다르게 하였다.
\[q_m^T k_n = x_m^TW_q^TW_kx_n + p_m^TU_q^TU_kp_n + b_{i,j}\]Deberta: Decoding-enhanced bert with disentangled attention
이 논문에서는 반대로 기존 attention score 계산식의 두 번째와 세 번째 항으로 token들의 relative position을 제대로 modeling 할 수 있다고 주장하였다. 따라서, $p_m$과 $p_n$을 relative position embedding $\tilde p_{m-n}$으로 대체하여 attention score 계산 방법을 다음과 같이 바꾸었다.
\[q_m^T k_n = x_m^TW_q^TW_kx_n + x_m^TW_q^TW_k\tilde p_{m-n} + \tilde p_{m-n}^TW_p^TW_kx_n\]현재까지의 방법들은 모두 기존의 attention score 계산을 분해하여 수정하는 방법들이며 context embedding x에 position embedding 값을 직접 더함으로써 query, key, value representation을 형성함을 알 수 있다. 하지만 더하는 방법은 context embedding 값을 바꾸고 기존 attention score 식을 변경하기 때문에 Linear Attention을 적용하지 못하게 된다는 단점이 존재한다.
RoPE: Rotary position embedding
이런 문제들을 해결하기 위해 본 논문은 RoPE을 소개한다. 본 논문은 회전 행렬을 context embedding에 곱하는 방법을 통해 위치 정보를 주입한다. 기존 Attention score 식이 유지가 되기 때문에 Linear Attention에 적합해졌고 더 효과적인 자연어 encoding을 가능하게 해주는 특징들을 가지게 되었다.
도출 과정
우선 Attention score을 계산하기 위해서는 query representation $f_q$와 key representation $f_k$의 inner product를 정의할 함수 g가 필요하다. 본 논문은 inner product를 통해 상대적 위치 정보만 encode되도록 하는 것을 목표로 하였다. 따라서 함수 g를 word embeddings $x_m, x_n$ 그리고 상대적 위치 m-n만 가지고 inner product를 정의하도록 설계하였다.
\[q_m^Tk_n = <f_q(x_m, m), f_k(x_n, n)> = g(x_m, x_n, m-n)\]함수 $f$는 word embedding $x_i$와 위치 i를 통합하여 내용과 위치 정보가 모두 표현된 query, key, value의 representation을 만들어야 한다. 본 논문은 벡터를 벡터의 크기와 각 정보로 분리할 수 있는 복소수 형태로 변환하여 representation 함수 $f$를 정의하였다.
벡터 $\vec a = (a_1, a_2)$가 있을 때 이 벡터는 $a_1 cos \theta + ia_2 sin \theta$로 표현할 수 있고 이는 또 $\sqrt {a_1^2 + a_2^2} \cdot e^{i \theta}$로 표현할 수 있다. R과 $\Theta$가 각각 벡터의 크기와 각도를 나타낸다면 representation 함수 $f$는 다음과 같이 정의될 수 있다.
\[f_q (x_q, m) = R_q (x_q, m) \cdot e^{i \Theta_q(x_q, m)}\] \[f_k (x_k, n) = R_k (x_k, n) \cdot e^{i \Theta_k(x_k, n)}\]함수 g도 동일한 방법으로 표현할 수 있다.
\[g (x_q, x_k, m-n) = R_g (x_q, x_k, m-n) \cdot e^{i \Theta_g(x_q, x_k, m-n)}\]이때 함수 g는 $f_q$와 $f_k$의 dot product이므로 두 벡터의 크기의 곱과 두 벡터가 이루는 각으로 표현된다.
\[g (x_q, x_k, m-n) = R_q (x_q, m) \cdot R_k (x_k, n) \cdot e^{i (\Theta_k(x_k, n) - \Theta_q(x_q, m))}\]여기서 R과 $\Theta$가 정확히 어떤 함수인지 정의하기 위해서 다음 과정을 거친다.
R과 $\Theta$ 도출
R 도출
m = n이라고 가정할 때, 다음을 만족한다
이때 m=0이라고 할 때 다음을 만족한다.
\[R_q(x_q,0) = \left\vert \left\vert q \right\vert \right\vert\] \[R_k(x_k, 0) = \left\vert \left\vert k \right\vert \right\vert\] \[R_g (x_q, x_k, 0) = \left\vert \left\vert q \right\vert \right\vert \cdot \left\vert \left\vert k \right\vert \right\vert\]m이 0이 아닐 때는 다음을 만족한다.
\[R_g (x_q, x_k, 0) = R_q(x_q,m) \cdot R_k(x_k,m) = \left\vert \left\vert q \right\vert \right\vert \cdot \left\vert \left\vert k \right\vert \right\vert\]이 관계식을 만족하는 제일 직관적인 풀이는 모든 m에 대해서 $R_q(x_q,m) = \left\vert \left\vert q \right\vert \right\vert$와 $R_q(x_q,m) = \left\vert \left\vert k \right\vert \right\vert$가 만족할 때이다. 이를 통해 함수 $R$은 위치값 m과 독립적임을 알 수 있다.
$\Theta$ 도출
m=n이라고 가정할 때, 다음을 만족한다.
\[\Theta_k (x_k, m) -\Theta_q (x_q, m) = \Theta_g (x_q, x_k, 0)\]m=n=0이라고 할 때, 다음을 만족한다.
\[\Theta_k (x_k, 0) = \theta_k\] \[\Theta_q (x_q, 0) = \theta_q\] \[\Theta_g (x_q, x_k, 0) = \Theta_k (x_k, 0) -\Theta_q (x_q, 0) = \theta_k - \theta_q\]m이 0이 아닐 때는 다음을 만족한다.
\[\Theta_g (x_q, x_k, 0) = \Theta_k (x_k, m) -\Theta_q (x_q, n) = \theta_k - \theta_q\]따라서 모든 m에 대해서, $\Theta_g (x_q, x_k, 0) = \theta_k - \theta_q$이다. 이 식을 $\Theta_k (x_k, m) -\Theta_q (x_q, m) = \Theta_g (x_q, x_k, 0)$ 관계식에 대입하면 다음을 만족한다.
\[\Theta_k (x_k, m) -\Theta_q (x_q, m) = \theta_k - \theta_q\]이 관계식을 변형하면 $\Theta_k (x_k, m) - \theta_k$와 $\Theta_q (x_q, m) - \theta_q$은 항상 동일한 상수값을 갖는다는 것을 알 수 있다. 이 관계식을 일반화하면 다음과 같다.
\[\phi (m) = \Theta_f (x, m) - \theta_x\]이 관계식을 $\Theta_g (x_q, x_k, m-n) = \Theta_k (x_k, m) -\Theta_q (x_q, m)$에 대입하면 $\Theta_g (x_q, x_k, m-n) = \phi(n) - \phi(m) + (\theta_k - \theta_q)$이 된다. 이 관계식은 모든 n과 m에 대해 만족하기 때문에 n=m+1을 대입하고 전개하면 다음과 같다.
\[\phi(m+1) - \phi(m) + (\theta_k - \theta_q) = \Theta_g (x_q, x_k, 1)\]우변이 m과 독립적인 값임을 통해 $\phi(m)$은 m에 대한 1차 함수임을 짐작할 수 있다. 따라서 $\phi(m)$을 다음과 같이 표현할 수 있다.
\[\phi(m) = m \theta + \gamma\]지금까지의 얻은 관계식들은 다음과 같다.
- $f_q(x_q, m) = R_q \cdot e^{i\Theta_q}$
- $R_q = \left\vert \left\vert q \right\vert \right\vert$
- $\Theta_q = \theta_q + \phi(m)$
- $\phi(m) = m \theta + \gamma$
이 관계식들로 본 논문이 제시한 Representation 함수를 얻을 수 있다.
\[f_q(x_q,m) = \left\vert \left\vert q \right\vert \right\vert \cdot e^{i(\theta_q + m\theta + \gamma)}\] \[f_q(x_q,m) = (\left\vert \left\vert q \right\vert \right\vert e^{i(\theta_q)}) \cdot e^{i(m\theta + \gamma)}\] \[f_q(x_q,m) = q \cdot e^{i(m\theta + \gamma)}\] \[f_q(x_q,m) = (W_q x_q) \cdot e^{i(m\theta + \gamma)}\]이때 간단하기 위해서 $\gamma$를 0으로 설정한다. 결국 $x_q$의 m에서의 representation은 affine transformed $x_q$을 $m\theta$만큼 회전시킨 것과 같다.
따라서 최종 representation 함수 $f$는 다음과 같다.
\[f_q(x_q,m) = (W_q x_q) \cdot e^{im\theta}\]도출 과정을 요약하자면, Attention score에 관여하는 position 정보를 relative position만 사용해야 한다는 가정을 바탕으로 수학적으로 전개하였을 때, representation 함수 $f$는 필연적으로 벡터의 크기를 바꾸지 않고, 벡터의 각도만 바꾸는 회전 함수라는 것을 알 수 있다.
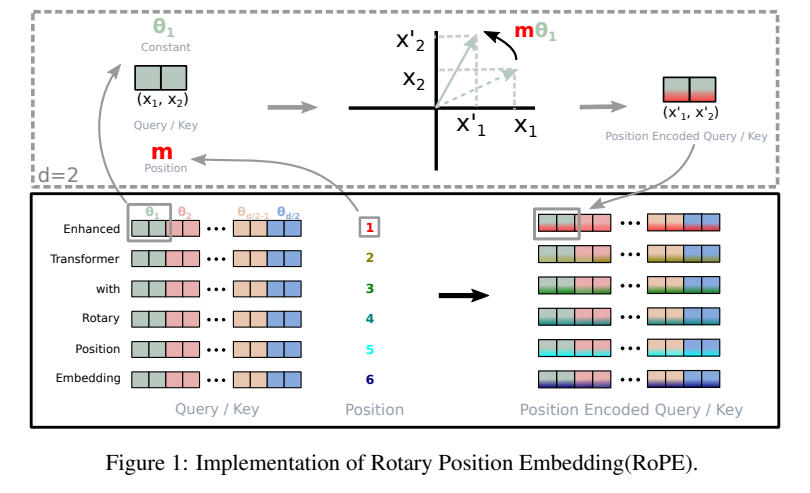
Self-Attention with RoPE
d가 양수인 아무 $x_i \in R^d$에 RoPE를 적용하기 위해서 $f$의 General form을 정의하였다. Inner product의 linearity의 장점을 활용하여 d 차원 공간을 d/2 차원의 공간들로 나누어 합쳤다. $f$의 General form은 다음과 같다.
\[f_{q,k} (x_m, m) = R_{\Theta, m}^d W_{q,k} x_m\]이때 $R_{\Theta, m}^d$은 다음과 같다.
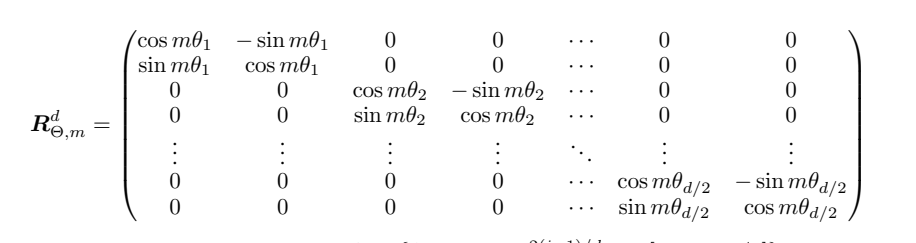
RoPE를 self attention에 적용하면
\[q_m^Tk_n = (R_{\Theta, m}^dW_qx_m)^T(R_{\Theta, n}^dW_kx_n) = x^TW_qR_{\Theta, n-m}^dW_kx_n\] \[where \hspace{0.1cm} R_{\Theta, n-m}^d = (R_{\Theta, m}^d)^T \cdot R_{\Theta, n}^d\]이때, 회전 행렬 $R_{\Theta, m}^d$은 orthogonal matrix이기 때문에 안정성이 높은 representation이 유지가 된다.
Orthogonal Matrix이 왜 안정적일까? $\rightarrow$ 벡터의 크기과 관계가 보존되기 때문이다.
- 크기 보존
Orthogonal matrix를 Q라고 할 때 $Q^T Q = I$을 항상 만족한다. 이 특징 때문에 이 행렬로 transformation을 시켜도 크기는 유지가 된다.
이 특징 때문에 layer를 여러 개 거쳐가도 크기가 유지되어 exploding이나 vanishing value 문제가 발생하지 않는다.
- 관계 보존
Orthogonal matrix는 두 벡터의 관계(내적)도 보존한다.
즉, 회전을 통해서 두 벡터가 가졌을 관계가 훼손되지 않는다.
RoPE가 갖는 특징
1) Long Term Decay
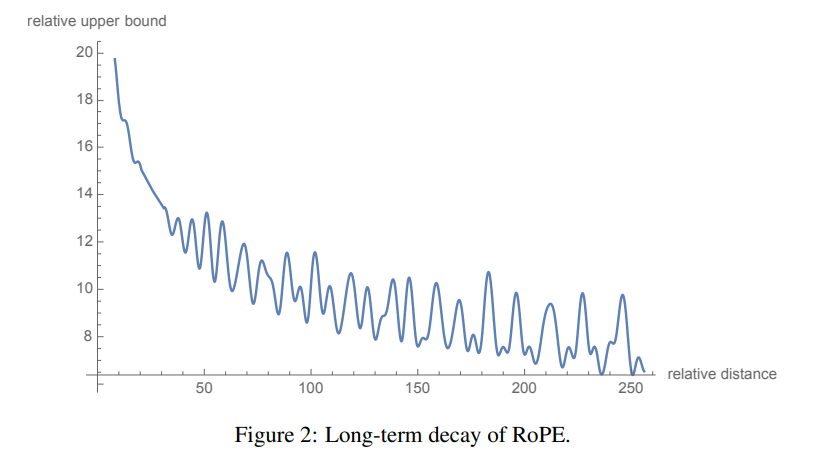
두 token 간의 관련 정도가 relative distance가 커질수록 약해지는 성질을 지니고 있다. 이 성질은 수학적으로 증명할 수 있다.
Attention score 구하는 식을 content term $h_i = q_{[2i:2i+1]} k_{[2i:2i+1]}^{*}$과 position term $e^{i(m-n)\theta_i}$으로 나눌 수 있다. 이 계산을 쉽게 하기 위해 Abel Transformation을 적용할 수 있다.
Abel Transformation은 $\sum^n u_i \nabla v_i$ 을 $[u_nv_n] - \sum^n \nabla u_i v_{i+1}$으로 바꾸는 Transformation이다. $u_i$를 $h_i$로, $v_i$를 $e^{i(m-n)\theta_i}$의 i항까지의 합을 $S_{i+1}$이라고 하고 대입하면 간단하게 Attention score를 구할 수 있다.
$h_{\frac{d} {2}} = 0$이라고 할 때, $u_n$=0이므로 다음과 같이 풀어 쓸 수 있다.
\[\sum^n u_i \nabla v_i = - \sum^n \nabla u_i v_{i+1}\] \[\sum^n u_i \nabla v_i = - \sum^n (h_{i+1} - h_i) S_{i+1}\]이 관계식을 이용하여 $\sum^n u_i \nabla v_i$, 즉 Attention score $(R^d_{\Theta,m} W_q x_m)^\intercal (R^d_{\Theta,n} W_k x_n)$의 upper bound을 계산해보면 다음과 같다.
\[\left\vert \text{Re} \left[ \sum_{i=0}^{d/2-1} q_{[2i:2i+1]} k^*_{[2i:2i+1]} e^{i(m-n)\theta_i} \right] \right\vert = \left\vert \sum_{i=0}^{\frac{d} {2}-1} (h_{i+1} - h_i) S_{i+1} \right\vert\] \[\left\vert \sum_{i=0}^{\frac{d} {2}-1} (h_{i+1} - h_i) S_{i+1} \right\vert \le \sum_{i=0}^{\frac{d} {2}-1} \left\vert (h_{i+1} - h_i)\right\vert \left\vert S_{i+1} \right\vert\] \[\sum_{i=0}^{\frac{d} {2}-1} \left\vert (h_{i+1} - h_i) \right\vert \left\vert S_{i+1} \right\vert \le (max \left\vert (h_{i+1} - h_i) \right\vert ) \cdot \sum_{i=0}^{\frac{d} {2}-1} \left\vert S_{i+1} \right\vert\]이때 $(max \left\vert (h_{i+1} - h_i) \right\vert)$은 relative distance를 결정하는 m과 n에 독립적이므로 $\sum_{i=0}^{\frac{d} {2}-1} \left\vert S_{i+1} \right\vert$의 값만 관찰하면 된다. $\theta_i = 10000^{-\frac{2(i-1)}{d}}$일 때, relative distance m-n이 증가할수록 $\sum_{i=0}^{\frac{d} {2}-1} \left\vert S_{i+1} \right\vert$의 값은 decay한다.
2) Linear Attention 적용 가능
회전 행렬을 곱해서 위치 정보를 주입하기 때문에 hidden representation의 norm이 변하지 않아서 linear attention을 적용할 수 있다. Linear Attention 공부하고 더 elaborate 해야함..