ELECTRA Pre-training text encoers as discriminators rather than generators 리뷰
Background
SOTA인 representation 학습 방법은 learning denoising autoencoders이다. BERT에서 사용된 방법으로 15%의 unlabeled input sequence를 [MASK] token으로 처리하고 나서 neural network가 [MASK] token에 원래 어떤 단어가 있었는지 맞추도록 학습하는 방법이다.
본 논문에서 현재 SOTA 학습 방법에 대해 지적한 문제점은 두 가지가 있다. 첫 번째로 학습 효율 문제이다. Pretraining 단계에서 많은 데이터에 대해서 학습할수록 성능이 향상된다는 것이 알려져있다. 하지만 지금 SOTA 방법처럼 학습 데이터의 15%만 사용하게 되면 학습 효율이 낮다. 두 번째로 pretrain-finetune discrepancy 문제이다. 학습에 사용되는 [MASK] token을 추론 과정에서는 사용하지 않기 때문에 학습 과정과 추론 과정에서 괴리감이 발생하여 성능에 영향을 준다.
Method
본 논문은 이 두 문제를 해결하기 위해 replaced token detection pretraining 방법을 제시한다. Input sequence 내의 몇몇 단어들을 작은 언어 모델 (generator)가 생성한 그럴 듯한 단어들로 대체한다. 이 방법을 통해 [MASK] token을 사용하지 않으면서 input sequence를 corrupt 할 수 있으며 pretrain-finetune discrepancy 문제를 해결한다. 이후, 다른 neural network (discriminator)를 input sequence의 모든 단어들이 원래 있던 단어들인지 아니면 generator를 통해 만들어진 단어인지 구별하도록 학습한다. 모든 단어들에 대해 학습을 하기 때문에 학습 효율 문제가 해결된다. Generative Adversarial Network과 유사하다고 생각할 수 있지만 이 방법에서의 generator는 적대적인 방법이 아닌 maximum log likelihood으로 학습되기 때문에 다르다.
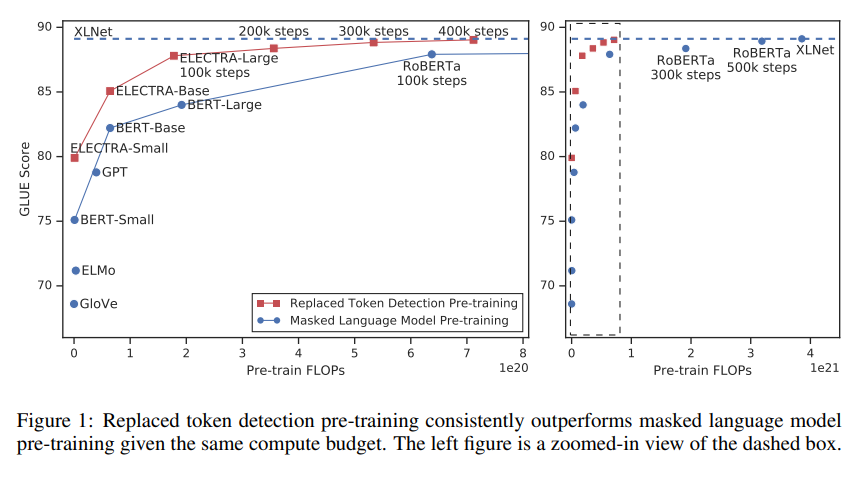
다음 결과를 통해 본 논문의 pretraining 방법이 동일한 계산 자원으로 더 큰 성능 향상을 보임을 알 수 있다.
Replaced Token Detection Pre-Training Task
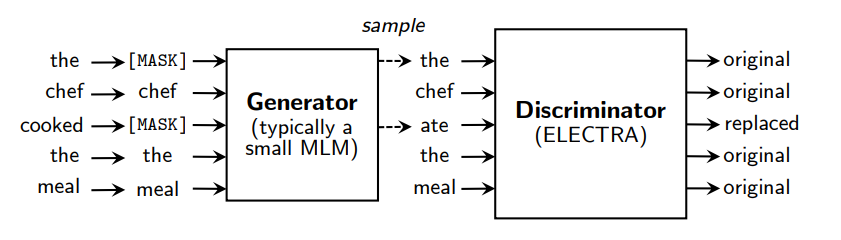
본 논문의 pretraining task는 두 neural network Generator G와 Discriminator D를 학습한다. 각 neural network는 Transformer 기반 Encoder로 input tokens $x$=[$x_1, …, x_n$]을 context representation $h(x) = [h_1, …, h_n]$으로 mapping한다.
Generator는 위치 t에서 $x_t$로 가능한 단어의 확률 분포를 출력한다. t까지의 context를 바탕으로 제일 그럴 듯한 단어를 생성하는 것이다. 이때 e는 token embedding 함수이다.
\[p_G(x_t | x) = \frac{\exp\left( e(x_t)^T h_G(x)_t \right)}{\sum_{x'} \exp\left( e(x')^T h_G(x)_t \right)}\]Discriminator는 위치 t의 token $x_t$가 generator로부터 생성되었는지 아니면 원래 있던건지 예측한다.
\[D(x,t) = sigmoid(w^T h_D(x)_t)\]학습 방법
Generator는 masked language modeling을 하도록 학습된다.
1: Input $x = [x_1, x_2, … x_n]$이 있을 때 mask할 무작위의 위치를 고른다. 이 위치들은 $m = [m_1, …, m_k]$이다.
이 위치들을 [MASK] token으로 바꾼다.
\[x^{masked} = \text{REPLACE(x, m, [MASK])}\]2: Generator를 mask 된 단어들이 원래 어떤 단어들이었는지 맞추도록 학습한다.
\[\hat x_i \sim p_G(x_i \mid x^{masked}) \,\, for \, i \in m\] \[x^{corrupt} = REPLACE(x, m, \hat x)\]3: Discriminator는 generator가 생성한 token들과 data의 token들과 잘 구분하도록 학습된다.
학습 과정을 Loss function으로 나타내면 다음과 같다.
\[\mathcal{L}_{MLM}(x, \theta_G) = \mathbb{E} (\sum_{i \in m} -log \, p_G(x_i \mid x^{masked}))\] \[\mathcal{L}_{Disc} (x, \theta_D) = \mathbb{E} (\sum_{t=1}^{n} \mathbb{1}(x_t^{corrupt} = x_t) log D(x^{corrupt}, t) - \mathbb{1}(x_t^{corrupt} \ne x_t) log(1 - D(x^{corrupt}, t)))\]이 두 loss function을 합쳐서 최종 loss function을 만든다. 이때 $X$는 large corpus of raw text이다.
\[min_{\theta_G, \theta_D} \, \sum_{x \in X} \, \mathcal{L}_{MLM}(x, \theta_G) + \lambda \mathcal{L}_{DISC}(x, \theta_D)\]본 논문의 학습 방법이 GAN과 다른 점은 첫 번째로 generator가 올바른 token을 생성했다면 corrupt된 token이 아니라 원래 있던 “real” token이 되도록 하였다는 것이다. 또, generator가 discriminator를 속이는 방향으로 학습되는 것이 아니라 “real” token을 잘 맞추는 방향으로 학습된다는 점에서 다르다.
Experiments
Model Extensions
본 논문은 모델의 변형을 통해 Replaced token detection pre-training 방법을 개선하고자 하였다.
1: Smaller Generators
ELECTRA는 학습 효율을 높이기 위해서 고안된 방법인데 Generator와 Discriminator의 크기가 동일하다면 우선 ELECTRA를 학습하는데 MLM만 학습하는 방법보다 두 배의 computation이 필요하다. 따라서 discriminator보다 작은 generator를 사용하였다고 한다.
본 논문은 추가로 Discriminator보다 더 작은 generator를 사용해야 하는 이유에 대해서 실험을 하였다. 다양한 크기 variation으로 ELECTRA를 학습한 결과, discriminator의 1/4 ~ 1/2 크기의 generator를 사용하는 것이 성능이 제일 좋았다.
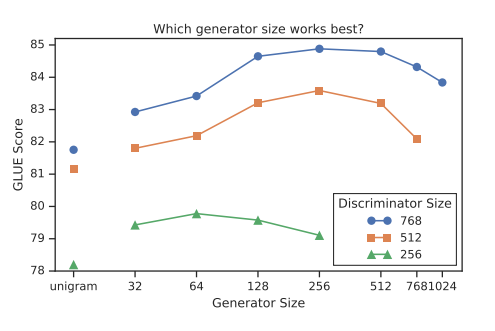
Generator의 성능이 너무 좋다면 (크기가 크다면), discriminator가 해결해야 하는 task가 너무 어려워진다. 또, Task를 수행하기 위해Discriminator는 parameter들이 실제 data 분포를 학습하는 것이 아니라 generator를 modeling하는 방향으로 학습을 할 수 있기 때문에 이런 결과가 나온다고 해석된다.
2: Weight Sharing
Pretraining의 효율을 더욱 높이기 위해 generator와 discriminator의 weight를 공유하는 방법도 실험하였다. Generator와 Discriminator의 크기가 동일하다면 모든 transformer weight를 공유하여 효율을 높일 수 있지만, 작은 generator를 사용하는 것이 성능이 좋다는 것이 입증되었으므로 token과 position embedding만 공유하도록 하였다. Generator의 MLM 방법이 token embedding을 학습하는데 매우 효과적이기 때문에 token embedding들을 공유함으로써 성능이 전체적으로 향상될 것이라고 생각하였다. Generator의 token embedding이 더 우수한 이유는 discriminator는 input에 있는 단어나 generator가 생성한 단어들에 대해서만 token embedding이 update 되지만 generator는 전체 vocabulary에 대해 softmax를 하기 때문에 모든 단어들의 token embedding이 update된다. 따라서, Generator와 discriminator의 token embedding을 공유하도록 하였다.
3: Training Algorithm 변화
Two-Stage Training
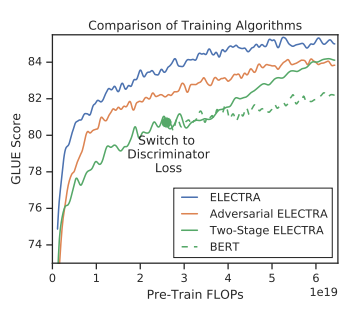
Generator만 먼저 $\mathcal{L_{MLM}}$ 으로 n step동안 학습한 다음에 generator의 weights로 discriminator의 weights를 초기화하여 discriminator를 $\mathcal{L_{Disc}}$로 학습하는 방법을 실험했다. 이때 이 방법은 generator와 discriminator의 크기를 동일하게 해야 한다는 단점이 있다.
Generator의 weights로 discriminator의 weights를 초기화하는 이유는 그렇지 않는다면 generator가 discriminator보다 성능이 너무 앞서있게 되어 학습을 잘 하지 못하게 되는 상황이 발생하기 때문이다. 하지만 Joint하게 학습하는 방법은 generator의 성능이 서서히 좋아지므로 discriminator에게 자연스럽게 학습 커리큘럼을 제공하듯이 진행된다.
Two stage training에서 generative objective에서 discriminative objective으로 바꾸자마자 downstream task의 성능이 향상되긴 하지만 joint training보다는 떨어진다.
GAN
GAN 방법으로 학습하는 방법도 실험했다. BERT보다 성능이 좋아지긴 하지만 generator를 maximum likelihood training으로 학습할 때보다 성능이 떨어진다. 이런 결과는 두 가지로 해석된다. 우선 Adversarial generator는 masked language modeling을 잘 하지 못한다. 강화학습 기반으로 학습되기 때문에 text와 같은 large action space에서 sample 능력이 떨어지기 때문이다. 두 번째 이유는 adversarial generator는 entropy가 낮은 output 확률 분포를 생성한다. 즉, discriminator가 맞추기 어려워하는 특정 token들에만 확률 분포가 집중된다. 따라서 generator sample에 다양성이 적기 때문에 discriminator의 성능도 이에 따라 안 좋아진다.
Small Models
논문의 목표는 pretraining의 효율을 높이기 위한 것이므로 결과를 빨리 얻을 수 있는 작은 모델들에 대해서 실험을 진행하였다. Small model들은 sequence length가 512에서 128로, batch size는 256에서 128로, hidden dimension size는 768에서 256으로, token embedding 또한 768에서 128로 크기를 줄였다.
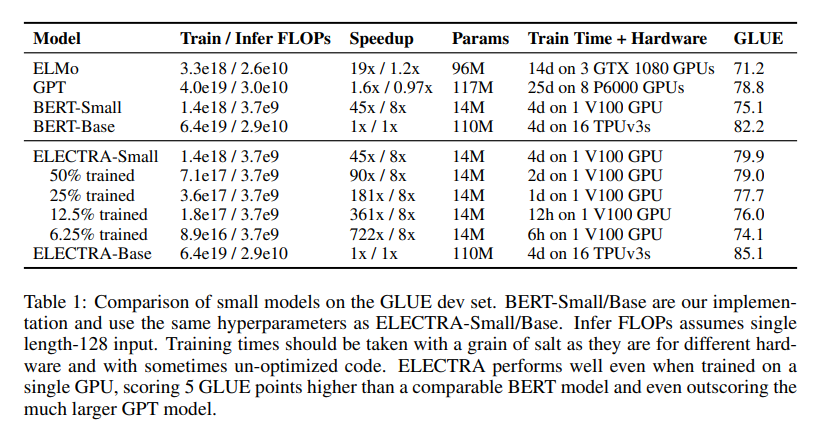
ELECTRA small 모델은 더 많은 parameter와 더 많은 연산을 요구하는 모델들보다 더 높은 GLUE score를 보인다. BERT small보다 5점이 높으며 더 큰 모델인 GPT보다도 더 좋은 성능을 보인다. ELECTRA base 모델은 BERT-base와 BERT-Large보다도 더 좋은 성능을 보인다. 이 실험 결과를 통해 ELECTRA의 pretrain 효율성을 엿볼 수 있다.
Large Models
크기가 큰 모델에서 replaced token detection pretraining task의 효과를 실험하기 위해서 크기가 큰 SOTA pretrained Transformers 모델들과 비교를 하였다. ELECTRA-400k는 400k steps동안 학습한 모델이고 RoBERTa를 학습하기 위해 필요한 계산량의 1/4만 필요하다. ELECTRA-1.75M은 1.75M steps만큼 학습한 모델로 RoBERTa를 학습하기 위해 필요한 계산량과 비슷하게 필요로 한다.
GLUE dev set에 대한 결과는 다음과 같다.
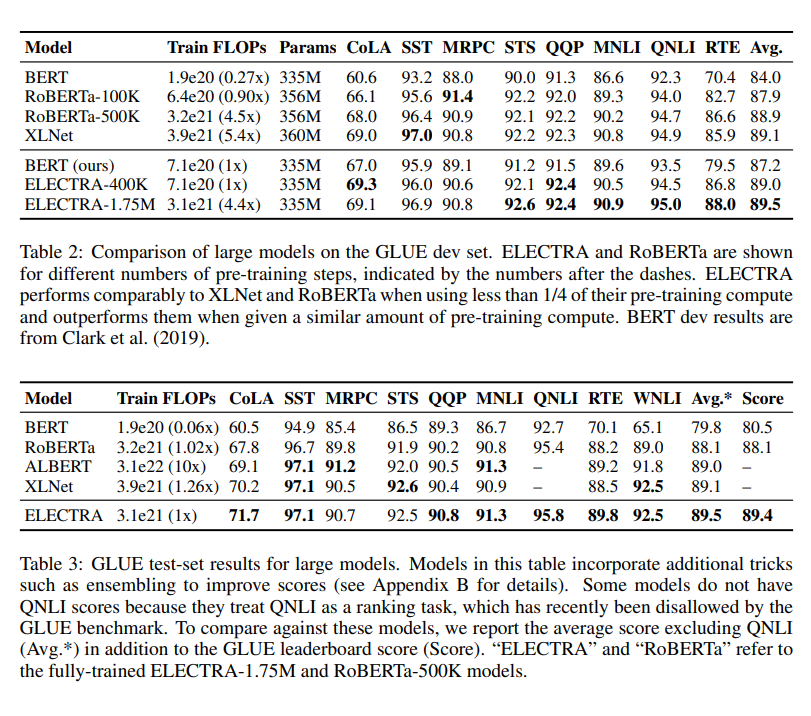
ELECTRA-400k는 RoBERTa와 XLNet을 학습하는데 필요한 계산량의 1/4만 필요하면서도 비슷한 성능을 보인다. 이를 통해 large scale에서도 replaced token detection pretraining의 우수한 효율성을 엿볼 수 있다.
ELECTRA-1.75M은 RoBERTa와 XLNet을 학습하는데 필요한 계산량보다 적으면서도 비슷한 성능을 보인다.
SQUAD에 대한 결과는 다음과 같다.
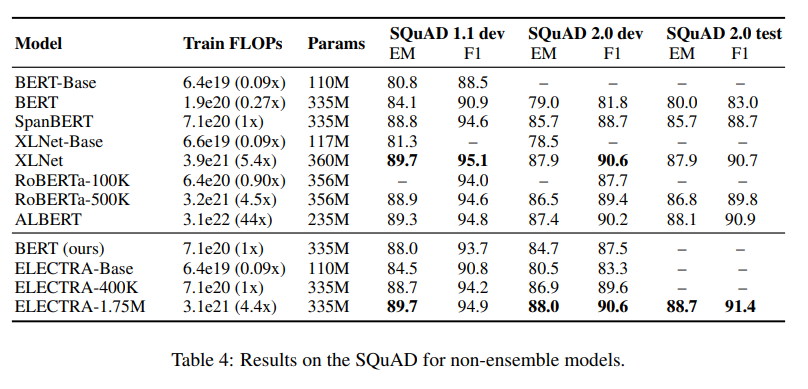
이 실험에서도 비슷하게 ELECTRA의 성능은 더 많은 계산량을 요구하는 모델들보다 더 좋은 성능을 보인다.
SQUAD 2.0에서는 더 높은 성능 향상을 보이는 이유로 본 논문은 discriminator가 가짜 token을 구별하는 과정이 SQUAD 2.0 데이터의 성격과 비슷하기 때문이라고 해석한다.
Efficiency Analysis
BERT에서 사용되는 Masked language modeling은 15%의 input token만 학습에 사용되기 때문에 비효율적이라고 지적하였지만 loss를 계산하는 token 수만 적은 것이고 학습 과정에서 많은 token들을 입력으로 받는다. 따라서 ELECTRA의 성능이 왜 우수한지 정확하기 이해하기 위해서 본 논문은 BERT와 ELECTRA의 차이점을 하나씩 적용해서 비교한다.
- ELECTRA 15%: ELECTRA와 동일하지만 discriminator 학습을 오직 15%의 masked된 input token에 대해서만 진행한다. 이 방법을 통해 모든 training data를 사용하는 것을 통해 성능 개선이 발생한 것인지 알아낸다.
- Replace MLM: 기존 Masked Language Modeling 방법 (BERT)에서 [MASK] 대신 generator에서 생성된 token을 사용하여 진행한 것. 이를 통해 ELECTRA의 성능 향상이 pretrain-finetune discrepancy를 해결함으로써 발생한 것인지 실험한다.
- All-Tokens MLM: [MASK]를 generator 생성 token으로 바꾼 뒤, 모든 token들이 MASK라고 간주하고 pretraining을 하는 방법을 실험한다. 이 방법의 성능 개선을 위해 모델의 softmax 분포는 입력 token을 그대로 가져오는 확률 D라고 했을 때, 다음과 같이 계산한다.
이를 통해 모든 token에 대해서 MLM을 하는 것도 좋은 것인지 알아낸다.
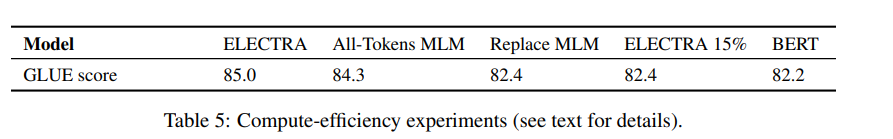
Electra 15%의 성능이 BERT의 성능과 가장 비슷하다. 이 결과를 통해 데이터의 일부만 가지고 loss를 계산하는 것이 성능 저하를 일으켰다는 것을 알 수 있다.
Replace MLM의 성능도 BERT와 가장 비슷하다. 이 결과를 통해 ELECTRA의 pretrain-finetune discrepancy 효과는 미미한 것을 알 수 있다. 사실 BERT는 15%의 token을 모두 [MASK] 처리하는 것이 아니라 그 중 10%는 무작위 token으로, 10%는 그대로 두는 방법을 통해 어느정도는 pretrain-finetune discrepancy를 해결한다. 하지만 아예 제거하지 못하기 때문에 미미한 성능 차이를 보임을 알 수 있다.
All-Tokens MLM은 ELECTRA와 성능이 가장 유사하다. 이 결과를 통해 ELECTRA의 성능 향상은 pretrain finetune discrepancy 해결보다 전체 token들로 학습을 하여 발생하였다는 것을 알 수 있다.
참고로 ELECTRA의 성능 향상 효과는 모델의 크기가 작을수록 커진다.
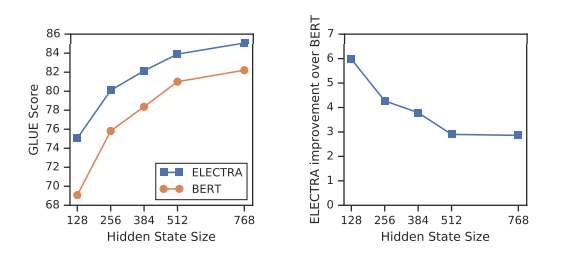
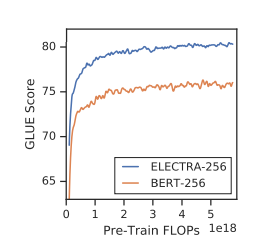
이에 더해 small ELECTRA는 converge 속도가 small BERT보다 빠를 뿐만 아니라 더 좋은 성능을 낸다.