Multi-Task Deep Neural Networks for Natural Language Understanding 리뷰
Background
Text의 vector representation을 학습하는 것은 NLU task에 매우 중요하다. Text의 representation을 학습하는데 주로 사용되는 두 방법은 Multi-task learning과 pretraining이다.
- Multi-task learning
Target task가 존재할 때, 그 task와 관련된 다른 task들의 labeled data set에 대해 supervised learning을 하여 Target task에 대한 성능을 간접적으로 올리는 방법이다. 이 방법은 Target task의 data가 적을 때 유용하다. 이는 간접적인 학습 방법이기 때문에 target task에 대해 overfitting된 representation을 얻는 것을 방지하고 regularization 효과를 얻게 한다. 또, 다양한 task에 적합한 vector representation을 얻게 해준다. - Pretraining
대량의 unlabeled text data에 대해 self-supervised learning하여 universal한 language representation을 얻게 하는 방법이다.
Multi-Task Deep Neural Network (MT-DNN)
MT-DNN은 이 두 방법을 결합하여 universal한 text representation을 효과적으로 학습시키는 방법이다. Universal text representation의 장점은 다양한 task에서 범용적으로 사용될 수 있다는 것이다. 즉, 모델의 전체적인 언어 이해도가 높아진다.
MT-DNN은 BERT가 lower layers를 다른 specific task와 공유하는 아이디어를 차용한다. 따라서, MT-DNN은 BERT처럼 다양한 task들에 대해 finetuning 될 수 있다. 차이점은 추가적으로 Multi-task learning을 적용한다는 것이다. 이를 통해 9개의 NLU task 중에 8개 task에서 SOTA 결과를 얻는다.
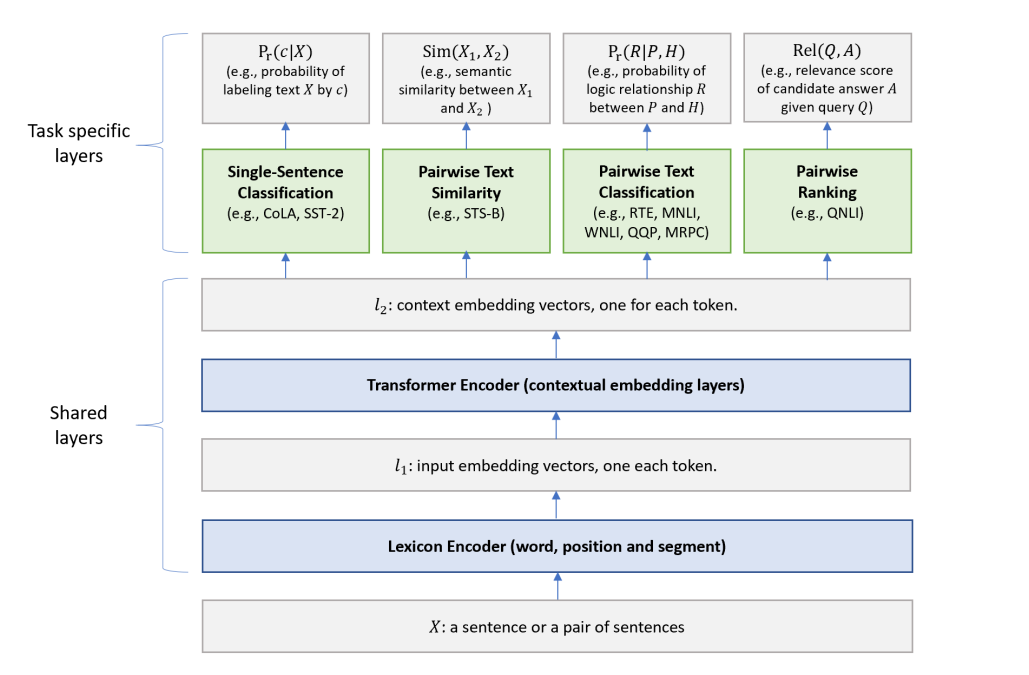
Low layer들은 모든 task에서 공유되지만 top layers는 task-specific output을 가질 수 있도록 하였다.
입력
입력 $X$는 input text sequence이다.
Lexicon Encoder ($\mathcal {l_1}$)
$X = {x_1, …, x_m}$의 첫 token은 BERT에 따라 항상 [CLS] token이고 $X$가 두 문장 ($X1, X2$)으로 되어있다면, [SEP]으로 문장이 구분된다. Lexicon Encoder는 $X$를 input embedding vector로 mapping하는 역할을 한다. 이때, input embedding은 word, segment, positional embedding이 더해져서 만들어진다.
Transformer Encoder ($\mathcal {l_2}$)
Transformer Encoder로는 multi-layer bidirectional Transformer encoder를 사용한다. Transformer Encoder는 $\mathcal {l_1}$에서 만들어진 input representation을 contextual embedding vectors $C \in R^{d \times m}$으로 mapping하는 역할을 한다. 이 contextual embedding vector는 다양한 task를 수행할 때 공유된다.
Multi-Task Learning에 사용되는 Task의 Output
Single Sentence Classification Output
x를 contextual embedding $\mathcal {l_2}$의 [CLS] token이라고 할 때, 이 token은 attention에 의해 문장 전체의 의미 정보를 지니고 있다고 볼 수 있다. 이 정보를 통해 문장이 어떤 class에 속할 지에 대한 확률 분포를 계산한다.
\[P_r(c \mid X) = softmax(W_{SST}^T \cdot x)\]이때 $W_{SST}^T$는 task-specific parameter matrix이다.
Text Similarity Output
x를 contextual embedding $\mathcal {l_2}$의 [CLS] token이라고 할 때, 이 token은 attention에 의해 문장 pair ($X_1, X_2$)의 의미 정보를 지니고 있다고 볼 수 있다. 여기서 similarity score를 계산하기 위해 다음 식을 사용한다.
\[Sim(X_1, X_2) = w_{STS}^T \cdot x\]이때 similarity score의 범위는 $(-\infty , \infty)$의 실수 값이다.
Pairwise Text Classification Output
두 문장 간의 관계를 계산하는 task이다. 전제 P = ($p_1, … , p_m$)이 있고 가설 H = ($h_1, … , h_n$)이 있을 때 P와 H의 논리적 관계 R을 구하는 task를 예로 들 수 있다. 이때 Stochastic Answer Network를 사용하여 output module을 구성한다.
Relevance Ranking Output
x를 contextual embedding $\mathcal {l_2}$의 [CLS] token이라고 할 때, 이 token은 attention에 의해 Question Q에 대한 정답 후보 A pair data ($Q, A$)의 의미 정보를 지니고 있다고 볼 수 있다. 여기서 relevance 점수를 계산하기 위해 다음 식을 사용한다.
\[Rel(Q, A) = g(w_{QNLI}^T \cdot x)\]Question Q의 모든 답안 후보들의 점수를 바탕으로 ranking을 한다.
학습 과정
Pretraining
우선 BERT와 동일한 pretraining 과정을 통해 Lexicon Encoder와 Transformer Encoder의 parameters를 update한다.
Multi-task Learning stage
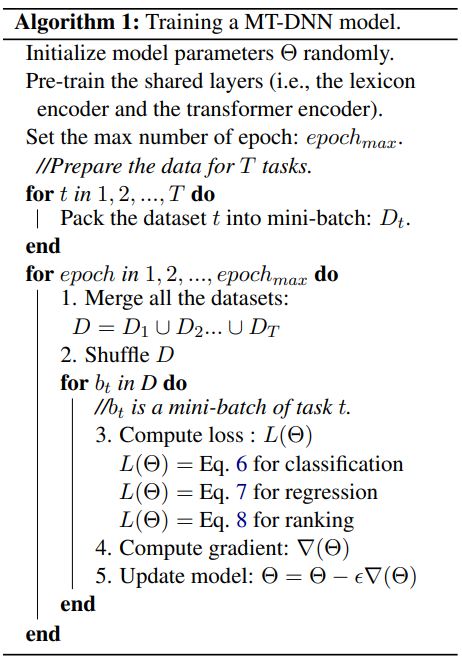
Mini-batched based stochastic gradient descent를 활용한다. 각 epoch마다 9개의 GLUE task 중 하나에 속하는 mini-batch $b_t$가 선택되고 그 task에 알맞은 model parameter들이 update된다. 이 과정은 대략 모든 multi-task objective의 합을 최적화한다.
각 multi-task에 사용되는 loss function은 다음과 같다.
Classification tasks (Single sentence and pairwise text classification)
\[-\sum_{c} \mathbf{1} (X, c) \log(P_r(c|X))\]이때 $\mathbf{1} (X, c)$는 X에 대한 classification이 c가 맞을 때 0을 c가 아닐 때는 1을 반환하는 binary indicator이다.
Text similarity tasks
\[(y - Sim(X_1, X_2))^2\]Relevance ranking tasks
Queries가 주어졌을 때 positive example의 negative log likelihood을 최소화하는 과정으로 학습을 한다.
\[-\sum_{(Q, A^+)} \text{Pr}(A^+|Q)\]이때 $P_r$은 다음과 같이 정의된다.
\[P_r(A^+|Q) = \frac{\exp(\gamma \text{Rel}(Q, A^+))}{\sum_{A' \in A} \exp(\gamma \text{Rel}(Q, A'))}\]즉, $A^+$가 나올 확률을 최대화하는 과정이라고 볼 수 있다.
Result
Finetune된 MT-DNN은 BERT를 능가한다. MT-DNN은 BERT에 Multi-task learning을 첨가한 것이므로 이 결과는 Multi-task learning가 효과적인 text representation을 학습하는 우수한 방법임을 입증한다.
Finetune되지 않은 MT-DNN을 학습할 때 사용한 task들과 관련없는 task에 대해서는 성능이 좋지 않다. 하지만 조금만 finetuning해도 성능이 우수해진다. 사전 학습의 Distribution에 없는 task에 대해서도 적응력이 높다는 것을 통해 Pretrain + Multi-task learning을 통해 효과적인 universal한 text representation을 만들 수 있다는 것을 입증한다.
Stochastic Answer Network (참고)
한 번에 정답을 찾는 것이 아니라, 정답의 확률 분포를 여러 단계(step)에 걸쳐 반복적으로 갱신하고 정제해 나가는 방식이다. Working memory of premise P를 P의 단어들의 contextual embeddings의 concatenation이라고 하자. 이는 $M^p \in R^{d \times m}$으로 표현된다. Working memory of hypothesis H는 $M^h \in R^{d \times m}$으로 표현한다. 이를 바탕으로 $K$번의 reasoning을 하여 relation label을 도출한다.
각 step을 state라고 생각할 때, 처음 state $s^0$은 $M^h$의 summary로 초기화된다.
\[s^0 = \sum_{j} \alpha_j M_{j}^h \quad \text{where} \quad \alpha_j = \frac{\exp(w_1^T \cdot M_{j}^h)}{\sum_{i} \exp(w_1^T \cdot M_{i}^h)}\]k번째 state $s^k = GRU(s^{k-1}, x^k)$로 정의된다. 이때 $x^k$는 k번째 추론 단계에서 새롭게 참고할 정보를 의미한다. $x^k$는 계산 이전 state $s^{k-1}$와 memory $M^p$로 계산된다.
\[x_k = \sum_{j} \beta_j M_j^p \quad \text{where} \quad \beta_j = \text{softmax}(s^{k-1} W_2^T M^p)\]즉, 이전까지의 추론 내용($s^{k-1}$)을 바탕으로, 가지고 있는 전제에 대한 정보($M^p$) 의 어떤 부분을 살펴봐야 하는지를 매 state마다 계산하는 것이다. 따라서 $s^k$를 update하는 식은 $s^{k-1}$의 정보 중 얼마를 잊고, $x^k$의 정보 중 얼마를 새로 받아들일지 결정하여, 현재까지의 추론 내용을 $s^k$로 압축한다.
각 단계별로 relation을 예측할 때 다음 식을 사용한다.
\[P_k^r = \text{softmax}(W_3^T [s^k; x^k; |s^k - x^k|; s^k \cdot x^k])\]예측을 위해 현재 상태와 현재 정보뿐만 아니라, 두 벡터의 차이와 곱까지 함께 제공하여 풍부한 context를 제공하도록 설계되어있다. 최종 예측은 다음 식을 사용한다.
\[P^r = \text{avg}([P_0^r, P_1^r, ..., P_{K-1}^r])\]