기존 방법 정리
최소한의 수정으로 Tactile injection / 적용 논문
VLM 입력에 Tactile 추가
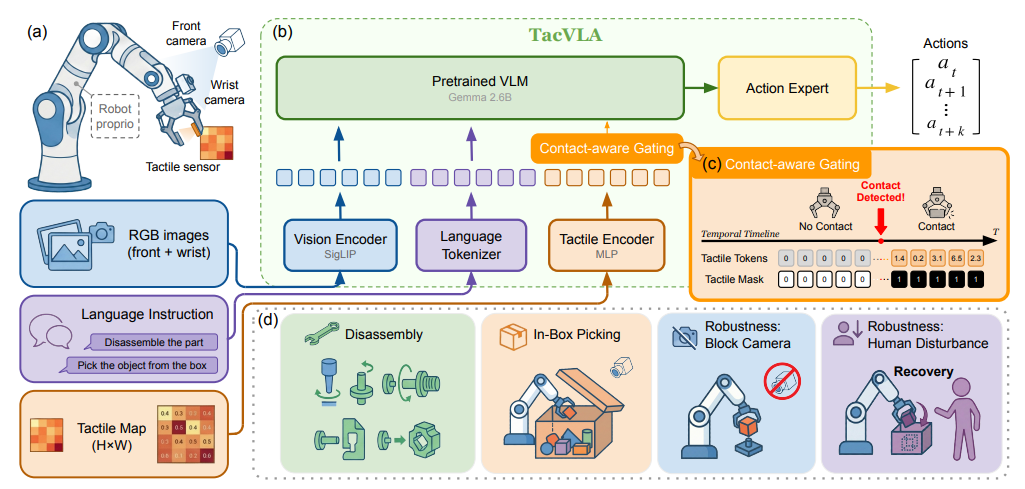
TacVLA: Contact-Aware Tactile Fusion for Robust Vision-Language-Action Manipulation (IROS 2026)
- 사용하는 tactile 정보: Tactile sensor array 값
- Tactile 정보 process 방법: MLP encoder + positional embedding으로 spatial 정보 보존
특징
- VLM backbone이 vision + language + proprioceptive + tactile 다 입력받아서 cross attention으로 처리 $\rightarrow$ Action expert가 받는 modality input 길이는 동일하게 유지
- Tactile 정보가 필요없는 task에서도 tactile을 VLM input으로 넣었을 때 성능이 더 안 좋아짐 $\rightarrow$ Tactile gating을 사용해서 접촉이 감지될 때만 VLM의 cross attention에 포함
- LoRA를 사용하면 기존 모델의 generalization을 잃지 않고 새로운 modality을 효과적으로 도입할 수 있다고 주장. 근데 LoRA가 어디에 적용되었는지 논문에서 공개 x, 코드도 공개 x
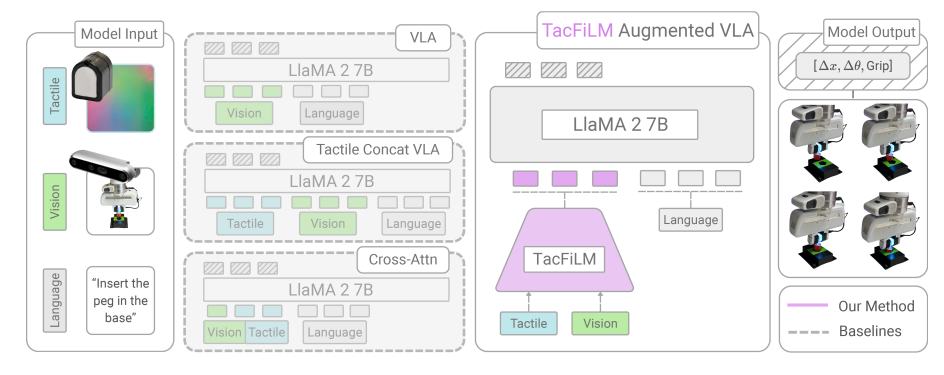
Tactile Modality Fusion for Vision-Language-Action Models (ECCV 2026)
- 사용하는 tactile 정보: DIGIT tactile sensor로 visuotactile임. Tactile RGB image을 사용
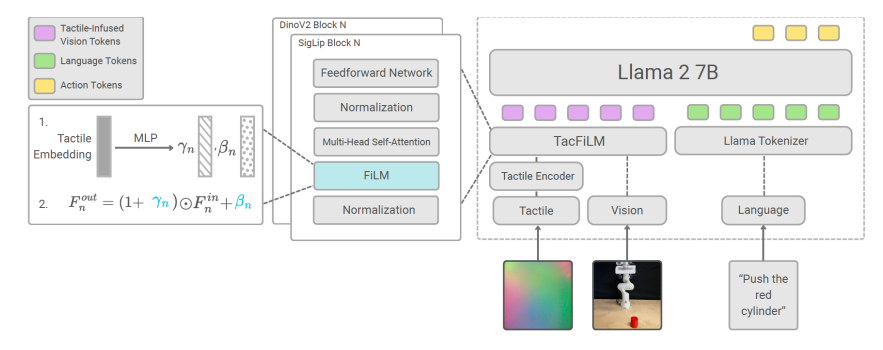
- Tactile 정보 process 방법: Sparsh-DINO encoder으로 처리 + FiLM (Feature wise Linear Modulation)
- Backbone VLM을 tactile 정보로 condition 할 수 있도록 channel 별 scale + shift parameter $\gamma, \beta$ 을 학습
- 특정 tactile 상태에서 Backbone VLM의 representation을 어떻게 변형시키고 강조해야 tactile 정보를 포함시킬 수 있는지를 학습하는 것
특징
-
VLM 입력에서 tactile을 어떻게 injection 해야 하는지를 비교함 $\rightarrow$ 단순한 Tactile concatenation과 cross attention보다 FiLM 방법론이 더 좋았음
-
Vision occlusion 상황 (dimming / frame 수 줄임) 에서도 FiLM 성능이 더 좋았음
-
Tactile Encoder가 어떤 objective으로 학습해야 성능이 좋았는지를 평가함 $\rightarrow$ DINO objective으로 학습한 모델이 MAE objective으로 학습한 모델보다 좋았음
Tactile 기반 action refinement
VLA-Touch: Enhancing Vision-Language-Action Models with Dual-Level Tactile Feedback
- 사용하는 Tactile 정보: Gelsight sensor의 marker displacement 정보
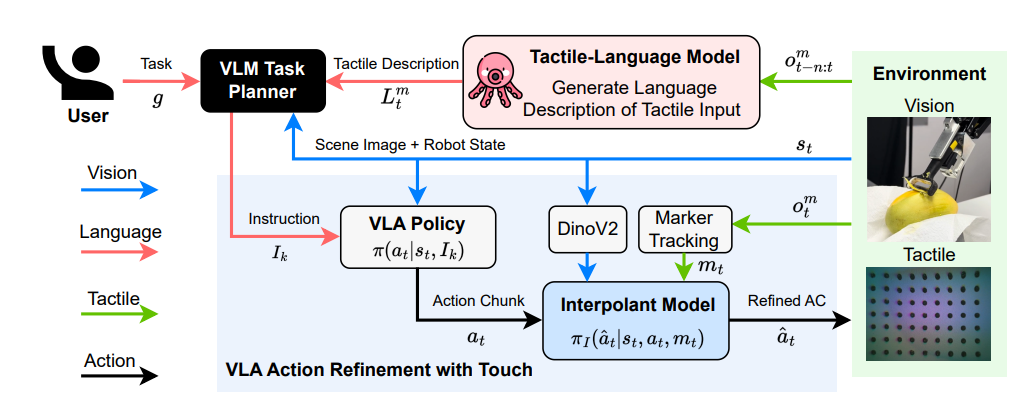
- Tactile 정보 process 방법: Octopi - gelsight 정보로 접촉한 물체의 특성을 language output으로 맞추도록 학습된 LM + OpenCV 기반 marker tracking으로 marker의 displacement을 계산 (각 marker의 이동량의 크기를 force 값으로 추정해서 사용)
특징
- Tactile 정보를 language와 controller에 추가
- Octopi으로 얻은 language tactile 특징을 VLM prompt에 추가 (이때 VLM이 GPT)
- 기존 policy의 action output과 tactile 정보를 controller에 추가해서 refine
- 이때 interpolant diffusion controller을 사용함
- Interpolant model을 학습할 때만 tactile을 사용. 기존 policy을 학습할 때는 tactile 사용하지 않음
Tactile 기반 Steering
TouchGuide: Inference-Time Steering of Visuomotor Policies via Touch Guidance (RSS 2026)
- 사용하는 tactile 정보: Xense optical tactile sensor의 tactile image
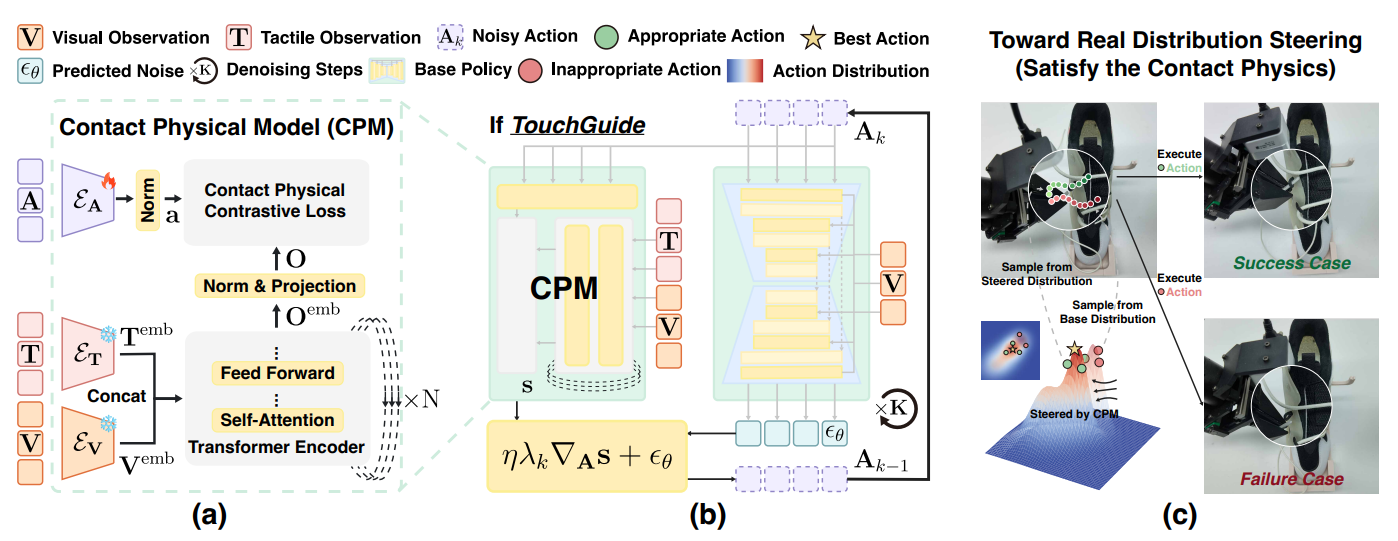
- Tactile 정보 process 방법: visual과 tactile image을 각각 DINOv2에 입력해서 freature embedding을 얻음. 이 embedding들을 concat시켜서 transformer에 입력하여 fusion
 특징
-
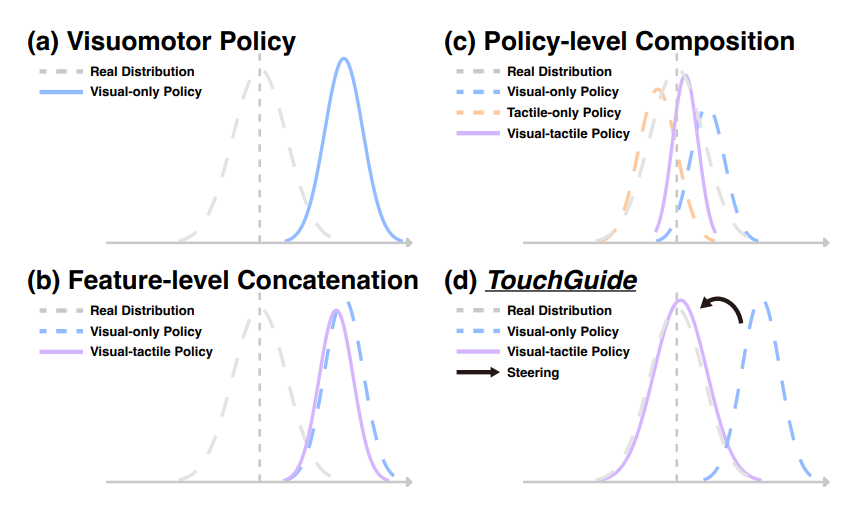
Physical Model $s_{\phi}$ 학습: Tactile 정보를 포함한 observation 값과 그에 맞는 행동 데이터의 점수 최대화를 contrastive learning을 통해 학습 score = $O_t^T a_t$
현재 observation embedding과 정답 action embedding이 가깝도록 (score가 높도록) 학습함
-
Velocity level steering: physical model을 통해서 flow matching의 denoising에서 velocity level에서 steering을 함
$v_{guided} = v_{\theta} + \nabla_{A_t} s_{\phi}$