KTO Model Alignment as Prospect Theoretic Optimization 리뷰
Background
인간의 feedback data를 통해 생성형 모델을 align 시키면 output이 더 도움이 되며, 사실에 기반하며, toxic하지 않아진다. 하지만 대부분 feedback data 중 preference data만 다루는 추세이다.
본 논문은 Kahneman & Tversky가 제시한 Prospect theory를 기반으로 왜 preference data를 사용하여 align하는 방법들 (RLHF, DPO)가 우수한지, 그리고 feedback data가 꼭 preference data 형태로 사용해야 하는지 설명한다. 또, 이런 Prospect theory를 기반으로 한 Alignment 방법도 제시한다.
A Prospect Theoretic View of Alignment
Prospect Theory
Prospect Theory는 인간이 왜 불확실한 상황에서 기댓값을 최대화하는 선택을 하지 않는 지에 대해 설명하는 이론이다. 이 이론을 alignment에 적용하면 사람이 모델 답변을 어떤 bias를 가지고 인식하는 지를 공식화할 수 있다.
이 이론은 원래 사람이 random variable을 어떻게 인식하는 지에 대한 이론이지만 random variable 보다는 모델 답변이라고 하는 것이 더 이해하기 쉽기 때문에 바꿈
이론에 따르면, 어떤 모델 답변에 대한 인간의 효용 판단은 value function과 weighing function으로 이루어진다고 한다.
Value function $V : Z \rightarrow \mathbb{R}$
임의의 기준점 $Z_0$을 기준으로 모델 답변 $Z$의 가치를 판단하는 함수이다. 이 함수는 예를 들어 A만큼의 이익보다 A만큼의 손실에 더 예민하게 반응하는 사람의 경향을 표현한다.
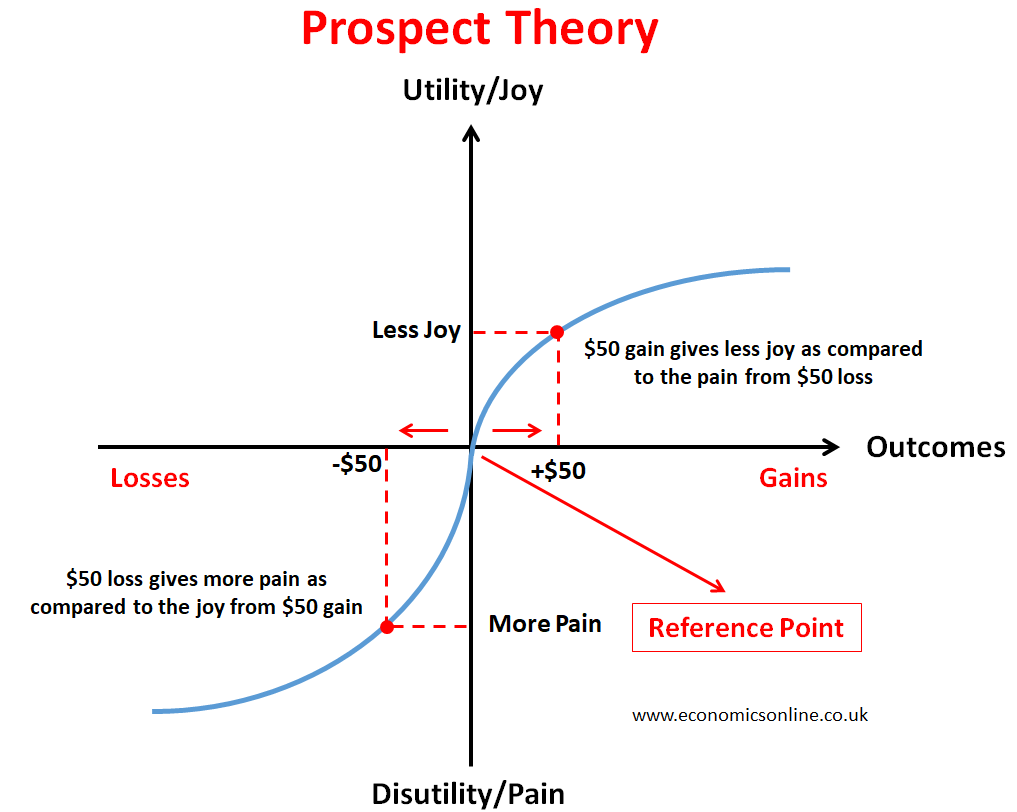
$\alpha$는 curvature를 표현하며 gain이나 loss가 커질수록 가치의 증가율이 감소하게 하여 인간의 risk aversion을 나타낸다.
$\lambda$는 loss 상황에서의 value magnitude가 gain 상황에서의 value magnitude보다 크게 하여 인간의 loss aversion을 표현한다.
Value function이 되기 위해서는 기준점이 존재해야 하며 이익에서는 위로 볼록해야 하고 loss를 싫어하는 사람의 경향을 나타내야 한다.
Weighing Function $w$
어떤 모델 답변이 실제 발생하는 확률이 인간에게는 어떻게 인식되는 지를 나타내는 값이다. 이 함수는 예를 들어 가끔 일어나는 사건들이 발생하는 확률을 보다 크게 인식하는 사람의 경향을 표현한다.
Utility Function
두 함수로 사람이 임의의 모델 답변 z의 효용 판단을 다음 함수로 한다고 한다.
\[u(Z) \triangleq \sum_{z \in Z} w_z \cdot v(z - z_0)\]하지만 인간은 LLM의 전체 probability distribution을 알지 못하므로 무엇이 가끔 일어나는지 등에 대한 정보가 없기 때문에 weighing function은 누락한다.
본 논문은 이처럼 인간이 어떤 bias를 가지고 있는지를 Language model alignment에 반영해야 모델의 output이 더 도움이 되고 사실을 기반으로 하며 toxic하지 않다고 주장한다. 이런 bias를 반영하는 loss function을 본 논문은 HALO라고 부른다.
HALO
학습되는 parameter를 $\theta$, input prompt를 $\mathcal{X}$, 답변을 $\mathcal{Y}$라고 할 때, $\pi_{\theta} : \mathcal{X} \rightarrow p(\mathcal{Y})$은 align되는 모델, $\pi_{ref}$는 reference 모델, $\mathcal{l} : \mathcal{Y} \rightarrow \mathbb{R^+}$은 normalizing factor라고 하자.
그러면 HALO의 reward model은 다음과 같다.
이때, $Q(Y’ \mid x)$을 모델 output $\mathcal{Y}$에 대한 기준 확률 분포라고 하고 $v: \mathbb{R} \rightarrow \mathbb{R}$은 감소하지 않으며 양수일 때 위로 볼록한 함수라고 하자. 그렇다면 인간이 느끼는 가치는 다음과 같다.
\[v(r_{\theta}(x,y) - \mathbb{E_Q}\left[ r_{\theta}(x,y')\right])\]그리고 함수 v를 기반으로 인간이 느끼는 효용 함수 $f$는 다음과 같다.
\[f(\pi_{\theta}, \pi_{ref}) = \mathbb{E_{x,y \sim D}} \left [ a_{x,y} \cdot v(r_{\theta}(x,y) - \mathbb{E_Q}\left[ r_{\theta}(x,y')\right]) \right ] + C_D\]이때, $\exists$ $a_{x,y} \in { -1, +1 }$이고 $D$는 human feedback data, $C_D$는 data-specific constant이다.
이를 해석하면 human feedback이 positive인 data에 대해서는 $a_{x,y} = 1$이므로 x,y에 대해 주는 reward가 기준점보다 커야 하고 human feedback가 negative인 data에 대해서는 reward가 기준점보다 작아야 인간이 느끼는 효용이 최대화된다.
본 논문은 HALO의 reward function $r_{\theta}(x,y)$가 정당하다는 것을 증명한다.
증명 방법: $r_{\theta}(x,y)$을 바탕으로 구한 optimal policy가 현재까지 성공적인 DPO나 RLHF와 동일한 optimal policy를 도출할 수 있다는 것을 보여주어 증명한다.
보상 $r^{\ast}$을 최대화하는 optimal policy $\pi^{\ast}$은 다음 관계식을 만족한다.
\[\pi^{\ast} (y \mid x) = \frac {1} {Z(x)} \pi_{ref} (y \mid x) \cdot exp(\frac {1} {\beta} r^{\ast}(x,y))\]
양변에 log를 씌우고 정리하면
\[log \frac {\pi^{\ast} (y \mid x) } {\pi_{ref} (y \mid x) } = \frac {1} {\beta} r^{\ast}(x,y) - log Z(x)\]
$\beta$를 양변에 곱하면 \(\beta log \frac {\pi^{\ast} (y \mid x) } {\pi_{ref} (y \mid x) } = r^{\ast}(x,y) - \beta log Z(x)\)
이때 HALO의 normalizing factor $\mathcal{l}$의 값이 $\beta$라면
\[r_{\theta}(x,y) = r^{\ast}(x,y) - \beta log Z(x)\]
$r_{\theta}$와 $r^{\ast}$는 동일한 equivalence class에 속하므로 동일한 optimal policy를 도출한다.
따라서 HALO의 reward function은 정당하다.
다른 방법들의 reward function을 그려보면 더 직관적으로 HALO의 reward function이 정당하다는 것을 알 수 있다.
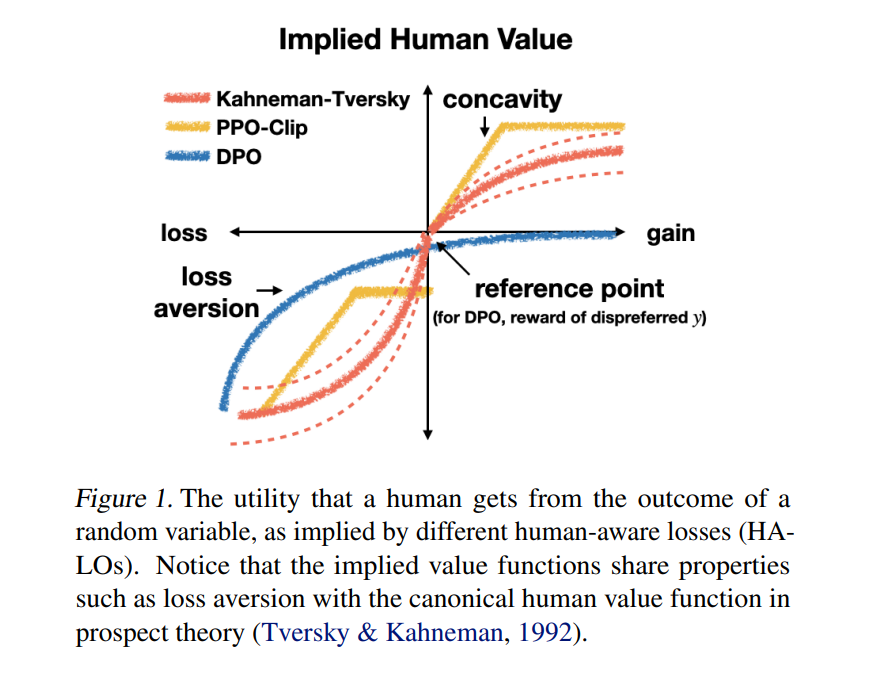
그렇다면 HALO가 사람의 심리적 요소를 더 잘 capture하니까 HALO 기반 alignment 방법들이 non-HALO보다 더 우수할까?
본 논문은 HALO의 효과를 관찰하기 위해 HALO와 non-HALO 기반 alignment 방법들의 align 성능을 평가하고 비교하였다. GPT-4에게 SFT에 사용되는 정답 답안보다 각 방법으로 align된 모델의 답안이 얼마나 선호되는지(win rate으로 표현함)를 측정하였다. 실험 결과는 다음과 같다.
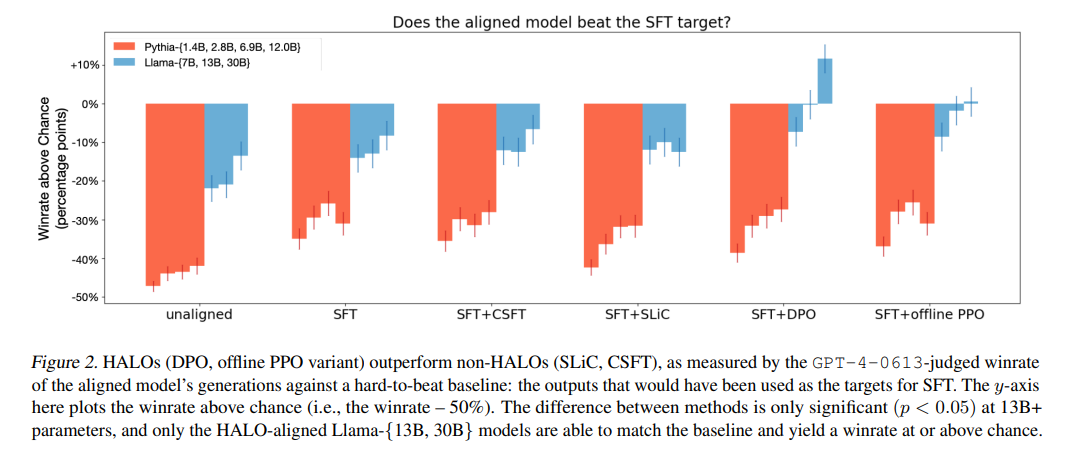
- HALO 기반 alignment 방법들이 win rate가 더 높았다.
$\rightarrow$ HALO 기반 alignment가 더 선호되는 답변을 잘 만들도록 한다는 것을 알 수 있다.
- $y_w$와 $y_l$에게 각각 dummy reward +1/-1만 사용한 PPO가 일반적인 DPO와 성능이 비슷하다.
$\rightarrow$ HALO처럼 사람의 심리적 bias를 잘 반영한 loss function을 사용하다면 reward learning에 큰 비중을 두지 않아도 모델은 align이 잘 된 output을 생성할 수 있다.
HALO의 우수성을 바탕으로 본 논문은 Kahneman-Tversky의 Prospect Theory을 통해 사람의 bias를 최대한 잘 반영한 alignment 방법을 고안하였다.
Kahneman-Tversky Optimization (KTO)
Value function
Kahneman-Tversky의 value function은 다음과 같았다.
\[v(z; \lambda, \alpha, z_0) = \begin{cases} (z - z_0)^\alpha & \text{if } z \ge z_0 \\ -\lambda(z_0 - z)^\alpha & \text{if } z < z_0 \end{cases}\]-
이때, $\alpha$가 risk aversion을 표현하기 위해서는 $0 < \alpha < 1$을 만족해야 한다. 하지만 그대로 optimization에 적용하게 되면 미분할 때 $z - z_0$의 값이 0 근처가 된다면 gradient explosion이 발생하여 불안정하다. 본 논문은 gain에서 위로 볼록하고 loss에서 아래로 볼록한 특징을 살리면서 $\alpha$를 대체하기 위해서 sigmoid $\sigma$ 함수를 사용한다.
-
또, risk aversion의 정도를 반영하기 위해 hyperparameter $\beta$를 사용한다. $\beta$는 다음처럼 이해하면 된다. $\beta$ 값이 클수록 sigmoid $\sigma$의 input의 magnitude가 커지므로 gain일 때는 일정 gain이 넘어가면 효용이 달라지지 않기 때문에 위험을 감수할 가능성이 낮아지고, loss일 때는 일정 loss를 넘어가면 효용이 달라지지 않기 때문에 (잃든 말든 똑같기 때문에) 위험을 감수할 가능성이 높아진다.
-
loss aversion을 표현하는 $\lambda$ 값은 선호되는 답변인지, 비선호되는 답변이지에 따라 다르게 설정하였다 ${ \lambda_D, \lambda_U }$.
$\lambda$의 setting은 KTO의 특징을 반영한 것이다.
1) KTO는 우선 다른 방법들과 다르게 paired preference data를 사용하지 않고 preferred, dispreferred data를 각각 독립적으로 하나의 data instance로 사용한다. 따라서, 고정된 비율이 아니라 data에 따라 달라지도록 하였다.2) dataset이 불균형 (preferred data가 dispreferred data보다 많다던지)을 해결할 수 있다. 데이터가 적은 쪽의 $\lambda$ 값을 키워줌으로써, 적은 양의 데이터라도 모델에게 강한 신호를 주도록 가중치를 조절할 수 있다.
3) 학습의 목표에 따라 세밀한 학습을 할 수 있다. $\lambda_D$는 기존 SFT처럼 정답 확률을 높이는 역할을 하는 hyperparameter로 해석될 수 있고, $\lambda_U$는 오답 확률을 낮추는 역할을 하는 hyperparameter로 해석될 수 있다. 이때, 학습의 목표에 따라 오답을 강하게 처벌($\lambda_U$를 높게)하는 것이 성능 향상에 더 중요하거나, 반대로 정답을 확실히 익히는게 ($\lambda_D$를 높게 더 중요한 경우가 존재하기 때문에 이렇게 분리를 하면 더 자세한 학습이 가능해진다.
이를 모두 반영하여 KTO가 사용하는 value function은 다음과 같다.
\[r_\theta(x, y) = \log \frac{\pi_\theta(y \mid x)}{\pi_{\text{ref}}(y \mid x)}\] \[z_0 = \text{KL}(\pi_\theta(y' \mid x) \parallel \pi_{\text{ref}}(y' \mid x))\] \[v(x, y) = \begin{cases} \lambda_D \sigma(\beta(r_\theta(x, y) - z_0)) & \text{if } y \sim y_{\text{desirable}} \mid x \\ \lambda_U \sigma(\beta(z_0 - r_\theta(x, y))) & \text{if } y \sim y_{\text{undesirable}} \mid x \end{cases}\]KTO Loss function
$\lambda_y$가 y가 desirable output일 때 $\lambda_D$의 값을 갖고, y가 undesirable output일 때 $\lambda_U$의 값을 가진다고 할 때, KTO의 loss function은 다음과 같다.
\[\mathcal{L_{\text{KTO}}} (\pi_{\theta}, \pi_{ref}) = \mathbb{E_{x,y \sim D}} \left[ \lambda_y - v(x,y) \right]\]KTO loss function에 v(x,y)를 대입하면 desirable output의 경우에는 $1 - \sigma(x) = \sigma(-x)$의 성질로 인해 $\mathbb{E_{x,y \sim D}} \left[ \lambda_y \cdot \sigma(\beta(z_0 - r_{\theta}(x,y))) \right]$가 된다. 이 loss function을 minimize하기 위해서는 desirable output y에 높은 reward을 주어야 한다. 반대 상황 $\mathbb{E_{x,y \sim D}} \left[ \lambda_y \cdot \sigma(\beta(r_{\theta}(x,y) - z_0)) \right]$에는 undesirable output y에 낮은 reward을 주어야 loss function이 minimize 된다.
KTO의 loss function을 직관적으로 이해하면 다음과 같다. 모델이 desirable example에 과도한 reward을 준다면 KL penalty 값도 커져서 loss가 원하는만큼 작아지지 않는다. 이런 방법으로 KTO alignment는 모델이 정확하게 무엇이 ouput을 desirable하게 만드는지 학습할 수 있다.
기준점 $z_0$ 구하기
이때, KTO는 DPO처럼 기준점을 하나의 dispreferred datapoint로 설정하는 framework를 따르지 않았다. 왜냐하면 본 논문은 사람은 prompt x에 대해 가능한 모든 output들로 기준점을 세울 것이라고 가정했기 때문이다.
$z_0$을 계산하기 위해서는 prompt x에 대한 모든 답변 y’들을 $\pi_{\theta}$로부터 sampling을 해서 비교대상 분포 Q를 구해야 한다.
이때 $r_{\theta}(x,y’) = \log \frac {\pi_{\theta} (y_j \mid x_i)} {\pi_{ref} (y_j \mid x_i)}$이므로
\[z_0 = \mathbb{E_{y' \sim Q}} \left [ r_{\theta}(x,y') \right ] = \mathbb{E_{y' \sim Q}} \left [ \log \frac {\pi_{\theta} (y_j \mid x_i)} {\pi_{ref} (y_j \mid x_i)}\right ] = \mathbb{E_{y' \sim Q}} \text{KL} \left [ \pi_{\theta} \parallel \pi_{ref} \right ]\]하지만, 모든 output들을 고려하는 것은 cost effective하지 않기 때문에 $z_0$을 추정치 $\hat z_0$ 값으로 대체하였다. $j = (i+1) \text{ mod m}$이라고 할 때, $\hat z_0$는 다음처럼 계산한다.
\[\hat z_0 = max (0, \frac {1} {m} \sum_{1 \le i < m} \log \frac {\pi_{\theta} (y_j \mid x_i)} {\pi_{ref} (y_j \mid x_i)})\]학습 batch 내에서 답변만 바꿔치기하여 답변들의 보상의 평균값을 계산하여 $\hat z_0$을 대체하였다. 이렇게 계산하는 이유는 $z_0$의 값은 prompt x에 대한 모든 답변 y’들의 보상값의 평균으로 대체할 수 있는데 어떻게 보면 무작위 답변 y’의 평균 보상값이기 때문이다. 본 논문은 이 방법이 bias가 있지만 오히려 실제로 인간도 bias를 갖고 있으므로 정당한 기준점이 된다고 주장한다.
이때 preference data에 대해 SFT를 한 뒤에 KTO를 한다면, $\pi_{\theta}$는 이미 $\pi_{ref}$와 비슷하므로 KL divergence 값이 0에 근접할 것이므로 기준점 $z_0$을 바로 0으로 설정해도 된다고 한다. 하지만 SFT를 하지 않은 경우에는 기준점이 무조건 필요하다고 주장한다.
Data
- 특정 답변이 desirable/undesirable 한지만 남기고 pair 형식을 버림
- pair 형식을 아예 버리기 위해 하나의 prompt에 대해서 $y_w, y_l$ 중 하나만 dataset에 포함시켰다.
Hyperparameter
-
KTO의 reward magnitude는 DPO보다 작기 때문에 Loss function의 derivative 값이 상대적으로 작다. 따라서 DPO의 learning rate보다 2배~10배 큰 learning rate를 사용한다.
-
또, risk aversion hyperparameter $\beta$는 SFT를 이미 거친 큰 모델에 대해서는 작은 값 [0.01, 0.1]을, SFT를 거치지 않은 작은 모델에 대해서는 큰 값 [0.10, 1.00]을 사용하는 것이 성능이 좋다.
실험 결과
KTO와 다른 alignment 방법들을 HALO vs non-HALO 실험처럼 비교하였다.
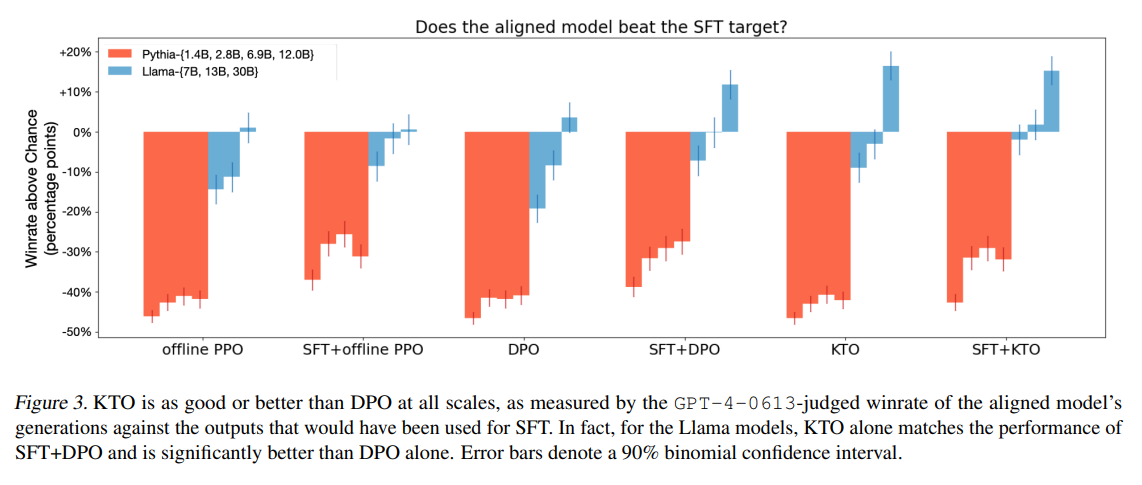
KTO $\ge$ DPO
- SFT+KTO는 weak binary reward signal을 사용했음에도 불구하고 SFT+DPO와 1B~30B에서 성능이 맞먹는다.
- Llama 7B, 13B, 30B에서는 KTO가 DPO보다 성능이 좋다.
- Pythia에서는 성능 차이가 없는 것으로 보아 KTO와 DPO가 차이가 나기 위해서는 모델의 용량이 커야지 나타난다고 해석할 수 있다.
KTO는 큰 모델에서 SFT를 필요로 하지 않는다.
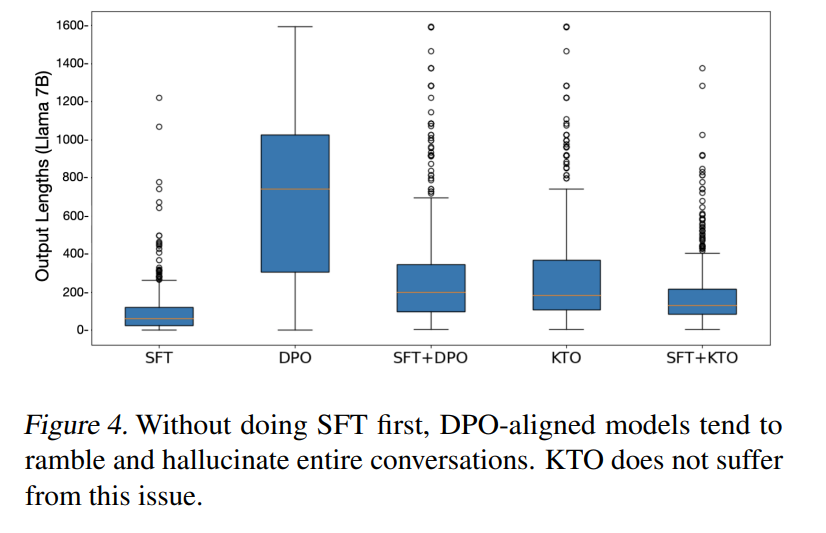
- SFT를 한 뒤의 KTO와 KTO만 한 model 성능이 Llama 13B, 30B에서 차이가 없다. 이런 효과를 보이는 alignment 방법은 처음이다. KTO가 SFT를 하지 않아도 되는 이유는 KTO는 hallucination, 의미없는 말 나열하는 경향을 없애 기 때문이다. 이는 답변의 길이가 일정하다는 것을 통해 증명된다.
KTO의 성능은 preference data 덕분이 아님
KTO가 DPO나 다른 방법들보다 우수한 이유가 남들은 n개의 paired data를 사용할 때 혼자 2n개의 data를 사용해서 그런지 알아보았다.
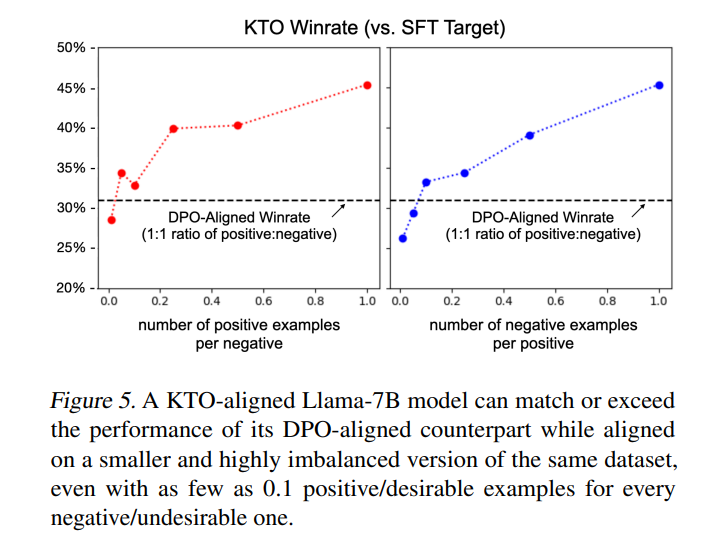
desirable data의 90%을 없애고 학습해도 DPO보다 성능이 좋았다.
전체 training data의 72%을 없애도 DPO보다 여전히 뛰어났다.
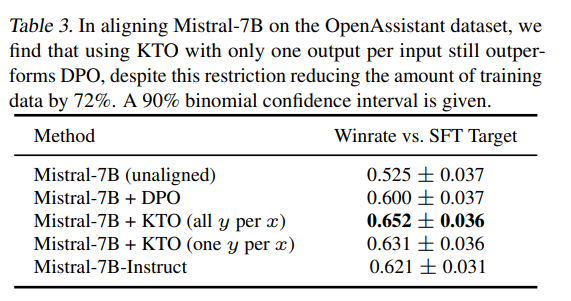
이 결과를 통해 KTO는 paired preference dataset가 필요없다는 것을 보여준다.
KTO 이론적 분석
KTO는 data 수가 적거나 unbalanced한 dataset에서도 DPO보다 성능이 좋다. KTO의 성능적 우세를 더 정확히 알아내기 위해 KTO를 수학적으로 분석해본다.
KTO는 noisy한 dataset에 강하다
수학적으로, KTO는 noisy한 dataset에 강하다. 이는 다음 Proposition의 증명을 통해 알 수 있다.
Proposition: As the reward implied by the current policy tends to ±∞, the KTO update of πθ tends to zero.
$r_{\theta}(x,y)$가 $\pm \infty$일 때 $\theta$의 update가 안 되는 경향이 있다.
proof)
**
$z = r_{\theta}(x,y) - z_0$로 치환하고 $\theta$에 대해 미분할 때, sigmoid의 성질에 따라 $\sigma’(x) = \sigma(x) \cdot (1 - \sigma(x))$이므로
\[\nabla_{\theta} \mathcal{L_{\text{KTO}}} = \mathbb{E_{x,y \sim D}} \left [ -\lambda_D \cdot \beta \cdot \underbrace {\sigma(\beta z) \cdot (1 - \sigma(\beta z))}_{\text {becomes 0}} \cdot \nabla_{\theta} (\log \pi_{\theta} (y \mid x) - \log \pi_{ref} (y \mid x))\right ]\]이때, $r_{\theta} \rightarrow \infty$일 때 $z \rightarrow \infty$이므로 $1 -\sigma(\beta z) \rightarrow 0$이 된다. 따라서 이때의 gradient는 0이 되어 $\theta$가 update되지 않는다.
또, desirable output이 undesirable하다고 잘못 label되어 학습하기 어려운 경우, reward function이 -$\infty$에 가까운 값을 갖게 된다. $r_{\theta} \rightarrow -\infty$일 때 $z \rightarrow -\infty$이므로 $\sigma(\beta z) \rightarrow 0$이 된다. 따라서 이때도 gradient는 0이 되어 $\theta$가 update되지 않는다.
**
너무 쉬운 경우, reward function이 $-\infty$에 가까운 값을 갖게 된다. 이때 gradient가 0이 된다.
\[\mathcal{L_{\text{KTO}}} = \mathbb{E_{x,y \sim D}} \left [ \lambda_U - \lambda_U \cdot \sigma(\beta(z_0 - r_{\theta}(x,y))) \right ]\]$z = z_0 - r_{\theta}(x,y)$로 치환하고 $\theta$에 대해 미분할 때, sigmoid의 성질에 따라 $\sigma’(x) = \sigma(x) \cdot (1 - \sigma(x))$이므로
\[\nabla_{\theta} \mathcal{L_{\text{KTO}}} = \mathbb{E_{x,y \sim D}} \left [ \lambda_U \cdot \beta \cdot \underbrace {\sigma(\beta z) \cdot (1 - \sigma(\beta z))}_{\text {becomes 0}} \cdot \nabla_{\theta} (\log \pi_{\theta} (y \mid x) - \log \pi_{ref} (y \mid x))\right ]\]이때, $r_{\theta} \rightarrow -\infty$일 때 $z \rightarrow \infty$이므로 $1 -\sigma(\beta z) \rightarrow 0$이 된다. 따라서 이때의 gradient는 0이 되어 $\theta$가 update되지 않는다.
또, undesirable output이 desirable하다고 잘못 label되어 학습하기 어려운 경우, reward function이 -$\infty$에 가까운 값을 갖게 된다. $r_{\theta} \rightarrow -\infty$일 때 $z \rightarrow \infty$이므로 $1 -\sigma(\beta z) \rightarrow 0$이 된다. 따라서 이때도 gradient는 0이 되어 $\theta$가 update되지 않는다.
이처럼 KTO는 noisy하거나 mislabel된 데이터에 대해 fitting되는 것을 피한다. 즉, 배울만한 것이 있는 데이터에 대해서만 학습을 하기 때문에 KTO의 성능이 우수한 것이다.
Data들을 너무 무시하게 되어 underfitting이 발생하면 $\beta$값을 낮추거나 epoch를 늘리면 된다.
Preference likelihood을 최대화하는 것은 인간이 느끼는 효용성(utility) / 가치 (value)를 최대화하는 것과 다르다
Theorem: Assuming the value function is logistic, for a reward function $r^{\ast}_a$ that maximizes (2), there exists a reward function in its equivalence class (i.e.,$r^{\ast}_b$ (x, y) = $r^{\ast}_a$ (x, y) + h(x) for some h(x)) that induces the same optimal policy $\pi^{\ast}$ and the same Bradley-Terry preference distribution but a different human value distribution.
DPO나 RLHF나 모두 reward model이 동일한 equivalence class하면 동일한 optimal policy와 동일한 선호도 예측을 도출한다고 알려져있다. 이유는 Bradley Terry model을 사용해서 pair data의 reward의 difference를 계산하기 때문에 input specific component가 의미가 없어지기 때문이다. 하지만 인간이 느끼는 효용성을 계산할 때는 Bradley Terry model을 사용하지 않기 때문에 input specific component 값도 optimal policy를 구할 때와 사람이 느끼는 가치 계산에 영향을 준다. 따라서, preference likelihood을 최대화하는 DPO나 PPO는 인간이 느끼는 효용성 / 가치를 최대화하는 방법이 아니다.
proof)
두 reward function $r_{b}^{\ast}, r_{a}^{\ast}$가 동일한 equivalence class여서 $r_{b}^{\ast}(x,y) = r_{a}^{\ast}(x,y) + h(x)$을 만족한다고 하자. 이 둘이 동일한 optimal policy와 preference distribution을 도출하지만 인간이 느끼는 가치의 distribution는 다르다는 것을 통해 theorem을 증명한다.
다음 내용은 DPO에서도 나온 내용이다.
우선, 동일한 equivalence class의 reward function은 동일한 preference distribution을 도출한다는 것을 증명한다.
\[p_{r_b^{\ast}}(\gamma \mid y_1, .. y_K, x) = \prod_{k=1}^{K} \frac {\exp(r_b^{\ast}(x, y_{\gamma (k)}))} {\sum_{j=k}^{K} \exp(r_b^{\ast}(x, y_{\gamma(j)}))}\]여기서 $r_a^{\ast}(x,y) + h(x) = r_b^{\ast}(x,y)$을 대입하면
\[p_{r_b^{\ast}}(\gamma \mid y_1, .. y_K, x) = \prod_{k=1}^{K} \frac {\exp(r_a^{\ast}(x, y_{\gamma (k)}) + h(x))} {\sum_{j=k}^{K} \exp(r_a^{\ast}(x, y_{\gamma(j)}) + h(x))}\]지수 법칙에 의해 항을 분리하면
\[p_{r_b^{\ast}}(\gamma \mid y_1, .. y_K, x) = \prod_{k=1}^{K} \frac {\exp(h(x)) \cdot \exp(r_a^{\ast}(x, y_{\gamma (k)}))} {\sum_{j=k}^{K} \exp(h(x)) \cdot \exp(r_a^{\ast}(x, y_{\gamma(j)}))}\]$h(x)$는 합의 인덱스 $j$와 무관하므로 밖으로 묶어내어 분모/분자 소거가 가능함
\[p_{r_b^{\ast}}(\gamma \mid y_1, .. y_K, x) = \prod_{k=1}^{K} \frac {\exp(r_a^{\ast}(x, y_{\gamma (k)}))} {\sum_{j=k}^{K} \exp(r_a^{\ast}(x, y_{\gamma(j)}))} = p_{r_a^{\ast}}(\gamma \mid y_1, .. y_K, x)\]따라서, reward function $r_a^{\ast}$와 $r_b^{\ast}$ 둘 다 동일한 preference distribution을 도출한다는 것이 증명된다.
다음으로 reward function $r_a^{\ast}$와 $r_b^{\ast}$ 둘 다 동일한 optimal policy를 도출한다는 것을 증명한다.
\[\begin{align*} \pi^{\ast}_{r_a}(y \mid x) &= \frac{1}{Z(x)} \pi_{\text{ref}}(y \mid x) \exp \left( \frac{1}{\beta} r^{\ast}_a(x, y) \right) \\ &= \frac{\pi_{\text{ref}}(y \mid x) \exp \left( \frac{1}{\beta} r^{\ast}_a(x, y) \right) \exp \left( \frac{1}{\beta} h(x) \right)}{\sum_{y} \pi_{\text{ref}}(y \mid x) \exp \left( \frac{1}{\beta} r^{\ast}_a(x, y) \right) \exp \left( \frac{1}{\beta} h(x) \right)} \\ &= \frac{\pi_{\text{ref}}(y \mid x) \exp \left( \frac{1}{\beta} (r^{\ast}_a(x, y) + h(x)) \right)}{\sum_{y} \pi_{\text{ref}}(y \mid x) \exp \left( \frac{1}{\beta} (r^{\ast}_a(x, y) + h(x)) \right)} \\ &= \pi^{\ast}_{r_b}(y \mid x) \end{align*}\]따라서, 동일한 equivalence에 속하는 reward function $r_a^{\ast}$와 $r_b^{\ast}$ 둘 다 동일한 optimal policy를 도출한다는 것을 증명하였다.
하지만 이 두 reward function은 다른 human value distribution을 도출한다는 것을 증명한다. 증명 과정은 0에서의 두 reward function의 taylor series가 항상 같지 않다는 것을 통해 human value 값이 다르다는 것을 증명한다.
0에서의 $r^{\ast}_a(x,y)$의 human value의 taylor series는 다음과 같다.
\(\sigma(0) + \sigma'(0)(r^{\ast}_a(x, y) - z_0) + \frac{\sigma''(0)}{2}(r^{\ast}_a(x, y) - z_0)^2 + \dots\)
반대로 0에서의 $r^{\ast}_b(x,y) = r^{\ast}_a(x,y) + h(x)$의 human value의 taylor series는 다음과 같다.
\[\sigma(h(x)) + \sigma'(h(x))(r^{\ast}_a(x, y) - z_0) + \frac{\sigma''(h(x))}{2}(r^{\ast}_a(x, y) - z_0)^2 + \dots\]$\sigma$는 단조 증가 함수이기 때문에 이 두 taylor series가 같기 위해서는 h(x)=0을 만족해야한다. 그렇지 않다면 $r^{\ast}_b(x,y)$와 $r^{\ast}_a(x,y)$의 값은 다르다. 따라서, 동일한 equivalence class에 있다고 동일한 human value distribution을 도출하는 것이 아니다.
Taylor series 값이 다르므로 Human value distribution이 다르다고 말한 것은, 두 reward function의 구체적인 기울기와 곡률이 다르면, 비록 두 대소 관계 (Bradley Terry model 기반 선호도 관계)가 유지되더라도 인간이 실제로 느끼는 가치의 강도나 분포는 전혀 다른 상태이다 라는 것이다.
이런 이유 때문에 실제 인간에게 DPO와 KTO의 답변을 비교해달라고 했을 때, KTO를 더 선호하는 경향이 GPT-4가 KTO를 더 선호하는 경향보다 매우 강했다.
DPO의 optimal policy는 비선호되는 답변을 생성할 수 있지만 KTO는 그럴 수 없다
Theorem For input $x$ with outputs ${y_a, y_b}$, let dataset $\mathcal{D}$ comprise contradictory preferences $y_a \succ y_b$ and $y_b \succ y_a$ in proportion $p \in (0.5, 1)$ and $(1 - p) \in (0, 0.5)$ respectively. If
\[p^{1/\beta}\pi_{\text{ref}}(y_a \mid x) < (1 - p)^{1/\beta}\pi_{\text{ref}}(y_b \mid x)\]then the optimal DPO policy is more likely to produce the minority-preferred $y_b$; the optimal KTO policy will strictly produce the majority-preferred $y_a$ for a loss-neutral value function ($\lambda_D = \lambda_U$).
desirable output을 선택할 확률 p가 작고 reference model이 제대로 align되어있지 않다면, DPO는 비선호되는 답변을 생성할 수 있다. 하지만 KTO는 그런 상황이 존재하지 않는다.
proof)
Loss function을 $\theta$에 대해 미분하였을 때, 미분값이 0이 되는 지점 (Loss가 최소인 지점, 즉 optimal policy일 때)에서 DPO의 optimal policy와 KTO의 optimal policy가 어떤 결과를 생성할 수 있는지 관찰하여 이 theorem을 증명한다.
DPO의 경우
$y_a$가 preferred, $y_b$가 unpreferred ouput, p는 답변이 어떤 label을 지녔는지를 맞추는 확률이라고 할 때, $p \in (0.5, 1)$, $1-p \in (0, 0,5)$라고 하고 $u = \beta (r_{\theta} (x,y_a) - r_{\theta} (x,y_b))$ 라고 하자.
\[\mathcal{L_{\text{DPO}}} = \mathbb{E_{(x, y_a, y_b) \sim \text{D}}} \left[- \log \sigma (\beta (r_{\theta} (x,y_a) - r_{\theta} (x,y_b))) \right]\] \[= \mathbb{E_{(x, y_a, y_b) \sim \text{D}}} \left[- \log \sigma (u) \right]\]기댓값의 정의에 따라 이 값은 다음과 같이 계산할 수 있다.
\[p(-\log \sigma (u)) + (1-p)( - \log \sigma(-u))\]u에 대해 미분하여 derivative가 0이 되는 지점을 보면 (optimal policy 지점)
\[\nabla_u \mathcal{L_{\text{DPO}}} = 0 = -p \cdot \frac {\sigma(u) \cdot \sigma(-u)} {\sigma(u)} + (1-p) \cdot \frac {\sigma(u) \cdot \sigma(-u)} {\sigma(-u)}\] \[= -p \cdot \sigma(-u) + (1-p) \cdot \sigma(u)\] \[= -p + \sigma(u)\]이때, 이 $\sigma$는 단조 증가함수이므로 역함수가 존재한다.
\[0 = -p + \sigma(u)\] \[\sigma^{-1}(p) = u\]이때 $u = \beta (r_{\theta^{\ast}} (x,y_a) - r_{\theta^{\ast}} (x,y_b))$이므로
\[\beta (r_{\theta^{\ast}} (x,y_a)) = \sigma^{-1}(p) + \beta(r_{\theta^{\ast}} (x,y_b))\]$\sigma^{-1}(x) = log \frac {x} {1-x}$이므로
\[\beta \log \frac{\pi^{\ast}_\theta(y_a \mid x)}{\pi_{\text{ref}}(y_a \mid x)} = log \frac {p} {1-p} + \beta \log \frac{\pi^{\ast}_\theta(y_b \mid x)}{\pi_{\text{ref}}(y_b \mid x)}\]log을 다 벗기면
\[\pi^{\ast}_\theta(y_a \mid x) = \underbrace {(\frac {p} {1-p})^{1/\beta} \cdot \frac {\pi_{\text{ref}}(y_a \mid x)} {\pi_{\text{ref}}(y_b \mid x)}}_{\text{t}} \cdot \pi^{\ast}_\theta(y_b \mid x)\]이때 t 값이 1보다 작다면, 즉 p가 너무 낮고 reference model이 제대로 align되어있지 않다면, 선호되는 output을 출력할 확률 $\pi_{\theta}^{\ast} (y_a \mid x)$ < 비선호되는 output을 출력할 확률 $\pi_{\theta}^{\ast} (y_b \mid x)$을 만족하게 된다.
따라서, DPO의 optimal policy는 상황에 따라 비선호되는 output $y_b$를 출력하는 policy가 될 수 있다.
KTO의 경우
$u_a = \beta(r_{\theta}(x, y_a) - \mathbb{E_Q}[r_{\theta}(x, y’)])$고 $u_b = \beta(r_{\theta}(x, y_b) - \mathbb{E_Q}[r_{\theta}(x, y’)])$라고 할 때 $\sigma$의 성질 $1 - \sigma(-u) = \sigma(u)$을 통해 x에 대한 KTO의 loss를 다음처럼 바꿀 수 있다.
\[\mathcal{L_{\text{KTO}}}(x)= \mathbb{E_{x,y \sim D}} \left[ \lambda_y - v(x,y) \right]\] \[\mathcal{L_{\text{KTO}}}(x) = \mathbb{E_{x,y \sim D}} \left[ \lambda_D (1 - \sigma(\beta(r_{\theta}(x, y_a) - z_0))) + \lambda_U (1 - \sigma(\beta(z_0 - r_{\theta}(x, y_b)))) \right]\]기댓값의 정의에 따라 기댓값을 계산하면,
\[\mathcal{L_{\text{KTO}}}(x) = p\lambda_D(1 - \sigma(u_a)) + (1 - p)\lambda_D(1 - \sigma(u_b)) + (1 - p)\lambda_U \sigma(u_a) + p\lambda_U \sigma(u_b)\]$\sigma(u_a), \sigma(u_b), \lambda_D, \lambda_U$에 대해 정리하면,
\[= p\lambda_D + ((1 - p)\lambda_U - p\lambda_D)\sigma(u_a) + (1 - p)\lambda_D + (p\lambda_U - (1 - p)\lambda_D)\sigma(u_b)\]식을 계산하면,
\[= \lambda_D + ((1 - p)\lambda_U - p\lambda_D)\sigma(u_a) + (p\lambda_U - (1 - p)\lambda_D)\sigma(u_b)\] \[= \lambda_D + \lambda_D((1 - 2p)\sigma(u_a) + (2p - 1)\sigma(u_b)) (\text{under loss neutrality } \lambda_D = \lambda_U)\]이때, p가 0.5보다 크다는 가정 하에, $u_a$이 클수록, 즉 desirable 답변에 주는 reward가 클수록, loss는 감소한다. 한편, $u_b$가 클수록, 즉 undesirable 답변에 주는 reward가 클수록, loss는 커진다.
따라서 KTO의 policy가 loss를 최소화하기 위해서는 1) $u_a$를 최대화하기 위해 $\pi_{\theta}(y_a \mid x)$는 1로 수렴해야 하고 2) $u_b$를 최소화하기 위해 $\pi_{\theta}(y_b|x)$가 $0$으로 가야 한다. 확률의 합 $\pi_{\theta}(y_a \mid x) + \pi_{\theta}(y_b \mid x)$은 1이어야 하므로, 이를 만족하는 유일한 policy는 $\pi_\theta(y_a|x) = 1$, $\pi_\theta(y_b|x) = 0$을 만족하는 policy이다.
즉, 답변의 label을 판단할 확률이 조금만 좋아도 ($p>0.5$만 만족하면) KTO의 optimal policy $\pi^{\ast}_\theta(y \mid x)$는 항상 desirable output을 생성한다.
\[\pi^{\ast}_{\theta}(y|x) = \mathbb{1}[y = y_a]\]