The Lessons of Developing Process Reward Models in Mathematical Reasoning 리뷰
Background
LLM은 수학 추론에 큰 진전을 보이고 있지만 여전히 논리적 / 계산 실수를 한다. 답은 맞추더라도 추론 과정이 그럴 듯 하게 틀리거나 아예 틀리는 경우가 빈번하다. 따라서 Language model의 풀이 step들을 채점해서 어디서 틀렸는지 알려줄 수 있는 Process Reward Model (PRM) 의 중요성이 부각되고 있다.
이때, PRM을 얻는 과정에는 여러 문제점들이 존재한다.
PRM 학습 data 구성 방법
답안의 각 step을 문제를 바탕으로 평가하기 위해서는 human feedback으로 직접 평가하는 것이 제일 reliable하고 효과적인 방법이다. 하지만 이 방법은 cost가 너무 높다.
$\rightarrow$ 이를 해결하기 위해 Monte Carlo Method (MC) 를 적용하여 각 step이 올바른 최종 답으로 유도할 확률을 예측하여 data annotation을 하는 방법이 일반적이다.
PRM을 정확하게 평가할 방법 부재
PRM의 성능을 측정하기 위해 보통 Best-of-N (BoN) 방법을 사용한다.
Best of N은 Policy로부터 sampling된 여러 답변들 중에서 PRM 점수가 가장 높은 답변의 최종 답이 실제 답과 같은지 비교하여 PRM이 올바른 답변을 골라낼 수 있는 능력이 있는지 평가하는 방법이다.
Best of N은 stepwise 평가가 불가능하기 때문에 PROCESS BENCH라는 benchmark도 존재한다.
PROCESS BENCH는 단계별 풀이 과정이 주어졌을 때, 첫 번째 오류가 발생하는 지점을 찾아낼 수 있거나 모든 단계들이 맞다면 옳은 풀이라고 판단할 수 있는지 평가하는 방법이다.
Preliminary Trials
본 논문은 conventional한 방법 (MC estimation으로 학습 dataset을 구성하는 방법과 Best-of-N으로 평가하는 방법)으로 PRM을 얻으면 생기는 문제점을 실험으로 보여준다.
Training Setup
Training data synthesis
Traning data를 구성하기 위해 전형적인 MC estimation 기반 방법은 Math Shepard을 적용한다.
- 정확한 답이 존재하는 50k개의 수학 문제를 준비한다.
- Qwen2-Math-Instruct와 Qwen2.5-Math-Instruct으로 각 문제에 대해 6~8개의 풀이를 생성하도록 한다.
- delimiter \n\n으로 풀이를 step 단위로 나눈다.
- 특정 step i를 평가하기 위해 그 step부터 풀이를 이어가도록 completion을 8번 진행한다. 이 completions 중 몇 개가 올바른 답을 도출했는지를 바탕으로 step i의 label을 결정한다.
이때, label 결정 방법에는 hard와 soft으로 나뉜다. Hard label은 8개의 completions 중 하나라도 올바른 답을 도출한다면 positive, 다 틀리면 negative으로 label을 하는 방법이다. 반면 soft label은 8개의 completions 중 정답을 맞춘 비율로 label을 하는 방법이다.
Evaluation Setup
PRM을 두 척도로 평가한다. 첫 번째 척도는 PRM이 답을 맞춘 답안을 알아낼 수 있는지 이다. 두 번째 첫도는 PRM이 풀이 steps 중 틀린 step을 알아낼 수 있는지 이다.
첫 번째 척도는 Best-of-N으로 평가를 한다. 이때, 하나의 풀이의 점수는 각 step들이 PRM으로부터 받은 점수들의 곱으로 계산한다. PRM이 가장 좋은 풀이를 알아낼 수 있는지를 평가하는 것이기에 baseline으로 majority voting을 사용한다.
두 번째 척도는 PROCESS BENCH으로 평가한다. 오류가 발생하는 첫 번째 step을 맞추거나 모든 과정이 맞는지 맞추는 것이다.
Evaluation Results
비교 baseline으로 PRM-800k(human feedback labeling)을 학습한 Qwen2.5-Math-7B-PRM-PRM800K을 사용하였다.
다음은 BoN 결과이다.
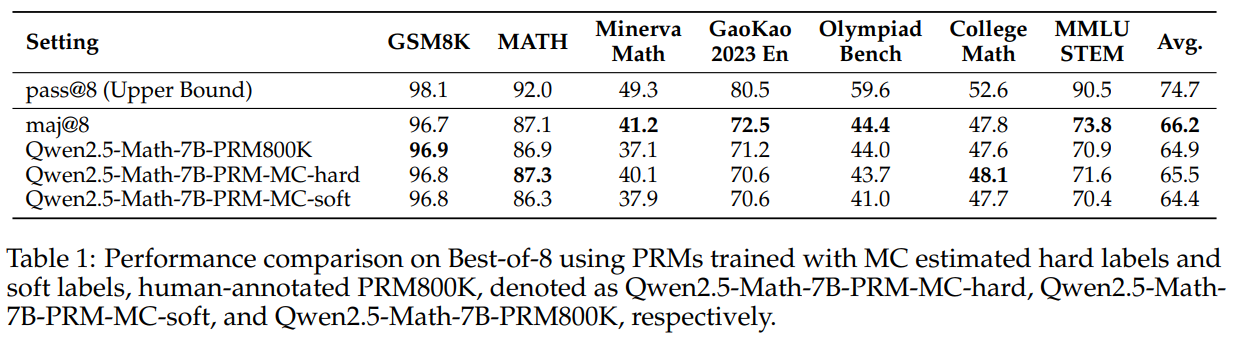
- 모든 PRM이 maj@8보다 낮게 나왔다.
다음은 PROCESS BENCH 결과이다.
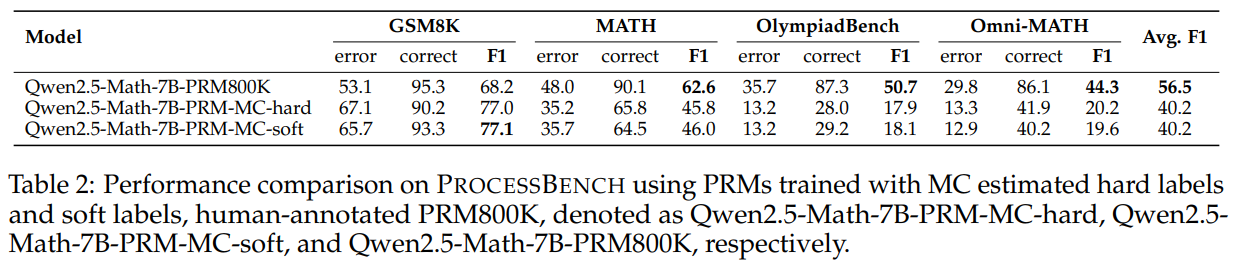
PROCESS BENCH에서 hard / soft labeling을 적용한 모델 모두 human annotated data로 학습한 Qwen2.5-Math-7B-PRM-PRM800K보다 더 많은 학습 data를 사용했음에도 결과가 좋지 않았다.
The Lessons
본 논문은 이 실험 결과가 현재 사용되는 MC estimation 기반 data synthesis 방법과 evaluation 방법에 한계점이 존재한다는 것을 보여준다고 주장한다.
Limiations of MC estimation for PRM Training
Distinguishing PRMs from Value Models
PRM의 목표는 풀이 과정의 각 step이 맞는지 평가하는 것이다. 반면 value model은 각 step의 유용성 (potential of reaching the correct final answer from the current step in the future)을 예측하는 것이다. 즉, PRM은 각 step이 옳은지 틀린지를 명확하게 판단하는 모델이고 Value model은 각 step이 얼마나 유용한지 값어치를 매기는 모델인 것이다.
하지만 MC estimation을 바탕으로 풀이의 step들을 labeling을 할 경우, PRM 학습 과정에 value model의 목표를 사용하는 것이라고 볼 수 있게 되는 것이다. 이 방법은 결국 human annotation으로 학습한 모델에 비해 성능 및 일반화 능력 저하를 야기한다. 특히, 틀린 step을 찾아내는 능력의 저하를 야기한다고 주장한다.
MC Estimation vs. LLM-as-a-judge vs. Human Annotation
이를 증명하기 위해 세 가지 방법 MC estimation, LLM as a judge, human annotation으로 data construction을 하고 동일한 base model이 이에 대해 각각 따로 학습하도록 하고 BoN과 PROCESS BENCH으로 평가하였다.
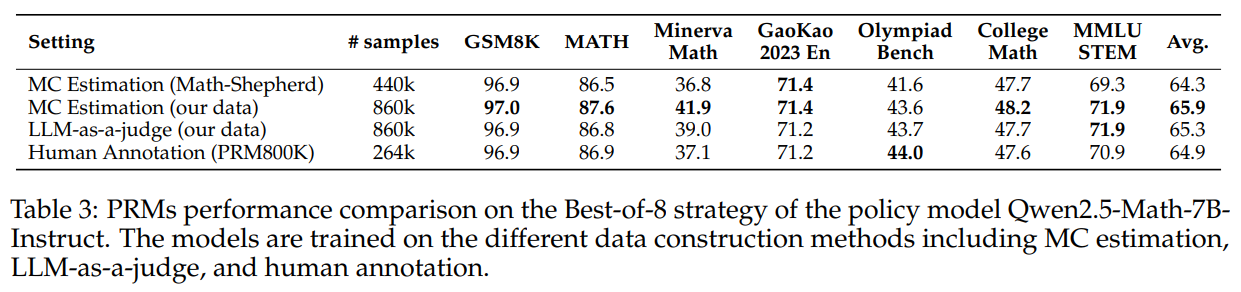
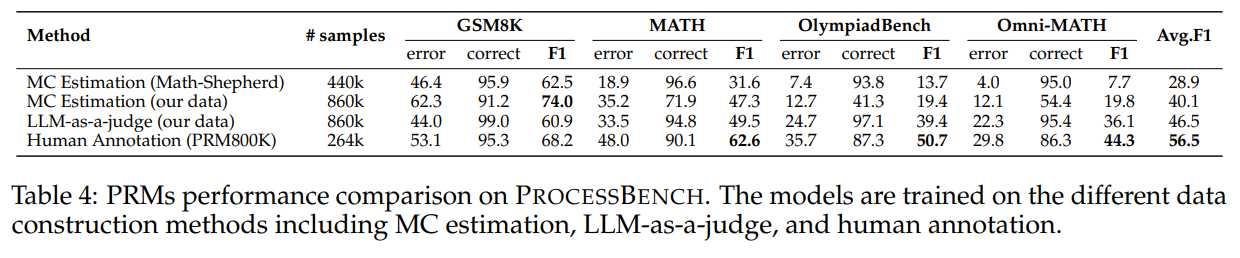
BoN 결과를 보면 MC estimation을 적용한 모델이 Human annotation을 적용한 모델보다 성능이 좋다.
하지만 PROCESS BENCH 결과를 보면 human annotation > LLM as a judge > MC estimation 순서로 성능 순위가 정해지는 것을 볼 수 있다.
이 두 평가 방법에서 MC 방법과 human annotation 방법의 반대되는 performance 관계를 보인다. 본 논문은 이 관계를 통해 Best of N 평가 방법이 정당하지 않다고 생각하게 되었다고 한다.
Stringent Data Filtering Mechanisms Required in MC Estimation
본 논문은 MC 기반 방법을 적용했을 때 PROCESS BENCH에서 나타나는 낮은 성능은 MC estimation의 reasoning steps의 correctness 예측은 policy model에 과도하게 의존하기 때문에 학습 data에 높은 noise가 생기기 때문이라고 주장한다. 예를 들어 policy model이 생성한 풀이의 과정은 틀리지만 최종 답안이 맞는 경우에 MC estimation 특성 상 각 step에 높은 점수를 주게 된다.
따라서, 본 논문은 이런 noise가 많은 data가 없어진다면 MC estimation을 적용한 모델의 성능이 향상될 것이라고 가설을 세웠다. 그래서 LLM as a judge 모델이 PROCESS BENCH에서 보여준 준수한 성능을 바탕으로 consensus (합의) filtering mechanism을 고안했다. 이 filtering은 학습 data의 noise를 없애기 위해 LLM과 MC estimation 둘 다 어떤 풀이의 모든 step에 대한 의견이 같을 때만 그 풀이를 학습 dataset에 포함시키는 과정이다. 통계적인 관점과 논리적인 관점이 일치하는 data만 보존하는 방법이라고 보면 된다.
이런 filtering을 적용하면 training dataset이 60%만큼 줄어드는데도 LLM as a judge 모델과 비슷한 성능을 보이고 기존 MC 모델은 능가한다. 이를 통해 MC estimation 학습 data의 noise를 줄이면 PRM의 성능이 좋아진다는 것을 알 수 있게 되었다.
Hard Label vs. Soft Label in MC Estimation
본 논문은 여기서 멈추지 않고 MC estimation 기반 PRM을 학습할 때, Hard label와 soft label 중 어떤 것이 더 효과적인지 파악하고자 하였다. 앞서 제시된 consensus filtering mechanism을 적용한 dataset에 hard label와 soft label을 하여 PRM을 학습시키고 비교하였다.
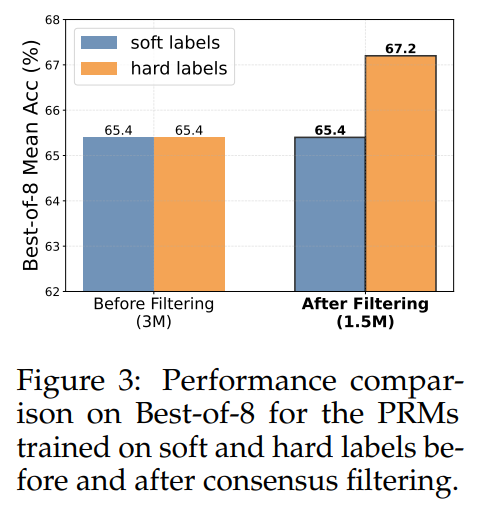
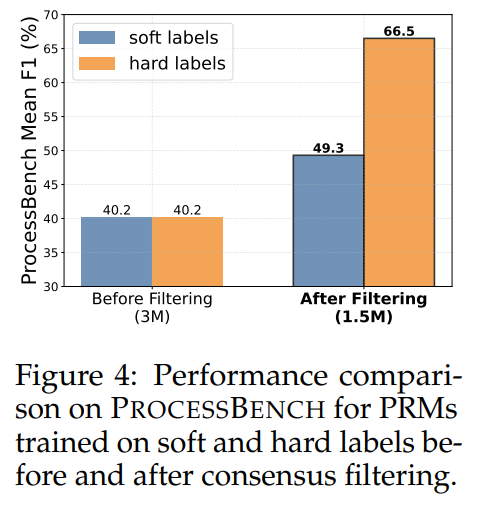
우선, filtering을 적용하기 전에는 soft와 hard 간의 차이가 미미하였다. 본 논문은 dataset의 high noise가 이 둘을 구분하기 어렵게 했다고 볼 수 있다. 반면 dataset의 noise를 줄이는 Filtering을 적용한 후에는 hard label으로 학습했을 때의 성능이 훨씬 우수해졌다.
이를 통해 PRM은 value model처럼 step의 value를 예측하는 모델이 아니라 step의 correctness를 판단하는 모델이기 때문에 continuous한 값인 soft label을 맞추도록 학습하는 것이 아니라 discrete한 값인 hard label을 맞추도록 학습하는 것이 더 유리하다는 것을 알아낼 수 있다. Soft label을 맞추도록 학습하면 soft label은 미래에 답을 맞출 가능성까지 고려한 값이기 때문에 부수적인 noise에 영향을 많이 받는다. 예를 들어, 실제로 올바른 step의 soft label이 1보다 작을 때, model은 이 step이 확실하게 좋은 step인지 모를 수 있게 되는 것이다.
이때, hard labeling을 할 때, 8번의 completions 중 몇 개 (k) 이상을 맞아야지 positive으로 설정할 것인지를 정하는 것도 필요하다. 본 논문은 이 threshold k을 알아내기 위해 k=0-7일 때 성능 변화를 측정하는 추가적인 실험을 진행하였다.
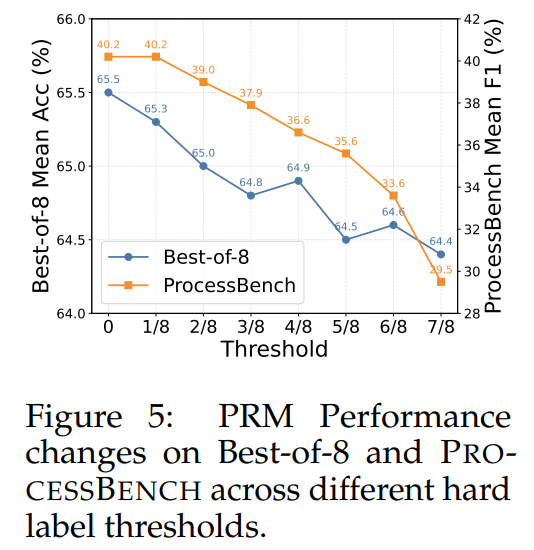
결과에 따르면 8번 중 1번이라도 맞으면 positive으로 labeling하는 것이 두 benchmark에서 모두 최고의 성능을 보였다.
요약하면 MC estimation으로만 data synthesis을 하면 PRM의 성능과 generalization 능력 모두 저하된다. 이 이유는 MC estimation은 policy model에 과도하게 의존하기 때문에 생긴 training data의 noise 때문이다. 이 주장은 LLM을 활용한 consensus filtering을 적용하여 noise를 제거했을 때 PRM의 성능이 비약적으로 향상되는 것을 통해 뒷받침된다. 또, MC estimation으로 data synthesis을 할 때 어떤 labeling을 하는지에 따라 학습 data에 부수적인 noise가 생길 수도 있다. Soft label을 적용하면 부수적인 noise가 포함된 값까지 맞추도록 학습되기 때문에 Hard label을 적용하는 것이 유리하다는 것을 알 수 있었다.
Bias in BoN Sampling for PRM Performance Evaluation
PRM을 평가할 때, BoN을 주로 사용하지만 BoN과 PROCESS BENCH에서 MC 방법과 human annotation 방법의 반대되는 performance 관계를 통해 PRM을 BoN에 대해서만 최적화하는 것은 부족하다고 볼 수 있다.
Unreliable Policy Models Cause BoN-PRMs Misalignment
이상적인 상황에서는 풀이의 답이 맞다면 풀이 과정도 맞고 답이 틀리다면 풀이 과정도 틀린 답안만 존재하기 때문에 답만 비교를 하면 풀이 과정의 correctness도 알 수 있게 된다. 하지만 policy는 false positive나 true negative 풀이를 생성하는 경향이 존재한다. 이때, BoN의 평가 방법의 성격 때문에 policy가 잘못된 풀이 과정을 생성해도 답만 맞는다면 PRM의 성능이 좋게 측정된다. 즉, BoN의 목표는 답만 비교하고 PRM의 목표는 과정 모두 평가하는 것이기 때문에 평가 대상과 평가 방법 간의 misalignment가 발생한다.
본 논문은 BoN이 PRM을 평가하는데 적합하지 않다는 것을 보이기 위해 Qwen2.5-Math-7B-Instruct이 다양한 수학 문제 (GSM8K, MATH, OlympiadBench, and Omni-MATH)를 풀게 하고 답이 맞은 response들만 추출하여 manual annotation을 통해 response들의 풀이 과정들을 평가하였다.
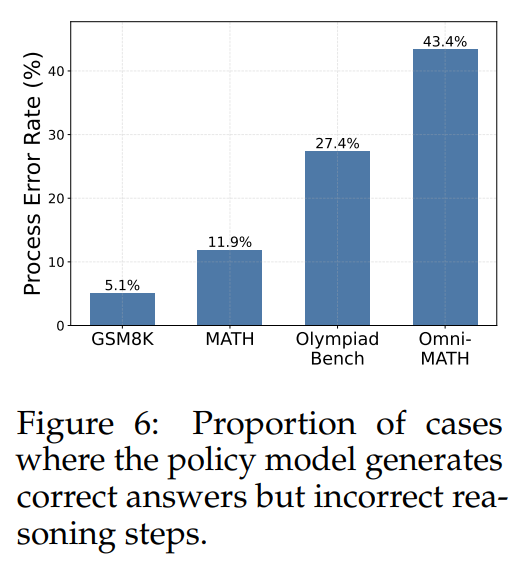
그 결과, policy가 생성하는 response 중 답만 맞고 풀이 과정은 틀린 비율은 어려운 문제일수록 높아졌다. 즉, policy가 생성하는 답이 맞은 풀이들은 unreliable하기 때문에 답만 비교하는 BoN은 적절하지 않은 평가 방법이라고 주장한다. 또, 성능이 좋은 policy란 답이 맞더라도 각 step의 정당성을 올바르게 판단할 수 있어야 한다고 하고 답만 맞고 풀이 과정이 틀린 답안에는 낮은 점수를 줄 수 있는 모델이라고 주장한다.
Limited Process Verification Capability in PRMs Lead to BoN Scores Inflation
PRM이 왜 BoN에서 Human annotation으로 학습한 PRM보다 성능이 좋게 나왔는지를 더 탐구한다. 본 논문은 PRM이 BoN 점수만 높게 나온다는 것은 PRM이 답만 맞고 풀이 과정이 틀린 response를 찾아낼 수 없다는 것을 의미한다고 한다. 이를 증명하기 위해서 PROCESS BENCH에서 답만 맞은 답안들을 추출하여 BoN 점수가 높은 PRM들이 이 false positive 답안들을 잘 거를 수 있는지 실험하였다.
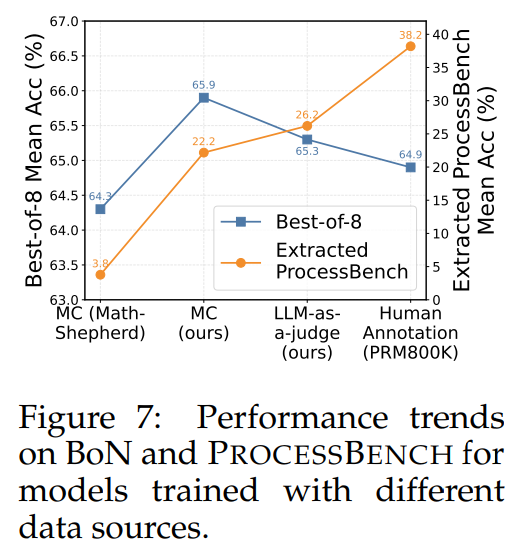
MC estimation으로 학습된 PRM을 보면 이런 구별을 하지 못하기 때문에, 즉 답만 맞은 틀린 풀이 과정을 옳다고 판단하기 때문에 false positive만 존재하는 PROCESS BENCH에서 다른 PRM들보다 성능이 떨어지면서 BoN 점수는 이상하게 높다는 것을 볼 수 있다. (BoN scores Inflation)
BoN 성능이 우수해서 나온 다른 Reward model들도 False positive만 존재하는 PROCESS BENCH에서는 낮은 성능을 보인다.
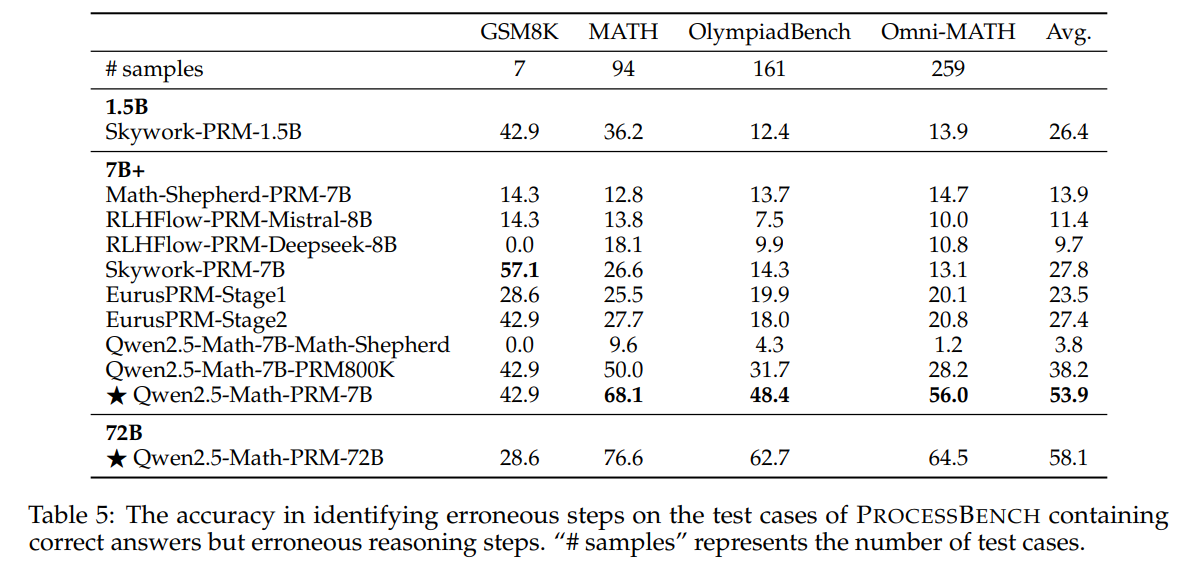
따라서 본 논문은 BoN에 더해 부수적인 평가 방법들도 고안되어야 한다고 주장한다.
Process-to-Outcome Shift in BoN Optimized PRMs
여기에 더해 BoN은 결과에 치중한 평가 방법이기 때문에 BoN 점수를 최대화하도록 PRM을 최적화하면 PRM이 Outcome Reward Model (ORM)으로 shift된다고 주장한다.
본 논문은 이를 측정하기 위해 BoN 점수 계산 방식을 조사하였다. BoN의 점수는 답안을 구성하는 step들이 PRM에게 받은 점수들의 곱 또는 최솟값으로 결정한다. 결국, BoN의 점수는 step들 중에서 가장 낮은 점수를 받는 step에 크게 영향을 받는다. 따라서, 본 논문은 PRM가 어떤 step에 보통 제일 낮은 점수를 주는지를 확인하였다.
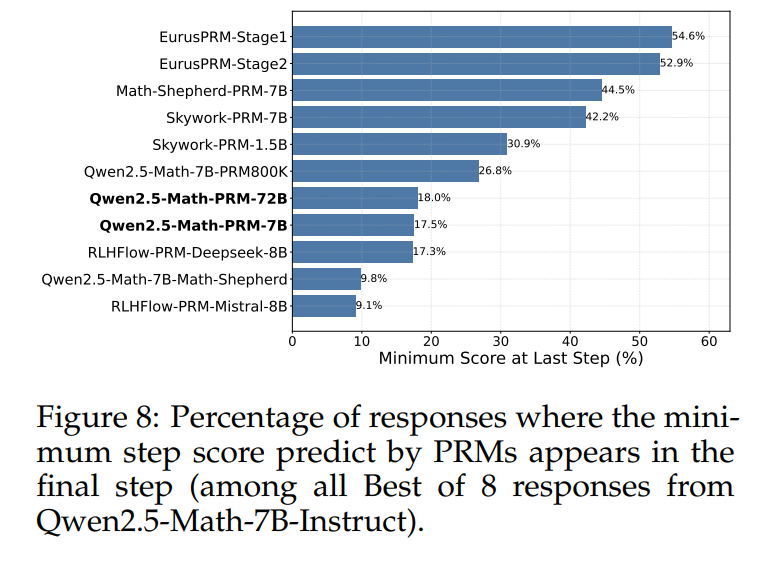
BoN에 최적화된 시중의 PRM들 (EurusPRM-Stage1, EurusPRM-Stage2, Math-Shepherd-PRM-7B and Skywork-PRM-7B)을 보면 가장 마지막 step에 제일 낮은 점수를 주는 경우가 40%를 넘는다. 즉, BoN에 최적화된다면 PRM은 마지막 step (결과)을 제일 비중있게 보는 경향이 존재한다는 것을 알 수 있다. 따라서 BoN에 대해서만 최적화하면 PRM은 결국 ORM의 역할을 하도록 변한다는 것이다.
Different PRMs, Different Optimal Scoring Strategies
MC estimation을 적용할 때, BoN의 답안의 점수 산정 방식은 다른 문제점이 존재한다. BoN의 답안 점수 산정 방식은 풀이의 각 step들이 받은 점수의 곱으로 결정된다고 하였다. 이때, 받은 점수가 각 step을 독자적으로 봤을 때 그 step이 정답일 확률을 의미한다면 joint probability의 개념에 따라서 전체 step들의 점수 곱은 전체 풀이가 정답일 확률을 의미한다고 볼 수 있기 때문에 정당하다. 하지만 MC를 적용하는 순간 step의 점수는 미래에 정답에 도달할 수 있는지에 대한 예측값이 되기 때문에 step의 곱으로 전체 답안의 점수를 결정하는 것은 문제가 있다고 주장한다. 이를 대체하기 위해 마지막 step에 부여된 점수는 처음부터 마지막까지의 모두 고려한 점수이기 때문에 더 정당한 BoN 점수 산정 방식은 마지막 step의 점수만으로 전체 답안의 점수를 설정하는 것이라고 주장한다.
마지막 step의 점수만으로 BoN을 하여 PRM을 평가하는 실험을 진행하였다.
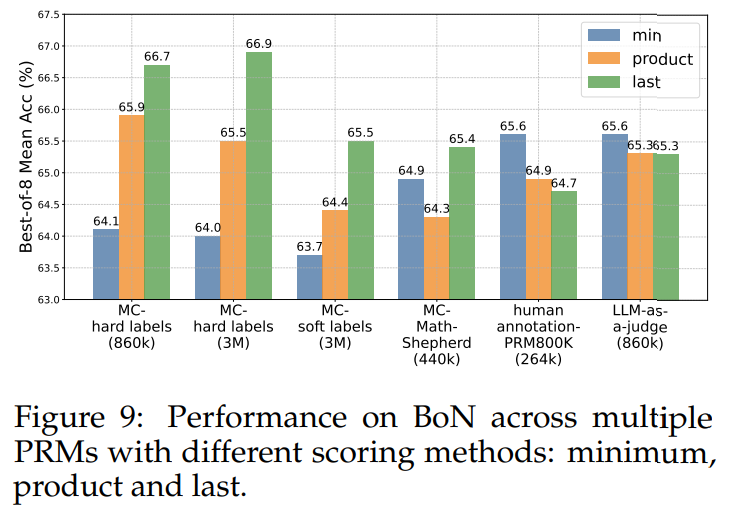
그 결과, 기존의 BoN보다 PRM의 BoN 성능이 훨씬 높게 나왔다. 이를 통해 MC estimation을 적용하여 PRM을 학습하고 BoN으로 평가하고자 한다면 마지막 step의 점수만 고려하는 방법이 더 정당하다고 한다. (LLM as a judge나 human annotation을 적용한 PRM은 이런 경향을 보이지 않음)
하지만 PRM은 모든 step의 correctness를 평가하는 모델이기 때문에 마지막 step의 점수만 고려하는 BoN에 대해 최적화하는 것은 여전히 PRM의 목적과 misalign된다고 한다.
요약하자면 policy는 unreliable하고 이런 policy를 바탕으로 training data를 구성하면 PRM의 목표와 BoN 간의 misalignment가 발생한다. 또, PRM이 step의 correctness를 잘 판단하지 못해도 BoN에서 높은 점수를 받을 수 있기 때문에 BoN으로만 평가하는 방법은 적절하지 않다. 그리고 BoN의 점수를 높이도록 PRM을 최적화하면 PRM이 아니라 답에 비중을 크게 두는 ORM으로 shift되는 현상이 발생한다. 따라서, 본 논문은 자세한 단계별 평가 방법을 구축하는 것이 필요하다고 주장한다.
Our PRM
본 논문은 기존의 PRM 학습 방법과 PRM 평가 방법의 한계를 해결함으로써 SoTA PRM을 얻었다.
Training details
PRM을 학습하기 위핸 데이터의 구축 과정은 두 단계로 나뉜다.
Data Expansion phase
기존처럼 MC estimation을 기반으로 data synthesis을 한다. 이때, Hard label을 사용하고 8개의 completion 중 하나도 답을 맞추지 못했을 때만 negative, 나머지는 positive으로 labeling하는 방법을 사용한다.
Filtering phase
Consensus filtering mechanism을 적용하는 단계이다. Qwen2.5-Instruct-72B LLM이 Data Expansion phase에서 생성된 풀이들의 모든 step들에 대해 평가하도록 하고 MC estimation과 LLM의 의견 (label)이 모두 동일한 풀이들만 남기고 나머지는 걸러서 training dataset의 noise를 최대한 제거하였다.
Training task으로는 Binary classification task를 사용하였다. 풀이 과정의 각 token의 hard label에 대한 Cross entropy loss를 최소하도록 학습하여 어떤 step이 correct한 것인지 학습한 것이다.
이 과정을 통해 7B와 72B 크기의 PRM을 얻었다. 각 PRM의 intialize model은 Qwen2.5-Math-7B-Instruct와 Qwen2.5-Math-72B-Instruct이고 결과 PRM은 PRM Qwen2.5-Math-PRM-7B와 Qwen2.5-Math-PRM-72B이라고 한다.
Experimental Setup
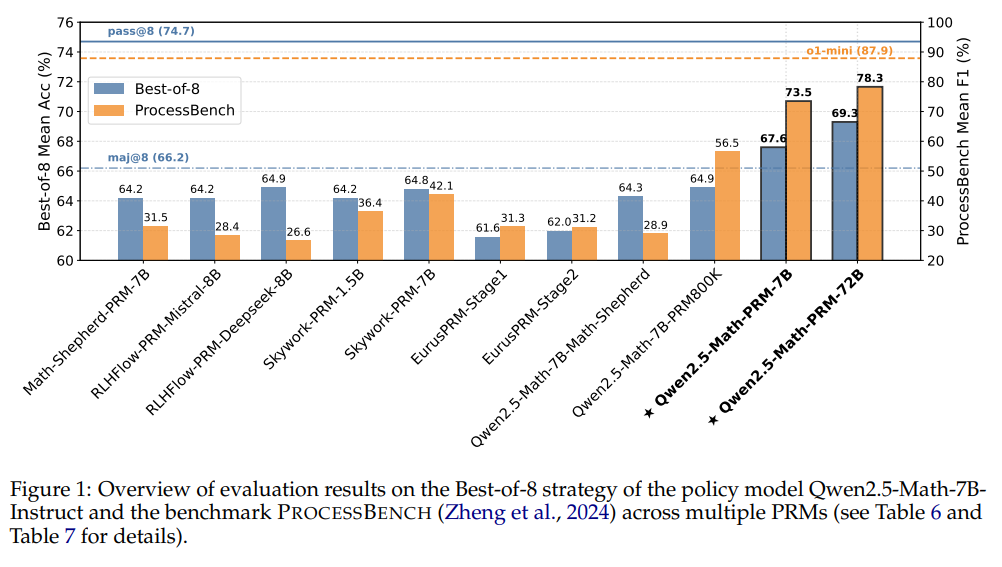
PRM Qwen2.5-Math-PRM-7B와 Qwen2.5-Math-PRM-72B의 성능을 측정하기 위해 BoN과 PROCESS BENCH으로 평가하였다.
BoN 결과는 다음과 같다.
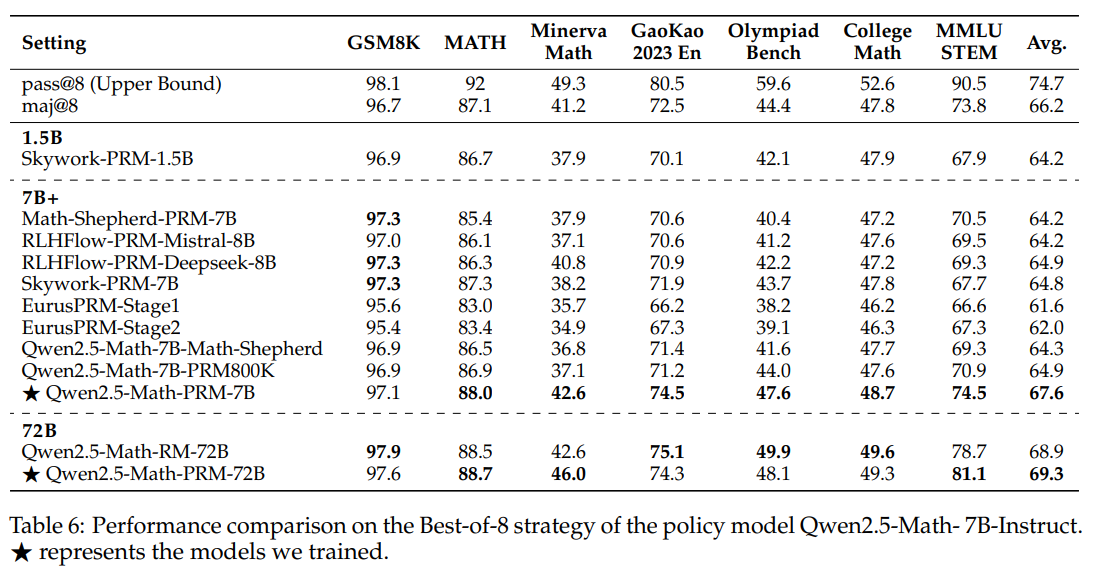
- PRM Qwen2.5-Math-PRM-7B은 다른 모든 PRM들보다 GSM8K을 제외하고 나머지 task에서 우수한 성능을 보인다.
- PRM Qwen2.5-Math-PRM-72B는 전체적인 성능이 ORM인 Qwen2.5-Math-RM-72B보다 우수하다.
PROCESS BENCH 결과는 다음과 같다.
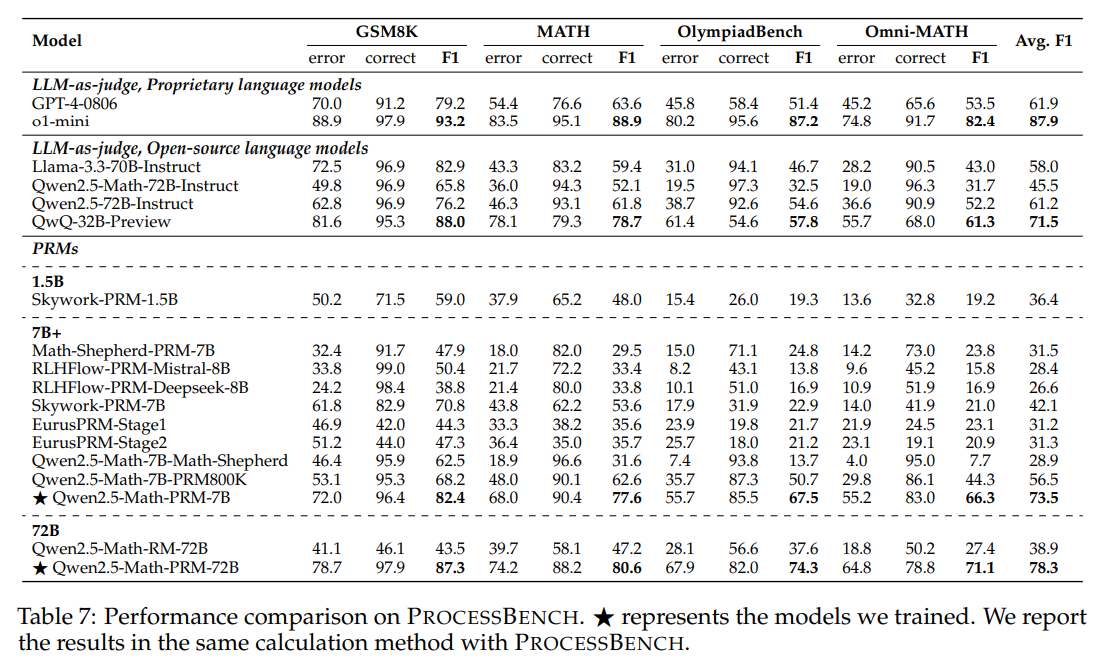
- Qwen2.5-Math-PRM-7B는 LLM as a judge 방법들과 비교했을 때 전체적인 성능이 더 우수하다. 심지어 GPT-4o-0806보다도 성능이 좋다.
- 기존의 PRM들과 비교하였을 때는 Qwen2.5-Math-PRM-7B, 72B 모두 counterparts보다 더 우수한 성능을 보인다.
다음은 PRM Qwen2.5-Math-PRM-7B와 Qwen2.5-Math-PRM-72B의 성능을 다른 모델들과 비교한 결과 요약본이다.