Evaluating Small Language Models for News Summarization Implications and Factors Influencing Performance 리뷰
Background
Text summarization이란 긴 text의 주요 정보를 잃지 않고 짧은 버전으로 압축하는 과정이다. Traditional text summarization 모델들은 하나의 news article를 입력으로 받으면 summary를 출력하지만, SLM은 무엇을 해야하는지에 대한 정보가 든 prompt와 news article이 주어져야지 summary를 출력할 수 있다. 따라서, SLM의 text summarization 능력을 평가할 때는 prompt의 영향까지 고려해야 한다.
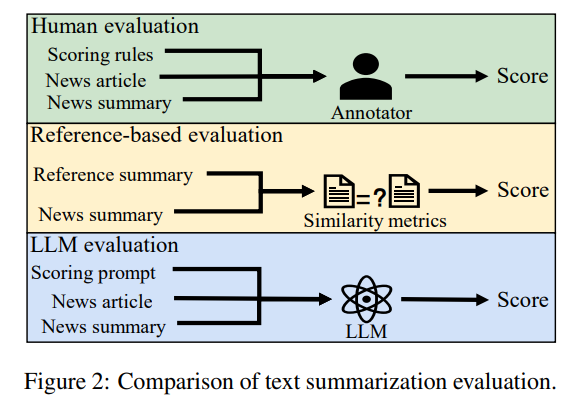
현재 text summarization을 평가하는 방법은 크게 3가지이다.
-
Human evaluation 정확하지만 cost가 크다.
-
Reference based evaluation 생성한 summary와 정답으로 간주되는 reference summary 간의 유사도를 측정하는 방법이다.
-
LLM evaluation 채점하라는 prompt와 함께 summary랑 article을 입력하여 점수를 매기도록 하는 방법이다. 하지만 채점 대상에 따라 LLM의 평가가 달라지는 bias가 존재한다고 한다.
하지만 이 방법들은 모두 traditional text summarization 모델을 평가하기 위해 사용되는 것이고 prompt까지 필요한 SLM의 text summarization 능력을 평가하기 위한 채점 방법은 구체화되지 않았다.
본 논문은 SLM의 news article 요약 능력과 LLM과 비교하였을 때 얼만큼의 차이가 존재하는지 탐구한다. 또, SLM은 traditional text summarization 모델들과 다르게 prompt도 입력받아야 하기 때문에 SLM의 text summarization에서 prompt의 영향력을 연구하였다.
LLM augmented reference based evaluation
본 논문은 다른 방법들보다 빠르고 효율적인 Reference based evaluation에 집중한다. 하지만 최근 연구 결과에 따르면, 현재 사용되는 dataset의 reference summary들이 좋은 summary가 아니기 때문에 이런 reference를 바탕으로 평가하는 방법은 human preference와의 align되지 않은 방법이라고 주장한다. 여기에 더해, 다른 연구에 따르면 high quality summaries를 reference로 사용한 평가 점수가 높을수록, human preference와 align을 더 잘 되어 있다고 볼 수 있다고 한다.
따라서, 본 논문은 더 객관적이고 정확한 평가를 하기 위해 기존의 dataset의 reference summary들을 LLM이 생성한 high quality summary로 바꾸어 SLM을 평가하는데 사용하였다. LLM의 summary를 사용하는 이유는 두 가지이다. LLM이 생성한 summary들은 우선 기존 dataset의 reference보다는 뛰어나고 (4.5점 vs 3.6점) 작가들에게 84%의 확률로 선호된다고 한다. 또, summary를 얻는 속도가 빠르기 때문에 다양하고 많은 news article domain에 대한 요약을 손쉽게 얻을 수 있다.
Benchmark design
News article selection
News summarization 평가에 사용되는 dataset은 CNN/DM, Newsroom, Xsum, BBC2024 다. 이때, 첫 세 개의 dataset은 오래 되었기 때문에 SLM의 pretraining 과정에서 이미 학습 되었을 수도 있다. 이 문제를 해결하기 위해 BBC의 2024년 1월~3월 뉴스 기사들로 만든 BBC2024 dataset을 만들었다.
이전 연구에 따르면, 각 dataset마다 500개의 sample을 바탕으로 성능을 비교해도 적당하다고 한다. 따라서 각 test set에서 500개의 data를 sample하여 총 2000개의 samples로 최종 test set을 구성하고 이 data들로 SLM들의 summarization 성능을 비교하고자 하였다.
Model selection
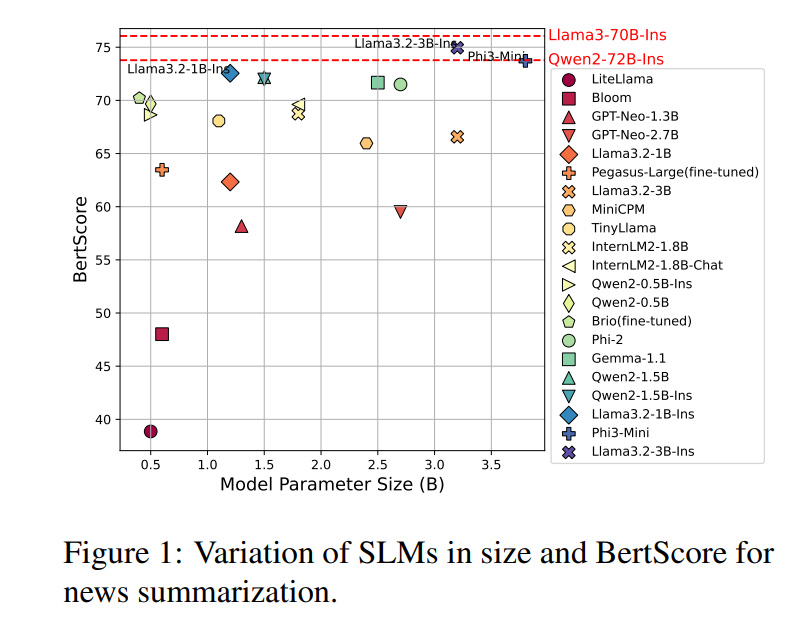
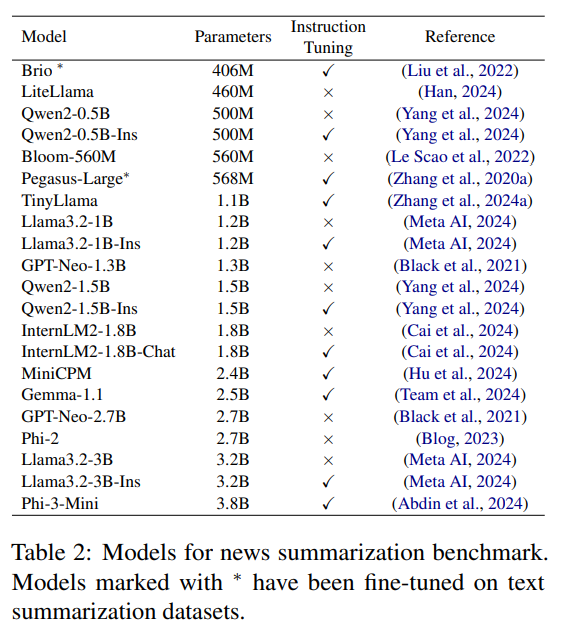
본 논문에서 정의한 SLM이란 parameter 크기가 4B 이하인 모델이다. 이 기준으로 19개의 SLM과 text summarization에 특화된 model (Pegasus-Large, Brio)으로 SLM의 text summarization 능력을 평가하였다.
SLM의 text summarization prompt로는 Figure 3의 Prompt 1을 사용하였다.
Evaluation metric
Summary를 평가할 때 relevance, coherence, factual consistency, 그리고 text compression 을 기준으로 평가 하였다. 사용한 metric은 BertScore, HHEM-2.1-Open, summary 길이이다.
BertScore
의미 기반 유사도 metric으로 reference based metric이다. Summary는 user를 위한 것이기 때문에 사람이 선호하는 summary가 우수한 summary라고 가정하였다. 이때, summary를 평가하는 여러 metric 중 human evaluation과 Kendall’s tau correlation 상수값이 제일 높은 metric이 BertScore이라서 BertScore을 사용하였다.
Kendall’s tau correlation
두 변수 사이의 순위 상관관계를 측정하는 비모수적 통계 방법이다.
모델 A의 요약이 모델 B보다 좋다”라고 인간이 판단했을 때, reference based metric도 동일하게 모델 A에게 더 높은 점수를 주었는지를 확인하여 referenced based metric과 인간 평가 metric이 어느정도 일치하는지를 나타내는 상수 값이라고 보면 된다.
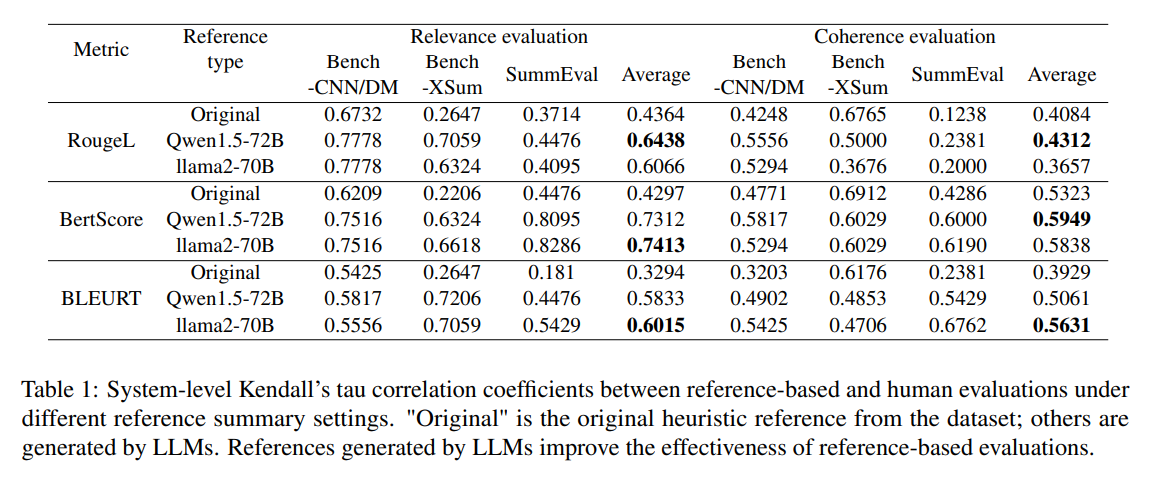
BertScore는 모델이 생성한 summary와 reference의 BERT embedding 간의 유사도를 계산하여 모델이 생성한 summary가 핵심 정보와 일관성을 유지하는지 평가하는 역할을 한다.
HHEM-2.1-Open
Hallucination 감지 모델로 감지 능력으로는 GPT-4를 능가하는 모델이다. 이 모델은 reference 없이 summarization이 news article 기반으로 작성하였는지, 아니면 hallucinate하여 거짓 정보나 이미 알고 있던 정보를 작성하였는지 판단할 수 있다. 값이 높을수록 hallucinate하지 않고 article 기반으로 summary를 작성하였음을 의미한다.
Summary Length
BertScore는 모델이 생성한 길이를 고려하지 못한다. 따라서, 모델이 생성한 summary의 평균 길이를 계산하여 article을 얼마나 잘 압축하였는지 평가한다.
Reference Summary Generation
앞서 설명했 듯이 Reference summary를 얻기 위해서 LLM을 사용하였다. 다른 두 series의 LLM: Qwn 1.5-72B-chat과 Llama2-70B-Chat으로 한 article에 대해 두 종류의 reference summary를 작성하였다. 그 다음, reference summary와 SLM의 summary와 비교하면서 평가할 때, 두 reference summary를 사용했을 때 받은 점수의 평균값을 최종 결과로 사용하였다. Summary 작성에 Figure 3의 prompt 2와 greedy strategy를 사용하였다.
Evaluation Results
Relevance and Coherence Evaluation
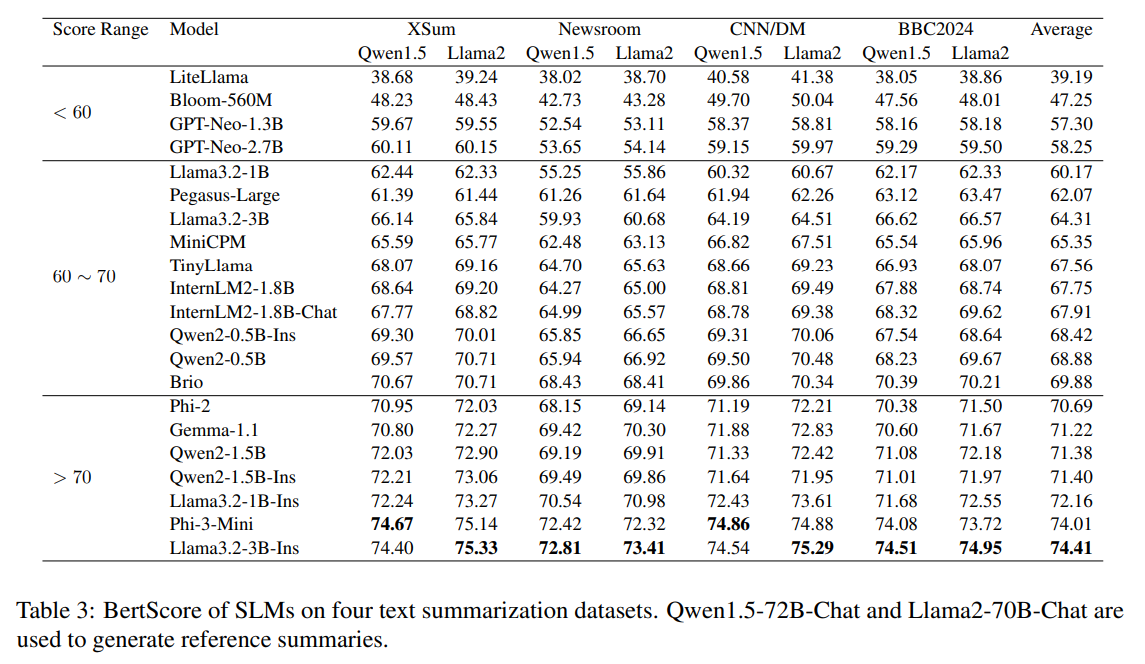
SLM들의 BertScore 평균값 결과는 다음과 같다.
모든 모델들이 사용된 4개의 dataset에서 일관된 성능을 보인다. 모델 간의 성능 차이를 기준으로 세 범주로 나눌 수 있다. 첫 번째 범주는 점수가 60점 이하인 모델들이다. Relevance 기준으로 보았을 때, 이 모델들은 news article을 요약할 때, 중요한 정보들을 하나씩 빼먹는 경향이 있다. Coherence 기준으로 보았을 때, 이 모델들은 repetition을 하는 경향이 있어 과도하게 긴 summary를 만든다. 다음은 이 범주에 속하는 모델 중 하나인 LiteLlama의 summarization 예시이다. LiteLlama의 요약이 news article의 내용과 벗어나는 것을 관찰할 수 있다.
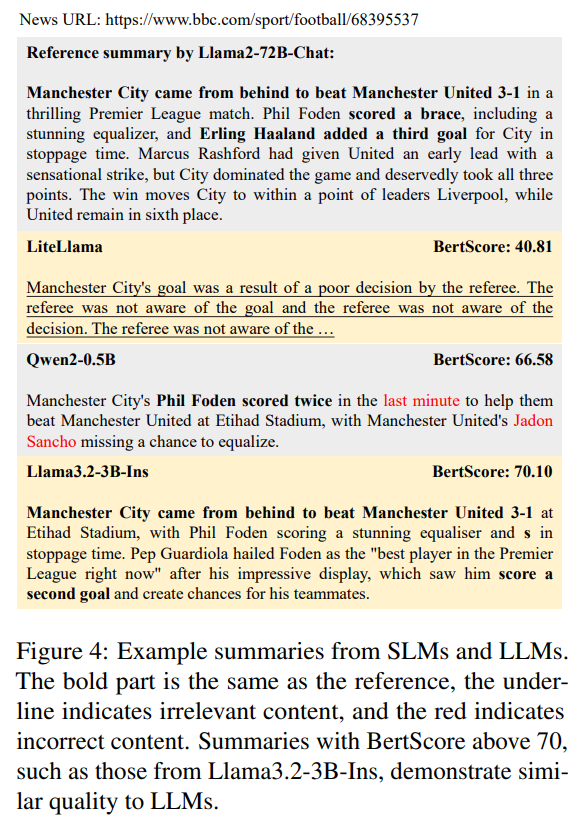
두 번째 범주는 점수가 60점 이상 70점 이하인 모델들이다. Relevance을 기준으로 이 모델들은 우수한 summary를 생성할 수 있지만 중요한 내용을 가끔 빼먹는 경향이 있다. Coherence을 기준으로 작성한 summary의 구조가 깔끔하다. Figure 4에서 이 범주에 속하는 모델 중 하나인 Qwen2-0.5B의 summarization 예시를 보면 Summary가 news article의 내용이 다 들어있고 일관되지만, 경기 내용의 최종 결과만 빼먹었다는 것을 관찰할 수 있다.
세 번째 범주는 점수가 70점 이상인 모델들로, LLM과 비슷한 요약 능력을 보인다. figure 4에서 Llama 3.2B-3B ins의 summarization 예시를 보면 정보 하나가 틀렸지만 그래도 매우 우수한 summary를 생성한다.
Factual Consistency
모델이 summarization을 하면서 hallucinate하는지를 관찰하였다.
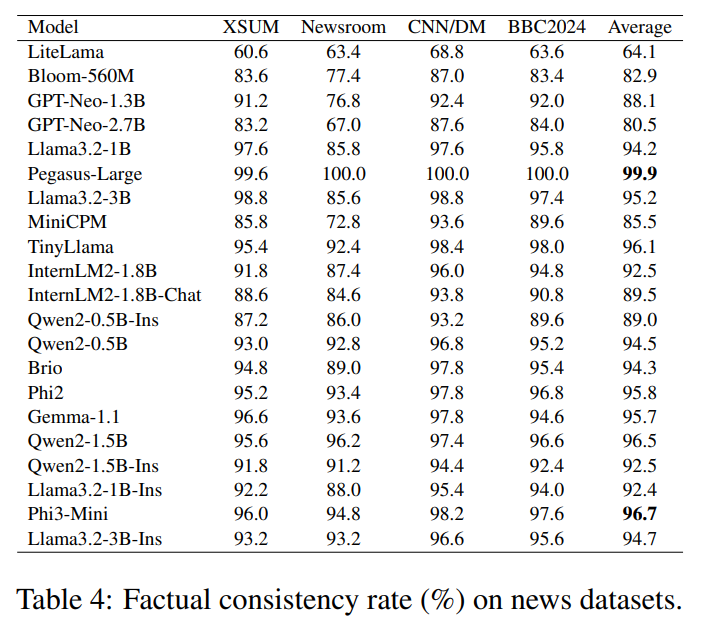
BertScore가 높은 모델일수록 factual consistency가 높은 경향이 존재한다. 이때, Pegasus-Large의 factual consistency가 비정상적으로 높은 것을 확인할 수 있는데 (99%) 이는 이 모델이 alignment을 하기 위해 news article의 일부를 summarization에 그대로 사용 (extractive)하기 때문이다.
Summary Length Evaluation
SLM들의 summary의 평균 길이에 대한 결과는 다음과 같다.
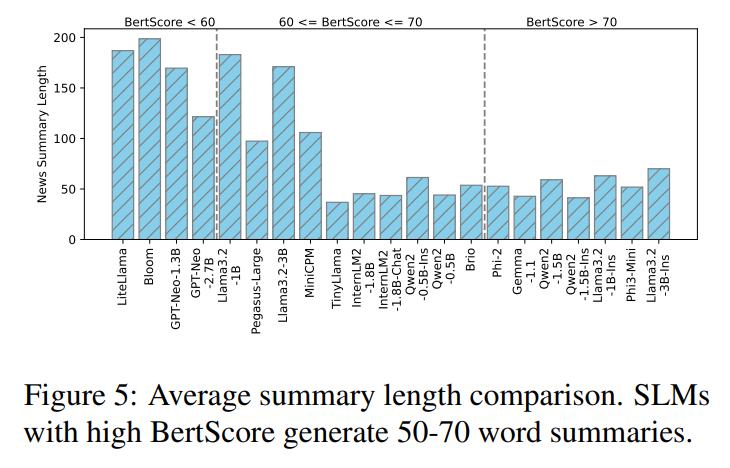
60점 이하의 모델들은 hallucinate하고 repetition을 하는 경향이 크기 때문에 summarization의 평균 길이가 100 단어를 넘어간다. 반면, 70점을 넘는 모델들은 더 consistent 한 summaries를 작성하기 때문에 summary의 평균 길이가 50~70 단어로 news article을 체계적으로 잘 압축한다는 것을 관찰할 수 있다.
Comparison with LLMs
전체적으로 좋은 성능을 보인 Qwen2-1.5B ins, Phi3-mini, llama 3,2-3B ins 모델들과 LLM들 간의 성능 비교를 하였다.
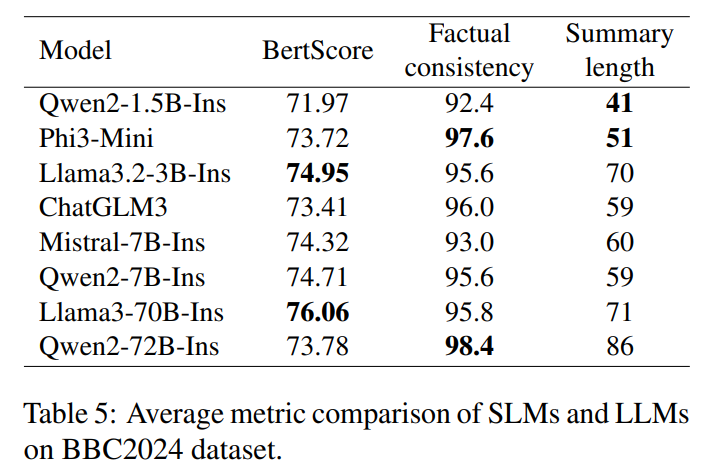
그 결과, BertScore와 factual consistency 값은 비슷하지만 SLM이 평균적으로 길이가 더 짧은, 즉 더 읽기 쉬운 summary를 작성한다는 것을 관찰할 수 있다.
Human evaluation
Kendall’s tau correlation 값에 더해서 본 논문이 사용한 metric이 정당하다는 것을 보여주기 위해 BBC2024에서 20개의 news instances를 sampling 하였고 이 news에 대해 각 SLM이 생성한 summary들을 6명의 human annotator들에게 평가하도록 하였다.
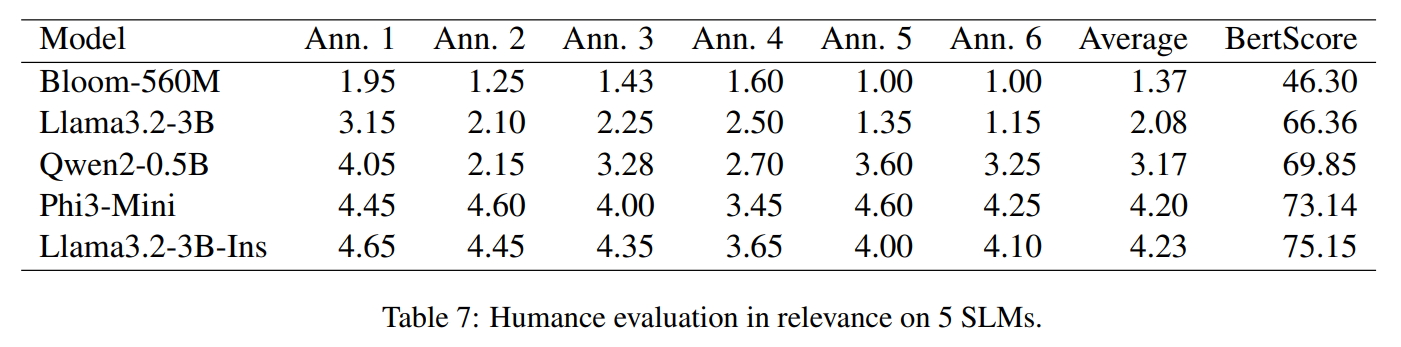
그 결과, BertScore, Factual constistency, Summary length가 모두 우수한 모델이 생성한 summary일수록 human annotator로부터 받은 점수가 높았다. 또, human annotator로부터 받은 점수의 평균과 BertScore 간의 Kendall correlation coefficient 값이 1으로 측정되었다. 이 실험으로 인해 BertScore와 human evaluation 간의 strong alignment를 엿볼 수 있으며 BertScore가 정당한 metric이라는 것을 알 수 있다.
결론적으로, SLM은 news article 요약 분야에 있어서 LLM을 대체할 수 있을만큼 뛰어나다.
Influencing Factor Analysis
Prompt Design
Prompt engineering은 LLM의 성능을 추가적인 학습없이 높여주는 역할을 한다. 따라서, Figure 3의 다양한 prompt template을 SLM에게도 실험하여 traditional summarization model과 다르게 prompt을 사용하는 SLM에서 prompt의 영향력을 실험해보았다.
Prompt 1에서 Prompt 3으로 갈수록 더 구체적인 prompt가 된다.
Bert Score
다음은 세 가지의 prompt template을 적용했을 때, BertScore 차이를 보여주는 실험 결과이다.
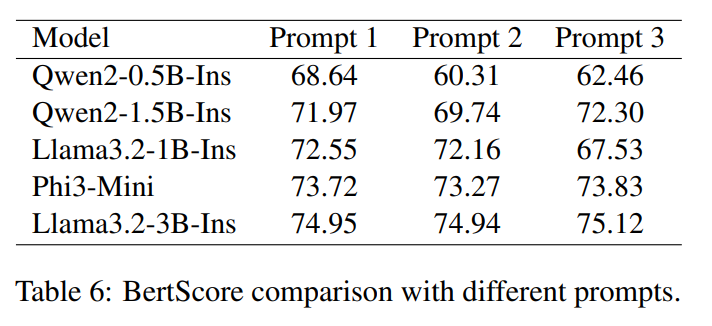
SLM에서는 LLM과 다르게 prompt를 자세하게 줄수록 성능이 저하되는 경향이 존재함을 관찰할 수 있다. 이 실험을 통해 SLM에는 간단한 prompt가 더 적절하다는 것을 알 수 있다. 본 논문은 이 경향은 SLM이 prompt 안의 다양한 요구 사항에서 어떤 것이 더 중요한지 판단할 수 없기 때문이라고 주장한다.
다음은 세 가지 prompt에서 Llama 3.2-3B-Ins의 summarization이다.
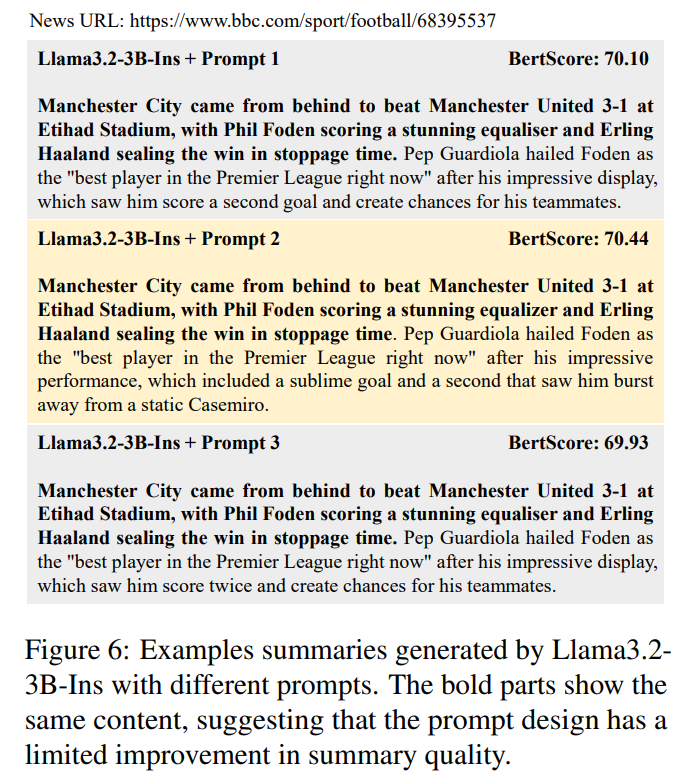
모두 좋은 summarization이지만 prompt 복잡도가 높을 때 미세한 quality의 차이를 관찰할 수 있다.
Factual Consistency
다음은 세 가지의 prompt template을 적용했을 때, Factual Consistency 차이를 보여주는 실험 결과이다.
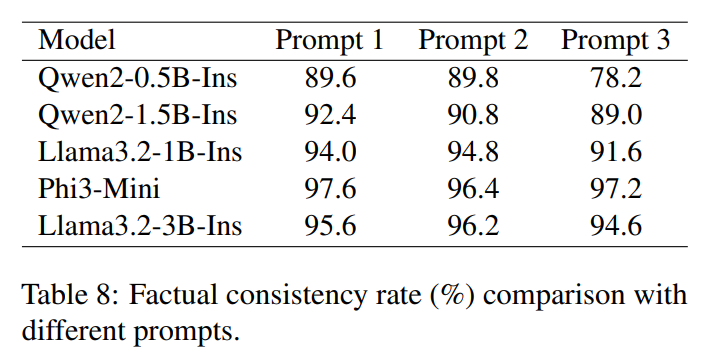
Qwen 2-0.5B ins처럼 parameter 크기가 작은 모델에서 prompt가 복잡해질수록 factual consistency가 내려가는 경향을 관찰할 수 있다. 앞선 BertScore 결과처럼 SLM에서 복잡한 prompt는 오히려 성능을 저하시킨다는 것을 확인할 수 있다.
Summary Length
Prompt의 복잡도는 summary의 길이에도 영향을 준다.
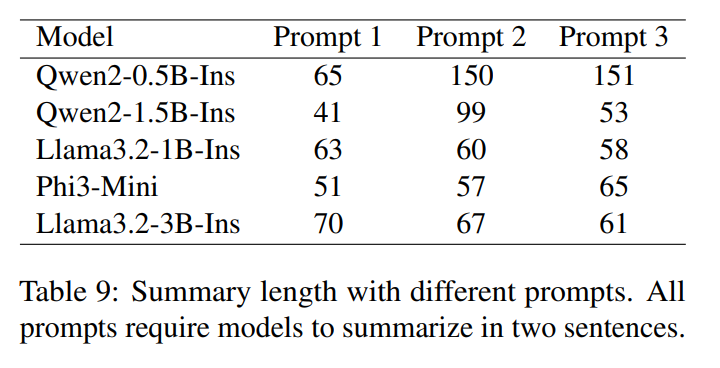
복잡한 Prompt의 영향으로 “two sentences”라는 제한 사항을 따르지 못하여 긴 summary를 작성하였다.
결론적으로, 복잡한 prompt는 LLM의 상황과 다르게 SLM의 성능을 끌어올리는 역할을 하지 못한다. SLM에게 복잡한 prompt는 news article의 정보를 파악하는데 방해하고 SLM은 이런 prompt와 article 간의 논리적 관계를 이해하지 못한다. 따라서, SLM으로 요약을 하도록 만들 때에는 simple prompt를 사용하는 것을 본 논문은 추천하였다.
Instruction tuning
Instruction tuning을 한 모델과 하지 않은 모델 간의 요약 능력에 큰 차이는 존재하지 않는 것으로 보아 instruction tuning이 SLM의 요약 능력에 큰 영향을 주지 않다고 볼 수 있다.