rStar-Math Small LLMS can Master Math Reasoning with Self-Evolved Deep Thinking 리뷰
Background
LLM으로 수학 문제를 해결하도록 할 때, 보통 한 번의 추론 과정을 통해 전체 solution을 생성하도록 한다. 이를 System 1 Thinking이라고 한다.
Greedy decoding처럼 다음 token 중 확률이 제일 높은 token을 계속 출력하는 방법으로 최종 generation을 얻는 방법이라고 이해하면 된다.
이 방법은 빠르지만 틀릴 가능성이 높다.
이런 문제점으로 인해 관습에서 벗어나 System 2 Thinking에 집중하는 경향이 뚜렷해졌다.
이 경향은 test-time compute scaling (추론 시간이 길어질수록 정답률이 상승하는 효과) 개념으로 인해 생겼다.
더 깊은 생각 과정을 통해 사람의 추론 과정을 따라하는 것이라고 보면 된다. System 2 Thinking에서는 보통 LLM이 policy model로 작동하여 어떤 문제에 대해서 여러 추론 CoT들을 생성한다. 그러면 reward model 역할을 하는 다른 LLM이 추론 CoT들을 평가하면서 정답에 도달할 확률이 제일 높은 CoT를 추려내어 최종 답으로 출력한다.
이렇게 test time compute에 집중하는 방법은 policy가 promising solution step들을 생성할 수 있도록 학습시키는 것과 각 step들을 정확하게 평가할 수 있는 reward model이 중요하다. 이때, 이 두 요소를 확보하기 위해 필요한 것은 high quality training data이다. 여기서 한계점이 존재한다.
현재 시중에 존재하는 high quality 수학 추론 dataset은 많이 없다. 또, 이런 dataset을 만드는 과정도 어렵다. 우선 어떤 policy를 통해 수학 문제 solution dataset을 만들고자 할 때, 올바른 solution들만 dataset에 넣어야 한다. 하지만 수학 domain의 경우, 올바른 solution이란 답만 맞은 solution이 아니라 solution을 구성하는 step들도 모두 정당해야 하기 때문에 모든 문제들에 대해서 올바른 solution이 labeling 되어있는지 판단한기 어렵다. 올바른 solution인지 판단하기 위해 각 step들이 정당한지 확인할 수 있는 Process Reward Model (PRM) 을 사용할 수 있다. PRM을 학습하기 위해서는 임의의 풀이 과정에 대해 PRM이 평가한 점수와 human feedback으로 평가한 점수의 차이가 최소화되도록 해야 한다. 이때, PRM을 학습할 때 필요한 human feedback을 얻는 것은 더 costly하다. Human feedback을 대체하기 위해 더 큰 size의 reward model을 사용하는 방법도 있지만 이런 reward model이 도출하는 reward는 noise가 많다. 즉, high quality 수학 추론 dataset을 얻는 것은 매우 어렵기 때문에 수학 문제를 잘 해결할 수 있는 policy 및 reward model 또한 얻을 수 없는 것이다.
이를 극복하기 위해서 reward model을 사용하는 것이 아니라 더 큰 Teacher 모델의 CoT를 작은 Student 모델에게 직접 SFT을 통해 학습시키는 distillation을 사용하긴 하지만 이 방법으로는 Student가 Teacher를 능가할 수 없고 CoT 데이터를 늘릴수록 Student 모델의 성능 증가가 미미해진다.
rStar-Math
본 논문은 이런 문제를 해결하기 위해 policy model과 reward model이 통합된 4 round self-evolution 과정을 따른다.
이 과정의 개요는 다음과 같다.
- 각 라운드마다 Monte Carlo Tree Search와 Code augmented CoT를 통해 수학 문제에 대해 policy model이 생성한 수학 추론 CoT(step by step verified reasoning trajectory) 중 우수한 후보들만 추려낸다.
- 이 후보 reasoning trajectories을 통해 각 추론 step을 채점할 수 있는 reward model인 Process Preference Model (PPM)을 학습한다.
- Policy가 생성한 step by step verified reasoning trajectories 중에서 PPM의 점수가 높은 trajectory들만 추려내어 이전보다 high quality인 trajectory dataset을 구성한다.
- 이렇게 얻은 high quality trajectory dataset을 통해 policy를 학습시킨다.
- 1~4 과정을 반복한다.
본 논문에 따르면 이 과정을 통해 training dataset, policy model, reward model이 지속적으로 발전한다. 따라서 rStar-Math를 self evolvable System 2 style reasoning이라고 소개한다. rStar-Math는 수학 추론 능력에서 SoTA를 달성하고 7B 크기의 SLM으로 OpenAI o1의 수학 추론 성능을 능가하거나 맞먹는다.
Methodology
Step by Step Verified Reasoning Trajectory
rStar-Math는 high quality math reasoning dataset을 얻기 위해 dataset의 각 instance를 step by step verified reasoning trajectory로 구성하였다. 본 논문은 이런 step by step verified reasoning trajectory을 얻기 위해서 Monte Carlo Tree Search와 Code augmented CoT를 사용한다.
rStar-Math는 System 2-style reasoning을 구현하기 위해서 수학 문제 solution을 한 번에 inference하지 않고 여러 단계의 generation으로 분해하였다. 이때, rStar-Math는 step by step reasoning을 자연어로 생성하면 hallucination이 생긴다는 연구 결과를 바탕으로 자연어가 아니라 Code augmented CoT로 생성한다.
이렇게 생성된 CoT의 step을 하나의 노드라고 볼 때, Monte Carlo Tree Search(MCTS) 알고리즘은 여러 노드들을 탐색하여 검증된 high quality 수학 solution을 찾을 수 있도록 도와준다. MCTS가 System 2 deep thinking을 효율적으로 해주는 이유는 두 가지이다. 첫 번째로, MCTS는 복잡한 수학 문제를 여러 개의 간단한 single step inference task으로 나눌 수 있어 정확한 step by step solution 생성을 도와준다. 기존 System 2 Reasoning methods (Best of N이나 self-consistency)의 경우에는 한번의 inference으로 전체 solution을 생성하도록 하였지만 MCTS는 제일 유망한 노드들을 탐색하고 그에 대해 확장하면서 여러 번의 inference을 거치기 때문이다. 두 번째로, MCTS를 적용하는 과정에서 policy와 reward model을 위한 학습 데이터가 자동으로 만들어진다. MCTS를 수행하기 위해서는 solution의 각 step이 정답을 유도하는데에 얼만큼 기여했는지에 따른 점수(Q-value)를 특정 알고리즘으로 매기게 된다. 각 step의 Q-value data로 step level human feedback data 없이도 reward model을 학습할 수 있게 되면서도 평균 Q-value가 제일 높은 solution trajectory (가장 우수한 trajectory) 를 통해 policy를 학습시킬 수 있게 된다.
GPT-4가 각 문제에 대해 생성한 solution data를 사용해서 MCTS가 만드는 학습 dataset을 대체하는 방법을 떠올릴 수 있다. 하지만 GPT-4는 쉬운 문제만 정확하게 풀 수 있기 때문에 Policy의 학습 data가 쉬운 문제에 대한 solution들로만 구성되게 된다. 따라서, 이 방법은 학습 data의 다양성과 품질에 영향을 준다. 또, GPT-4가 정확한 Q-value를 계산하여 process reward model 학습 data를 구성하기 위해서는 수많은 forward pass를 수행해야 하기 때문에 cost effective 하지 않다.
Policy가 생성한 step by step solution들 중에서 검증된 solution을 구별하는 방법과 solution의 각 step에 Q-value를 부여하는 과정은 다음과 같다.
Policy model을 M이라고 하고 수학 문제 $x$가 주어졌을 때, MCTS는 최적의 solution을 찾기 위한 search tree $T$를 구축한다.
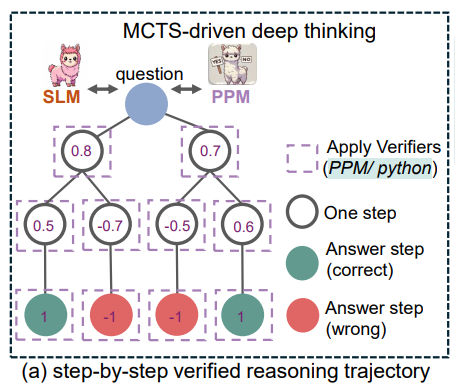
이때 root 노드부터 leaf 노드 ($s_d$)까지의 경로는 각 step $s_i$에 Q-value $Q(s_i)$가 부여된 trajectory $t = x \oplus s_1 \oplus s_2 \oplus … \oplus s_d$ 를 의미한다고 했을 때, MCTS의 최종 목표는 Search Tree $T$로부터 여러 개의 high quality의 solution trajectories $\mathbb{T} = { t^1, t^2, …, t^n }$를 추출하는 것이다. 하지만 어떤 trajectory의 각 step이 자연어로 되어있다면 high quality인지 일일이 판단하는 것은 효율적이지 않다. 따라서 Code augmented CoT 방법을 통해 정확하고 빠르게 high quality trajectory를 추출한다.
기존의 MCTS는 자연어 CoT를 바탕으로 진행되었지만 순수 자연어 CoT는 LLM이 hallucinate할 가능성을 높여 과정은 틀리지만 답만 맞는 solution을 생성할 수도 있게 한다고 연구를 통해 밝혀졌다. 본 논문은 이런 문제를 해결하기 위해 본 논문은 Code augmented CoT를 제시한다.
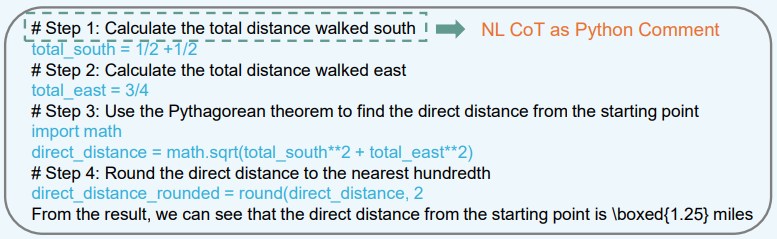
Code augmented CoT는 Policy 모델로 CoT를 생성할 때, 각 단계를 파이썬 코드 주석으로 된 NL CoT와 그에 대응하는 파이썬 코드로 구성하도록 하는 방법이다. 파이썬 코드가 정상적으로 실행되는 CoT만 high quality trajectory의 후보 (= valid trajectory)로 설정한다.
이 과정을 더 자세히 설명하면 다음과 같다.
Step i에서 가장 최근의 valid trajectory $x \oplus s_1 \oplus s_2 \oplus … \oplus s_{i-1}$를 현재 state로 설정한다. 이 state를 바탕으로 policy 모델이 다음 step이 될 수 있는 n개의 노드 후보 $s_{i,0}, s_{i,1}, …, s_{i,n-1}$를 생성하도록 prompt한다. 그 다음 이 후보들의 python code를 실행하여 valid한 노드만 남긴다. 이때, 각 노드 $s_{i,j}$의 코드는 아래 그림처럼 현재 state를 구성하는 모든 step들의 코드와 이어진 형태이다.
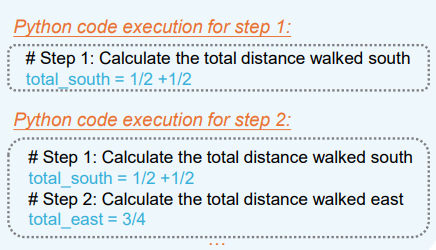
Valid한 후보는 PPM (Q-value $q(s_i)$를 부여하는 모델)에게 점수를 받게 된다. 그 다음 Upper Confidence bounds for Trees (UCT) 방법론을 통해 valid한 후보들 중에서 최고의 후보를 선택한다. 이때 최고의 후보란, 정답을 유도할 가능성이 높은 노드를 의미한다. 이 선택 과정은 수학적으로 다음과 같다.
\[UCT(s) = \underbrace{Q(s)}_{\text{exploitation}} + \underbrace{c \sqrt\frac {\ln N_{\text{parents}} (s)} {N(s)}}_{\text{exploration}} \text{ where } Q(s) = \frac {q(s)} {N(s)}\]이때, $N(s)$는 노드 s를 방문한 횟수, $N_{\text{parents}}(s)$는 노드 s의 parent 노드를 방문한 횟수이다. $q(s)$는 PPM이 노드 s에게 준 점수로 back propagation으로 update되는 값이다. c는 exploitation과 exploration의 비중을 조절하는 상수 값이다.
이때, Q-value Q(s)를 정확히 구해야 MCTS를 통해 정당한 high quality training data를 구축할 수 있다. 그러기 위해서는 PPM이 q(s)를 잘 예측해야 하는데 초기에는 PPM의 성능이 뛰어나지 않아 불확실성이 크다. 이를 해결하기 위해 첫 두 번의 evolution round에서는 Q-value를 Terminal-guided Annotation을 통해 계산한다.
Terminal-guided Annotation
이 방법은 Go라는 게임을 하는 사람들의 전략을 활용한다. Go 유저들은 어떤 move를 여러 번 실행해서 얻은 결과를 바탕으로 그 move의 우수성을 계산한다. 이 방법을 차용해서 Terminal-guided Annotation은 임의의 노드의 Q-value를 정확히 구하기 위해서 노드에서 시작해서 terminal 노드(최종 답안이 나온 노드)에 도달할 때까지 trajectory를 생성하는 과정을 반복한다. 이런 반복적인 과정을 extensive rollout이라고 지칭한다. Extensive rollout을 진행하면 이 노드가 실제 정답으로 얼만큼 유도했는지, 즉 실제 정답을 도출하는데 얼만큼 기여했는지를 계산할 수 있게 된다. 매 rollout마다 노드의 Q-value를 계속 update한다.
이 과정은 미래의 결과값을 통해 현재 값을 update하므로 back propagation이라고 한다. 어떻게 보면 통계학적인 방법으로 각 노드의 점수를 매기는 것이다
Extensive rollout을 진행하였는데 Q-value가 계속 높다면, 그 노드는 정답을 유도하는데 필수인 high quality step이라고 해석하고 Q-value가 낮다면, 그 노드는 정답을 유도하는데 필요없는 low quality step이라고 해석할 수 있게 된다. 이때 back propagation, 즉 Q-value의 값을 매 rollout마다 update하는 방법은 $q(s_i)^k$를 k번째 rollout을 수행하고 난 뒤 얻은 step $s_i$의 q-value라고 했을 때, 다음과 같다.
\[q(s_i)^k = q(s_i)^{k-1} + q(s_d)^k\]이때, $s_i$의 첫 q value는 0이다. Terminal node $s_d$의 q value는 정답과 같을 때는 $q(s_d)^k = 1$, 오답일 때는 $q(s_d)^k = -1$으로 계산한다.
Terminal-guided annotation을 적용한 training data로 PPM을 학습하면 PPM의 성능은 향상된다. 따라서 self evolution의 세 번째 round부터는 학습된 PPM을 통해 계산한 q-value로 training data를 구축한다.
PPM-augmented Annotation
PPM을 통해 q-value를 각 step에 부여할 때는 한 번의 PPM inference으로 q-value를 바로 구할 수 있기 때문에 extensive rollout이 필요하지 않다. PPM은 Terminal-guided annotation과 비교했을 때, 더 정확하고 세밀한 q-value를 부여할 수 있기 때문에 (Terminal-guided annotation은 다 정수) policy model이 생성한 CoT들로부터 더 높은 quality의 training data를 얻어낼 수 있다.
PPM이 step $s_i$의 q-value를 다음과 같이 계산한다.
\[q(s_i)^0 = PPM(x \oplus s_1 \oplus s_2 \oplus ... \oplus s_i)\]이 q-value 값도 terminal node $q(s_d)$의 값을 바탕으로 MCTS back propagation으로 update된다. 이때, $q(s_d)$는 PPM이 점수를 매기지 않고 Terminal-guided annotation의 방법처럼 값을 갖게 된다. 이 과정을 통해 모델의 예측 결과 (trajectory의 우수성 예측)와 실제 결과 (trajectory가 실제로 답을 맞췄는지)를 반영한 q-value 값을 각 step에 assign 할 수 있다.
Process Preference Model
이때, 왜 Process Reward Model (PRM)을 사용하지 않을까? PRM은 추론 step별 reward signal을 잘 생성하는 모델로 알려져 있지만 정확한 PRM을 얻기 위해서는 한계가 존재한다. PRM은 human feedback이나 다른 reward model을 통해 각 step에 준 label 값을 맞추도록 MSE loss나 pointwise loss를 최소화하는 방법으로 학습을 한다. 따라서, 각 step의 label 값을 정확하게 구하는 것이 매우 중요하다. 하지만, 현재 정확한 per step scoring 방법은 뚜렷하지 않기 때문에 process reward model의 예측값 자체에도 noise가 존재하다. (Label에도 noise가 있기 때문)
따라서 본 논문은 정확한 per step scoring 방법을 필요로 하지 않는 reward model 학습 방법을 고안하여 PRM 방식에서 벗어났다. Process Preference Model (PPM)은 각 step에 얼만큼의 reward을 부여해야 하는지를 학습하지 않고 오직 어떤 step이 더 좋은지 (preference)를 학습하여 reward model의 역할을 수행한다. 즉, discrete한 Q-value를 MCTS tree에서 preference pair dataset을 추출하기 위해서 사용하는 것이고 step의 label로 사용하는 것이 아니다.
Preference pair dataset을 구축하기 위해서 각 step에서 Q-value가 가장 높은 두 노드를 positive, 가장 낮은 두 노드를 negative으로 선택한다. 이때, positive node는 최종 정답으로 이어져야 하고, negative node는 오답으로 이어져야 한다. 추론을 수행한 위치에 따라 데이터를 구성하는 방법도 다르다. Intermediate steps에서 preference pair data를 얻을 때에는 동일한 앞부분 ($x \oplus s_1 \oplus s_2 \oplus … \oplus s_{i-1}$)을 공유하면서 그 다음 node $s_i$만 다르도록 한다. Final answer step에서 preference pair data를 얻을 때에는 앞부분이 같은데 최종 답이 다를 가능성이 매우 희박하기 때문에 이때는 그냥 평균 Q-value 값이 가장 높은 trajectory와 가장 낮은 trajectory를 비교 대상으로 삼는다.
PPM이 preference를 학습하기 위해 사용하는 loss function은 Bradley Terry model with pairwise ranking loss이다.
\[\mathcal{L_{\text{ppm}}(\theta)} = - \frac {1} {2 \times 2} \mathbb{E_{(x, y_i^{\text{pos}},y_i^{\text{neg}} \sim D)}} \left [ \log(\sigma(r_{\theta}(x,y_i^{\text{pos}}) - r_{\theta}(x,y_i^{\text{neg}}))) \right ]\]이때, i는 final answer step이 아니고 $y_i^{\text{pos}} = s_1 \oplus … \oplus s_{i-1} \oplus s_i^{\text{pos}}$이고 $y_i^{\text{neg}} = s_1 \oplus … \oplus s_{i-1} \oplus s_i^{\text{neg}}$이다. 그리고 $r_{\theta}(x,y)$는 PPM의 output을 의미한다.
Self Evolved Deep Thinking
rStar-Math는 이렇게 얻은 high quality의 step by step verified reasoning trajectory (training data)로 policy와 PPM을 학습하여 스스로 진화를 한다. 진화는 총 4 round을 거쳐 진행된다.
Training with Step by Step Verified Reasoning Trajectory
Math problems collection
정답이 하나의 값으로 정해진 747k 개의 수학 문제들만 포함시킨다. 이때, 쉬운 수학 문제를 사용하는 것은 LLM의 수학 추론 능력 향상에 큰 영향이 없다는 관찰을 통해 올림피아드처럼 어려운 수학 문제들만 포함시켰다. 어려운 수학 문제들의 개수에는 제한이 있기 때문에 GPT-4로 augment하였다. 하지만 hallucination으로 인해 풀 수 없는 문제나 잘못된 답을 가진 문제를 생성할 수 있기 때문에 문제를 생성하고 나서 10개의 solution을 작성하도록 prompt 하였고 최소 3개의 비슷한 solution이 존재하는 문제에 대해서만 Math problems collection에 포함했다.
Reasoning Trajectories Collection
Math problem collection에 존재하는 original solution을 사용하지 않고 extensive MCTS rollouts를 통해 검증된 high quality step by step reasoning trajectories를 sampling한다.
각 self-evolution round마다 문제 별로 16번의 rollout을 진행하여 16개의 reasoning trajectories를 얻는다. 이 trajectories가 정답을 맞춘 횟수를 통해 각 문제의 난이도를 easy, medium, hard으로 구분하였고 hard 문제에 대해서는 더 많은 positive reasoning trajectories를 얻기 위해 16번의 rollout을 추가로 진행하였다. MCTS를 통해 얻은 Q-values annotated (terminal-guided annotation) step by step trajectories으로 policy SLM과 PPM을 학습한다.
학습을 할 수 있는 Code augmented CoT와 step 별 label이 든 학습 data를 얻기 위해서 이 과정을 거쳤다고 이해하면 된다.
Supervised Fine-tuning the Policy SLM
Policy가 수학 문제를 풀기 위해서 제일 중요한 것은 high quality reasoning trajectories를 추려내는 것이다. 본 논문은 high quality reasoning trajectories란 Q-value의 평균값이 제일 높은 trajectories를 의미한다고 가정하였다. 따라서, 각 수학 문제 별로 정답을 도출하면서 Q-value 평균값이 제일 높은 두 trajectories를 추려내어 Policy SLM의 SFT training data를 구성한다. Policy는 이 SFT data를 next token prediction 방법으로 학습하게 된다.
Training PPM
PPM은 fine-tuned policy model로 초기화된다. 이때, policy model의 next token predicition head를 scalar value head (linear layer + tanh function)으로 대체하여 scalar reward의 범위를 [-1,+1]로 제한한다. 문제 중에 모든 trajectory가 positive이거나 negative인 문제는 preference pair를 구성하지 못하기 때문에 Mixed outcome이 존재하는 문제에 대해서만 two positive, two negative trajectories를 추출하여 preference pair dataset을 구성한다.
Recipe for Self-Evolution
SLM의 역량은 제한적이기 때문에 MCTS depp thinking을 4 rounds 동안 진행하여 점진적으로 더 높은 quality data를 생성하고 더 어려운 수학 문제들을 학습 데이터에 추가하였다. 각 round에서는 이전 round에서 학습된 모델들을 사용한다.
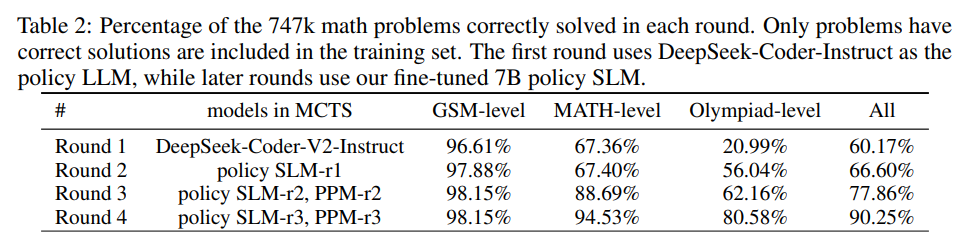
다음은 각 round에서 해결한 수학 문제들의 Percentage이다.
Round 1: Bootstrapping an initial strong policy SLM-r1
SLM이 좋은 training data를 생성하도록 하기 위해서 initial strong policy model을 finetune한다. DeepSeek Coder V2 Instruct 모델에서 시작하여 MCTS를 통해 SFT dataset을 얻는다. 이때, 첫 round이기 때문에 reward model이 없으므로 terminal guided annotation을 사용하고 효율성을 위해 Q-value 평균값이 제일 높은 두 trajectory로 SFT data를 구성하고 학습시켜 SLM-r1을 얻는다. 또 terminal guided annotated Q-value 값들을 바탕으로 preference dataset을 구성하고 학습시켜 PPM-r1을 얻는다.
Round 2: Training a reliable PPM-r2
SLM-r1으로 round 1에서처럼 MCTS rollout을 수행하여 training data를 얻는다. 이때는 extensive MCTS rollout (16 rollouts)으로 얻은 terminal guided annotation 기반 Q-value를 통해 더 발전된 training data를 구축한다. 이 training data로 학습한 policy SLM-r2와 PPM-r2는 더 향상된 성능을 보인다. 특히, PPM-r2는 이 round를 통해 reliable한 reward model이 된다.
Round 3: PPM augmented MCTS to significantly improve data quality
세 번째 round에서는 trajectory들의 Q-value annotation을 extensive rollout으로 하지 않고 PPM-r2를 통해 즉각적으로 한다. 이를 통해 더 세밀하고 정확한 MCTS를 수행할 수 있기 때문에 더 어려운 수학 문제들을 해결할 수 있는 trajectory들을 구별할 수 있게 되어 Training dataset에 더 어려운 문제들이 포함이 되기 시작한다. (해결한 문제들만 training set을 구성하므로) 따라서 더 발전된 training data를 구성하게 되고 이 data로 학습하여 SLM-r3와 PPM-r3가 만들어진다.
Round 4: Solving challenging math problems
Table 2를 보면 GSM과 MATH 난이도의 수학 문제들은 대부분 풀 수 있게 되어 대부분 training dataset에 포함되었지만 (98%, 88%) 난이도가 제일 높은 Olympiad 난이도의 수학 문제들은 오직 62%만 포함되어 있다. 이 이유는 SLM의 한계 때문이 아니라 그냥 너무 어렵기 때문이다. Olympiad 난이도의 수학 문제들을 더 풀 수 있게 만들어 더 어려운 문제가 포함된 dataset을 만들기 위해 본 논문은 특단의 조치를 한다. 풀지 못한 Olympiad 문제들에 대해 최대 128번까지의 rollout을 진행하여 SLM이 풀 수 있도록 한다. 이를 통해 Olympiad level 수학 문제의 80%를 풀 수 있게 되어 더 어려운 문제들이 dataset에 추가되었다.
4 round의 self-evolution을 하고 나서는 747k의 수학 문제들 중 90%가 해결되었으며 training dataset에 포함되었다.
나머지 10%의 문제는 어떤 문제인지 보기 위해 20 문제를 random하게 sampling하였다. 그 결과 19개의 문제가 오답으로 labeling 되어있었다. 따라서, rStar-Math로 Math problems collection 대부분의 수학 문제를 해결했다고 볼 수 있다.
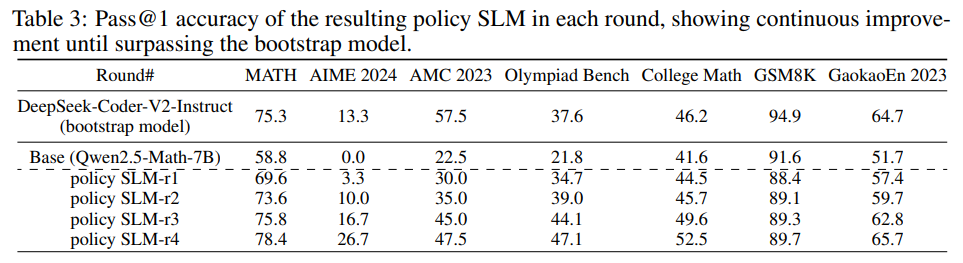
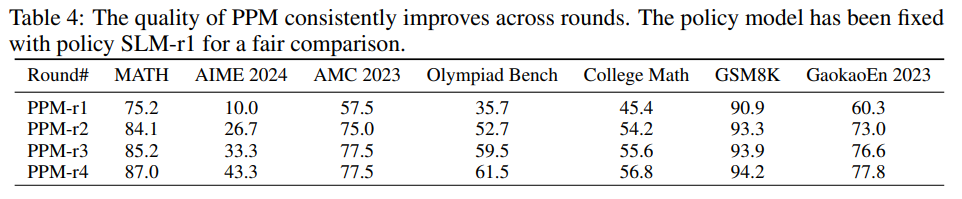
각 라운드가 진행된 후의 policy와 reward model의 성능 결과이다.
Result
Main Result
Results on diverse challenging math benchmarks
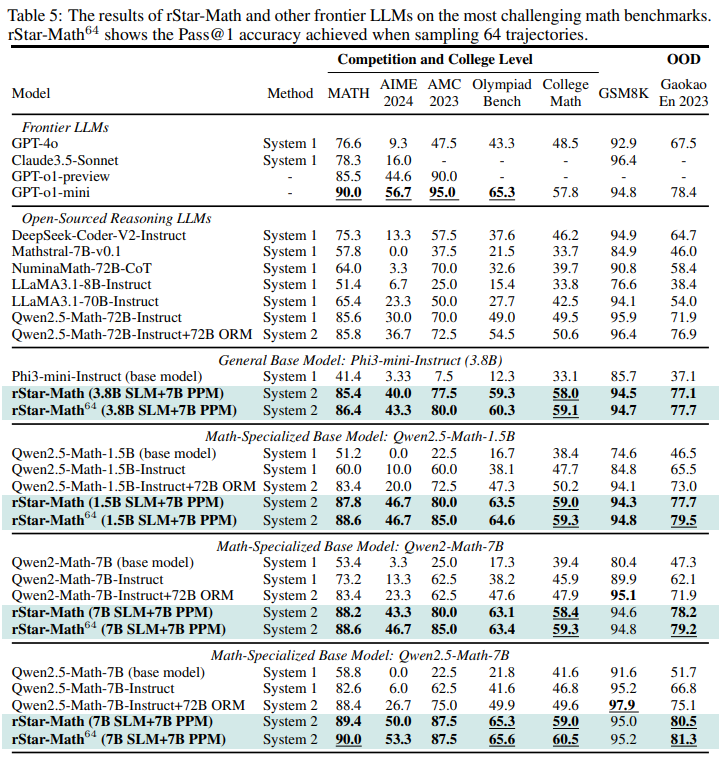
rStar-Math가 수학 문제 추론 능력을 얼만큼 향상시키는지 보기 위해 rStar-Math를 적용한 모델과 다른 모델들간의 수학 문제 해결 능력을 다양한 수학 benchmark로 평가하였다.
-
Baseline과 rStar-Math를 적용한 결과를 비교하면 SLM의 수학문제 해결 능력을 큰 폭으로 향상시킨다는 것을 알 수 있다.
-
1.5B ~ 7B 크기의 모델로 GPT-o1-preview보다 우수하고 GPT-o1-mini와 맞먹는 성능을 보여준다.
-
1.5B~7B policy 모델과 7B reward model만 사용하는데 기존의 SoTA System 2 baseline들보다 우수한 성능을 보인다.
-
Training set과 성격이 다른 수학 문제들 (Olympiad Bench, College Math, Gaokao)에서도 SoTa 성능을 보여 우수한 generalizability도 보임을 알 수 있다.
Scaling up test-time computation
Test time에서 더 많은 연산을 하면, 즉 더 많은 trajectories를 고려하게 할수록 rStar-Math의 성능이 얼만큼 향상되는지를 관찰하였다.
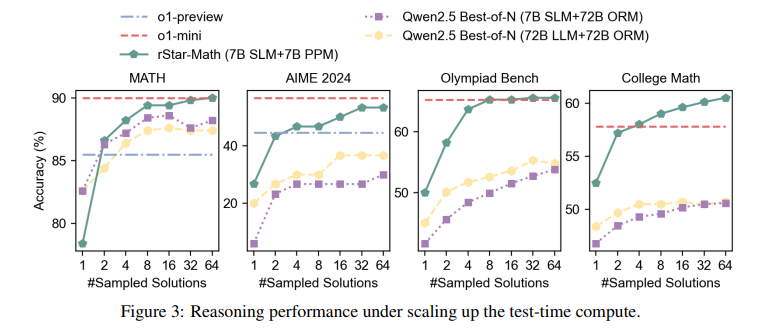
- 더 많은 trajectory를 고려할수록 성능 향상이 향상되었다. 이를 통해 rStar-Math가 Best-of-N 보다 더 효율적인 System 2 Thinking 방법임을 알 수 있다.
Ablation Study and Analysis
The effectiveness of self-evolution
Round가 진행될 때마다 수학 추론 능력을 test 해보았다.
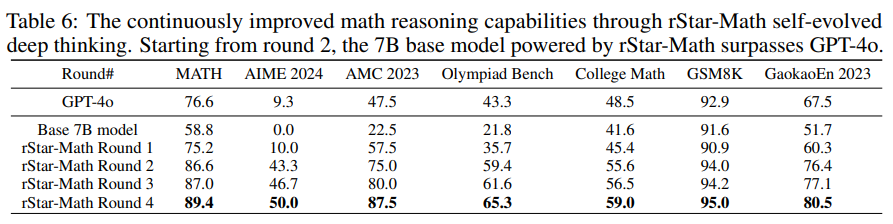
Self evolution round가 지날수록 성능이 지속적으로 증가한다. Round 2에서 성능 향상이 매우 큰 폭으로 진행됨을 알 수 있고 이때부터 GPT-4o를 능가한다.
The effectiveness of step-by-step verified reasoning trajectory
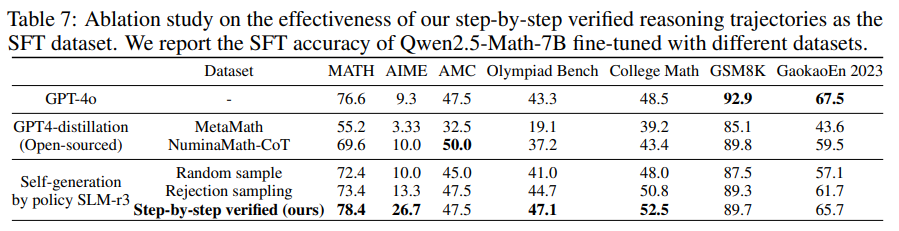
High quality math reasoning dataset을 직접 생성하면서 이에 대해 학습함으로써 rStar-Math는 self-evolution을 한다. 이때, 이 data가 실제로 모델 성능 향상에 얼만큼의 기여를 하는지 알아보기 위해 다양한 데이터 구성 방법으로 만든 data로 학습했을 때와 모델 성능을 비교하고자 하였다. 비교군으로 설정한 데이터 구성 방법들은 다음과 같다.
- GPT-distillation : GPT-4가 만든 공개 데이터셋
- Random Sampling from SLM-r3
- Rejection Sampling from SLM-r3 : 32개를 무작위 생성 후, Outcome Reward Model이 좋은 것 선택
각 dataset으로 Qwen 2.5 Math 7B를 finetuning하고 결과를 비교하였다.
-
본 논문이 생성한 방법대로 dataset으로 finetuning 하였을 때 성능이 가장 좋음. 이를 통해 PPM augmented MCTS가 더 우수한 math solution을 생성하기 때문에 SFT data로 사용되었을 때도 성능이 뛰어남을 알 수 있다.
-
SLM-r3에서 random sampling한 solution들로 finetuning한 결과도 GPT-distillation data로 finetuning 한 결과보다 뛰어나다는 것을 통해 rStar-Math의 framework는 advanced LLM distillation 없이도 더 뛰어난 solution을 생성하도록 한다는 것을 알 수 있다.
The effectiveness of PPM
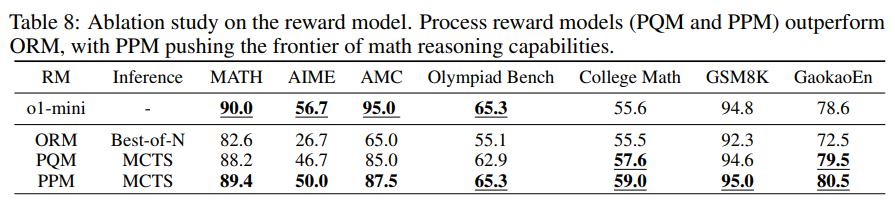
PPM의 effectiveness를 알아보기 위해 ORM, Q-value를 바탕으로 한 PRM(PQM) 간의 성능 차이를 비교하였다.
-
PPM과 PQM 모두 ORM보다 성능이 좋다는 것을 통해 step by step reward을 학습하는 것이 결과만을 바탕으로 풀이 과정의 reward을 학습하는 것보다 뛰어나다는 것을 알 수 있다.
-
PQM은 noise가 존재하는 Q-value를 정확하게 예측하려고 하는 학습 과정을 거치기 때문에 더 어려운 문제들의 solution을 평가할 때 PPM보다 성능이 좋지 않다. 이는 정확한 reward을 학습하려고 하지 않고 preference를 학습하는 과정의 우수성을 증명한다.
Findings and Discussions
The emergence of intrinsic self-reflection capability
자신의 답변이 틀렸다고 판단할 때, 자신의 풀이를 다시 되돌아보고 고칠 수 있는 능력을 self-reflection이라고 한다. 학습 dataset에 self-reflection을 학습하도록 한 data가 없음에도 MCTS deep thinking이 self-reflection을 하는 성격을 보인다는 것을 관찰하였다.
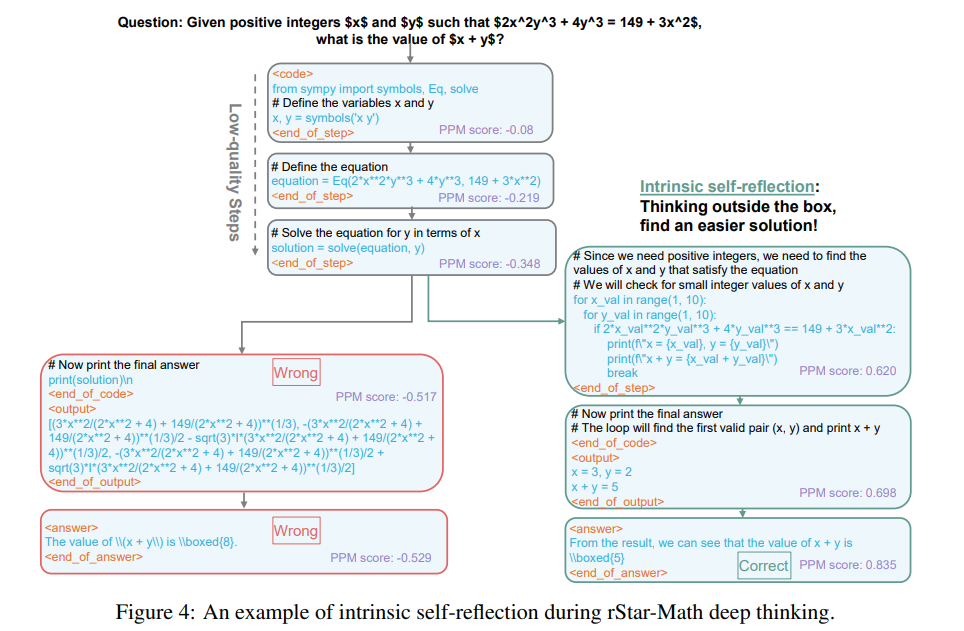
이를 통해 MCTS deep thinking은 내재적으로 self-reflection 능력을 갖도록 함을 알 수 있다.
PPM spots theorem-application steps
모델이 수학 문제를 해결하는 과정에서 문제 해결에 필요한 필수 이론을 언급할 때, PPM이 그 node에 높은 점수를 부여한다는 것을 관찰하였다. 이런 우수한 PPM 때문에 rStar-Math가 복잡한 수학 문제들도 해결할 수 있게 되고 더 high quality의 solution dataset을 형성할 수 있음을 알 수 있다.
Generalization discussion
수학 이론 증명, 코드, 상식 추론 등과 같은 다양한 domain에서도 우수한 성능을 보인다.