Direct Preference Optimization Your Language Model is Secretly a Reward Model 리뷰
Background
Large scale로 unsupervised learning을 하는 language model들은 지식과 추론 능력을 갖지만 이것이 꼭 올바른 행동으로 이어지지 않는다. 현재 Language model의 행동을 조절하기 위해서 사람이 상대적으로 선호하는 답변 data를 사용하여 이 상대적인 선호도를 Language model에 학습시키고 있다.
대표적인 예시로는 Reinforcement Learning with Human Feedback (RLHF)를 사용하는것이다. RLHF는 세 단계를 거친다.
1) SFT
pretrained Language model을 우수한 답변 (demonstration) 데이터를 통해 supervised하게 finetuning하여 $\pi^{SFT}$를 얻는 과정이다.
2) Reward modeling phase
$\pi^{SFT}$가 prompt x에 대해 pair of answers $(y1, y2) \sim \pi^{SFT}(y \mid x)$을 생성하도록 하고 human labeler들이 어떤 답변이 상대적으로 더 선호되는지를 판단하여 $(y_1, y_2)$를 선호되는 답안 $y_w$와 비선호되는 답안 $y_l$의 쌍 $(y_w, y_l)$으로 만든다.
이 인간 선호도를 Bradley Terry model로 모델링을 한다. Bradley Terry model에 따르면 human preference distribution $p^*$는 어떤 답안이 더 우위에 있을 확률을 통해 표현할 수 있다고 한다.
\[p^* (y_1 > y_2 \mid x) = \frac {exp(r^* (x,y_1))} {exp(r^* (x,y_1)) + exp(r^* (x,y_2))} (a)\]이 $p^{*}$ 로부터 각 $x^{(i)}$ 에 대한 두 답안 $y_w^{(i)}, y_l^{(i)}$ pair로 이루어진 dataset $D$ 을 sampling하여 이 dataset을 바탕으로 reward model $r_{\phi}(x,y)$ 을 다음 objective으로 학습시킬 수 있다. 이렇게 얻은 reward function은 어떤 답안이 사람에게 더 선호될 지 맞출 수 있는 함수가 된다.
\[\mathcal{L}(\phi) = - \mathbb{E}_{(x, y_w, y_l) \sim D} \left[ \log \sigma \left( r_{\phi}(x, y_w) - r_{\phi}(x, y_l) \right) \right]\]3) RL Finetuning phase
학습된 reward function을 통해 language model에게 피드백을 주어 강화학습을 진행한다.
너무 큰 변화를 막으면서도 모델의 generation의 reward가 높도록 update하는 objective를 사용한다.
본 논문은 이 방법은 우선 인간 선호도를 반영하는 reward model을 학습해야 하고 이 reward model을 가지고 large scale language model을 강화학습으로 finetuning해야 하기 때문에 불안정하다고 주장한다. 또, 강화학습을 사용하는 방법은 language model을 여러 번 학습시켜야 하고 학습 과정에서 policy로부터 샘플링해야 한다는 점에서 비용이 비싸다.
보통의 경우 objective function을 미분하여 optimization을 진행하는데 이 objective에서는 language generation의 discrete한 특징으로 인해 미분이 불가능하기 때문에 강화학습을 사용할 수 밖에 없다.
Direct Preference Optimization (DPO)
본 논문의 근본적인 목표는 RLHF와 동일하다. Language model이 인간의 선호도를 학습하여 지식만 지닌 상태가 아닌 사람의 지시사항에 잘 따르도록 하고자 한다. 이때, Language model finetuning과 같은 large scale 문제에는 강화학습을 적용하기에는 한계가 뚜렷하기 때문에 본 논문은 reward model과 강화학습 없이 language model의 human preference 학습을 간단하게 하는 방법을 고안하였다.
DPO의 방법론을 요약하면 DPO는 reward model의 reparameterization을 통해 optimal policy를 바로 계산한다. 본 논문의 key insight는 Reward function에서 최적의 policy로의 analytic 매핑을 활용하여 change-of-variables 접근 방식을 통해 reward function에 대한 loss function을 policy에 대한 loss function으로 변환하였다. 이를 통해 복잡하고 불안정한 강화학습이 아닌 간단한 binary cross-entropy objective를 이용하여 directly하게 policy와 human preference를 align할 수 있게 되었다.
DPO objective 유도 과정
DPO는 RLHF의 objective function으로부터 시작된다.
\[max_{\pi_{\phi}} \mathbb{E_{x \sim D, y \sim \pi_{\phi}(y \mid x)}} \left [ r_{\theta}(x,y) - \beta log \frac {\pi_{\phi}(y \mid x)} {\pi_{\text{ref}}(y \mid x)} \right ] (1)\]전체에 -$\frac {1} {\beta}$을 곱하면
\[min_{\pi_{\phi}} \mathbb{E_{x \sim D, y \sim \pi_{\phi}(y \mid x)}} \left [ log \frac {\pi_{\phi}(y \mid x)} {\pi_{\text{ref}}(y \mid x)} - \frac {1} {\beta} \cdot r_{\theta}(x,y) \right ] (2)\] \[min_{\pi_{\phi}} \mathbb{E_{x \sim D, y \sim \pi_{\phi}(y \mid x)}} \left [ log \frac {\pi_{\phi}(y \mid x)} {\pi_{\text{ref}}(y \mid x)} - log(exp( \frac {1} {\beta} \cdot r_{\theta}(x,y))) \right] (3)\] \[min_{\pi_{\phi}} \mathbb{E_{x \sim D, y \sim \pi_{\phi}(y \mid x)}} \left [ log \frac{\pi_{\phi}(y \mid x)} {\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r_{\theta}(x,y))} \right] (4)\]임의의 값 $Z(x)$를 더하고 빼는 것은 아무 영향이 없으므로
\[min_{\pi_{\phi}} \mathbb{E_{x \sim D, y \sim \pi_{\phi}(y \mid x)}} \left [ log \frac{\pi_{\phi}(y \mid x)} {\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r_{\theta}(x,y))} + logZ(x) - logZ(x) \right] (5)\] \[min_{\pi_{\phi}} \mathbb{E_{x \sim D, y \sim \pi_{\phi}(y \mid x)}} \left [ log \frac{\pi_{\phi}(y \mid x)} { \frac {1} {Z(x)} \times \pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r_{\theta}(x,y))} - logZ(x) \right] (6)\]이때, Z(x)가 $\sum_{y} (\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r_{\theta}(x,y)))$라고 한다면, $\pi_{\text {ref}}$에만 의존하는 확률 분포 $\pi^*(y \mid x)$가 나온다.
\[\pi^*(y \mid x) = \frac {\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r_{\theta}(x,y))} {Z(x)} (7)\]모든 y에 대해 $\pi^* (y \mid x) \ge 0$ 이면서 $\sum_{y} \pi^*(y \mid x) = 1$ 이기 때문에 valid한 확률 분포이다.
Z(x)는 y에 대한 함수가 아니기 때문에 equation (7)을 대입하면 objective가 다음과 같이 변한다.
\[min_{\pi_{\phi}} \mathbb{E_{x \sim D}} \left [ \mathbb{E_{y \sim \pi_{\phi}(y \mid x)}} \left [ log \frac{\pi_{\phi}(y \mid x)} {\pi^* (y \mid x)} \right ]- logZ(x) \right] (8)\]$log \frac{\pi_{\phi}(y \mid x)} {\pi^* (y \mid x)}$은 두 분포의 KL-divergence 값이므로
\[min_{\pi_{\phi}} \mathbb{E_{x \sim D}} \left [ D_{KL}(\pi_{\phi}(y \mid x) \mid\mid \pi^* (y \mid x)) - logZ(x) \right] (9)\]이때 Z(x)는 $\phi$와 독립적이기 때문에 고려하지 않아도 된다. Optimal policy를 구하기 위해서는 이 objective을 최소화하는 ($D_{KL}$값을 최소화하는) $\phi$를 찾아야 한다. Gibb’s equality에 따르면, $D_{KL}$값이 최소일 때는 두 분포 $\pi_{\phi} (y \mid x)$ 와 $\pi^* (y \mid x)$ 가 동일할 때이다. 따라서, KL-constraint을 지닌 reward maximization objective을 최대화하는 policy $\pi_{\phi}$ 는 $\pi^*$ 인 것이다.
\[\pi_{\phi}(y \mid x)= \pi^*(y \mid x) = \frac {\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r_{\theta}(x,y))} {Z(x)} \,\,\,(10)\]하지만 이 policy를 계산하는 과정은 Z(x)를 계산하기 위해서는 불안정한 reward model을 사용해야 되기 때문에 여전히 불안정하다. 여기서 DPO는 reward model의 reparameterization을 통해 optimal policy를 얻는다. Equation (7)을 $\pi_{\phi}, \pi_{ref}, Z(x)$에 대해 정리하면
\[\log(\pi^*(y \mid x)) = \log(\frac {\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r_{\theta}(x,y))} {Z(x)})\] \[\log(\pi^*(y \mid x)) + log(Z(x)) = log(\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} r_{\theta}(x,y)))\] \[\log(\frac {\pi^*(y \mid x)} {\pi_{\text{ref}}(y \mid x)}) + \log(Z(x)) = log(exp( \frac {1} {\beta} r_{\theta}(x,y)))\] \[\log(\frac {\pi^*(y \mid x)} {\pi_{\text{ref}}(y \mid x)}) + \log(Z(x)) = \frac {1} {\beta} r_{\theta}(x,y)\]따라서, $r(x,y)$는 다음과 같이 표현할 수 있다.
\(r(x,y) = \beta \cdot \log \frac {\pi_\phi(y \mid x)} {\pi_{ref}(y \mid x)} + \beta \cdot \log (Z(x)) (11)\)
Reward function에서 optimal policy로 mapping을 한 것으로 볼 수 있다.
이때, Bradley Terry model은 두 답변의 reward 값의 차이를 통해 preference를 모델링하기 때문에 이 reward function의 reparameterization을 사용하면 Z(x) term을 없앨 수 있다.
\[p^*(y_1 > y_2 \mid x) = \frac {1} {1+exp(\beta \log \frac {\pi_{\phi}(y_2 \mid x)} {\pi_{ref}(y_2 \mid x)} - \beta \log \frac {\pi_{\phi}(y_1 \mid x)} {\pi_{ref}(y_1 \mid x)})}\]sigmoid function $\sigma(x)$는 $\frac {1} {1 + e^{-x}}$이므로
\[p^*(y_1 > y_2 \mid x) = \sigma (\beta \log \frac {\pi_{\phi}(y_1 \mid x)} {\pi_{ref}(y_1 \mid x)} - \beta \log \frac {\pi_{\phi}(y_2 \mid x)} {\pi_{ref}(y_2 \mid x)})\]즉, preference modeling을 reward model을 거치지 않고 policy로 직접 할 수 있게 되었다. $p^*$을 최대화하는 policy가 human preference와 최대한 align된 policy이기 때문에 Negative log likelihood을 적용하면 간단한 binary cross entropy classification objective가 나온다.
\[\mathcal{L_{\text{DPO}}}(\pi_{\phi} ; \pi_{ref}) = -\mathbb{E_{(x, y_w, y_l) \sim \text{D}}} \left[ \log \sigma (\beta \log \frac {\pi_{\phi}(y_w \mid x)} {\pi_{ref}(y_w \mid x)} - \beta \log \frac {\pi_{\phi}(y_l \mid x)} {\pi_{ref}(y_l \mid x)}) \right]\]이 식을 보면 RLHF에서 사용한 reward model의 loss function인 equation (b)와 비슷하다. 즉, reward model의 loss function으로부터 optimal policy의 loss function로 변환한 것이다.
정리하자면 DPO는 reward model을 거치지 않고 human preference dataset와 간단한 objective으로 policy와 human preference를 직접 align시킬 수 있도록 하였다.
DPO update 해석
Objective의 gradient을 통해 policy가 update되는 방향을 알 수 있다.
\[\mathcal{L_{\text{DPO}}}(\pi_{\phi} ; \pi_{ref}) = -\mathbb{E_{(x, y_w, y_l) \sim \text{D}}} \left[ \log \sigma ( \underbrace {\beta \log \frac {\pi_{\phi}(y_w \mid x)} {\pi_{ref}(y_w \mid x)} - \beta \log \frac {\pi_{\phi}(y_l \mid x)} {\pi_{ref}(y_l \mid x)})}_{g(\phi)} \right]\]$g(\phi) = \beta \log \frac {\pi_{\phi}(y_w \mid x)} {\pi_{ref}(y_w \mid x)} - \beta \log \frac {\pi_{\phi}(y_l \mid x)} {\pi_{ref}(y_l \mid x)} = \beta \log \pi_{\phi}(y_w \mid x) - \beta \log \pi_{ref}(y_w \mid x) + \beta \log \pi_{\phi}(y_l \mid x) - \beta \log \pi_{ref}(y_l \mid x)$ 라고 할 때
\[\nabla_{\phi} \mathcal{L_{\text{DPO}}}(\pi_{\phi} ; \pi_{ref}) = - \nabla_{\phi} \mathbb{E_{(x, y_w, y_l) \sim \text{D}}} \log \sigma (g(\phi))\]이때, $\sigma$의 특성으로 인해 쉽게 미분할 수 있다.
\[log \, \sigma (g(x)) ' = \frac {\sigma ' (g(x))} {\sigma (g(x))} \times g'(x)\]$\sigma(x) = \frac {1} {1+e^{-x}}$이므로 $\sigma ‘ (x) = \frac {e^{-x}} {(1+e^{-x})^2} = \frac {1} {1+e^{-x}} \cdot \frac {e^{-x}} {1+e^{-x}} = \sigma(x) \cdot (1 - \sigma(x))$이다.
따라서
\[log \, \sigma (g(x)) ' = \frac {\sigma ' (g(x))} {\sigma (g(x))} \times g'(x) = (1 - \sigma (g(x))) \times g'(x)\]이때, $\sigma(x) + \sigma(-x) = 1$이므로 $1 - \sigma (g(x)) = \sigma(-g(x))$이다.
한편, $g’(x) = \nabla_{\phi} (\beta \log \frac {\pi_{\phi}(y_w \mid x)} {\pi_{ref}(y_w \mid x)} - \beta \log \frac {\pi_{\phi}(y_l \mid x)} {\pi_{ref}(y_l \mid x)} = \beta \log \pi_{\phi}(y_w \mid x) - \beta \log \pi_{ref}(y_w \mid x) + \beta \log \pi_{\phi}(y_l \mid x) - \beta \log \pi_{ref}(y_l \mid x))$에서 $\pi_{ref}$는 $\phi$와 독립적이므로 $g’(x) = \nabla_{\phi} (\beta \log \pi_{\phi}(y_w \mid x) - \beta \log \pi_{\phi}(y_l \mid x))$이다.
다 대입하면,
\[\mathcal{L_{\text{DPO}}}(\pi_{\phi} ; \pi_{ref}) = - \beta \cdot \mathbb{E_{(x, y_w, y_l) \sim \text{D}}} \left [ \sigma(- \log \frac {\pi_{\phi}(y_w \mid x)} {\pi_{ref}(y_w \mid x)} + \log \frac {\pi_{\phi}(y_l \mid x)} {\pi_{ref}(y_l \mid x)}) \cdot \nabla_{\phi} (\log \pi_{\phi}(y_w \mid x) - \log \pi_{\phi}(y_l \mid x)) \right ]\]Reward model의 reparameterization을 다시 적용하면, policy $\pi_{\phi}$와 $\pi_{ref}$의 reward function은 $\hat r_{\phi}(x,y) = \beta \cdot \log \frac {\pi_\phi(y \mid x)} {\pi_{ref}(y \mid x)} + \beta \cdot \log (Z(x))$ 이므로
\[\mathcal{L_{\text{DPO}}}(\pi_{\phi} ; \pi_{ref}) = - \beta \cdot \mathbb{E_{(x, y_w, y_l) \sim \text{D}}} \left [ \underbrace {\sigma(\hat r_{\phi}(x,y_l) - \hat r_{\phi}(x,y_w))}_{update의 weight} \cdot \nabla_{\phi} (\underbrace {\log \pi_{\phi}(y_w \mid x)}_{y_w의 likelihood} - \underbrace {\log \pi_{\phi}(y_l \mid x))}_{y_l의 likelihood} \right ]\]Derivative를 통해 gradient descent를 진행하면
\(\phi_{new} = \phi - \alpha \cdot \mathcal{L_{\text{DPO}}}(\pi_{\phi} ; \pi_{ref})\)
DPO의 loss function의 derivative는 직관적으로 다음과 같이 해석된다.
- $y_l$의 선호도를 $y_w$의 선호도보다 높게 평가하였다면, 잘못된 판단이므로 update의 크기가 커진다.
- $y_w$의 likelihood을 높이고 $y_l$의 likelihood을 낮추는 방향으로 policy가 update 된다
Theoretical Analysis of DPO
Your Language Model is Secretly a Reward Model
DPO는 Language model (policy)에 이미 reward model이 내재되어있기 때문에 따로 특정 reward model을 거치지 않더라도 optimal policy를 얻을 수 있다는 것이다. 본 논문에서는 다음 내용을 통해 Reward model의 reparameterization의 정당성을 증명하고 또 reparameterization를 활용한 방법이 reward model의 class와 상관없이 optimal policy를 항상 유도할 수 있다는 것을 보여준다.
Reparameterization의 정당성 증명은 다음 사실들을 기반으로 한다.
Definition 1)
reward functions $r(x,y)$와 $r’(x,y)$가 어떤 함수에 대해서 $r(x,y) - r’(x,y) = f(x)$을 만족하면 equivalent하다.
이 definition은 prompt x에 대해 답변들의 reward 값 자체는 변해도 두 답변의 상대적 ranking은 변하지 않는다면 동일한 equivalent class에 속한다는 것을 의미한다. r’(x,y)는 A,B에게 각각 10점과 100점을 주는 함수라고 할 때, r(x,y)가 A,B에게 각각 10+80점과, 100+20점을 주어도 ranking은 변하지 않음.
Lemma 1)
동일한 equivalence class의 두 reward function은 동일한 (Plackett-Luce, 특히 Bradley-Terry 기반) preference distribution을 도출한다.
즉, 동일한 human preference prediction을 한다.
Definition 1에 따르면, 동일한 class의 r(x,y)와 r’(x,y)는 임의의 함수 f(x)에 대해 r(x,y) + f(x) = r’(x,y)을 만족한다. 이 관계식을 바탕으로 general한 Plackett-Luce을 생각해보자. reward function r’을 바탕으로 답변들 중 ranking $\gamma$에 대한 확률분포 $p_{r’}(\gamma \mid y_1, .. y_K, x)$은 다음과 같다.
\[p_{r'}(\gamma \mid y_1, .. y_K, x) = \Pi_{k=1}^{K} \frac {exp(r'(x, y_{\gamma (k)}))} {\sum_{j=k}^{K} exp(r'(x, y_{\gamma(j)}))}\]
여기서 r(x,y) + f(x) = r’(x,y)을 대입하면
\[p_{r'}(\gamma \mid y_1, .. y_K, x) = \Pi_{k=1}^{K} \frac {exp(r(x, y_{\gamma (k)}) + f(x))} {\sum_{j=k}^{K} exp(r(x, y_{\gamma(j)}) + f(x))}\]
\[p_{r'}(\gamma \mid y_1, .. y_K, x) = \Pi_{k=1}^{K} \frac {exp(f(x)) \cdot exp(r(x, y_{\gamma (k)}))} {\sum_{j=k}^{K} exp(f(x)) \cdot exp(r(x, y_{\gamma(j)}))}\]
f(x)는 k와 독립적이므로 소거가 가능함
\[p_{r'}(\gamma \mid y_1, .. y_K, x) = \Pi_{k=1}^{K} \frac {exp(r(x, y_{\gamma (k)}))} {\sum_{j=k}^{K} exp(r(x, y_{\gamma(j)}))} = p_{r}(\gamma \mid y_1, .. y_K, x)\]
따라서, reward function r와 r’ 둘 다 동일한 preference distribution을 도출한다는 것이 증명된다.
Lemma 2)
동일한 equivalence class의 두 reward function은 constrained RL 문제에서 동일한 optimal policy를 도출한다.
r’(x,y)와 r(x,y)가 동일한 class의 reward function이라고 가정하고 r’(x,y)를 통해 도출되는 optimal policy를 $\pi_r$, r(x,y)를 통해 도출되는 optimal policy는 $\pi_{r’}$라고 하자. 그렇다면 Equation (10)에 따르면
\[\pi_{r'}(y \mid x) = \frac {\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r'(x,y))} {\sum _{y} (\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r'(x,y)))}\]
Definition 1에 따라 임의의 함수 f(x)에 대해 r(x,y) + f(x) = r’(x,y)을 만족하기 때문에
\[\pi_{r'}(y \mid x) = \frac {\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r(x,y) + f(x))} {\sum _{y} (\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r(x,y) + f(x)))}\]
\[\pi_{r'}(y \mid x) = \frac {exp(f(x)) \times \pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r(x,y))} {exp(f(x)) \times \sum _{y} (\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r(x,y)))}\]
f(x)는 y와 독립적이므로 소거가 된다.
\[\pi_{r'}(y \mid x) = \frac {\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r(x,y))} {\sum _{y} (\pi_{\text{ref}}(y \mid x) \times exp( \frac {1} {\beta} \cdot r(x,y)))} = \pi_{r}(y \mid x)\]
따라서 reward function r’(x,y)와 r(x,y)은 동일한 optimal policy를 도출한다.
Definition 1과 Lemma 1,2를 통해 알 수 있는 정보는 다음과 같다.
-
어차피 같은 equivalence class에 있는 reward function들은 똑같은 optimal policy를 도출한다.
-
그러니 우리는 그 class 안의 reward function을 정확히 정의할 필요가 없다.
-
그냥 그 class에 속하는 임의의 Reward function으로 최적 정책은 얻을 수 있다.
-
DPO는 Reparameterization을 통해, 리워드 함수를 명시적으로 구하지 않고도 이 과정을 암묵적으로(Implicitly) 수행한다.
Theorem
모든 prompt x, 답안 y pair에 대해 $\pi_{ref}(y \mid x) > 0$을 만족하는 reference model이 존재한다고 가정하자. 그렇다면 모든 reward equivalence classes consistent with the Plackett-Luce (and Bradley-Terry in particular)는 어떤 model $\pi(y \mid x)$에 대해 $r(x,y) = \beta \log \frac {\pi(y \mid x)} {\pi_{ref}(y \mid x)}$로 reparameterization 할 수 있다.
증명 과정
임의의 reward function r(x,y)가 KL constrained RL problem 하에 도출하는 optimal policy가 $\pi_r$라고 하자. 이때, r(x,y)와 동일한 equivalence class의 reward function r’(x,y)가 $\beta \log \frac {\pi(y \mid x)} {\pi_{ref}(y \mid x)}$으로 reparameterization될 수 있다는 것을 보여주어 theorem 1을 증명한다.
Equation (11)에 따라 $r(x,y)$는 다음을 만족한다.
\[r(x,y) = \beta \cdot \log \frac {\pi_r(y \mid x)} {\pi_{ref}(y \mid x)} + \beta \cdot \log (Z(x))\]이때, $Z(x)$는 모든 y에 대한 확률을 알아야 계산이 가능하기 때문에 계산이 불가능하다. $Z(x)$를 계산할 필요가 없도록 다음과 같은 projection $f$이 존재한다고 하자. $f$는 reward function 값을 partition function $Z(x)$의 $\log$ 값으로 normalize하는 함수라고 볼 수 있다.
\[f(r ; \pi_{ref}, \beta) (x,y) = r(x,y) - \beta \log \sum_{y} \pi_{ref} (y \mid x) exp(\frac {1} {\beta} r(x,y)) = r(x,y) - \beta \log Z(x)\]$Z(x)$는 $x$에만 대한 함수이기 때문에 Definition 1에 따라 $f(r ; \pi_{ref}, \beta) (x,y)$를 $r(x,y)$와 동일한 equivalence class의 reward function으로 해석할 수 있다. 간단하게 표현하기 위해 $f(r ; \pi_{ref}, \beta) (x,y)$을 $r’(x,y)$라고 하자.
이때, $r(x,y) = \beta \cdot \log \frac {\pi_r(y \mid x)} {\pi_{ref}(y \mid x)} + \beta \cdot \log (Z(x))$을 위 관계식에 대입하면,
\[r'(x,y) = f(r ; \pi_{ref}, \beta) (x,y) = \beta \cdot \log \frac {\pi_r(y \mid x)} {\pi_{ref}(y \mid x)}\]따라서, 모든 reward equivalence classes는 $r(x,y) = \beta \cdot \log \frac {\pi_r(y \mid x)} {\pi_{ref}(y \mid x)}$의 reparameterization이 가능하다는 것이 증명된다.
즉, 모든 reward function은 Plackett-Luce 기반 문제에서 현재 policy와 reference policy의 log ratio로 대체할 수 있다는 것이다. (reward 값이 높은 답변이라는 것은 reference 모델보다 훈련된 모델이 훨씬 더 높은 확률로 내뱉는 답변이라고 해석할 수 있게 된다)
이때, reparameterization 할 수 있다는 것은 완벽히 같다는 것이 아니라 대체를 할 수 있다는 것을 의미한다는 것을 명심하자. Plackett-Luce 기반 문제에서 관심 있는 건 선호도 Ranking 뿐이기 때문에 $Z(x)$가 붙어 있든 안 붙어 있든 순위 매기는 데는 아무런 차이가 없다. 따라서 복잡한 $Z(x)$를 달고 다니는 모든 Reward Function들을, 계산하기 가장 편한 $r’$ 형태로 ‘대표’해서 바꿔 써도 아무 문제가 없다는 것을 Theorem 1이 의미하는 것이다.
이에 더해서 동일한 class의 두 reward function은 constrained RL 문제에서 동일한 optimal policy를 도출한다는 Lemma 2를 적용하면 다음과 같다.
\[r'(x,y) = f(r ; \pi_{ref}, \beta) (x,y) = \underbrace {\beta \cdot \log \frac {\pi_r(y \mid x)} {\pi_{ref}(y \mid x)} = \beta \cdot \log \frac {\pi_{r'}(y \mid x)} {\pi_{ref}(y \mid x)}}_{Lemma 2} = f(r' ; \pi_{ref}, \beta) (x,y)\]
따라서 $f(r)(x,y)$는 하나의 equivalence class의 모든 reward function들을 동일한 reward function(parameterization)으로 mapping해주는 함수라는 것을 알 수 있다.
\[r(x,y) \xrightarrow{f} \beta \log \frac{\pi(y \mid x)}{\pi_{\text{ref}}(y \mid x)}\]
정리하자면, reward function으로부터 optimal policy를 얻을 수 있고 optimal policy와 reference policy의 log 비율로 reward function을 대체할 수 있다는 것을 증명하였다.
여기서 문제는 Theorem 1은 reward function을 $\beta \log \frac{\pi(y \mid x)}{\pi_{\text{ref}}(y \mid x)}$으로 대체를 할 수 있다는 것만 보여준다. 하지만 이렇게 대체하여 학습했을 때, policy가 올바른 human preference을 학습했는지 알 수 없다. 따라서 reward function의 reparameterization을 사용하여 학습했을 때 도출된 optimal policy가 의도된 human preference을 잘 ranking하는 reward function과 일대일 대응이 되는가를 증명해야 한다.
본 논문은 다음 명제 제시하고 증명한다. Proposition 1 모든 prompt x, 답안 y pair에 대해 $\pi_{ref}(y \mid x) > 0$을 만족하는 reference model이 존재한다고 가정하자. 그렇다면 모든 reward functions의 equivalence class에 $r(x,y) = \beta \cdot \log \frac {\pi_r(y \mid x)} {\pi_{ref}(y \mid x)}$으로 reparameterize 될 수 있는 reward function은 오직 하나이다.
말이 어려운데, 쉽게 말하면 Reward Function과 Optimal Policy 사이에 일대일 대응이 성립함을 증명하여, Reward Model을 Policy의 로그 비율 식으로 치환해도 수학적으로 유일한 정답을 찾을 수 있음을 보장하고자 하는 것이다.
증명 과정
명제의 모순을 통해 증명한다. 동일한 class의 reward function $r(x,y)$와 $r’(x,y)$가 존재한다고 하자. Definition 1에 의해 $r’(x,y) = r(x,y) + f(x)$가 만족한다. 추가로 어떤 model $\pi’(y \mid x)$에 대해 $r’(x,y) = \beta \log \frac {\pi’(y \mid x)} {\pi_{ref} (y \mid x)}$가 성립하고 어떤 model $\pi(y \mid x)$에 대해 $r(x,y) = \beta \log \frac {\pi(y \mid x)} {\pi_{ref} (y \mid x)}$가 성립하며 $\pi’ \ne \pi$라고 하자. 그렇다면 모든 prompt x와 답안 y에 대해 다음이 성립해야 한다.
\[r'(x,y) = r(x,y) +f(x) = \beta \log \frac {\pi(y \mid x)} {\pi_{ref} (y \mid x)} + f(x) = \log \frac {\pi(y \mid x) exp(\frac {1} {\beta} f(x))} {\pi_{ref} (y \mid x)} = \beta \log \frac {\pi'(y \mid x)} {\pi_{ref} (y \mid x)}\]
이것이 성립하기 위해서는 $\pi(y \mid x) exp(\frac {1} {\beta} f(x)) (y \mid x) = \pi’(y \mid x)$이 만족해야 한다. $\pi 와 \pi’$는 모두 확률 분포이므로 양변에 모든 y에 대해 더하면 1이 된다. 따라서, 성립하기 위해서는 $exp(\frac {1} {\beta} f(x)) = 1$이어야 한다. $\beta > 0$이기 때문에 모든 x에 대해서 $f(x) = 0$이어야 한다. 그렇다면 $r’(x,y) = r(x,y) + f(x)$에 의해 $r’(x,y) = r(x,y)$을 만족해야 한다. 모순!!
따라서, Reward Function과 Optimal Policy 사이에 일대일 대응이 성립하며 Reward Model을 Policy의 로그 비율 식으로 치환해도 수학적으로 유일한 정답을 찾을 수 있다.
모든 내용을 정리하자면, RLHF은 reward modeling을 통해 reward function을 따로 학습하고 이를 기반으로 policy를 강화학습을 시킨다.
\[max_{\pi_{\theta}} \mathbb{E}_{x \sim D, y \sim \pi_{\theta} (y \mid x)} \left[ r_\phi(x, y) \right] - \beta \cdot D_{KL} \left[ \pi_{\theta}(y \mid x) \mid \mid {\pi^{\text{ref}}(y \mid x)} \right] \,\, (c)\]하지만 Theorem 1과 Proposition 1에 따르면 Plackett-Luce 기반의 모든 reward function은 $\beta \log \frac{\pi(y \mid x)} {\pi_{\text{ref}}(y \mid x)}$ 으로 대체할 수 있으며, 대체하고 학습을 한 optimal policy는 필연적으로 올바른 human preference를 가진 policy라는 것이다. 따라서, RLHF와 같은 과정을 거치지 않아도 된다는 것이다. 그래서 DPO의 objective는 다음과 같이 reward function을 필요로 하지 않는다.
\[\mathcal{L_{\text{DPO}}}(\pi_{\phi} ; \pi_{ref}) = -\mathbb{E_{(x, y_w, y_l) \sim \text{D}}} \left[ \log \sigma (\beta \log \frac {\pi_{\phi}(y_w \mid x)} {\pi_{ref}(y_w \mid x)} - \beta \log \frac {\pi_{\phi}(y_l \mid x)} {\pi_{ref}(y_l \mid x)}) \right]\]어떻게 보면 policy (language model)로 reward 값을 대체할 수 있기 때문에 본 논문에서 Your language model is secretly a reward model이라는 문장으로 표현한 것이다.
Instability of Actor-Critic Algorithms
다음은 PPO의 objective를 변형시킨 것이다.
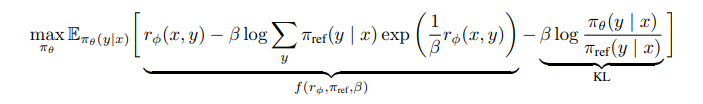
PPO는 Gradient 분산을 낮추기 위해 계산하기 어려운 $Z(x)$를 억지로 추정해야 해서 불안정하다는 것을 알 수 있다.
하지만 DPO는 $Z(x)$를 제거했기 때문에 Critic 없이도 안정적인 학습이 가능하다.