Training language models to follow instructions with human feedback 리뷰
Background
Language model의 parameter의 수가 많아지면 NLP task에 대한 성능은 대체로 좋아지지만 human preference에 알맞는 답변을 하는 것은 아니다. 특히, language generation의 경우에 거짓 정보나 toxic text 등 예상하지 못하는 반응을 보이는 경향이 있다. 이런 현상의 이유는 Large Language model의 pretraining 목표 (Next token prediction)와 user’s need ( 지시 사항을 따르는 것)이 다르기 때문이다.
Method
Language model이 user의 지시 사항을 잘 따르도록 하는 것을 user의 need와 language model을 align하는 과정이라고 표현한다. 논문에서 User와 language model이 잘 align 되었다는 것은 user의 need을 잘 따르는 것 뿐만 아니라 toxic한 답변이나 hallucination을 생성하지 않고 도움이 되며 솔직한 모델이라는 것이라고 정의한다. 본 논문은 Language model의 alignment를 하기 위해 Reinforcement Learning from Human Feedback (RLHF)으로 finetuning을 한다. 다음 순서로 finetuning이 진행된다.
1) Collect demonstration data and train a supervised policy
임의의 Input prompt에 대해 선호되는 답변의 demonstration data를 통해 pretrained GPT-3 모델을 supervised learning을 통해 finetune 시키는 단계이다.
Input prompt 데이터는 OpenAI API의 Playgorund에 제출된 실제 user들의 prompt와 labeler들이 직접 생각해낸 instruction-like prompt들로 구성된다. Labeler들이 직접 작성한 prompt들은 Plain, Few-shot, User-based의 종류를 갖는다. Plain은 임의의 작업을 지시하는 prompt, few-shot은 지시문과 그에 따른 질의/응답 쌍을 포함한 prompt, 그리고 user-based는 실제 user들의 prompt을 기반으로 작성한 prompt이다. 이 dataset들로 세 가지의 dataset을 만든다. 우선 SFT dataset은 prompt와 labeler들의 정답 답안이 든 dataset이다. RM dataset은 prompt에 대한 model의 output의 순위 dataset이다. 마지막으로 PPO dataset은 prompt만 든 dataset이다.
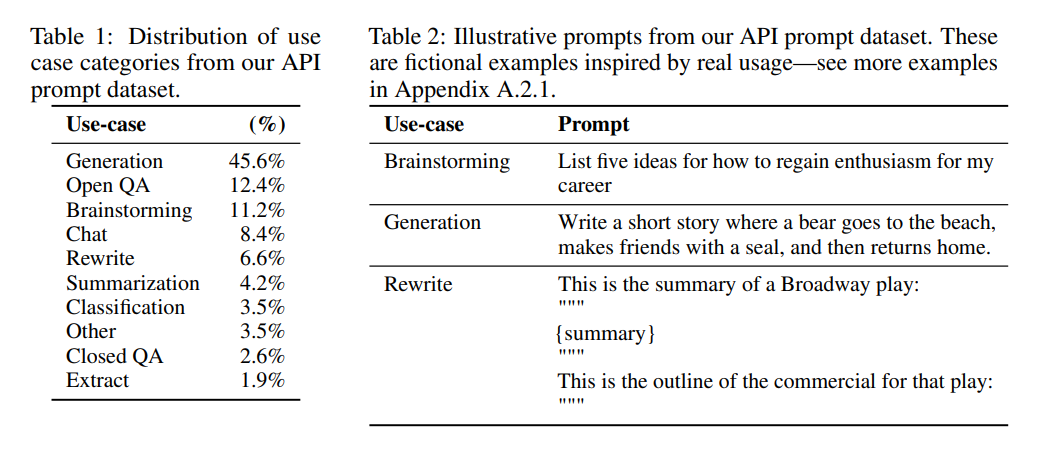
이렇게 만든 SFT dataset으로 GPT-3에게 supervised하게 finetuning을 시킨다. 이렇게 학습된 모델은 Instruction이 주어졌을 때, 어느정도 대답을 할 수 있는 SFT model이 된다.
2) Collect comparison data and train a reward model
SFT model로 모델로 각 prompt에 대해 여러 output들을 얻어 labeler들에게 선호 정도를 기준으로 순위를 매기도록 하여 RM dataset (comparison data)을 만들었다. Comparison data를 더 빨리 얻기 위해 labeler들에게 k=4~k=9 개의 답변에 순위를 매기도록 하였다. 따라서 하나의 prompt에 대해서 $_kC_2$개의 comparison data가 생기는 것이다. 하지만 이 comparison data들이 서로 관련되어있기 때문에 하나의 dataset 안에 shuffle을 해버리면, data point들이 독립적이지 않게 되어 overfitting이 발생한다. 따라서, 하나의 prompt에 대해서 $_kC_2$개의 comparison data를 하나의 batch로 만들었다.
Reward 모델은 이 순위를 학습하여 어떤 답안이 더 human preference가 높을 지를 예측할 수 있도록 finetuning되었다. 이때, Reward 모델으로는 SFT model의 final unembedding layer만 제거하고 scalar reward를 출력할 수 있도록 변형한 모델을 사용하였다. 크기를 키울 수는 있지만 강화학습의 특성 상 학습 과정이 불안정할 것이라고 생각하여 6B의 크기로 하였다.
Reward 모델 loss function은 다음과 같다.
\[loss(\theta) = - \frac {1} {_kC_2} \mathbb{E_{(x, y_w, y_l) \sim D}} \left [ log(\sigma(r_{\theta} (x,y_w) - r_{\theta} (x,y_l))) \right ]\]이때 $r_{\theta}(x,y)$는 prompt x와 답안 y에 대한 scalar output이다. $D$는 human comparison dataset이고 $y_w$은 선호되는 답안이고 $y_l$은 선호되지 않는 답안이다. (ranking이 더 높은 답안이 $y_w$) Cross entropy loss을 통해 선호 답변에 준 reward와 비선호 답변에 준 reward 간의 차이를 극대화하는 방향으로 학습을 한다.
Reward Model의 loss function의 유도 과정은 다음과 같다. Bradley Terry Model (BT)는 paired comparison이 있을 때, 누가 더 우위에 있는지를 확률적으로 예측하는 모델이다. 이 모델을 통해 reward 모델이 preference가 높은 답안에 더 높은 점수를 주는지 평가할 수 있다. 답변 $y_w$와 $y_l$이 있을 때, 두 점수 차이가 클수록 $y_w$가 $y_l$보다 더 좋다고 평가받을 확률이 높다고 판단한다.
\[p^{*}(y_w > y_l \mid x) = \frac {exp(r^{*}(x,y_w))} {exp(r^{*}(x,y_w)) + exp(r^{*}(x,y_l))}\]
이 식을 정리하면 sigmoid 함수 ($sigma(x) = \frac {1} {1 + exp^{-x}}$)의 형태가 된다.
\[\frac {exp(r^{*}(x,y_w))} {exp(r^{*}(x,y_w)) + exp(r^{*}(x,y_l))} = \frac {1} {1+exp(r^{*}(x,y_l) - r^{*}(x,y_w))} = \sigma (r^{*}(x,y_w) - r^{*}(x,y_l)))\]
이 식을 negative log likelihood를 적용하여 reward function의 loss function으로 만든 것이다.
3) Optimize a policy against the reward model using PPO Reward model의 output을 scalar reward으로 사용하여 SFT policy를 PPO로 finetune한다. Input prompt가 주어질 때, policy $\phi$는 답변을 생성하고 reward model이 prompt와 답변을 모두 고려하여 reward를 계산하고 episode가 종료된다.
\[\text{Objective}(\phi) = \underbrace{\mathbb{E}_{(x,y) \sim D_{\pi_{\phi}^{\text{RL}}}} \left[ r_\theta(x, y) - \beta \log \left( \frac{\pi_{\phi}^{\text{RL}}(y|x)}{\pi^{\text{SFT}}(y|x)} \right) \right]}_{\text{PPO (RL part)}} + \underbrace{\gamma \mathbb{E}_{x \sim D_{\text{pretrain}}} [\log(\pi_{\phi}^{\text{RL}}(x))]}_{\text{ppo-ptx (Pretraining part)}}\]여기서 PPO-PTX 부분은 PPO로만 학습을 했을 때, 말은 잘 듣지만 전체적인 NLP task 성능이 떨어졌기 때문이다. 본 논문은 PPO로만 학습을 할 경우, 말을 잘 듣는 것에 집중하기 때문에 NLP task 성능은 저하된 것이라고 판단하였다. 이 문제를 해결하기 위해 objective에 Pretraining 분포 data에 대한 log likelihood 항(pretraining을 할 때처럼 next token prediction의 log likelihood)을 더해서 말을 잘 듣는 것에만 집중하지 말고 NLP task 성능 향상에도 신경을 쓰도록 하였다. Next token prediction을 잘한다는 것은 NLP task 성능이 좋다는 것을 전제로 두는 것 같다.
$\pi_{\phi}^{RL}$은 학습된 RL policy, $\pi^{SFT}$는 supervised trained model, $D_{pretrain}$은 pretraining 분포이다. 상수값 $\beta$와 $\gamma$는 KL penalty와 pretraining gradients의 강도를 결정한다.
Evaluation
Alignment의 정의를 기반으로 Language model이 잘 align이 되었는지를 판단하기 위해서는 고려해야 하는 것들이 존재한다.
- 우선 대부분의 data가 실제 user의 preference가 아니라 labeler들 자체의 preference이기 때문에 실제 user의 선호도와는 차이가 존재할 수 있다.
- 모델이 솔직한 지 알기 위해서는 모델의 지식과 모델의 답변을 비교해야 하는데 모델의 지식은 black box이므로 내부를 볼 수 없다. 따라서 Closed domain task에서 Language model이 내용을 지어내는 지를 관찰하여 honesty (솔직함) 대신 truthfulness (정직함)을 측정하기로 하였다.
- Harmful한지 판단하기 위해서는 성적인 말, 잔인한 말, 차별적인 말을 하는지를 기준으로 판단하였다.
Result
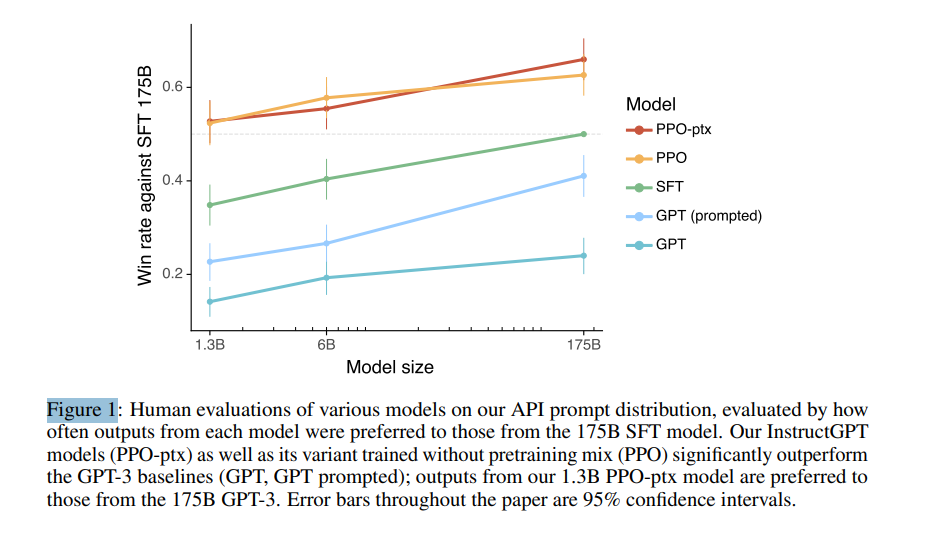
OpenAI API의 Playgorund의 prompt에 대해서 175B InstructGPT의 답변은 GPT-3의 답변보다 85 ± 3% 만큼 더 선호되고, few-shot GPT-3보다는 71 ± 4% 만큼 더 자주 선호된다.
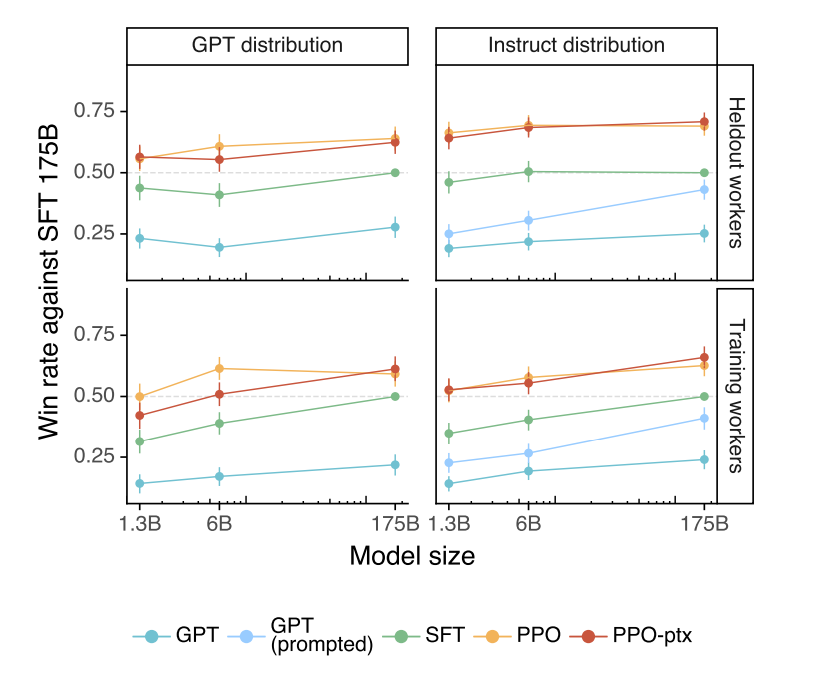
PPO-ptx가 큰 모델에서는 성능이 조금 저하되긴 하지만 OpenAI API의 Playgorund의 prompt 분포와 labeler들이 직접 만든 prompt 분포에서 동일한 양상을 보인다.
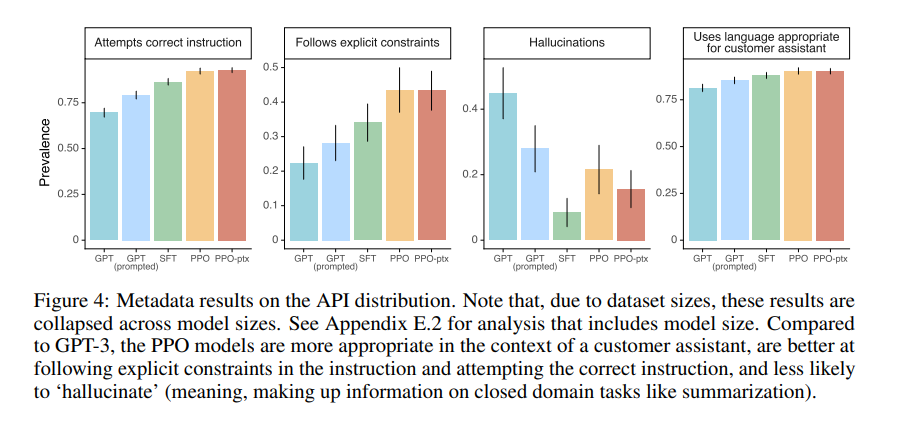
RLHF를 적용한 모델이 기존 모델들보다 대체로 customer assistant에 적합하고 user가 제시한 제한 사항들을 더 잘 따르는 경향이 크다. 그리고 closed domain task에서 halluciante하는 빈도 또한 작다. 이 결과를 통해 RLHF를 적용함으로써 더 믿음직하고 control하기 쉽다는 것을 알 수 있다.
SFT 모델에서 hallucination 빈도가 압도적으로 작은 것은 아마도 supervised learning만 하기 때문에 world 지식과 모델의 지식 일치율이 RLHF를 적용한 모델보다 더 높기 때문이라고 생각한다…
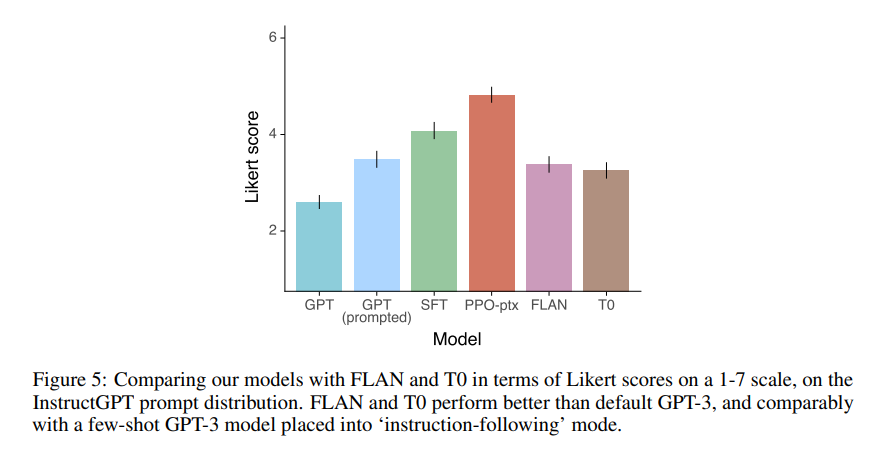
T0과 FLAN은 GPT-3보다는 더 선호되지만 user의 요구를 잘 따르라고 prompt된 GPT와 비슷하게 선호되지만 labeler가 생성한 data에 대해 SFT한 모델과는 선호도 차이가 크고 InstructGPT와 비교했을 때는 더 크다. 이런 결과가 나온 이유는 두 가지로 분석된다. 첫 번째로 public NLP datasets는 automatic metrics로 평가가 쉬운 task들로만 구성되어있다. 하지만 실제 user’s needs는 brain storming이나 open ended generation처럼 다양한 task들로 구성되어있기 때문에 SFT baseline이나 InstructGPT의 선호도가 더 높은 것이다. 두 번째로 public NLP datasets는 아무래도 input의 다양성이 제한되기 때문에 실제 user’s needs를 학습하기에는 적합하지 않은 dataset이다.
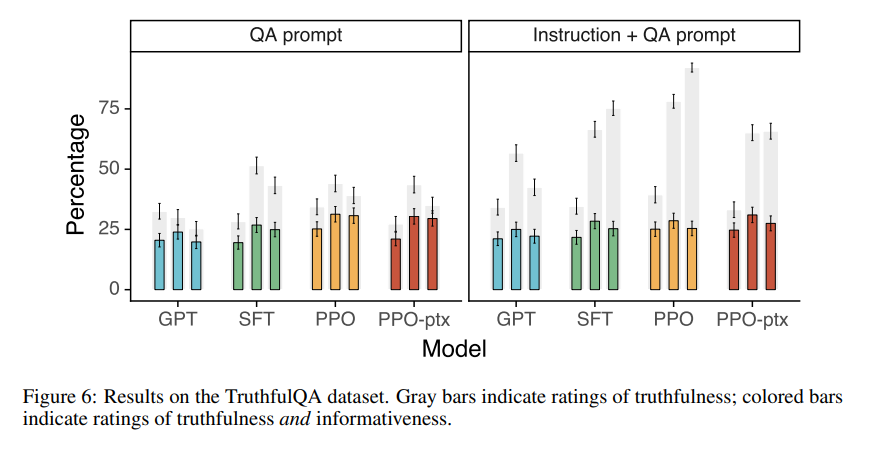
RLHF를 적용한 모델들은 GPT-3보다 더 도움이 되면서 정직하다는 것을 알 수 있다. 또, prompt를 “정답을 알지 못하면 모른다고 얘기해”라는 instruction과 QA prompt로 구성하였을 때, RLHF를 적용한 모델들은 모르면 모른다고 얘기하는 비율이 압도적으로 높다는 것을 통해 본 논문의 방법론이 모델을 더 정직하게 만든다는 것을 알 수 있다.
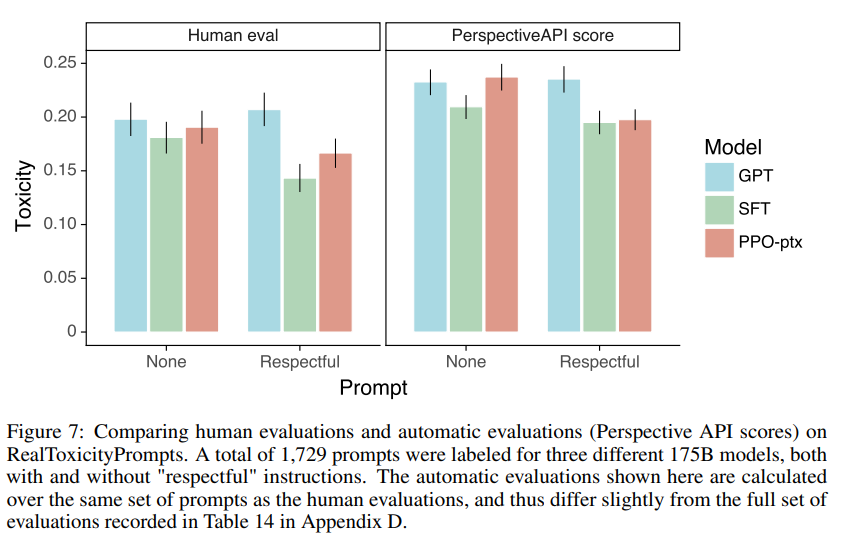
이 결과는 “respectful” prompt를 통해 각 모델들에게 non-toxic한 output만 생성하도록 지시 사항을 주었을 때, 모델들의 toxicity를 측정한 것이다. RLHF를 적용한 모델들은 지시 사항을 더 잘 따름으로써 GPT-3보다 덜 toxic한 output을 생성함을 알 수 있다.
이 결과는 ptx 항이 없는 PPO를 적용했을 때 생기는 NLP task에 대한 성능 저하를 보여준다. 또, ptx 항을 추가한 PPO-ptx의 NLP task 성능이 PPO보다 큰 것을 통해 performace regression 효과를 막기 위해 제안된 ptx 항의 역할을 보여준다.
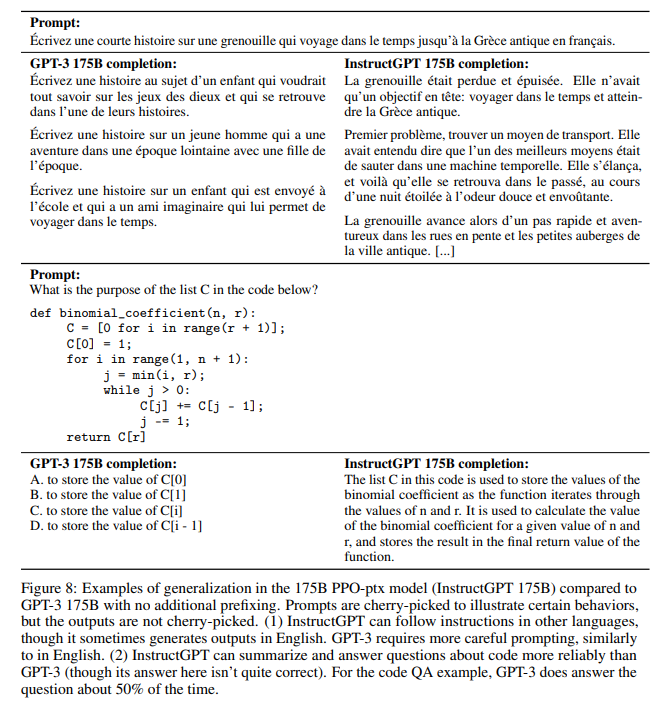
InstructGPT는 RLHF finetuning 분포 밖의 prompt에 대해서도 잘 대답한다는 것을 통해 generalization 능력이 뛰어남을 알 수 있다. 위 예시들은 다른 언어나 코딩 prompt는 다른 prompt들보다 훨씬 적었음에도 불구하고 InstructGPT가 GPT-3보다 대답을 잘하는 것을 보여준다.
Limitations
- 인간이 직접 점수를 매겨서 dataset을 얻는 방법이기 때문에 비용이 높다.
- 인간이 직접 점수를 매기기 때문에 labeler들을 검증하는 단계를 거치긴 하지만 아무래도 그들이 살아온 배경에 따라 preference가 실제 user와 다를 수 있다.
- Instruction을 너무 잘 따라서 toxic한 output을 생성해달라고 하면 toxic한 output을 진짜 생성한다.