Proximal Policy Optimization Algorithms 리뷰
Background
Neural networks으로 강화학습을 하는 방법으로는 Q-learning과 Vanilla Policy Gradient가 있다.
Q-Learning
Q-learning은 현재 state s에서 action a를 하면 미래에 총 얼마의 보상을 받을까를 예측하는 함수 Q(s,a)를 학습하는 방법이다. 예측값을 $Y_t$라고 할 때, Q(s,a)가 $Y_t$를 계산하는 방법은 다음과 같다.
\[Y_t = r_t + \gamma \cdot max_{a'} Q_{\theta}(s_{t+1}, a')\]이때, $r_t$는 action $a_t$를 함으로써 얻는 즉각적인 보상이고 $Q_{\theta}(s_{t+1}, a’)$는 다음 상태부터 받을 것이라고 예측되는 미래 보상값이다.
$Q_{\theta}$ 는 $Y_t$ 값이 $a_t$를 함으로써 얻는 실제 보상이라고 간주한 뒤, 예측값 $Q_{\theta}(s_t, a_t)$가 $Y_t$와 같아지도록 오차를 줄이는 방법으로 update된다.
문제점
- Q-Learning은 $Y_t$를 계산하는 과정에서 bias 문제가 생긴다. $Q_{\theta}$ 의 예측값을 통해 계산한 $Y_t$를 상황 t에서 실제로 받을 수 있는 보상으로 여긴다. 이때 $Q_{\theta}$ 의 성능이 좋지 않다면, $Q_{\theta}$ 는 잘못된 답 $Y_t$와 비슷해지도록 학습되는 것이기 때문에 불확실성 문제가 생긴다.
Vanilla Policy Gradient
Vanilla Policy Gradient는 다음 objective을 최대화하는 $\theta$를 구하는 방법으로 학습이 진행된다.
\[J(\theta) = \mathbb{E} \left[log \pi_{\theta} (a_t \mid s_t) \cdot \hat A_t \right]\]$log \pi_{\theta} (a_t \mid s_t)$은 $s_t$에서 action $a_t$를 할 확률, $\hat A_t$는 action $a_t$가 평균적으로 얼만큼의 이득을 불러오는지를 의미한다. 이 값의 미분값으로 $\theta$를 update한다.
\[\theta_{new} = \theta_{old} + \alpha \cdot \nabla_{\theta} J(\theta)\]문제점
-
$\pi_{\theta} (a_t \mid s_t)$ 가 잘못된 행동 $a_t$가 좋다고 여기고 $\theta$ 를 update한다면, $\theta$가 급격하게 변해서 성능이 저하될 가능성이 높다. 또, on-policy 방법이기 때문에 현재 policy가 각 상태에 대해 고른 행동들이 곧 학습 데이터가 되기 때문에 이미 policy가 성능이 저하가 된 상태라면 잘못된 학습을 반복하게 된다.
-
Gradient의 크기가 Reward 크기에 의존적이라 어떤 상황에 대해서 Reward가 큰 행동을 했다면, 그 방향으로 policy가 크게 update되어서 robust하지 않게 된다.
Trust Region Policy Optmization (TRPO)
TRPO는 위에 있는 두 방법의 문제점들을 해결하였다. 우선 TRPO는 Vanilla Policy Gradient(VPG) 방법의 data 효율성 문제를 해결하기 위해 Vanilla 방법의 objective를 대체하는 surrogate objective를 사용한다. VPG는 현재 policy로 환경과 상호작용하여 data를 모든 다음, 그 data로 현재 policy를 update한다. 하지만 update가 된 후에는 이전에 모은 data를 학습에 사용할 수 없게 되어 data 효율성이 떨어진다. 이 문제를 개선하기 위해 Importance Sampling 방법을 활용하였다.
Importance Sampling
대부분의 강화학습 objective는 policy를 통해 얻는 기대 보상값을 최대화하는 목적을 지니고 있다.
기댓값 $\mathbb{E_{x \sim p} \left[ R(x) \right]}$을 계산하기 위해서는 기댓값의 정의에 따라 p(x)가 함수 R(x)의 확률 분포라고 할 때, 다음 식을 계산해야 한다.
\[\mathbb{E_{x \sim p} \left[ R(x) \right]} = \int p(x) R(x) dx\]그렇다면 왜 Vanilla Policy Gradient의 objective는 $J(\theta) = \mathbb{E} \left[log \pi_{\theta} (a_t \mid s_t) \cdot \hat A_t \right]$ 인지 궁금해서 조사하였다. 그 이유는 다음과 같다.
\[J(\theta) = \mathbb{E}_{x \sim \pi_{\theta}} \left[ R(x) \right] = \int \pi_{\theta}(x)R(x)dx\]
\[\nabla_{\theta} J(\theta) = \nabla_{\theta} \int \pi_{\theta}(x)R(x)dx\]
\[= \int \nabla_{\theta} \pi_{\theta}(x)R(x)dx\]
\[= \int \pi_{\theta}(x) \frac{\nabla_{\theta} \pi_{\theta}(x)}{\pi_{\theta}(x)} R(x) dx\]
\[= \int \pi_{\theta}(x) \underbrace{\nabla_{\theta} \log \pi_{\theta}(x)}_{\text{로그 미분법}} R(x) dx\]
\[= \mathbb{E}_{x \sim \pi_{\theta}} \left[ \nabla_{\theta} \log \pi_{\theta}(x) R(x) \right]\]
이 Derivative가 바로 나오도록 하기 위해 $J(\theta)$를 다음과 같이 적은 것이다.
\[J(\theta) = \mathbb{E}_{x \sim \pi_{\theta}} \left[log \pi_{\theta}(a_t \mid s_t) \cdot R(x) \right]\]
기댓값을 정확하게 구하기 위해서는 전체 확률 분포를 알아야 한다. 하지만 전체 확률 분포를 아는 것은 모든 상황에 대한 충분한 데이터가 필요하기 때문에 어렵다. 따라서, 일반적으로 확률 분포로부터 일부 sampling하여 그 data들로 기댓값의 근사값을 계산한다.
\[\mathbb{E} \left[ R(x) \right] = \int p(x) R(x) dx \simeq \frac {\sum_{i=1}^{N} R(x^{(i)})} {N}\]이때, Vanilla Policy Gradient에서 매 학습 step마다 $\pi_{\theta}$가 환경과 상호작용하여 data(action)를 sample해야 한다는 점 때문에 Data 비효율성 문제를 지니고 있다. 하지만 Importance Sampling을 사용하면 이 문제를 해결할 수 있다.
Importance Sampling이란 특정 확률 분포를 바탕으로 기댓값을 구하는 과정이 비효율적이거나 어려울 때, 다른 확률 분포에서 추출한 sample로 구하고자 한 기댓값의 근사값을 구할 수 있도록 하는 방법이다.
\[\mathbb{E} \left[ R(x) \right] = \int p(x) R(x) dx \simeq \int \frac {p(x)} {q(x)} \cdot q(x) \cdot R(x) dx = \int q(x) \cdot (\frac {p(x)} {q(x)} \cdot R(x)) dx\] \[= \mathbb{E}_{x \sim q} \left[ \frac {p(x)} {q(x)} R(x) \right] \simeq \frac{1} {N} \sum_{i=1}^{N} \frac { p(x) R(x^{(i)})} {q(x)}\]어떤 확률 분포 q(x)로 sample하는지에 따라 기댓값 근사값의 variance가 정해진다는 것을 눈치챌 수 있다. q(x)가 p(x)의 성질을 capture하지 못하는 확률 분포라면 p(x)와 성격이 다른 sampling을 할 가능성이 높아져 기댓값의 variance가 커진다. 따라서, q(x)를 정할 때는 p(x)의 성질을 최대한 잘 capture 해야 한다.

Importance sampling은 importance weight 값 $\frac {p(x)} {q(x)}$ 으로 sampling 할 때, p(x)의 성격을 최대한 반영한다. 임의의 sample s가 p(x)에서는 빈도가 낮고 q(x)에서만 빈도가 높은 경우, weight가 작아져서 기댓값에 큰 영향을 주지 않는다고 생각하면 된다.
결과적으로 Vanilla Policy Gradient에 Importance sampling을 적용하면 Vanilla Policy Gradient가 겪는 data 비효율성 문제가 해결된다. 학습을 할 때마다 현재 policy $\pi_{\theta}$ (p(x)) 로 상호작용하지 않아도 되고 이전 step의 policy $\pi_{\theta_{old}}$ (q(x)) 에서 sample 했던 data를 사용하여 기댓값을 계산하면 되는 것이다.
-
Vanilla Policy Gradient 식
\(J(\theta) = \mathbb{E_{s \sim p_{\pi_{\theta_{old}}}, a \sim \pi_{\theta}}} \left[ A_{\pi_{\theta}} (s,a) \right]\) -
Importance Sampling 적용
KL Penalty 적용
Vanilla Policy Gradient는 앞서 말했 듯이 objective의 gradient 크기가 보상의 크기에 너무 의존하기 때문에 policy가 너무 크게 update되어 불안정하다. TRPO 논문에서는 이를 막기 위해 현재 policy와 이전 policy가 달라진 정도만큼 objective에 penalty를 주어 기대 보상값을 최대화하되 너무 크게 update되는 것을 막았다.
\[max_{\theta} \mathbb{ \hat E_t} \left[ \frac {\pi_{\theta} (a \mid s)} {\pi_{\theta_{old}} (a \mid s)} \cdot A_{\pi_{\theta}} (s,a) - \beta \cdot \text{KL} \left[ \pi_{\theta_{old}} (\cdot \mid s_t), \pi_{\theta} (\cdot \mid s_t) \right] \right]\]KL은 KL divergence으로 두 확률 분포가 차이가 날수록 값이 커진다.
하지만 실제 사용하는 objective는 이와 달랐다. 이 objective의 문제점은 적절한 상수 $\beta$를 설정하는 것이다. 이 값을 KL penalty coefficient 라고 부른다. 문제 종류마다 다른 $\beta$ 를 골라야 하고 동일한 학습 과정 내에서도 상황에 따라 $\beta$ 값을 다르게 해야 하기 때문에 이 objective을 변형하였다.
\[\text{max}_{\theta} \,\,\,\mathbb{ \hat E_t} \left[ \frac {\pi_{\theta} (a \mid s)} {\pi_{\theta_{old}} (a \mid s)} \cdot A_{\pi_{\theta}} (s,a) \right] \text{subject to } \text{KL} \left[ \pi_{\theta_{old}} (\cdot \mid s_t), \pi_{\theta} (\cdot \mid s_t) \right] \le \delta\]TRPO의 성질은 학습이 진행될수록 policy의 성능이 단조적으로 (monotonic) 향상된다는 것이다. Objective을 보면 알 수 있듯이 TRPO는 policy 성능의 lower bound를 최적화하여 policy의 성능을 보장하였다.
TRPO의 단점은 objective을 최적화하는데 계산 복잡도가 높다는 것이다. Constraint 문제는 quadratic conjugate를 활용하여 근사값을 계산할 수 있는데 이를 적용하면 second order objective가 되어 quadratic computation을 해야 한다. 아니면 Fisher Information Matrix (FIM) 라는 거대한 행렬(Hessian의 근사치)의 역행렬을 계산해야 한다.
Proximal Policy Optimization (PPO)
본 논문은 TRPO처럼 policy의 성능을 단조적 향상시키면서 계산 복잡도가 낮은 first order algorithm을 만들고자 하였다.
Clipped Surrogate Objective
$r_t(\theta)$를 확률 비 $\frac {\pi_{\theta}(a_t \mid s_t)} {\pi_{old} (a_t \mid s_t)}$라고 할 때 TRPO가 maximize하는 surrogate objective는 다음과 같다.
\[L^{CPI}(\theta) = \mathbb{\hat E}_t \left [ \frac {\pi_{\theta}(a_t \mid s_t)} {\pi_{old} (a_t \mid s_t)} \hat A_t \right]\]Constraint가 없다면, $L^{CPI}$를 최대화하는 것은 policy의 과도한 update가 된다. 따라서 PPO는 $r_t(\theta)$ 값의 변화에 따라 policy 변화에 penalty를 주었다. PPO가 제시한 objective은 다음과 같다.
\[L^{CLIP}(\theta) = \mathbb{\hat E}_t \left[ min(r_t(\theta) \hat A_t , clip(r_t(\theta), 1 - \epsilon, 1 + \epsilon) \hat A_t)\right]\]이때 $\epsilon$은 hyperparameter이다. min의 첫 번째 항은 $L^{CPI}$이다. 두 번째 항은 확률 비 $r_t(\theta)$를 clipping함으로써 구간 $\left[ 1 - \epsilon, 1 + \epsilon \right]$을 벗어나지 못하게 한다. 따라서 최종 objective는 TRPO objective처럼 $L^{CPI}$의 lower bound의 최적화라고 볼 수 있다.
왼쪽 그림을 보면 Advantage 값이 양수일 때 $r_t(\theta)$가 커져야 objective가 최대화된다. 하지만 너무 과도하게 커져 1+$\epsilon$보다 커지려고 한다면 이를 막아서 과도한 update를 막았다. 반대로 오른쪽 그림에서 advantage 값이 음수일 때, $r_t(\theta)$가 감소해야 objective가 최대화되는데 1-$\epsilon$보다 작아지려고 한다면 이를 막아서 과도한 update를 막는다. 즉, 이 방법을 통해 advantage를 너무 증가시키는 update가 진행될 거 같을 때는 clipping을 통해 미분값을 0으로 만들어 update를 막는다.
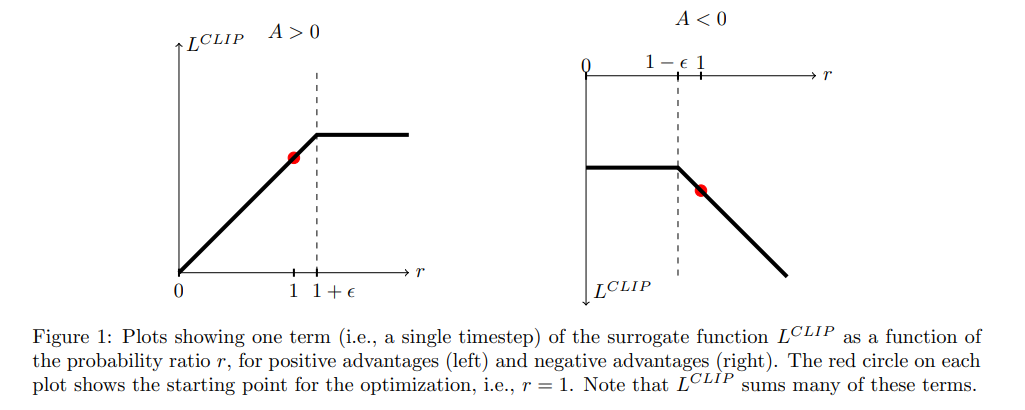
또, $\theta_{old}$ 근처에서는 first order로 $L^{CLIP}(\theta)$ = $L^{CPI}(\theta)$이고 $\theta_{old}$을 벗어날수록 달라진다는 것을 볼 수 있다.
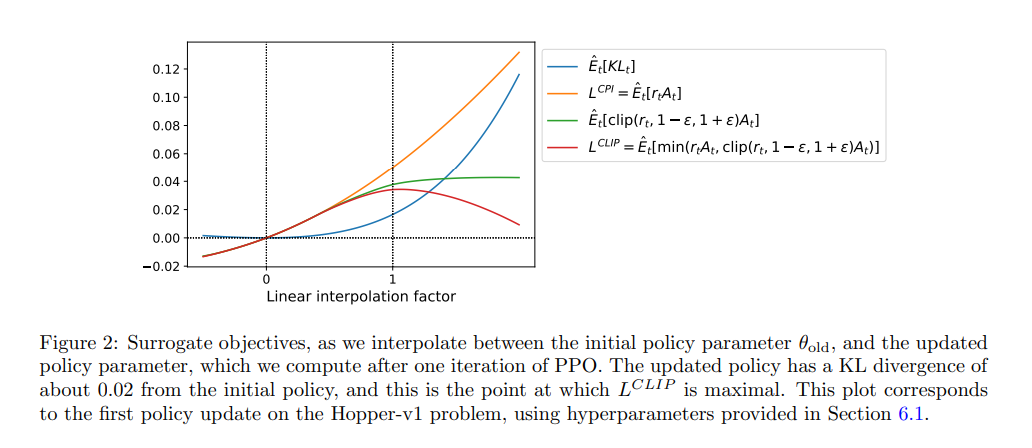
이 그래프는 각 objective으로 policy를 update 했을 때, 얼마나 변하는지를 시각화한 것이다. Linear interpolation factor는 $\theta_{old}$에서 변한 정도이고 y축은 objective의 값이다.
- Constraint가 없는 $L^{CPI}$는 update가 되면 될수록 objective 값이 커진다. 이는 constraint가 없을 때 생기는 update 방법의 문제점을 보여준다.
- $KL$의 값은 policy가 변할수록 exponential하게 증가하는 것을 보여준다.
- $L^{CLIP}$은 linear interpolation factor가 1일 때 최대이면서 극대값을 가지고, $\theta$가 과도하게 변해 linear interpolation 값이 1을 넘을 때는 오히려 objective 값이 감소함을 보여준다.
즉, policy gradient optimization을 수행할 때, $L^{CLIP}$을 사용하면 안정적으로 수렴하게 되면서 KL divergence 값을 objective에 직접 포함하지 않았음에도 $r_t(\theta)$값에 따라 policy의 과도한 변화를 막는다는 것을 알 수 있다.
Adaptive KL Penalty Coefficient
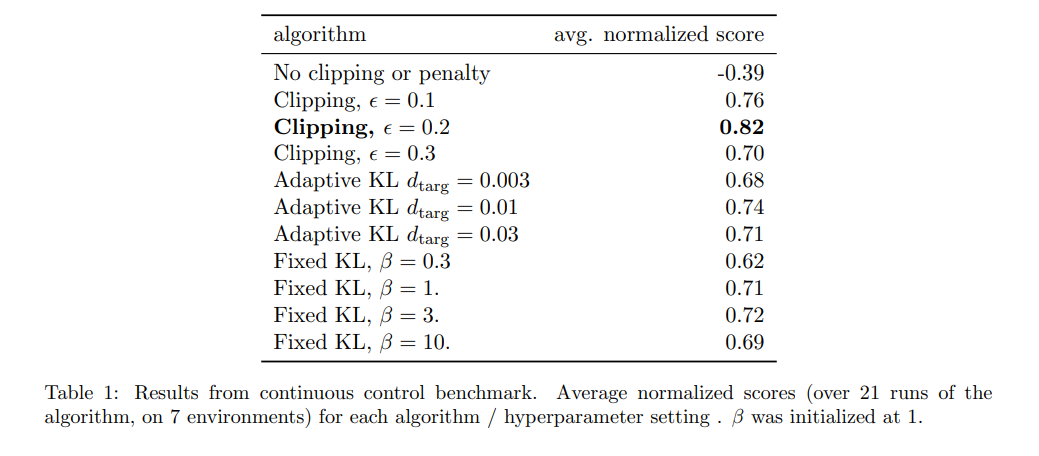
PPO 논문에서는 TRPO에서 제시한 penalty on KL divergence를 사용한 objective을 보완한 objective도 제시한다. Clipped objective보다 성능이 좋지 않지만 baseline의 역할을 하기 때문에 소개한다.
\[L^{KLPEN}(\theta) = \mathbb{\hat E_t} \left[ \frac {\pi_{\theta}(a_t \mid s_t)} {\pi_{old} (a_t \mid s_t)} \hat A_t - \beta \cdot \text{KL} \left[ \pi_{\theta_{old}} (\cdot \mid s_t), \pi_{\theta} (\cdot \mid s_t) \right] \right]\]본 논문에서 $\beta$의 값을 KL divergence 값 $\text{KL} \left[ \pi_{\theta_{old}} (\cdot \mid s_t), \pi_{\theta} (\cdot \mid s_t) \right]$에 따라 달라지도록 설정하였다.
- Compute $d = \mathbb{\hat E_t} \left[ \text{KL} \left[ \pi_{\theta_{old}} (\cdot \mid s_t), \pi_{\theta} (\cdot \mid s_t) \right] \right]$
- If $d < d_{\text{targ}} / 1.5$, $\beta \leftarrow \beta / 2$
- If $d > d_{\text{targ}} \times 1.5$, $\beta \leftarrow \beta \times 2$
달라진 $\beta$값은 다음 update에 적용되어 이전 step에서 너무 많은 update가 진행되었을 때 ($d > d_{\text{targ}} \times 1.5$), penalty coefficient 값을 키워서 다음 update에는 조금만 변하도록 하고 이전 step에서 너무 적은 update를 하여 변화가 미미했을 때 ($d < d_{\text{targ}} / 1.5$)에는 penalty coefficient 값을 줄여 다음 update에는 크게 변하도록 하였다.
Algorithm
Advantage를 계산할 때는 GAE를 이용한다. 만약 Policy와 value function의 parameter를 공유한다면 loss function이 policy와 value function의 error를 최종 objective에 결합해야 한다.
\[L^{CLIP + VF + S}_t (\theta) = \mathbb{\hat E_t} \left[ L^{CLIP}_t (\theta) - c_1 L^{VF}_t(\theta) + c_2 S[\pi_{\theta}](s_t) \right]\]이때, $c_1, c_2$는 상수이고 S는 entropy bonus로 $s_t$에서 다양한 시도를 할 수 있게 해주는 항이다. $L_t^{VF}(\theta)$은 $(V_{theta}(s_t) - V^{targ}_t)^2$으로 실제 value 값과 value function이 예측한 값의 squared-error loss이다.
Policy gradient implementation을 위해서 보통 policy를 T timestep동안 실행하여 samples를 얻어서 update을 한다. 이 방법은 timestep T 이후를 고려하지 않는 advantage estimator가 필요하다. 기존에 사용하는 advantage estimator는 다음과 같다.
\[\hat A_t = -V(s_t) + r_t + \gamma r_{t+1} + ... + \gamma^{T-t+1}r_{T-1} + \gamma^{T-t}V(s_T)\]$V(s_t)$는 timestep t부터 얻을 수 있는 보상의 기댓값, $r_t + \gamma r_{t+1} + … + \gamma^{T-t+1}r_{T-1}$은 T timestep동안 policy를 실행하여 실제로 받은 보상, $\gamma^{T-t}V(s_T)$은 timestep T부터 얻을 수 있는 보상의 기댓값이다. 하지만 이 advantage estimator를 사용하면 timestep T 동안의 모든 실제 reward를 구해야 하므로 trajectory가 끝날 때까지 policy를 update할 수 없다. 따라서 variance가 큰 estimator이다.
이 문제를 해결하기 위해 Temporal difference $\delta_t = r_t + \gamma V(s_{t+1}) -V(s_t)$ 을 사용한다. 즉각적 reward $r_t$ 와 그 이후 state $s_{t+1}$부터의 보상의 기댓값만 계산하면 되기에 피드백을 매 timestep마다 할 수 있어진다. 하지만 전체 step들을 보지 못하고 오직 최근 값에 대해서만 계산이 되기에 bias가 큰 estimator가 된다.
따라서, 이 두 방법들의 가중평균을 사용한 GAE의 truncated version (bias와 variance가 다 낮음)을 PPO에 활용한다. 미래의 값일수록 value function의 값이 불확실하므로 더 낮은 가중치를 주어 variance을 낮추었다.
\[\hat A_t = \delta_t + (\gamma \lambda) \delta_{t+1} + ... + (\gamma \lambda)^{T-t+1} \delta_{T-1}\]PPO의 학습 알고리즘은 다음과 같다.
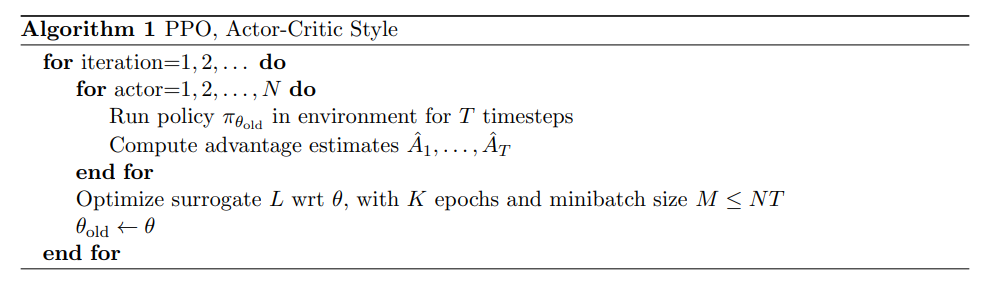
PPO는 N개의 policy로 parallel하게 T timestep 동안 data를 얻어 총 NT timestep data로 surrogate loss를 계산한다. 이 loss를 바탕으로 policy를 on-policy 방법으로 update한다.
Result
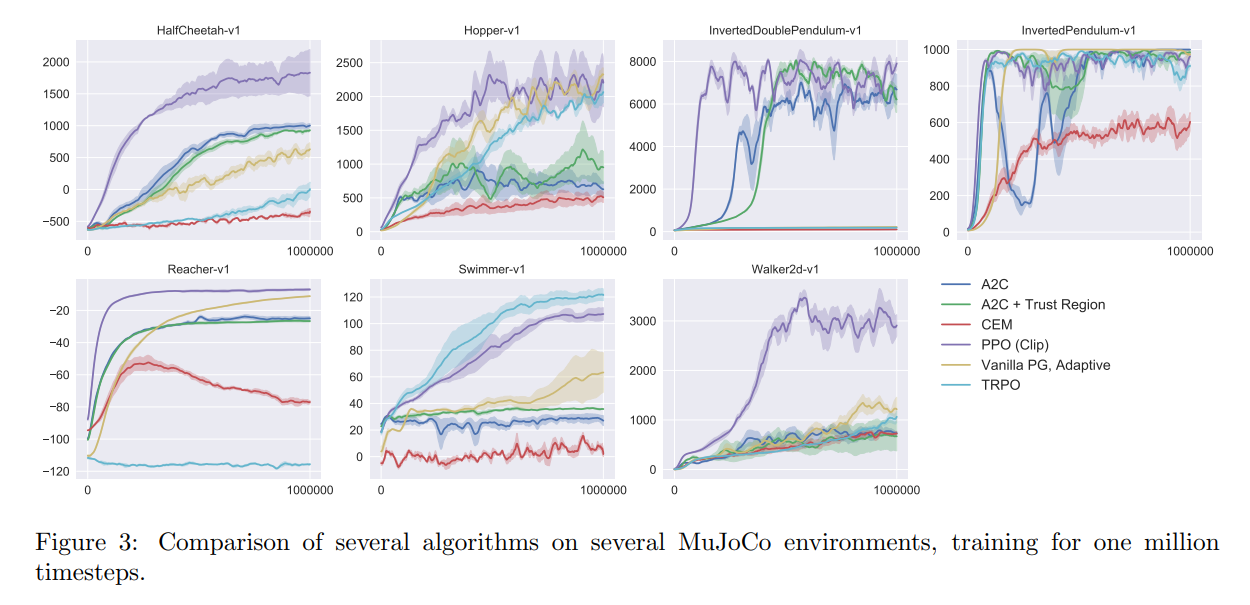
PPO가 대체로 성능이 좋음.