From Sparse to Dense GPT4 Summarization with Chain of Density Prompting 리뷰
Background
Automatic summarization은 SFT로 요약에 특화된 모델을 만드는 패러다임에서 LLM을 prompting하는 패러다임으로 변화하였다. Prompting 방법은 추가적인 학습 과정을 필요로 하지 않고 prompt에 요약의 길이, 성격 등을 명시하는 방법이다. 이때, Prompt 구성 방법에 따라 요약문의 성격이 달라지기 때문에 어떻게 prompt를 구성해야 좋은 요약문을 생성하는 지 알아내는 것이 중요하다.
본 논문은 요약문을 평가할 때 정보의 밀도 (information density)가 중요한 평가 기준이라고 주장한다. 또, 정보 밀도가 높기만 하지 않고 readability가 적당한 요약문이 좋은 요약문이라고 주장한다. 본 논문이 design한 prompt에 따르면, abstraction, compression, fusion의 combination을 거쳐야 좋은 요약이 나온다고 한다.
이때, 본 논문은 정보 밀도를 요약문에 들어있는 entity의 밀집도로 본다.
본 논문의 prompt의 효과를 직관적으로 보여주는 결과는 다음과 같다.
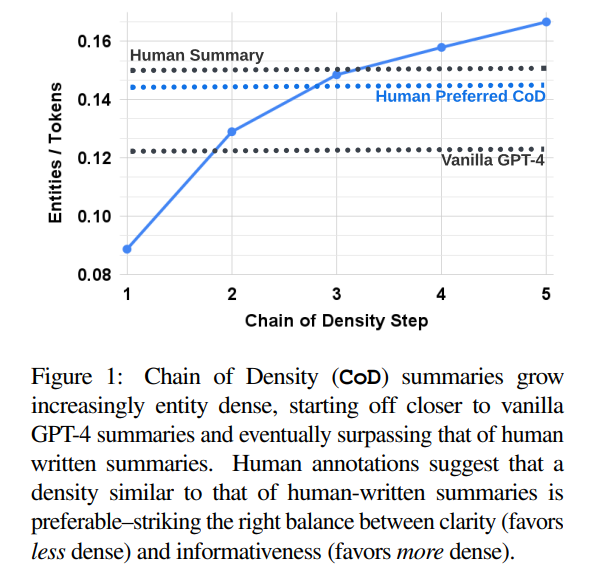
Chain of Density Prompting
Prompt
얼만큼의 정보 밀도가 좋은지 알아내기 위해 GPT-4가 각 text에 대해 다양한 정보 밀도 level을 가진 요약문들을 생성하도록 하였다. GPT에게 정보 밀도를 다르게 여러 요약문들을 동시에 생성하도록 지시한 것이 아니라 original text와 이전 요약문을 비교하면서 빠진 정보를 알아내고 이 정보들을 길이를 유지하면서 추가하도록 prompt하였다. 이때, 요약문끼리 정당한 비교를 하기 위해서 요약문의 길이가 서로 동일하도록 조정하였다.
이 prompt를 Chain of Density (CoD) prompt라고 지칭한다.
다음 prompt가 본 논문에서 사용한 CoD prompt이다.
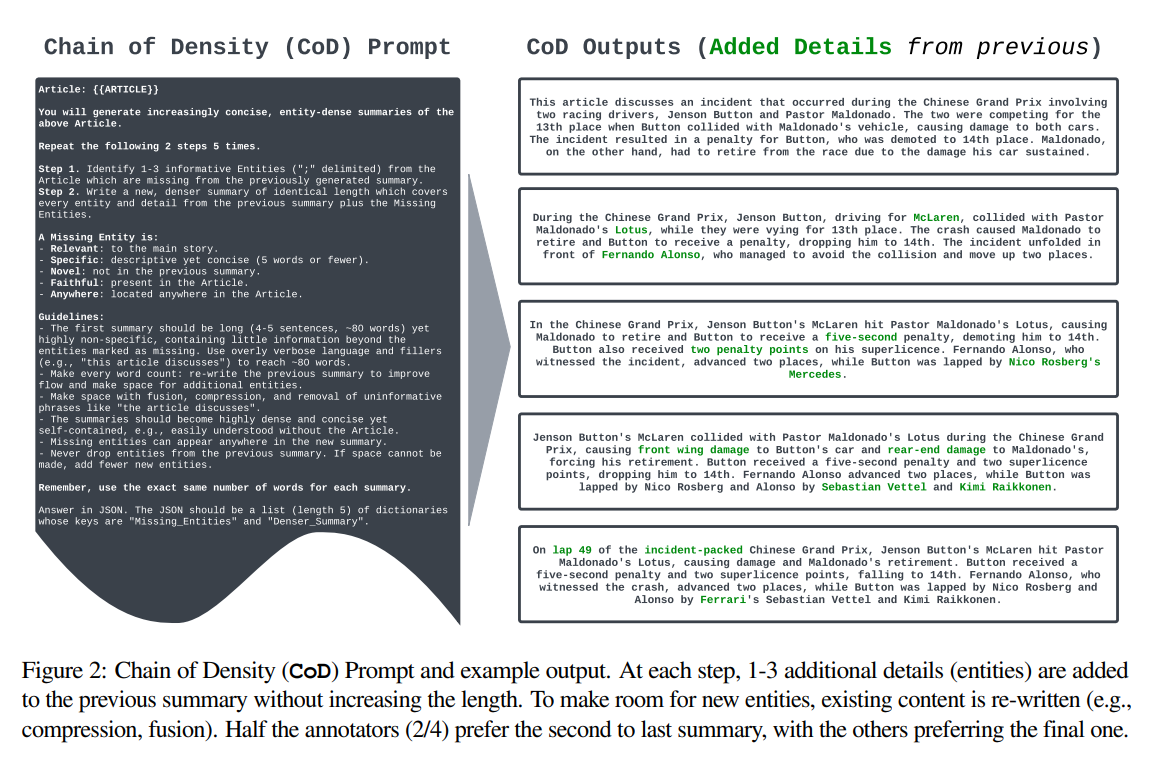
Prompt를 읽어보면 길이를 유지하면서 빠진 정보들을 추가하기 위해서는 이전 요약문의 중요한 내용들을 제거하는 것이 아니라 Abstraction, fusion, compression의 과정을 거치도록 제안한 것을 알 수 있다. 또, 빠진 정보들을 정의할 때 entity를 종류별로 정의한 것이 아니라 ‘Missing Entity’라는 것을 따로 정의하여 이 정의대로 빠진 정보들을 찾아내도록 하였다.
Missing Entity를 고르는 기준은 다음과 같다.
- Relevant: 주요 흐름과 연관되어있고
- Specific: Article의 특징을 잘 담으면서 짧아야 하고
- Novel: 이전 summary에 존재하지 않고
- Faithful: Article에 존재하며
- Anywhere: Article에서 존재하는 위치는 상관없음
Data
CNN/DailyMail summarization test set에서 100개의 article들을 sampling하여 CoD 요약문들을 생성하도록 하였다.
Reference Points
COD 요약문의 비교 대상으로는 사람이 직접 작성한 요약문과 vanilla prompt로 생성한 GPT-4 요약문을 사용하였다.
Statistics
요약문 평가는 두 종류의 통계 지표를 사용한다.
Direct statistics
CoD prompt으로 조절되는 token 수, entity, entity 밀도를 측정하였다. 다음은 측정 결과이다.
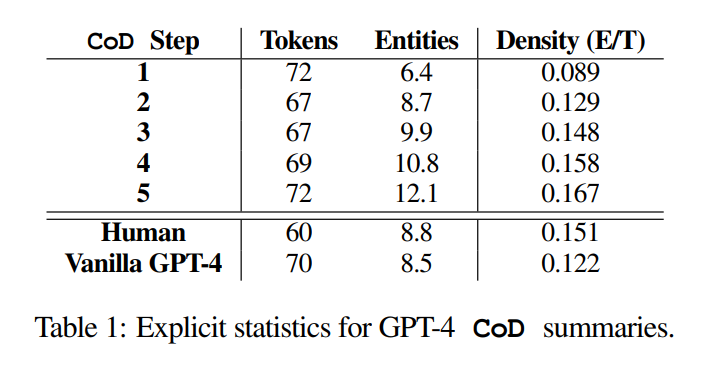
- Token 수가 CoD prompt으로 인해 적절하게 유지되는 것을 관찰할 수 있다.
- Entity 개수와 entity 밀도는 밀도를 높이는 step을 거칠수록 높아지는 것을 관찰할 수 있다.
Indirect statistics
정해진 길이 안에서 정보를 더 밀도있게 작성하려고 하는 과정에서 변하는 요약문의 특성도 측정하였다.
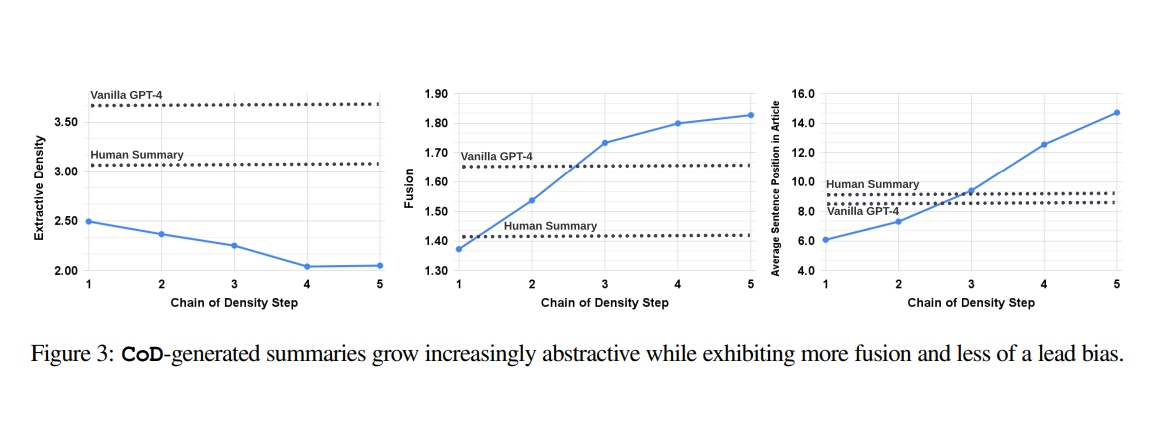
Abstractiveness
정해진 길이 안에서 새로운 정보를 추가해야 하기 때문에 이 정보가 들어갈 공간을 기존의 요약문에서 중요도가 낮은 단어나 표현들을 줄이면서 만들어야 한다. CoD level이 높아질수록 공간을 만들기 위해서는 original text의 문장을 그대로 복붙하는 것이 아니라 여러 문장들을 더 짧으면서 정확하게 바꾸는 abstractiveness가 높아질 수 밖에 없다.
본 논문은 요약문의 abstractiveness를 측정하기 위해 abstractiveness의 반대 개념인 extractive density (Original text에서 얼만큼 추출했는지)를 측정하여 이 값이 낮을수록 abstractiveness가 높다고 판단하였다.
Figure 3의 맨 왼쪽을 보면 CoD step이 진행될수록, extractive density가 낮아지는 것을 확인할 수 있다. 이를 통해 CoD가 진행될수록 original text를 그대로 사용하는 것이 아니라 적합한 구조와 단어들을 직접 생각하여 요약문을 생성하였음을 알 수 있다.
Fusion
이 경우에도 CoD level이 높아질수록 새로운 entity들이 들어갈 공간을 만들기 위해서는 original text / 이전 summary의 여러 표현들을 하나로 합치는 과정이 필수이다. 따라서, CoD level이 높아질수록 더 많은 공간을 만들어야 하므로 fusion 측정 값도 높아질 것이라고 가설을 세웠다.
Fusion의 정도를 측정하기 위해 요약문의 한 문장에 original text의 몇 개의 문장을 참조하였는지를 측정하였다. 이 값이 높을수록 fusion의 정도가 높을 것이라고 판단한 것이다. 이 값을 결정하는 metric은 Relative ROUGE gain이다.
Relative ROUGE gain: 요약문의 한 문장이 original text의 몇 개의 문장을 참고하였는지 계산하는 metric이다. 이 측정 과정은 우선 요약문의 target 문장과 연관성이 제일 높은 original text의 source 문장을 알아내는 것에서 시작된다. 여기에 original text의 다른 문장들까지 하나씩 더해가면서 요약문과의 유사도 (ROUGE 점수)가 negative가 될 때 멈춘다. 이렇게 최종적으로 선택된 original text 문장의 개수가 target 문장의 fusion score가 되도록 하였다.
이 수치 결과값 또한 가설과 일치한다. Figure 3의 중간을 보면, CoD가 진행될수록 Fusion 값이 증가함을 알 수 있다. 즉, CoD level이 높아지면서 정보의 결합이 높아져 효율적인 정보 전달 구조를 만들어냈다는 것을 관찰할 수 있다.
Content Distribution
요약문에서 사용되는 정보가 original text의 어떤 위치에서 왔는지의 분포도 측정하였다. 본 논문은 CoD 요약문들이 original text의 앞부분에 집중하는 경향인 Lead Bias을 갖고 있다가 (뉴스 기사는 맨 앞에 가장 중요한 정보들을 배치하므로) CoD가 진행되면서 다른 부분들도 참고할 것이라고 가설을 세웠다.
Content Distribution을 측정할 때 Fusion 측정 데이터를 활용하였다. Fusion 데이터에 각 요약문 문장과 관련이 높은 original text의 문장들에 대한 정보가 들어있다. 본 논문은 이 문장들의 순서들의 평균값을 계산하여 이 값이 높을수록 original text의 뒷부분도 참고하였다고 판단하였다.
Figure 3의 오른쪽을 보면 CoD가 진행될수록 이 값이 증가한다는 것을 통해 요약문이 Lead bias 없이 article의 뒷부분도 많이 참조한다는 것을 보여준다.
Results
Human preferences
어느 정도의 정보 밀도가 선호되는지 파악하기 위해서 CoD step에 따른 human preference 실험을 하였다. 각 article의 요약문들 중 제일 선호되는 summary를 하나 고르도록 하고 기록하였다. 다음은 CoD step 별 1등을 한 비율이다.
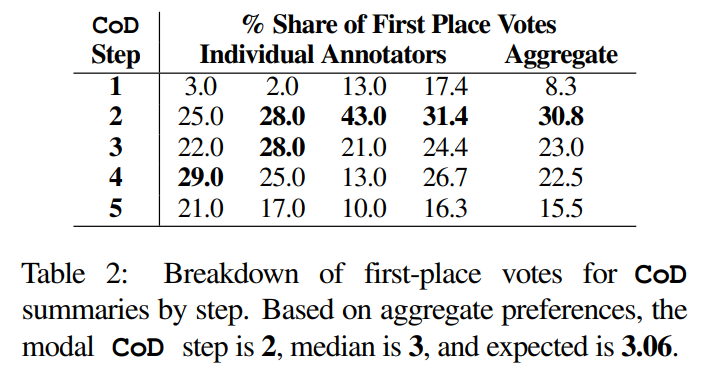
우선 Fleiss’ kappa 값이 낮다는 것을 통해 사람들의 의견이 통일되지 않은 경향을 보인다.
Fleiss’ kappa (k): 여러 명의 평가자가 서로 얼마나 일치된 의견을 내놓았는지를 측정하는 통계적 지표이다. k>0.75일 때 높은 일치율, k<0.4일 때 낮은 일치율을 보인다고 해석된다.
이 수치의 의미는 요약본이 어느 정도 수준 이상의 quality를 갖고 있어 차이가 미세했기 때문에 어떤 요약본이 절대적으로 우월한지 판단하기 어려웠을 것이라는 것이다. 하지만 이런 불확실성 속에서도 human preference 결과에서 주목할만한 뚜렷한 정보가 존재한다.
실험 결과를 보면 step 2가 1등을 할 비율이 제일 높다는 것을 관찰할 수 있다. 또, step을 3번 이상 거쳤을 때 1등을 한 비율이 61% (23+ 22.5+ 15.5)라는 것을 관찰할 수 있다. 따라서, 사람에게 가장 선호되는 CoD step의 median은 step 3이라고 추론할 수 있다.
사람이 가장 선호하는 정보 밀도 (entity density)는 Step 3의 정보 밀도 값 0.148, 약 0.15이라는 것인데 이 수치는 Table 1을 보면 사람이 작성한 요약문의 정보 밀도값 0.151과 거의 일치한다. 이 정보를 통해 가장 선호되는 정보 밀도는 사람이 작성한 요약문의 정보 밀도와 align된다는 것을 알 수 있다.
Automatic Metrics
이전 연구 결과에 따르면 Gpt-4의 평가는 사람의 평가와 연관성이 크다. 따라서, human preference 실험처럼 각 article의 요약문들을 GPT-4에게 평가하도록 prompt 하였다. 이때, 사용한 평가 기준은 다음과 같다.
-
Informative: Informative 요약문은 기사의 중요한 정보를 빠짐없이 포착하여, 이를 정확하고 간결하게 제시한다.
-
Quality: 고품질의 요약문은 독자가 쉽게 파악하고 이해할 수 있어야 합니다.
-
Coherence: 일관성 있는 요약문은 구조가 잘 짜여 있고 체계적으로 조직되어 있습니다.
-
Attributable: 요약문에 포함된 모든 정보가 원문 기사 내용에 완전히 근거하고 있는지 확인한다.
-
Overall Preference 좋은 요약문은 기사의 핵심 아이디어를 효과적으로 전달해야 한다.
이 실험의 결과는 다음과 같다.
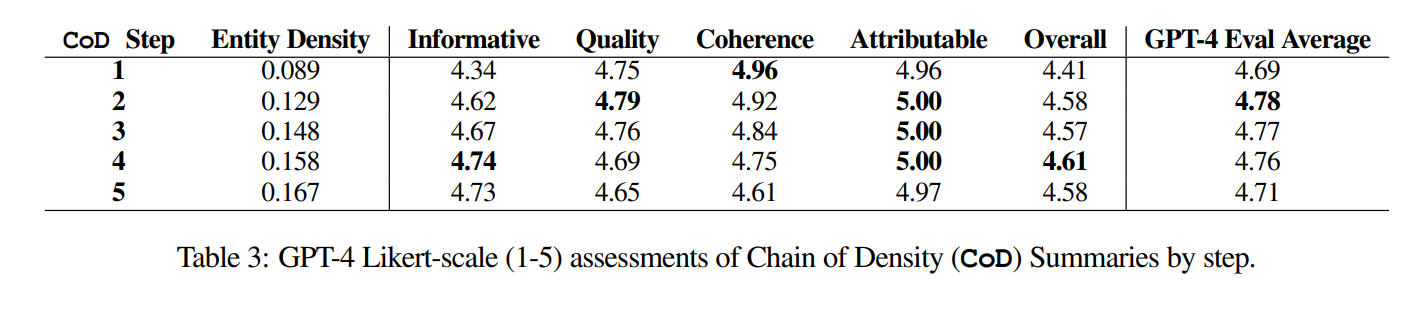
Informative
정보의 밀도가 높아질수록 informative 점수가 높아지는 것을 통해 이 둘은 밀접한 연관성이 존재함을 알 수 있다. Step 1에서부터 informative 점수가 높아지면서 Step 4에서 Informative 점수가 최대로 높아진다. 그 후, step 5에서 다시 낮아진다.
Quality, Coherence
이 점수들은 article과 관련없이 요약문 자체만 평가한 결과이다. 둘 다 초반에만 높다가 step이 진행될수록 낮아지는 경향이 있다.
Attributable
모두 다 높게 나온다.
Overall
정보 밀도가 높은 step에서 overall 점수가 높게 나오는 경향이 있다. 이 중 step 2~4가 비슷하게 높고 step 1과 5가 가장 점수가 낮다.
Qualitive Analysis
Coherence/Readability와 informativeness 간의 trade-off가 존재한다는 것이 뚜렷하다. 이 trade-off를 보여주는 예시는 다음과 같다.
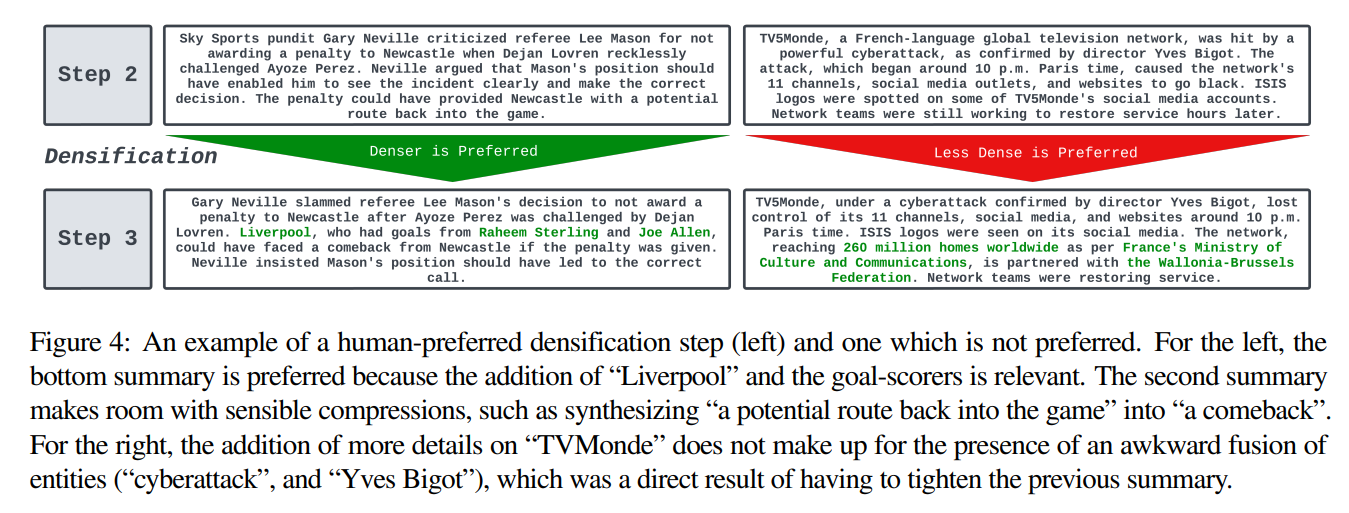
왼쪽 요약문에서는 정보 밀도가 높아져서 더 선호되는 요약문이 되었지만 오른쪽은 반대로 밀도가 높아짐으로써 덜 선호되는 요약문이 되었다. 즉, 밀도의 정도에 따라 readability가 떨어지는 것을 관찰할 수 있다.