DeBERTa Enhanced BERT with Disentabled Attention 리뷰
Background
기존 self attention을 활용한 Language model들은 위치 정보를 주입하기 위해서 input의 word embedding에 positional embedding을 더했다. 이를 통해 각 input의 단어는 위치 정보와 내용 정보를 바탕으로 한 벡터로 표현되도록 하였다. 하지만 본 논문은 기존 방법으로는 위치 정보를 활용하지 못하도록 한다는 것을 지적한다. 또, Masked Language Modeling은 위치 정보를 input 초기에 주는 것은 상대적 위치 정보를 충분히 학습하지 못하게 할 가능성이 존재한다고 지적한다.
DeBERTa Architecture
본 논문은 두 방법 disentangled attention과 enhanced mask decoder를 통해 SOTA PLM의 성능을 개선한 DeBERTa를 소개한다.
1) Disentangled Attention
본 논문은 한 단어를 나타내기 위해 위치 정보와 내용 정보를 더하는 기존의 방법에서 벗어나기 위해 각 단어를 내용을 나타내는 vector와 위치를 나타내는 vector로 따로 나타내었다. 그리고 attention weights는 단어의 내용과 단어 간 상대적 위치를 바탕으로 계산되도록 하였다. 이런 설계를 한 이유는 단어 짝의 attention weight가 내용 뿐만 아니라 상대적 위치에도 의존한다는 관찰 결과 때문이다.
DeBERTa는 어떤 sequence에서 위치 i에 있는 token을 content 벡터 ${H_i}$와 위치 j에 있는 token과의 상대적 위치 vector ${H_{i \mid j}}$로 표현한다. 이를 바탕으로 i번째 token과 j번째 token의 attention score 계산은 다음과 같다.
\[A_{i,j} = \{ H_i, P_{i \mid j} \} \times \{ H_i, P_{j \mid i} \}^T\] \[= \underbrace {H_iH_j^T}_{\text{(a) content-to-content}} + \underbrace {H_iP_{j \mid i}^T}_{\text{(b) content-to-position}} + \underbrace {P_{i \mid j}H_j^T}_{\text{(c) position-to-content}} + P_{i \mid j}P_{j \mid i}^T\]$A_{i,j}$을 분리해서 생각하면 다음과 같다.
-
$(a)$: Content-to -content으로 내용만 봤을 때의 두 단어의 연관성
-
$\text{(b)}$: Content-to-position으로 Query의 내용과 Query - Key의 상대적 위치의 연관성
-
$(c)$: Position-to-content으로 Query - Key의 상대적 위치와 Key의 내용과의 연관성
이때, $P_{i \mid j}P_{j \mid i}^T$는 상대적 위치 간의 연관성이기 때문에 큰 정보를 제공해주지 못 한다고 생각하여 없앴다.
Disentangled Attention을 직관적으로 이해해보자
deep learning과 learning deep에서 각각 다르게 쓰인 단어 learning을 제대로 represent 하기 위해서는
- $(a):$ learning과 의미적 관계가 높은 단어가 무엇인지
- $\text{(b)}:$ learning으로부터 얼마나 떨어진 단어가 중요한지
- $(c):$ learning의 위치에서는 어떤 의미를 가진 단어를 주목해야 하는지
알 수 있게 하는 방법이 Disentangled Attention이라고 할 수 있다. 이런 다각적인 정보를 통해 Disentangled Attention은 token embedding을 더 정확하게 할 수 있게 된다.
Relative Distance
길이가 k인 sequence에서 첫 번째 단어와 나머지 단어들의 상대적 위치 차이는 [0,-1, …, -k+1]이다. 또, 마지막 단어와 나머지 단어들의 상대적 위치 차이는 [k-1, … 0]이다. 즉, 상대적 위치 차이는 -k ~ +k 범위 안에서 정의가 된다. 하지만 이 정보들은 거리값으로 바꾸기 위해 상대적 위치 거리는 [-k+1, k-1] -> [0,2k)의 범위를 갖도록 하였다. 따라서, k를 상대적 위치의 최대값이라고 하고 상대적 거리 matrix를 $\delta$라고 할 때, 위치 i와 j 간의 상대적 거리를 본 논문은 다음과 같이 정의한다.
\[\delta(i, j) = \begin{cases} 0 & \text{for } i - j \le -k \\ 2k - 1 & \text{for } i - j \ge k \\ i - j + k & \text{otherwise.} \end{cases}\]너무 먼 token들은 멀수록 더 큰 값을 주지 않고 제한시켰다. 이를 통해 너무 벗어난 token들은 주변 문맥으로 인정하지 않겠다는 의도를 지닌다.
Disentangled Attention과 Self-attention을 비교해보면 다음과 같다.
기존 Self-Attention 수식
\[\begin{align*} Q &= H W_q \\ K &= H W_k \\ V &= H W_v \\ A &= \frac{Q K^T}{\sqrt{d}} \\ H_o &= \text{softmax}(A) V \end{align*}\]이때 $H \in R^{N \times d}$는 input hidden vectors를 의미하고 $H_o \in R^{N \times d}$는 self attention의 output, $W_q, W_k, W_v \in R^{d \times d}$는 projection matrix, $A \in R^{N \times N}$는 attention matrix, N은 input sequence 길이, d는 hidden states 크기이다.
Disentangled Self-Attention 수식
Projection matrix를 content를 위한 것($_c$)과 position을 위한 것($_r$)으로 따로 설정한다.
$Q_c, K_c, V_c$는 projection matrix $W_{q,c}, W_{k,c}, W_{v,c} \in R^{d \times d}$로 input hidden vectors $H$를 mapping하여 얻은 content vectors이다.
\[Q_c = H W_{q,c}\] \[K_c = H W_{k,c}\] \[V_c = H W_{v,c}\]$P \in R^{2k \times d}$는 모든 layers에서 공유되는 relative positional embedding vectors이고 $Q_r, K_r$은 projection matrix $W_{q,r}, W_{k,r} \in R^{d \times d}$로 $P$를 mapping하여 얻은 relative position vectors이다.
\[Q_r = P W_{q,r}\] \[K_r = P W_{k,r}\]$\tilde{A}_{i,j}$는 attention matrix $\tilde A$의 요소로 i번째 token의 j번째 token에 대한 attention score이다.
\[\tilde{A}_{i,j} = \underbrace{Q_{i}^c {K_{j}^c}^T}_{(a) \text{ content-to-content}} + \underbrace{Q_{i}^c {K_{\delta(i,j)}^r}^T}_{(b) \text{ content-to-position}} + \underbrace{K_{j}^c {Q_{\delta(j,i)}^r}^T}_{(c) \text{ position-to-content}}\] \[H_o = \text{softmax}\left(\frac{\tilde{A}}{\sqrt{3d}}\right) V_c\]이때, (b)에서 $\delta(i,j)$인 이유는 content-to-position은 key의 위치가 j일 때, 위치 i에 있는 query의 content의 attention weight를 계산하는 항이기 때문이고 ( c )에서 $\delta(j,i)$인 이유는 position-to-content는 query의 위치가 i일 때, 위치 j에 있는 key의 content의 attention weight를 계산하는 항이기 때문이다.
2) Enhanced Mask Decoder
DeBERTa는 MLM을 통해 pretrain이 된다. DeBERTa는 disentangled attention을 통해 이미 단어의 내용과 상대적 위치 정보를 학습할 수 있지만 절대적 위치 정보는 학습을 할 수 없다. 본 논문은 NLU / NLG task에 상대적 위치 정보가 더 효과적이라는 연구가 존재하긴 하지만 절대적 위치 정보도 추론 과정에서 매우 중요한 정보라고 주장한다.
예를 들어 “a new store opened beside the new mall”이라는 문장에서 store와 mall 두 단어 모두 new라는 단어와 동일한 상대적 거리를 가지기 때문에 주변 단어들과 상대적 위치 정보들로 구분하기 어렵다. 즉, 상대적 위치 정보만 가지고는 문장의 주어와 같은 문장의 구조를 파악하기 어려워진다. 그리고 문장 구조 정보는 절대적 위치 정보에 많이 의존한다.
BERT는 절대적 위치 정보를 input layer에만 넣지만 DeBERTa는 모든 Transformer layers 뒤에 넣는다. 이때, masked token prediction을 하는 softmax layer 전까지만 절대적 위치 정보를 넣는다.
$I$가 absolute position embedding이다.
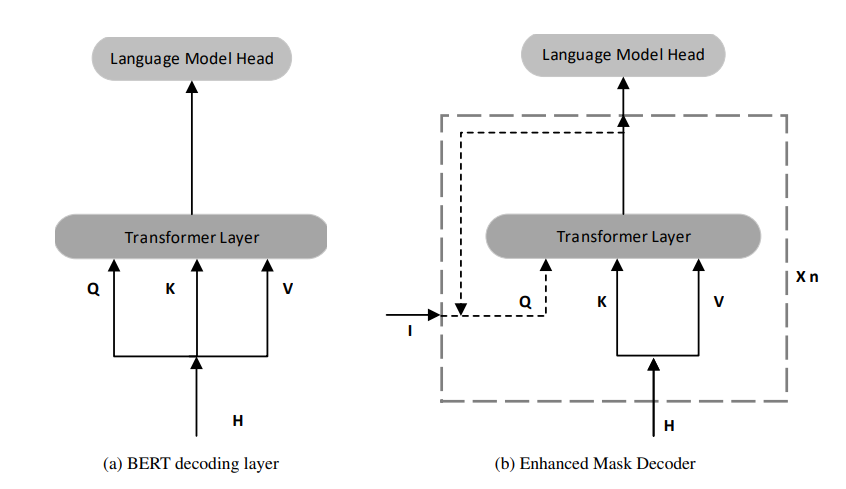
이 방법을 통해 더 효과적인 상대적 위치 정보는 Transformer로 caputure하고 절대적 위치 정보는 masked 단어들을 decoding할 때 부가적인 정보로 사용하도록 하였다.
SiFT: Scale invariant Fine-Tuning
본 논문은 모델의 finetuning 과정을 더 안정적으로 만들기 위해서 SiFT를 소개한다.
모델의 generalization, 즉 성능을 robust하게 만들기 위한 방법 중 하나는 Adversarial Training이다. 이 방법의 대략적인 과정은 다음과 같다. 우선, 입력 data에 perturbation을 주어 adversarial data를 만든다. 그 다음, 모델이 이런 adversarial data을 이해하여 정답을 맞추도록 학습시킨다. 이런 학습 방법은 모델이 약간의 변화에도 흔들리지 않고 더 robust해지며 일반화 성능이 향상된다.
하지만 이 방법의 문제점은 perturbation을 주입하는 과정으로 인해 불안정하다는 것이다. 입력 data에 perturbation을 주는 방법으로는 word embedding에 noise를 더하는 방법을 주로 사용한다. 이때, 모델이 커질수록 word embedding의 norm 값의 variance가 커진다. 따라서 word embedding에 noise를 더하는 방법은 어떤 단어들에는 그저 noise가 되고 어떤 단어들에는 의미를 바꿔버리는 영향력을 갖고있다. 예를 들어 apple의 norm은 0.1이고 democracy의 norm은 10.0일 때, 0.01의 noise를 각 단어에 주면 apple에게는 10%의 변화를, democracy에세는 0.1%의 변화를 주게 되는 것이다. 이렇게 noise의 영향력이 벡터의 norm에 따라 달라지게 된다면 학습 과정이 불안정해진다.
따라서, SiFT는 노이즈를 더하기 전에 모든 embedding vector들의 norm을 normalize한다. Fine-tuning 할 문장의 word embedding들을 가져와서 Layer Normalization처럼 normalization을 진행한다. 이를 통해 모든 단어들은 동일한 noise에 동일한 영향을 받게 되어 안정적인 adversarial training이 가능해진다.
Experiments
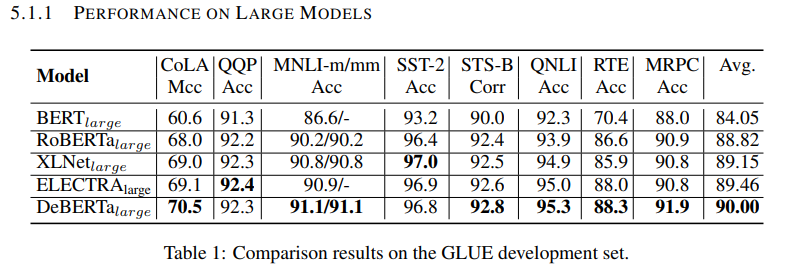
Table 1에서는 GLUE의 8개 NLU 태스크에 대하여 DeBERTa와 유사한 구조인 BERT, RoBERTa, XLNet, ELECTRA를 포함한 트랜스포머 기반 PLMs의 결과를 비교한다. RoBERTa, XLNET, ELECTRA는 160GB의 학습 데이터로 사전학습 되는 반면, DeBERTa는 78GB의 학습 데이터로 학습된다. 또, RoBERTa와 XLNet은 40억개의 training sample을 사용하는 반면, DeBERTa는 RoBERTa나 XLNet의 약 반 정도 되는 20억개의 training sample을 사용한다. Table 1은 DeBERTa가 BERT와 RoBERTa에 비해, 모든 태스크에서 꾸준히 좋은 성능을 보인다는 것을 입증한다. 그리고 DeBERTa는 8개 태스크 중 6개 태스크에서 XLNet의 성능을 능가한다.
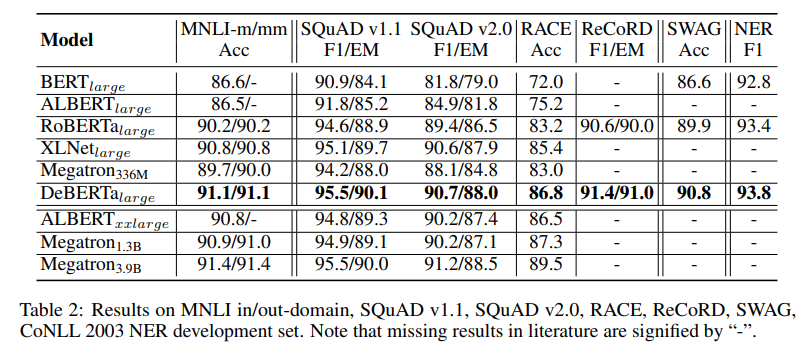
DeBERTa는 모든 7개 태스크에서 가장 좋은 성능을 보인다. RACE benchmark에서는 DeBERTa는 XLNet을 +1.4%만큼 크게 능가한다. 심지어 Megatron1.3B가 DeBERTa보다 3배 큰 모델임에도 불구하고, DeBERTa는 4개의 benchmark 중 3개에서 Megatron1.3B를 능가한다.
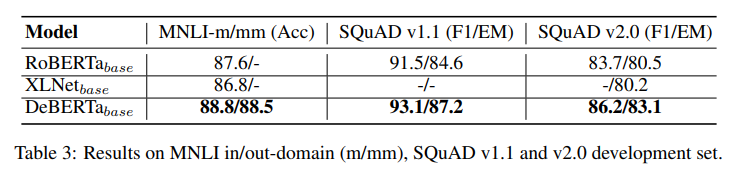
모든 3개의 태스크에서, DeBERTa는 RoBERTa와 XLNet을 큰 차이로 능가한다.
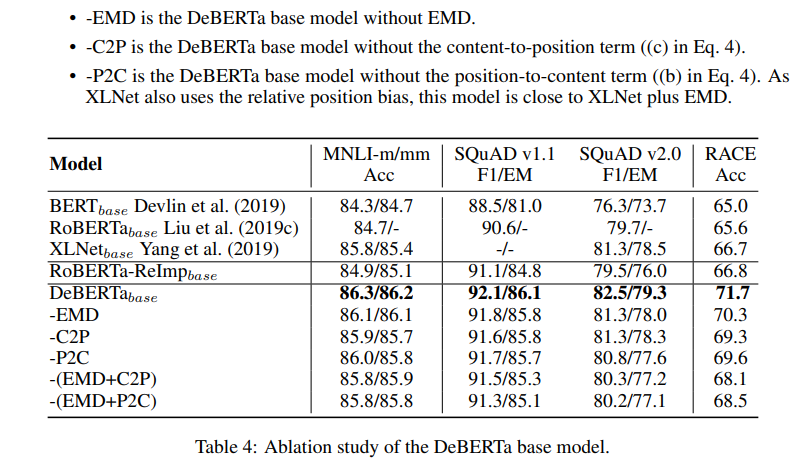
DeBERTa의 모든 요소들이 성능 향상에 필수임을 알 수 있다.
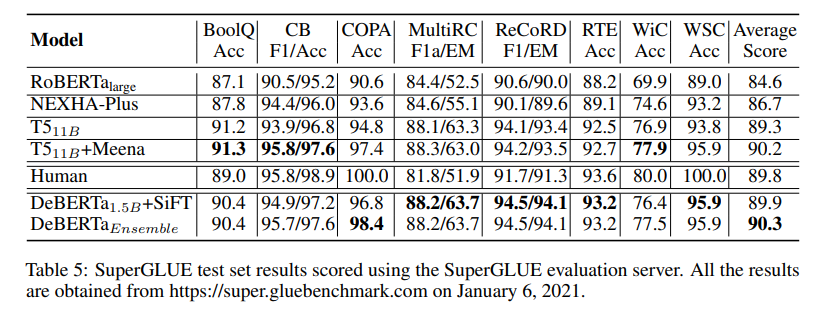
11 billion parameter를 가진 T5와 1.5 billion parameter를 가진 DeBERTa가 비슷한 성능을 보인다. 또, SiFT를 사용하는 것이 Ensemble 방법을 사용하는 것보다 더 우수한 generalization 능력을 보인다. 이는 더 많은 task에서 더 우수한 성능을 보인다는 것을 통해 유추할 수 있다.