VLA-Touch: Enhancing Vision-Language-Action Models with Dual-Level Tactile Feedback 리뷰
본 논문은 contact rich manipulation을 돕기 위한 tactile feedback은 두 영역에서 활용될 수 있다고 주장한다. 첫 번째는 planning 단계이다. 이 단계에서 tactile 정보를 사용하면 object의 surface와 같은 특징 정보에 대해 추론을 할 수 있게 된다. 두 번째는 control 단계로 tactile sensing이 표면의 마찰력이나 contact detection의 역할을 해준다고 한다.
하지만 현재 VLA 모델들은 이미 visual과 langauge에 대해서만 학습이 되어있기 때문에 tactile 정보를 바탕으로 추론을 하고 action을 생성하지 못한다.
따라서 본 논문은 기존 VLA에 최소한의 수정을 통해 tactile 정보를 두 방면(planning과 control)으로 활용할 수 있게 한다.
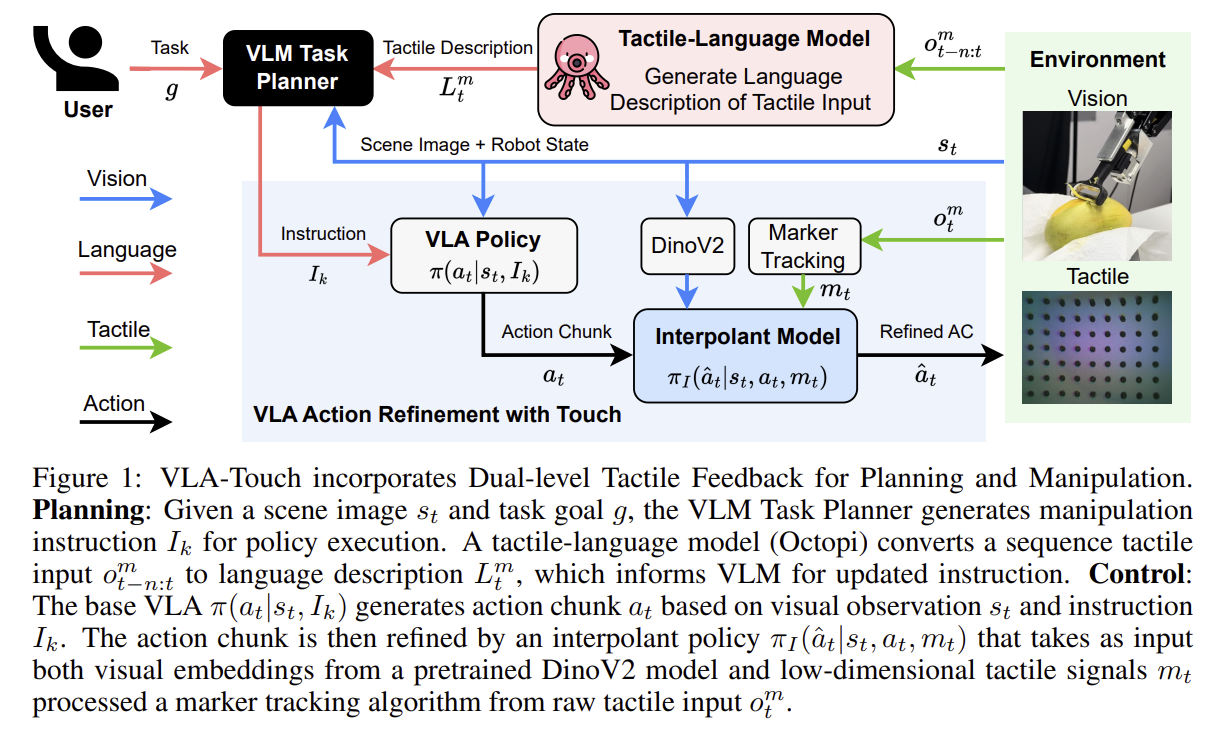
Planning
기존의 VLM은 원래처럼 task instruction과 image을 처리하게 두고 별도의 tactile language model이 tactile data로 물체의 특성을 파악하고 linguistic feedback을 VLM에 전달하도록 한다.
Control
별도의 Tactile augmented controller을 사용해서 기존의 VLA의 action output에 tactile signal을 반영해서 contact rich task에서 precise manipulation이 가능하도록 한다.
Methodology
Tactile Assisted Task Planning
기본 VLA는 Robot Diffusion Transformer RDT을 사용하고 VLM task planner는 GPT-4o을 사용한다. GPT-4o가 현재 observation과 goal을 바탕으로 RDT에 manipulation instructions을 내려주는 구조라고 생각하면 된다. RDT가 행동을 끝내거나 maximum execution steps을 넘었을 때 tactile language model이 최근 tactile signal을 linguistic tactile description으로 바꿔서 planner에 전달하고 planner가 새로운 planning을 하도록 한다.
이떄 tactile langauge model로는 Octopi을 사용한다. Octopi는 Gelsight sensor을 기반으로 contact한 object의 tactile 특성을 맞추도록 학습되어있는 language model이다.
VLA Policy Refinement with Tactile Sensing
기존 VLA model은 tactile 정보를 사용할 줄 모르기 때문에 BRIDGeR라는 interpolant diffusion controller을 사용한다.
Interpolant diffusion controller는 random noise부터 시작해서 diffusion을 하지 않고 어느정도 denoised된 action을 입력으로 받아서 refine하도록 설계된 모델이다.
Interpolant controller $\pi^I (\hat{a}{t:t+T_i} \mid a{t:t+T_i}, s_t, m_t)$ 은 source action chunk $a_{t:t+T_i}$, state $s_t$, tactile signal $m_t$ 을 입력으로 받아 ($T_a$가 전체 horizon length이라고 할 때 $T_i \le T_a$) refinement process을 수행한다.
이때 tactile signal은 tactile force signal으로 marker displacement 정보로 추측할 수 있는 값이다. 각 marker 별로 force vector을 계산한 다음에 합쳐서 전체 force vector $m_t$ = (X,Y,M) 을 얻은 것이다.
Controller는 VLA가 생성한 action과 expert demonstration으로 pair가 된 dataset으로 supervised learning으로 학습을 한다. 추론을 할 때는 sliding window 방법으로 refinement을 적용한다. 예를 들어 $a_{\text{t:t+H}}$ 까지가 전체 action이라고 하고 window 크기가 3이라고 했을 때 $a_1, a_2, a_3$ 만큼만 tactile 정보를 통해 refining을 거치고 수행한 다음 $a_4, a_5, a_6$ 으로 옮겨서 다시 refine을 진행한다.
Experiments
실험을 통해 다음 세 질문을 해결하고자 한다.
실험에 사용되는 task들은 뚜겅이 있는 cup에 물이 들어있는지 확인하고 물을 흘리지 않고 옮기는 Cup task, 가장 매끄러운 sponge을 골라서 ink을 닦는 Wipe task, 그리고 망고의 부드러움/딱딱함을 파악하고 껍질을 벗기는 Peeling task이다.
Q1: Tactile linguistic feedback이 VLM의 task planning에 주는 효과
Tactile feedback이 task planning의 효과를 높여주는가? 그리고 raw tactile image을 VLM에 넣는 것보다 tactile linguistic description이 더 좋은가?
이를 답하기 위해서 세 종류의 VLM을 사용한다. (GPT-4o, GPT-4o + Tactile image, GPT-4o + Octopi)
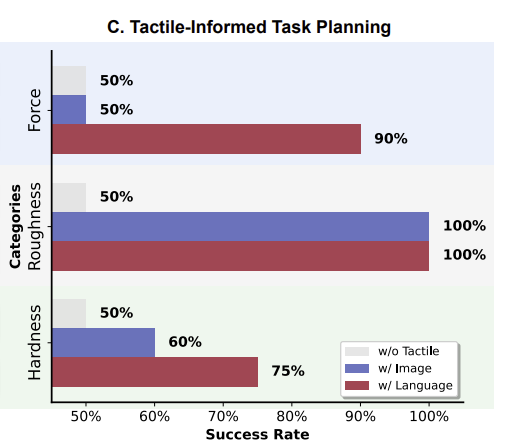
VLM이 tactile 정보를 통해 물이 들어있는지 (Force), 부드러운지 (Roughness), 딱딱한지 (Hardness) 를 판단하도록 하였는데 image을 주는 것은 효과가 없었고 Octopi을 통해 linguistic 정보를 주는 것이 더 효과가 있었다.
Q2: Tactile Feedback이 Action expert에 주는 효과
Tactile feedbnack이 VLA의 성능을 높여주는가? 그리고 interpolant based diffusion이 residual controller와 비교했을 때 더 좋은가?
이를 답하기 위해서 세 종류의 Action policy을 구성한다. (RDT, RDT + Residual Controller, RDT + Interpolant Controller)
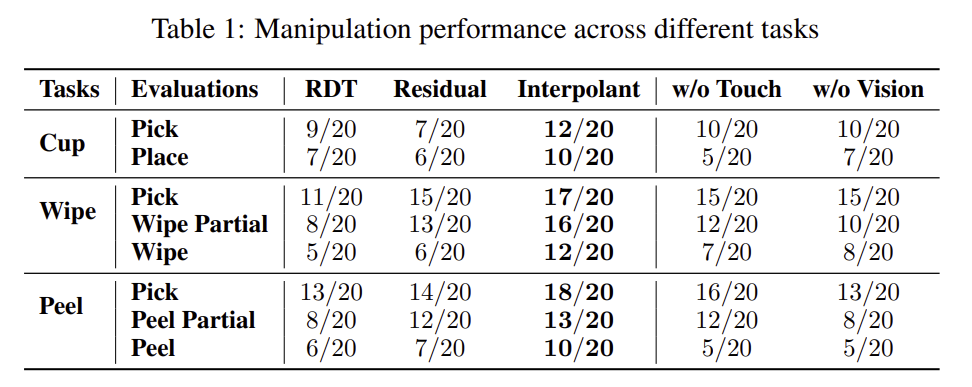
Interpolant Controller가 다른 종류의 action policy 구성보다 다 outperform한다.
특히 tactile 정보를 사용하지 않는 일반 RDT는 grasp을 잘 하지 못하고 pre-release을 해서 최종 목표까지 이루지 못한다. 반면 residual controller는 positioning error가 존재한다. 이로 인해서 refine을 거치더라도 잘못된 행동을 하게 된다. 하지만 새로 action을 refining하는 interpolant controller는 준수한 성능을 보인다.
Q3: 꼭 Dual level으로 tactile feedback을 사용해야 하는가
Dual level tactile feedback (linguistic, refinement) 가 contact rich task에 도움이 되는가?
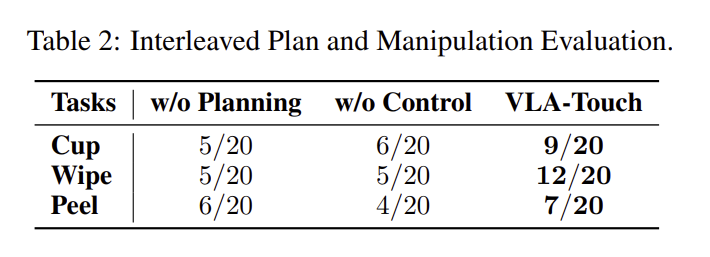
이를 답하기 위해서 tactile feedback을 세 종류로 나눈다. (w/o planning, w/o control, both)