10: Free Space Management
Free Space Management
이전 post에서 말했듯이 free space management는 memory를 고정된 단위로 처리할 때 유리하다. 하지만 malloc()/free()을 사용하거나 segmentation 때문에 고정된 unit으로 memory를 분리하지 못하게 될 때는 free space management가 어려워진다.
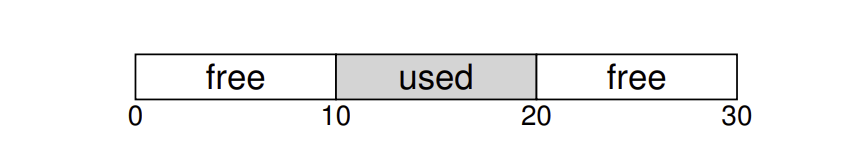
이처럼 연속적인 free space가 없어서 메모리를 할당 못해주는 문제를 external fragmentation이라고 한다. 예를 들어 process가 20 byte을 요청했는데 이 그림처럼 10 byte, 10 byte으로 나누어져 있어서 할당되지 못하는 것이다.
그렇다면 이 문제가 발생하지 않도록 allocator는 free space을 어떻게 관리할까? OS는 어떤 역할을 할까?
Assumptions
우선 malloc()/free()으로 인해 크기가 달라지는 heap이 external fragmententation의 주된 원인이기에 heap에 집중을 한다.
Allocator는 heap 안의 free space을 관리하기 위해서 free list을 사용한다. Free list는 모든 free space의 reference을 지니고 있다고 보면 된다.
Internal fragmentation이라는 문제도 존재한다. 이는 요구한 정도보다 더 할당했을 때 생기는 문제이다. 하지만, external fragmentation이 더 심각한 문제이라고 가정한다.
또, malloc()으로 인해 할당된 공간은 malloc 호출 프로그램의 소유가 되며 free()을 할 때까지 다른 system이 접근하지 못한다고 가정한다. 즉, OS의 compaction (physical address space 내에서 virtual address space의 segment들을 옮기는 행위)이 불가능하다고 가정한다.
Low level mechanism
Allocator는 자기의 역할을 수행하기 위해 low level mechanism과 high level policy을 사용한다.
이 mechanism을 통해 free list가 어떻게 관리되는지 그리고 allocate된 memory 크기를 어떻게 알아내는지를 알 수 있다.
Splitting
다음과 같은 heap이 존재한다고 해보자.
이 heap에 대응하는 free list는 대충 이렇게 생겼다.
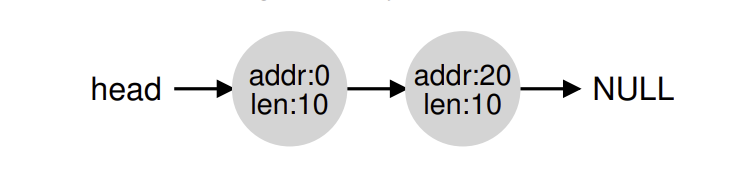
아까 말했듯이 external fragmentation 상태라서 20 byte 할당을 요구해도 실패한다. 하지만 반대로 10 byte보다 작은 할당이 요구되면 어떻게 될까? 즉, 어떤 10 byte을 쪼개서 줄까?
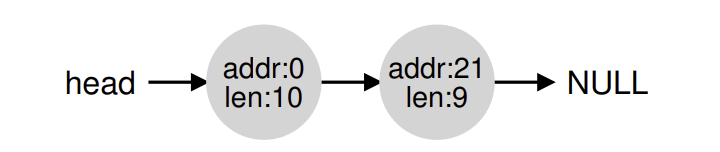
이 상황일 때 allocator가 splitting을 사용한다. Splitting은 이름 그래도 free space 중 하나를 골라 요청한만큼 떼어가고 나머지는 그대로 두는 방법이다. 예를 들어 1 byte을 요청했다면 두 번째의 free space의 첫 byte을 떼어가고 나머지를 남기는 것이다.
Coalescing
이젠 free()을 했을 때를 생각해보자.
예를 들어 free space의 중간에서 할당되었던 10 byte가 free 된다고 하자. 그럼 free list을 어떻게 update할 것인가?
아무 생각 없이 10 byte을 free list에 더한다면 free list는 다음처럼 될 것이다.
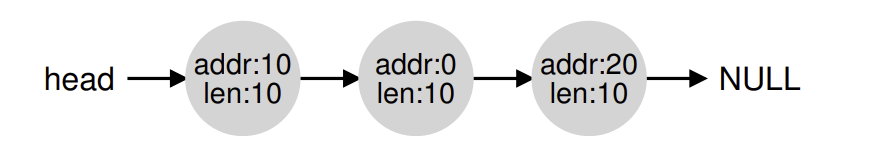
이제 free space가 연속적으로 30 byte가 존재함에도 불구하고 free list에서는 10 byte씩 쪼개져 있어서 실패한다.
이런 문제를 해결하기 위해서 coalescing이 사용된다. Free chunk가 free 될 때마다 chunk의 address 값과 근처 free chunk의 address의 값을 비교해서 붙어있다면 이를 연결해 더 큰 chunk을 만드는 방법이다.
Tracking Size of Allocated Regions
지금까지 free list가 어떻게 관리되는지 알아봤다. 그럼 이제 allocator가 할당해준 memory 크기를 기억하는 방법을 알아보자.
왜 allocator가 할당한 memory의 크기를 다 기억한다고 하는걸까? 이는 free()의 input/output을 보면 알 수 있다.
Free()에 할당된 영역에 pointer만 전달하면 할당했던 memory 크기만큼 반환해주었다. 그렇다는 것은 allocator는 할당한 영역의 크기를 모두 기억하고 있음을 의미한다.
$\rightarrow$ 그럼 free list에서 allocate된 memory 크기를 어떻게 매번 알아내는걸까?
Allocator는 사실 자기가 할당해준 영역 위에 header 정보를 저장한다.
typedef struct {
    int size;
    int magic;
} header_t;
malloc(20)을 했다고 했을 때 header에 크기 정보를 저장하기에 각 pointer가 가리키는 영역의 크기를 알 수 있는 것이다.
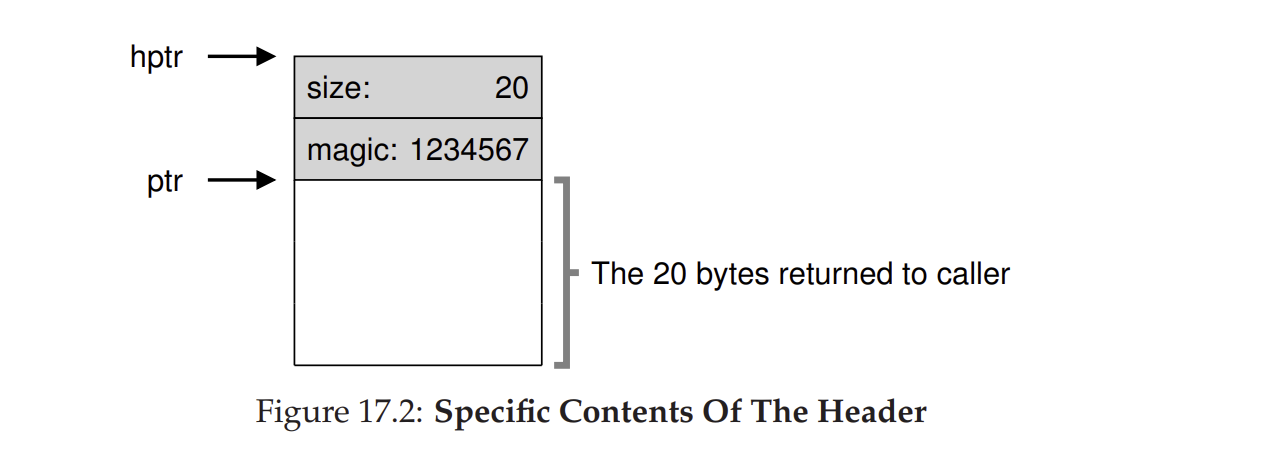
또, free 할 때는 allocate한 영역(ptr)부터 free 하는게 아니라 그 영역의 header(header pointer hptr)부터 free 한다.
void free(void *ptr) {
    header_t *hptr = (header_t *) ptr - 1;
...}
이에 더해 magic 값은 memory에 저장된 값이 garbage data인지 아닌지 확인해주는 역할을 한다.
그러면 malloc(20)울 할 때 header 정보가 들어갈 memory도 넣어야 하는거 아닌가? $\rightarrow$ 맞다. 따라서 N byte memory allocation을 요청했다면 사실 N byte 크기의 free space을 찾는 것이 아니라 N + sizeof(header) byte의 free space을 찾는 것이다.
Embedding a Free List
한 가지 의문점이 들 수 있다. Free list는 그럼 어디에 저장되는 것일까? Free list는 linked list이기에 free space가 늘어난다면 malloc()을 통해 node을 추가해야 하므로 heap에 저장된다고 생각할 수 있다.
하지만 free list가 heap에 저장된다면.. heap에 저장된 free list는 그럼 누가 관리할 것인가..?
따라서, free list는 malloc()을 통해 저장되는 것이 아니다. Free list는 사실 흔히 생각하는 list가 아니다. Free list는 free list의 free space node마다 그에 대한 정보를 앞에 저장하는 방법을 사용하여 free list을 heap에 embedding 된다.
typedef struct __node_t {
    int size;
    struct __node_t *next;
} node_t;
이것을 그림으로 표현하면 다음과 같다.
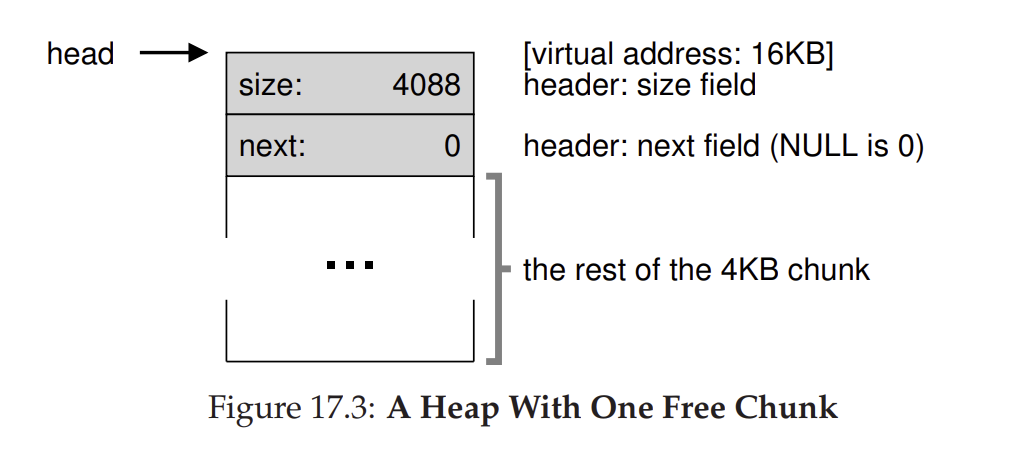
이렇게 free list의 정보를 저장하면 list을 저장할 곳을 만들지 않고 free list을 관리할 수 있게 되는 것이다.
free list chunk의 pointer을 얻기 위해서 system call mmap()을 사용한다.
// mmap() returns a pointer to a chunk of free space
node_t *head = mmap(NULL, 4096, PROT_READ|PROT_WRITE,
MAP_ANON|MAP_PRIVATE, -1, 0);
head->size = 4096 - sizeof(node_t);
head->next = NULL;
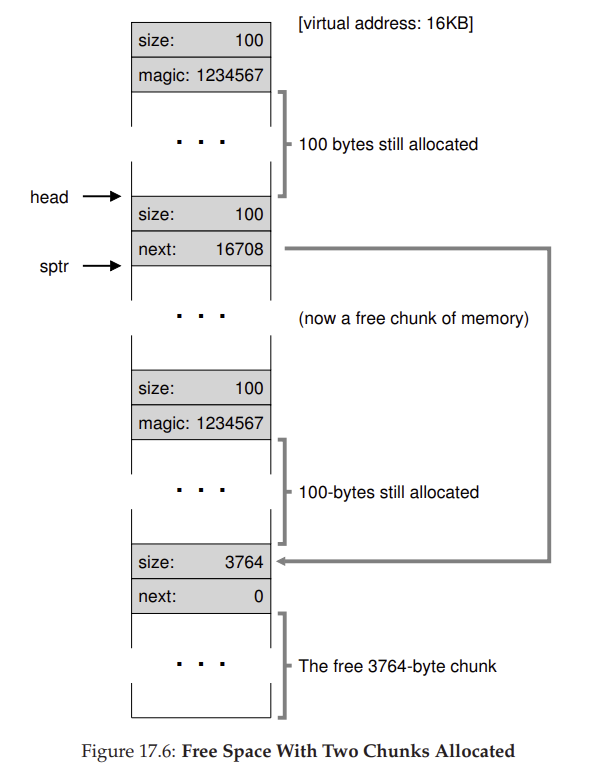
이 코드를 보면 mmap을 통해 4KB( = 4096) 크기의 chunk of free space의 pointer을 얻은 뒤에 size(node_t)만큼 뺀 값을 free space의 크기로 설정하는 것을 볼 수 있다. Header을 설정해야 하기에 4KB의 free space을 할당해도 사실은 header의 크기를 제외한 4088 (4096 - 8) 크기를 갖게 된다. 그래서 그림에서 size 값이 4096이 아니라 4088인 것이다.
이 상태에서 100 byte의 allocation request가 들어왔다고 하자. 그럼 100 byte의 free space와 그 영역의 정보(size, magic)를 저장할 header의 memory까지 할당해주어야 한다. Allocation space의 정보를 담는 header도 8 byte라고 했을 때, 실제 할당해주어야 하는 free space는 108 (100 + 8) byte이고 남는 free space는 3980(4088 - 108) byte가 되는 것이다.
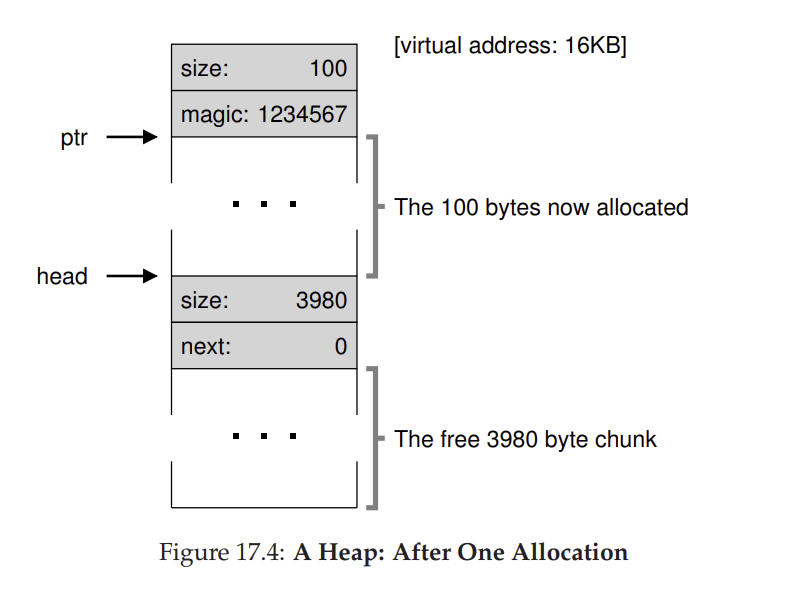
이런 요청이 3번 더 있었다면 어떻게 될까? 실제로 할당해주어야 할 free space는 2(100+8) byte이고 남는 free space는 3764 ( = 3980 - 2(100+8)) byte 인 것이다.
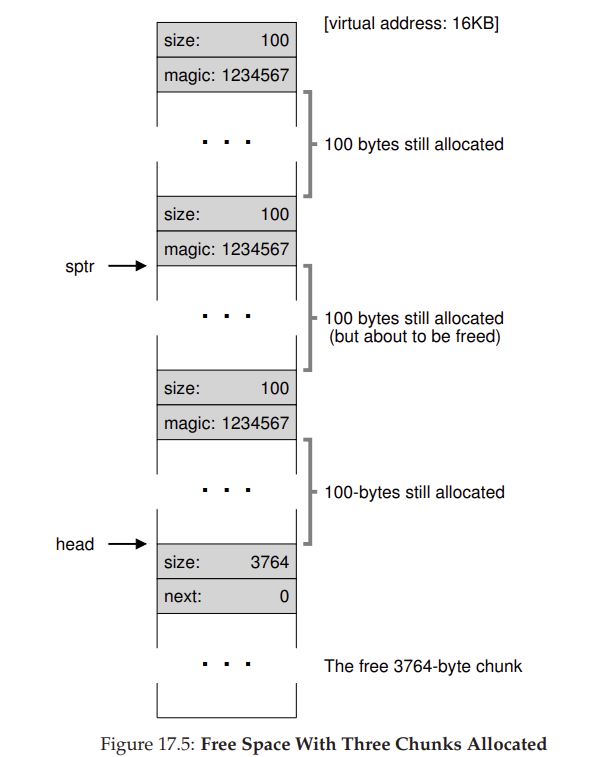
이제 그럼 free()가 일어난다고 해보자. 두 번째 allocated 영역을 free한다고 하면 이 영역의 시작 지점의 위치를 구해야 한다.
Virtual address space에서 heap의 시작 지점은 16KB (16$2^{10}$) 이므로 free되려는 영역의 시작 지점은 16500 = (16$2^{10}$ + 8 + 100 + 8)이다. 따라서 free(16500)을 하면 할당했던 영역이 다시 free space가 되는 것이다. 이때, free 되려는 영역의 시작 지점에서 allocated 영역의 header는 않았다. 왜냐하면 이 header는 free space node의 header가 되어야 하기 때문이다. Free()의 결과 diagram은 다음과 같다.
이제 남은 두 영역도 free 되었다고 하자. 그러면 실제로는 이어지지만 free list 안에 node가 여러 개가 생기게 된다.
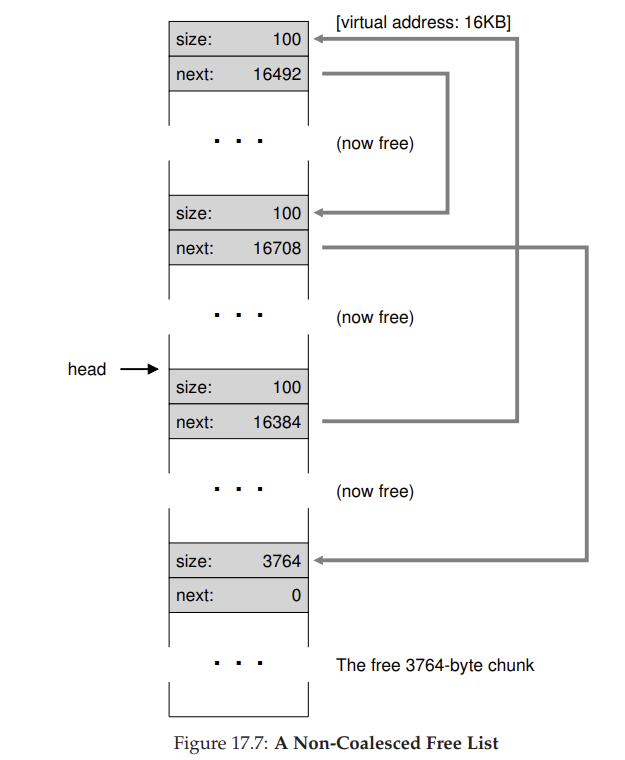
이때, coalescing을 적용하면 다시 하나의 free space, 하나의 node가 든 free list가 된다.
High Level Policy
이제 그럼 allocation의 policy에 대해서 알아보자.
Free list가 있고 malloc request가 들어왔다고 할 때, 여러 free space 중 어떤 free space을 할당해주어야 할까?
제일 이상적인 방법은 external fragmentation을 최소화하면서 속도가 빠른 방법이다. 하지만 이런 방법은 미래를 보지 못하기 때문에 존재하지 않는다..
기본적으로는 4가지를 사용한다.
Best Fit
Best fit은 request을 소화할 수 있는 free spcae 중 가장 작은 free space을 주는 것이다.
이 방법은 낭비를 최소화할 수 있는 대신에 최적의 free space을 찾는 과정에서 속도가 느려진다.
Worse fit
Worst fit은 줄 수 있는 free space 중에서 제일 큰 free space을 필요한만큼 분리해서 주는 방법이다.
Best fit은 엄청 작은 chunk을 여러개 남기는 대신에 worst fit은 적당한 크기의 chunk을 몇 개 남기는 방법을 선택한 것이다.
이 방법도 제일 큰 free space을 찾는 과정에서 속도가 느려진다.
First fit
First fit은 그냥 request을 소화할 수 있는 free space가 나오자마자 바로 할당해주는 것이다.
First fit은 더 검색을 하지 않기에 매우 빠르다. 하지만 free list의 초반 부분이 계속 쪼개질 확률이 높기 때문에 초반 부분이 더러워진다.
Next fit
Next fit은 first fit의 원리를 채용하면서 이전 malloc 요청에서 멈춘 곳을 기록하여 다음에는 그곳부터 시작해서 적절한 free space을 찾는 방법이다.
속도도 어느정도 빠르면서 exhaustive search을 막는 방법이다.
Segrated Lists
Segrated list는 자주 요청되는 크기의 메모리를 별도 list에 관리하여 allocation과 free을 빠르게 할 수 있도록 해준다. 하지만 자주 요청의 정도와 list에 몇 개의 메모리 크기를 기억하게 할 지를 결정해야 한다는 조건이 있다.
이 아이디어를 발전시킨 allocator로 slab allocator가 있다. Slab allocator는 kernel이 booting 될 때 lock, inode 등 자주 요청되는 kernel 객체들을 위한 object cache을 미리 생성하여 이 문제를 해결한다. 각 object cache는 하나의 segrated list이다. 특정 cache의 공간이 부족해지면 general allocator에게 추가 공간 (slab)을 받고, slab 내의 모든 객체의 reference count가 0이 되면 그 slab를 general allocator가 회수한다. 또, 한 object을 free 할 때 초기화된 상태로 유지하기 때문에 매번 초기화/삭제 과정을 반복해서 하지 않아도 된다.
Buddy Allocator
Buddy Allocator는 할당해야 하는 memory 크기보다 작아질 때까지 전체 free space을 2로 나누다가 적절한 크기를 찾으면 이를 할당한다.
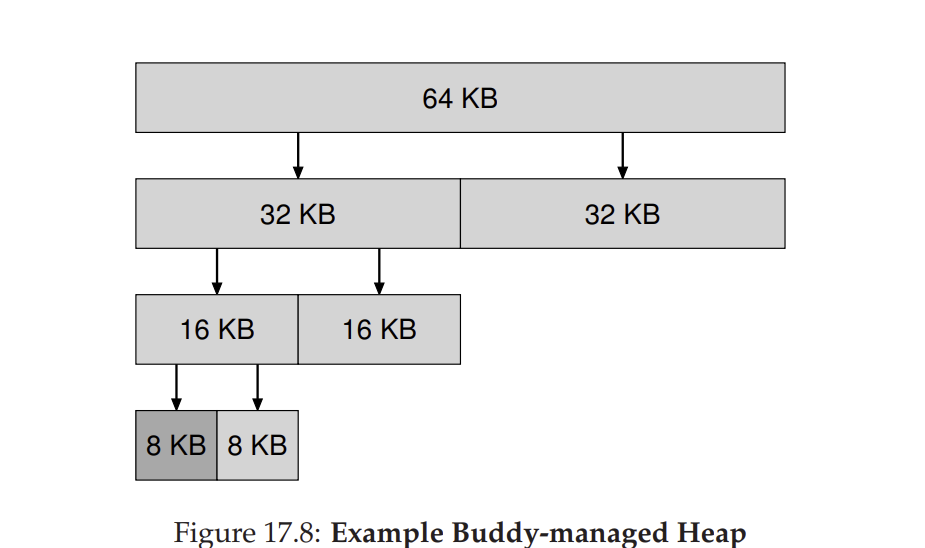
예를 들어 7KB을 할당해야 한다고 하자. 그럼 8KB가 나올 때까지 전체 free space을 2로 나누는 것이다. 그리고 8KB 하나를 할당해주는 방법이다.
이 방법은 간단하지만 $2^m$ KB의 memory 공간만 할당할 수 있다는 점에서 internal fragmentation (요청한 크기보다 더 할당하여 메모리 낭비가 생기는 문제)가 생긴다.
하지만 이 방법은 coalescing 할 때 매우 편리하다. 만약 할당한 8KB가 free 되었다면 coalescing 하기 위해 free된 영역의 buddy 8KB (2로 나눠서 생긴 동일한 크기의 영역)이 비어있는지 확인한 뒤, 비어있다면 합해서 다시 16KB로 만들면 바로 coalescing이 되는 것이다.