9: Segmentation
Segmentation
Base and bounds을 사용할 때 virtual address space 자체를 넣어야 한다. 이때 address space을 잘 살펴보면 heap과 stack 사이에 사용되지 않는 free 공간이 존재한다는 것을 알 수 있다.
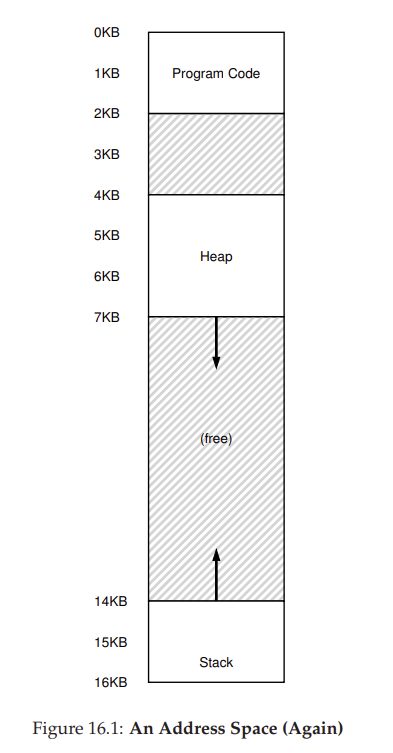
즉, base and bounds에서는 의미없는 free space까지 physical memory에 저장되기에 메모리 낭비 문제가 발생한다.
이런 낭비를 해결하기 위한 방법이 Segmentation이다. Segmenation의 기본 원리는 process마다 한 쌍의 base / bounds register을 저장하는 것이 아니라 process의 virtual address space의 각 logical segment마다 한 쌍의 base / bounds register을 저장하는 것이다. 즉, virtual address space의 단위로 physical memory에 저장하는 것이 아니라 logical segment 단위로 저장하겠다는 것이다.
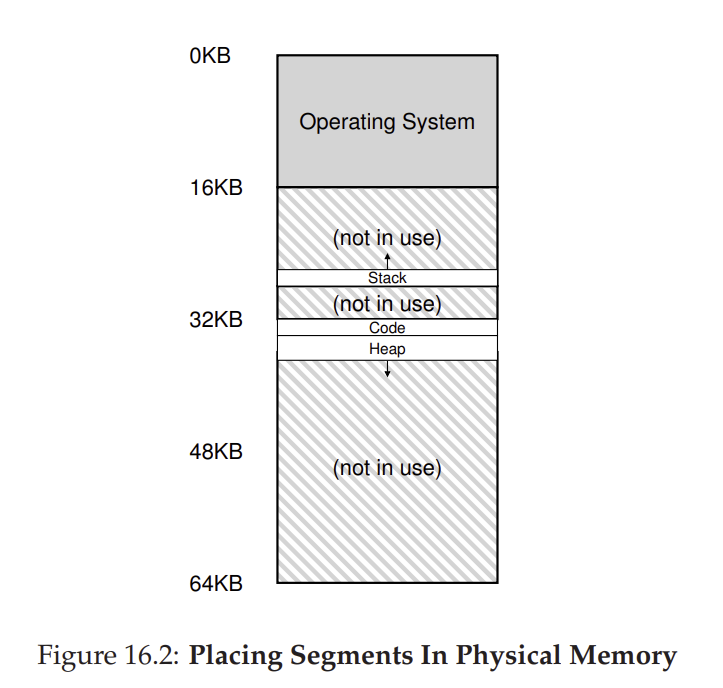
이때, logical segment란 code, stack, heap을 의미한다. 이 방법을 사용하면 code, heap, stack만 따로 저장하고 메모리 낭비를 일으켰던 free space는 저장이 안 된다. 또, 각 segment의 base와 bounds 값만 저장된다면 segment들이 독립적으로 저장될 수 있게 된다.
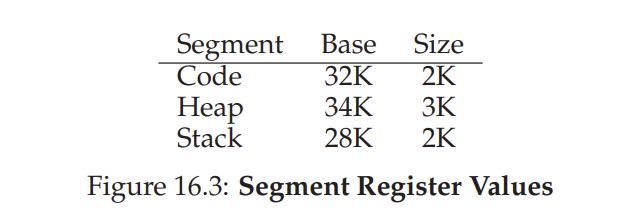
Segmentation을 하기 위해서는 각 process마다 3 쌍의 base / bounds 값이 MMU에 저장되어야 한다.
Address Translation in Segmentation
Segmentation을 적용했을 때 address translation은 어떻게 되는 것인지 알아보자
예를 들어 code segment에 존재하는 virtual address 100에 접근하고자 한다고 해보자. 그러면 Code의 base 값 32Kb ($32 * 2^10$) + 100으로 physical address의 32868번 주소에 접근하게 되는 것이다.
하지만 이처럼 모든 segment에서 간단한 것이 아니다. 예를 들어 heap segment에 해당되는 virtual address 4200에 접근하고자 한다고 해보자. 이때는 heap의 base 값 34KB + 4200을 하면 안 된다. 4200은 시작 위치를 기준으로 잰 거리지 heap segment의 시작 지점을 기준으로 잰 거리가 아니기 때문이다. 즉, segmentation을 사용하면 각 logical segment는 독립적으로 저장되기 때문에 virtual address가 해당되는 segment의 기준으로 생각해야 한다는 것이다.
이 이미지를 다시 보면 heap segment는 4KB에서 시작한다. 4200은 4096( 4KB = 4 * $2^10$)로부터 104 떨어져 있기 때문에 최종 address translation은 34KB + 104 = 34920이 된다.
만약 heap 영역 밖의 virtual address 7KB에 접근한다고 하면 어떻게 될까? Hardware는 이 접근이 bounds에 벗어난다는 것을 감지하고 exception (trap)을 발생시킬 것이다. 이런 문제를 segmentation fault라고 한다.
Virtual Address -> Which Segment?
이때 의문점이 드는것은 address translation 과정에서 virtual address 4200이라는 값이 주어졌을 때 이 주소가 어떤 segment에 해당되는지 어떻게 알아낼 수 있을까? 그리고 이 주소가 해당되는 segment로부터 얼만큼 떨어져 있는지 어떻게 알아내는 걸까? 이다.
이를 알아내는 방법 중 explicit approach는 virtual address을 bit으로 표현하여 어떤 segment에 해당되는지와 offset이 얼마인지 알아내는 방법이다.
예를 들어 현재 우리가 구별해야 하는 segment는 3개이다 (code, heap, stack). 3개를 구분하기 위해서는 2개의 bit만 필요하다. ($2^2$)
Virtual address가 14 bit으로 되어있다고 할 때 그럼 맨 앞의 2 bit는 segment을 구별하는 bit, 나머지 bit는 offset을 의미하는 bit가 된다.
Virtual address 4200을 예시로 들어보자
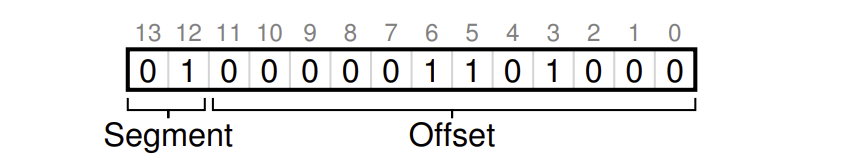
Code, Heap, Stack의 순서대로 virtual address의 크기가 커지므로 Code virtual address의 첫 두 bit는 00, heap는 01, stack은 10과 11이 될 수 있다는 것이다.
또, offset은 000001101000으로 정확히 64 + 32 + 8 = 104이다.
즉, hardware는 virtual address을 bit으로 표현함으로써 address translation을 수행하는 것이다. Hardware가 사용하는 workflow는 다음과 같다.
// get top 2 bits of 14-bit VA
Segment = (VirtualAddress & SEG_MASK) >> SEG_SHIFT
// now get offset
Offset = VirtualAddress & OFFSET_MASK
if (Offset >= Bounds[Segment])
RaiseException(PROTECTION_FAULT)
else
PhysAddr = Base[Segment] + Offset
Register = AccessMemory(PhysAddr)
Virutal address을 14 bit으로 표현한다는 전제 하에 SEG_MASK는 몇개의 bit로 segment을 표현할 것인지를 의미하기에 leftmost bit 2개의 정보를 얻어낼 수 있는 0x3000 = 11 $\mid$ 0000 $\mid$ 0000 $\mid$ 0000 으로 설정되고, SEG_SHIFT는 몇 번 shift해야 leftmost bit 2개가 나오는지를 의미하기에 (지금 상황에서는 12번) SEG_SHIFT = 12의 값을 가진다. OFFSET_MASK는 offset이 몇 개의 bit으로 표현되는 지를 의미하기에 하위 12 bit의 정보를 가져오는 0XFFF = 00 $\mid$ 1111 $\mid$ 1111 $\mid$ 1111 으로 표현된다.
What about Stack?
또 다른 의문점이 들 수 있는 것은 stack segment의 offset을 구할 때이다. Stack은 heap과 달리 위로 증가하기 때문에 offset이 양수면 stack의 증가 방향과 일치하지 않게 된다. 따라서, stack의 offset을 계산하는 경우에는 다른 방법을 사용해야 한다.
이처럼 logical segment마다 자라나는 방향이 다르기에 이를 표시하게 위해 추가 정보를 MMU에 저장할 수 있다.
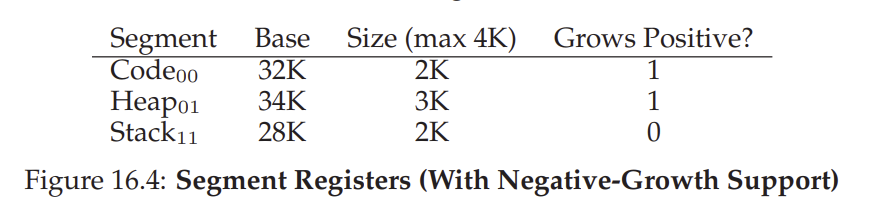
아무튼 그럼 stack에서는 offset을 어떻게 구할 수 있을까? 예를 들어 virtual address 15KB에 접근하고자 하였다고 해보자.
15KB = 15 * $2^10$ = 11 $\mid$ 1100 $\mid$ 0000 $\mid$ 0000 이다.
따라서 segment code는 11, offset의 값은 1100 $\mid$ 0000 $\mid$ 0000으로 3KB이다. 하지만 앞서 설명했다싶이 stack은 다른 segment와 반대 방향으로 자라나기 때문에 offset을 다르게 구해야 한다. 이를 구하기 위해서는 - (logical segment의 최대 길이 - 일반적으로 구한 offset) 을 통해 얼만큼 반대방향으로 왔는지 알 수 있다. Segment offset은 12 bit으로 표현되기 때문에 어떻게 보면 segment의 최대 길이는 12 bit $\rightarrow$ $2^{12} = 4 * 2^{10}$ 즉, 4KB으로 볼 수 있다. 따라서 최종 stack offset은 -(4KB - 3KB)으로 -1KB이다.
따라서 최종 address translation은 28KB - 1KB = 27KB으로 된다.
Support for Sharing
한 program을 여러 process으로 실행할 때, 동일한 코드를 실행하는 것과 동일하기에 code segment가 공유될 수 있다. 이렇게 공유가 가능해지면 메모리 효율이 더 높아진다.
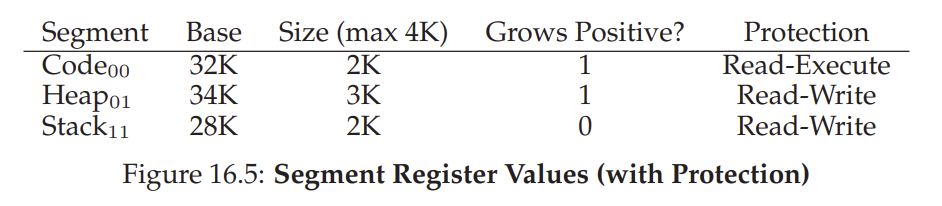
이런 sharing이 가능하도록 하기 위해서는 hardware의 도움이 필요하다. 즉, 특정 영역은 오직 read와 excecute만 가능하다는 표시만 할 수 있다면 특정 영역들이 공유가 가능해진다. 이 표시 정보를 protection bit라고 한다. 즉, protection bit가 1이라면 read execute만 할 수 있어 share가 가능하고 0이라면 read write execute 모두 가능한 영역이라고 볼 수 있다.
Fine grained vs Coarse grained Segmentation
Segmentation을 지금까지 logical segment 단위로만 나누었지만 사실 더 작은 단위로 나눌 수 있다. 이렇게 더 많은 segment으로 나누는 것을 fine grained segmentation이라고 한다. Segment가 많아질수록 더 많은 정보를 MMU에 저장해야 하기에 더 많은 hardware support이 필요하다. 이를 segment table이라고도 부른다.
OS Support needed for Segmentation
OS는 우선 각 segment base / bound 값들을 register에 저장하고 context switch가 일어날 때마다 갈아끼워야 한다.
또, 새로운 process가 만들어질 때, OS는 그 process의 각 segment들이 어디에 저장될 지 정해야 한다. Base and bounds에서는 모든 virtual address space의 크기가 동일하다는 가정이 있었기에 slot처럼 관리하면 됐었지만 Segmentation에서는 logical segment 단위로 저장을 하기에 더 복잡해진다.
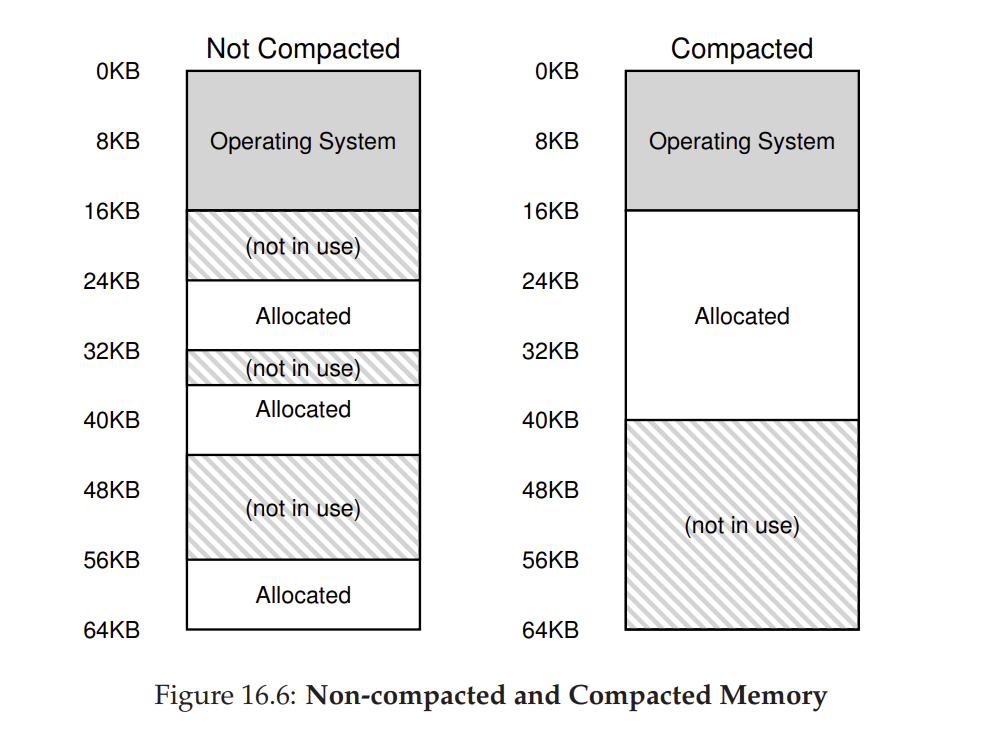
즉, Base and bounds에서는 오른쪽 그림처럼 compact하게 저장될 수 있지만 Segmentation에서는 저장되는 단위의 크기가 제각각이기에 크기가 잘 들어맞지 않는다면 physical memory에서 구멍이 숭숭 뚫린 것처럼 빈 공간이 생겨날 수 있다. 이 현상을 external fragmentation이라고 한다. 이 현상은 매우 심각하다.
예를 들어 physical address space가 10KB $\mid$ 할당된 공간 $\mid$ 10KB처럼 생겼다고 해보자. 그리고 이제 15KB의 segment을 저장해야 한다고 해보자. 전체 빈 공간의 크기는 20KB임에도 불구하고 external fragmentation으로 인해 구멍이 생겨서 15KB의 segment을 저장할 수 없게 된다.
이런 문제의 해결책은 physical memory에 존재하는 segment들을 다시 조율해서 compact하게 저장되도록 바꾸는 것이다. 하지만 이 과정은 비용이 매우 크고 오래 걸린다.
이보다 더 간단한 방법은 Free Space Management 방법을 사용하는 것이다.