Chatper 3 Transport Layer 정리 이어서
User Datagram Protocol
UDP Services
UDP가 제공하는 services들을 알아보자.
-
Process to process communication
UDP는 IP address와 port number을 합친 socket address을 통해 process to process communication을 가능하게 한다.
-
Connectionless services
UDP에서는 datagram이 독립적이고 순서가 없다. 또, 별도의 connection establishment나 termination 과정이 필요없다.
이 특징은 delay가 되면 안되거나 짧은 요청/답변만 원할 때 유리하다. 또, 순서가 중요하지 않은 서비스에서도 선호된다.
반대로 긴 요청/답변이 필요할 때는 UDP을 쓰게 되면 message가 여러 packet에 나뉘어 들어가게 된다. 하지만 UDP는 순서 정보를 포함시키지 않기 때문에 receiver 측에서 이 message을 합칠 수 없게 된다.
-
Flow Control
UDP는 flow control 과정이 없어서 window mechanism도 사용하지 않는다. 따라서 receiver가 받는 데이터가 많아지면 overflow가 된다.
-
Error Control
Checksum을 사용하는 것 제외하고 별도의 error control을 하지 않는다. Sender는 보낸 정보가 lost/duplicate 되었는지 인지를 못한다.
반면 receiver는 checksum을 통해 error을 감지하면 그냥 그 packet을 discard한다.
이때 checksum은 16 bits이다.
이런 이유로 UDP는 unreliable service라고 불리는 것이다. UDP는 보내기만 하기에 네트워크 상황에 따라 수신 측에 message가 도착하는 시간 간격이 일정하지 않다. 이를 uneven delay라고 한다.
하지만 이런 특징이 항상 나쁜 것은 아니다. 예를 들어 real time interactive application의 경우, corrupted/lost frame을 탐지하고 재전송을 요청하고 또 처리한다고 하면 서비스에 delay가 누적될 것이다. 하지만 UDP는 이런 error을 무시하기에 real time application에 적합하다.
-
Congestion Control
UDP는 connectionless이기에 congestion control을 하지 않는다. UDP는 packet이 작아서 congestion을 유발하지 못한다는 가정 하에 작동하기 때문이다.
-
Encapsulation and Decapsulation
Message을 한 process에서 다른 process에 보내기 위해서 encapsulation / decapsulation을 수행한다.
-
Queuing
Receive / Send queue을 사용한다.
-
Multiplexing and demultiplexing
하나의 UDP만 있는데 여러 process가 그 UDP을 사용하고 싶을 때, multiplexing과 demultiplexing이 필요하다.
TCP Services
TCP Service의 특징은 다음과 같다.
-
Byte Stream Oriented
TCP는 두 process가 tube로 연결되어 있다는 가정 하에 Input과 Output을 stream of bytes으로 간주한다. Sender와 Receiver 측에서 이 정보들을 받고 보내기 위해서 buffer을 사용한다. 이 buffer는 꼭 동일한 사이즈가 아니여도 된다.
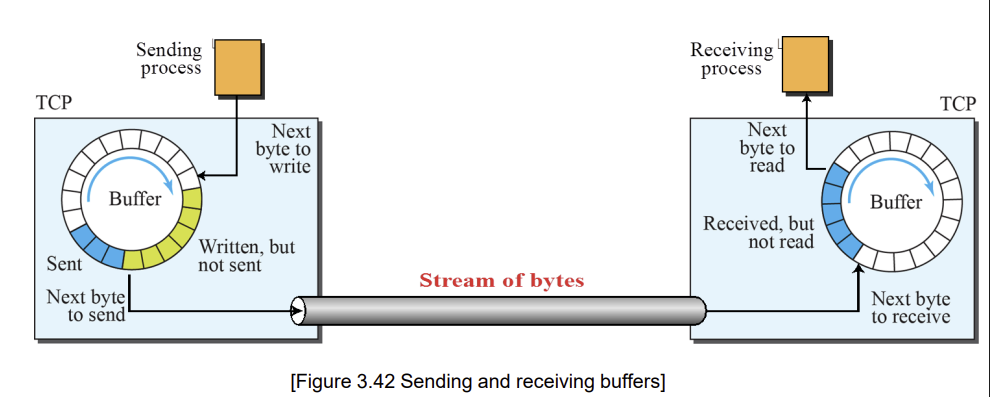
TCP는 bytes들을 segment라는 packet에 담고 각 packet에 control을 위해서 header을 추가한다.
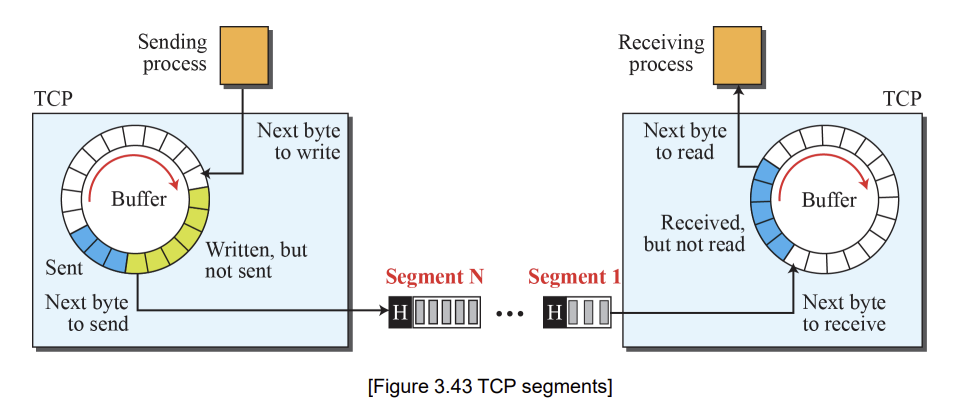
각 byte들과 segment는 또 number가 주어진다. 특히 segment에는 sequence number가 주어지는데 이 숫자는 보내는 byte에 할당된 number이고 Initial Sequence Number (ISN)이라고 한다. 범위는 ($0 - 2^{32}-1$) 이다.
TCP에서 5000 bytes을 전송하고 있다고 할 때, 첫 byte의 number가 10001이라고 해보자. 그럼 각 segment가 1000 bytes을 담고있다고 할 때 sequence number는 각 몇일까?
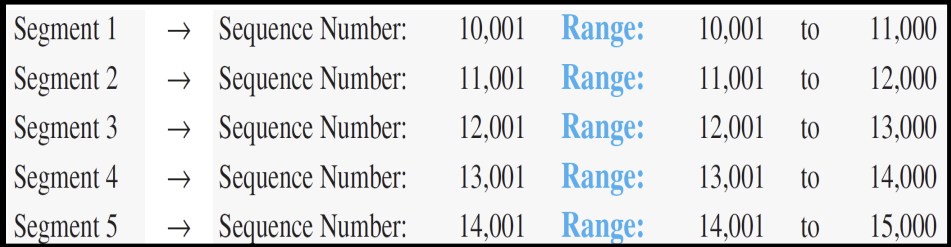
첫 번째 segment의 sequence number는 첫 byte의 number이어야 하기에 10001이 되고 각 1000 bytes을 담고있으므로 segment마다 sequence number가 1000씩 늘어난다.
-
Full Duplex Communication
-
Multiplexing and Demultiplexing
-
Connection-Oriented Service
-
Reliable Service
-
Acknowledge Number
Receiver/Sender는 acknowledge number을 통해 받은 bytes을 확인한다. 이 number는 보통 다음에 받아야 하는 byte의 번호를 의미한다.
TCP Segment
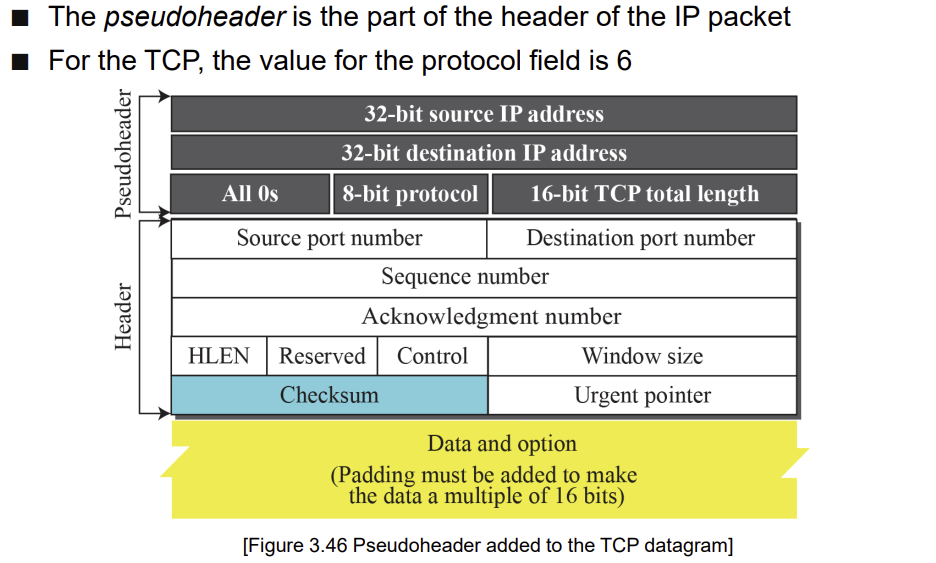
TCP의 Segment의 구조를 더 세분화하면 다음과 같다.
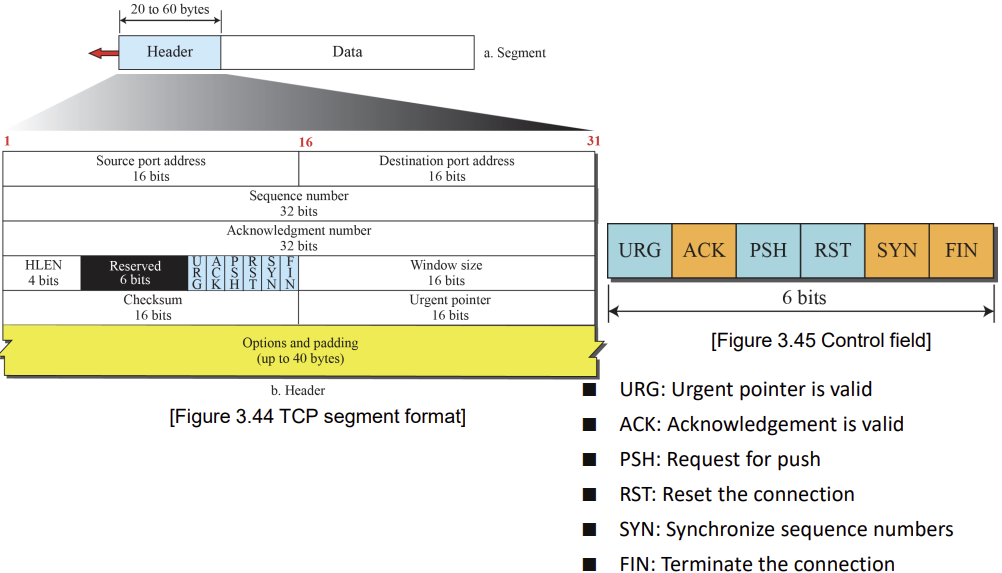
TCP의 header 크기는 UDP와 다르게 고정된 크기를 갖지 않는다. 또, 6 bit의 control field을 가지고 있다.
여기에 IP packet의 header인 pseudoheader까지 들어간다.
TCP Connection
TCP는 Connection oriented service이기에 connection 방법이 중요하다.
TCP Connection Establishment
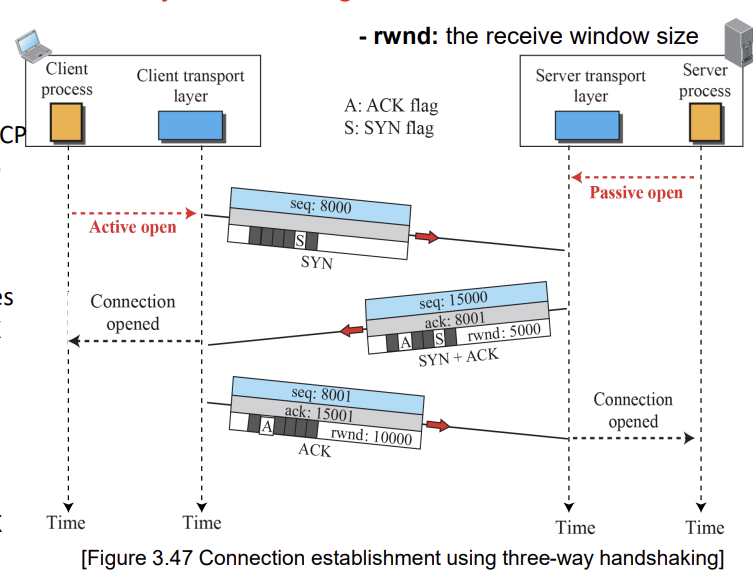
우선 Connection establishment 과정을 보자. TCP는 Three way handshaking을 통해 conneciton을 생성한다.
-
우선 Server가 passive open이 되어있을 때, Client는 server에 SYN segment을 전송하여 active open을 시도한다. 이때, 이 segment 내에는 data는 없다.
-
Server가 SYN을 받으면 SYN + ACK, 그리고 받을 수 있는 window size 정보인 rwnd 값을 준다.
-
Client는 그럼 다시 ACK segment으로 답장을 하고 자기의 rwnd 값도 준다.
이 세 과정이 수행되어야 client와 server 간의 connection establishment가 성공한다.
Data Transfer
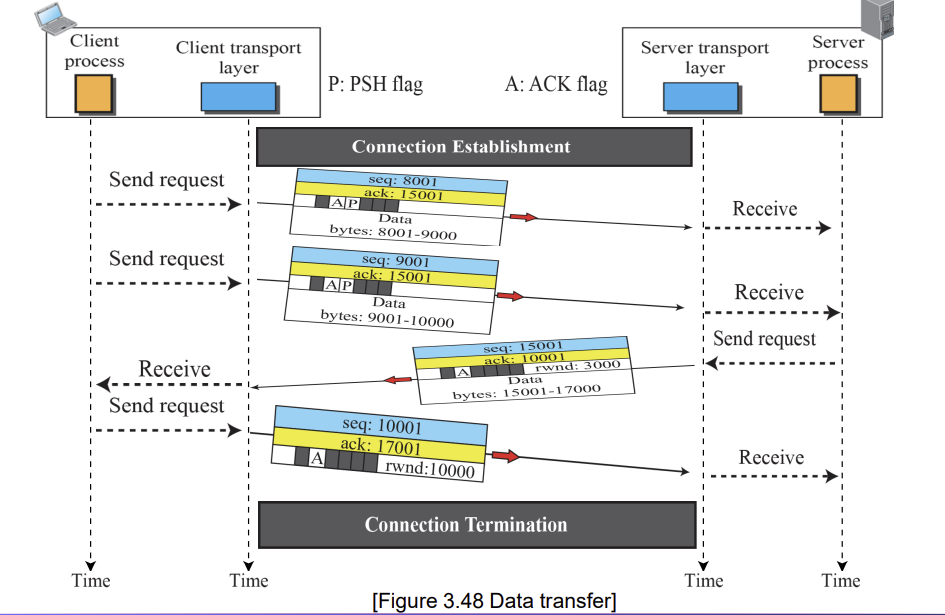
서버의 RWND 값이 5000 이라고 하자.
Seq: 8001에서 시작해서 1000 byte의 data을 보냈다. 그러면 다음 packet의 sequence number는 9001 (8001 + 1000)이 된다. 그리고 나서 또 1000 byte을 보냈다고 하자.
서버가 client에 request을 보낼 때, 남은 receive buffer 크기인 5000 - 2*(1000) = 3000 과 함께 seq 15001에 해당하는 packet을 보낸다. 그 이유는 client에서 packet을 보낼 때, 다음에 받아야 하는 packet의 sequence number인 ACK을 15001로 보냈기 때문이다.
이런 과정을 통해서 서버와 client끼리 정보를 교환한다.
이때, Client가 P bit을 활성화하고 데이터를 보낸 것을 볼 수 있다. 원래 TCP는 받은 data을 바로 process에게 보내지 않고 process가 준비될 때까지 기다리다가 보내준다. 하지만 가끔 이런 delay를 하면 안되는 데이터에는 이 P flag을 활성화시켜서 보낸다. 이 flag는 PSH(push) flag으로 도착하자마자 바로 process에게 전달되도록 해준다.
Connection Termination
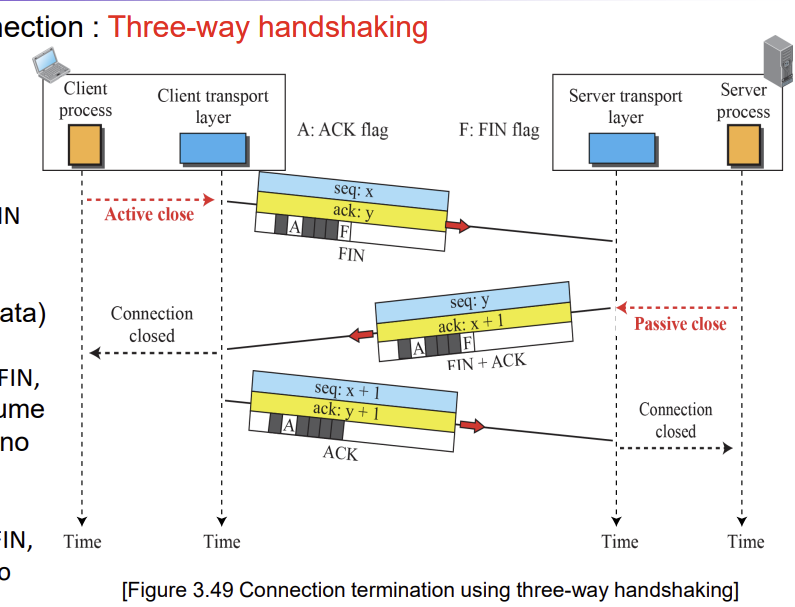
Connection을 terminate 하기 위해서는 client가 TCP FIN control segment을 서버에 보내서 active close을 활성화한다.
서버는 그럼 FIN과 ACK까지 같이 response을 보낸다. 그럼 client는 다시 ACK packet을 보내고 connection이 종료된다.
이때, Half close 상황도 있다. Half close에서는 server는 client에게 data을 계속 보낼 수 있지만 client는 ACK만 보낼 수 있게 되는 상황이다.
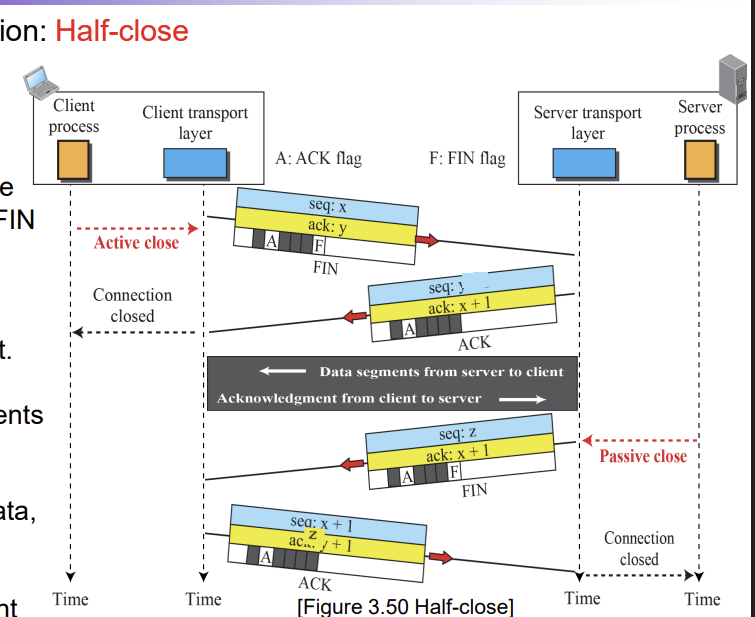
이런 기능은 상대방이 아직 보내는 중인 남은 데이터는 연결을 끊지 않고 끝까지 안전하게 다 받기 위해서라고 생각하면 된다. 차이점은 server가 client의 active close response으로 FIN이 아니라 ACK만 전송한다는 것이다.
TCP Window
TCP에서 client, server은 모두 전송용 window와 받기용 window을 사용한다. 따라서, 총 4개의 window을 사용한다.
Send window
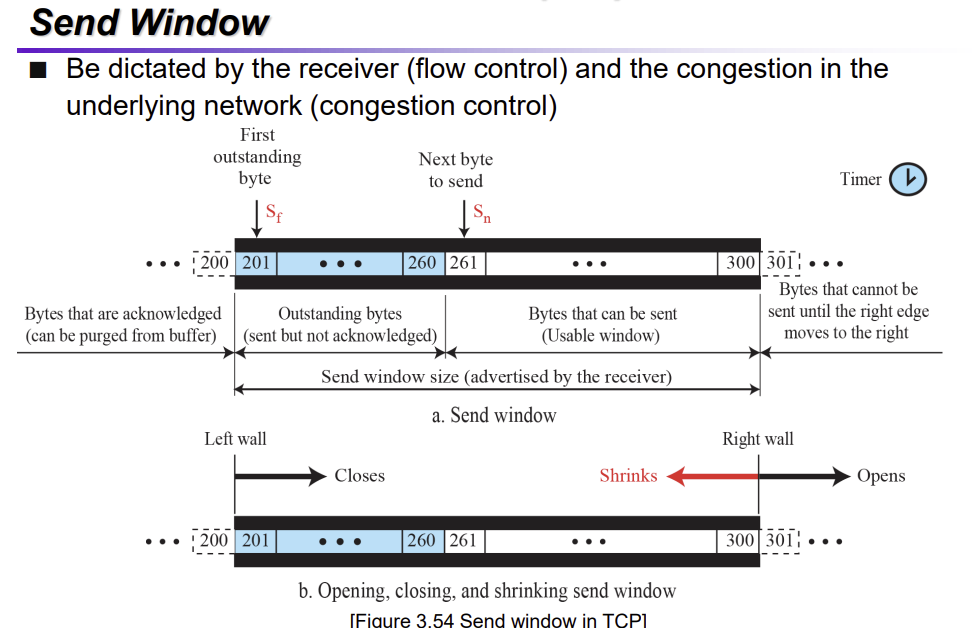
Send window는 보냈지만 ACK가 되지 못한 것 (outstanding bytes)과 아직 보내지 못한 bytes으로 나뉜다. 이때 ACK 되지 못했다는 것은 receiver 측에서 다 완전히 받았다는 response을 받지 못한 상태인 것이다.
Send window의 범위는 그래서 ACK number부터 ACK number + RWND까지 제한된다.
- Receiver로부터 ACK을 받을 때마다 left wall은 오른쪽으로 이동할 수 있게 되고 그럼 보낼 수 있는 데이터가 많아지므로 right wall도 오른쪽으로 이동하게 된다. $\rightarrow$ Left wall shrink, right wall open
Right wall도 shrink 할 수 있지만 권장되지 않는 기능이다.
Receive Window
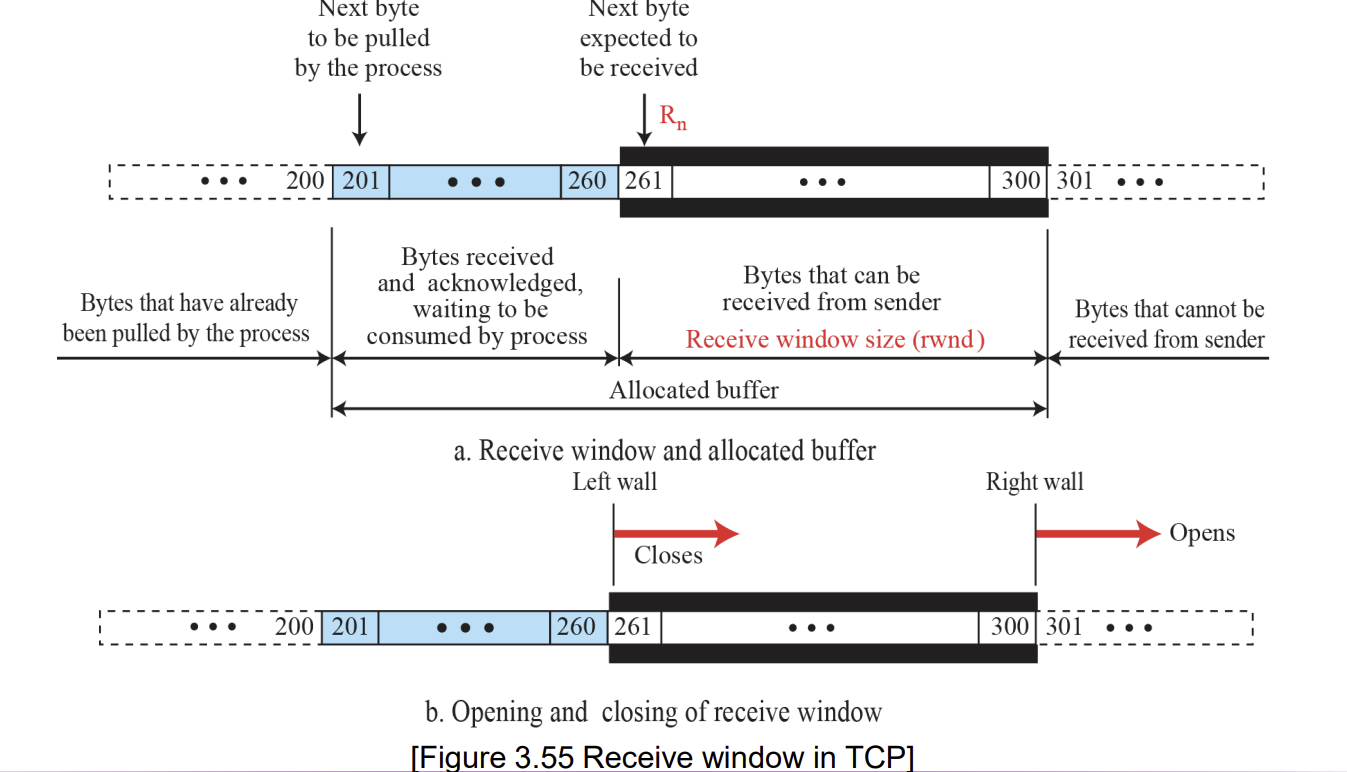
Receive window는 다음에 받아야 하는 부분부터 RWND 크기만큼의 영역이다. 이 영역의 이전 byte들은 ACK을 보내고 process가 가져갈 때까지 보관되는 곳으로 receive window을 구성하지 않는다. 하지만 이 부분은 buffer을 구성하기 때문에 RWND 값을 알아내기 위해서는 buffer 크기에서 ACK가 이미 보내진 영역의 크기를 빼야 한다.
-
데이터를 새로 받을 때, left wall은 오른쪽으로 이동한다. $\rightarrow$ left wall close
-
Process가 buffer에 쌓인 데이터를 읽어갈 때, right wall은 오른쪽으로 이동한다. $\rightarrow$ right wall open
Flow Control
Flow control은 receiver가 sender로부터 받는 데이터 양을 조절하는 방법이다. TCP에서 window는 flow control 기능과 관련성이 높다.
Receive window에서의 flow control
Sender로부터 data가 너무 많이 오게 되면, TCP는 receive window의 left wall을 오른쪽으로 움직이도록 하고 process에 의해 데이터가 읽히면 right wall을 오른쪽으로 움직이게 한다.
Sender window에서의 flow control
Sender window을 receiver의 RWND 크기 안에서만 전송하도록 조절하여 flow control을 수행한다.
예를 들어, receiver로부터 ACK가 올 때만 left wall을 오른쪽으로 움직이게 한다 (다음에 보내야 하는 데이터만 찾아내도록). 이런 경우에 right wall은 움직이지 않는다. 왜냐하면 아직 receiver의 process가 data을 다 읽지 않았기 때문에 데이터를 더 보내면 안되기 때문이다. 그래서 결국 다음 식이 만족한다. (new rwnd가 ackNO가 늘어난만큼 줄어듦)
\[\text{new ackNO + new rwnd = last ackNO + last rwnd}\]Receiver의 process가 data을 다 읽어서 receiver가 자기의 여유 공간인 RWND을 다시 보내줄 때만 right wall을 오른쪽으로 움직여서 더 보낼 데이터를 준비한다.
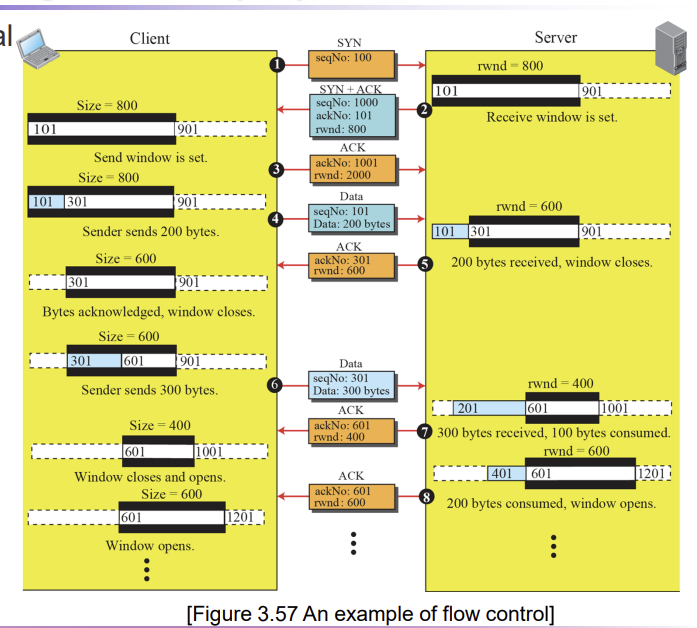
\[\text{new ackNO + new rwnd > last ackNO + last rwnd}\]다음은 unidirectional communication을 가정하고 Client -> Server의 opening and closing window 과정을 보여준다
-
1,2,3: connection establishment 과정이다. Client가 SYN을 보내고 server는 자신의 rwnd을 보낸다.
-
4,5: 그로 인해 sender인 client의 send window 크기는 800이 된다. 그 다음 200 byte을 보냈을 때, server는 rwnd 중 200이 차므로 rwnd가 800-200 = 600으로 바뀐다. 받은 데이터에 대한 ACK을 client에 보내면 TCP의 flow control 로직으로 인해 sender window의 left wall만 200만큼 close되고 send window의 크기가 receiver (server)의 rwnd와 일치하게 된다.
-
6,7: Sender가 이제 300 byte을 보내면 server의 여유공간인 rwnd는 300만큼 더 줄어든다. 이때, process가 100 byte을 소모하면 rwnd는 100만큼 늘어나기에 결과적으로 rwnd 값은 600-300+100 = 400이 된다. 이 정보를 다시 sender인 client가 받게 되면 300만큼 ACK을 받았기에 left wall은 300만큼 오른쪽으로 close하고 rwnd 값이 늘었기 때문에 (300 -> 400) right wall은 오른쪽으로 100만큼 open한다.
-
8: 추가 데이터는 안 받았는데 process가 consume을 200만큼 더 해서 rwnd 값이 200만큼 늘어서 다시 600이 된다. 이 rwnd 값을 sender가 받게 되면 또 right wall이 200만큼 open된다.
Shrinking Window
Send window의 right wall은 특수한 상황에서 shrink할 수 있다. 예를 들어 receiver가 rwnd와 ackNO을 sender에게 보냈다고 하자. 그리고 Sender가 이 rwnd 값을 바탕으로 receiver에게 data을 보냈다고 하자. 하지만 그 과정에서 receive 측의 rwnd가 어떤 이유로 인해 줄어들었다고 하자. 이런 상황에서 receiver는 받을 수 있는 용량보다 더 많이 데이터를 받게 되어 초과된 데이터는 discard된다.
따라서 TCP는 이런 문제를 예방하기 위해서 rwnd 값이 충분히 크기 전에는 sender에게 rwnd 값을 알려주지 않거나 아예 rwnd 값을 0으로 보내서 데이터를 전송하지 못하도록 막는다.
Error Control
Acknowledgment
Error control에는 ACK 값이 사용된다. 사실 ACK에는 두 종류가 존재한다.
-
Cumulative Acknowledgement: receiver가 받고싶어하는 첫 byte을 가리킨다.
-
Selective Acknowledgement (SACK): SACK는 ACK을 대체하지는 못하고 중복된 bytes나 out of order bytes 정보를 추가적으로 알려주는 역할을 한다.
Cumulative Acknowledgement의 장점은 자동으로 lost ACK을 고칠 수 있다는 것이다.
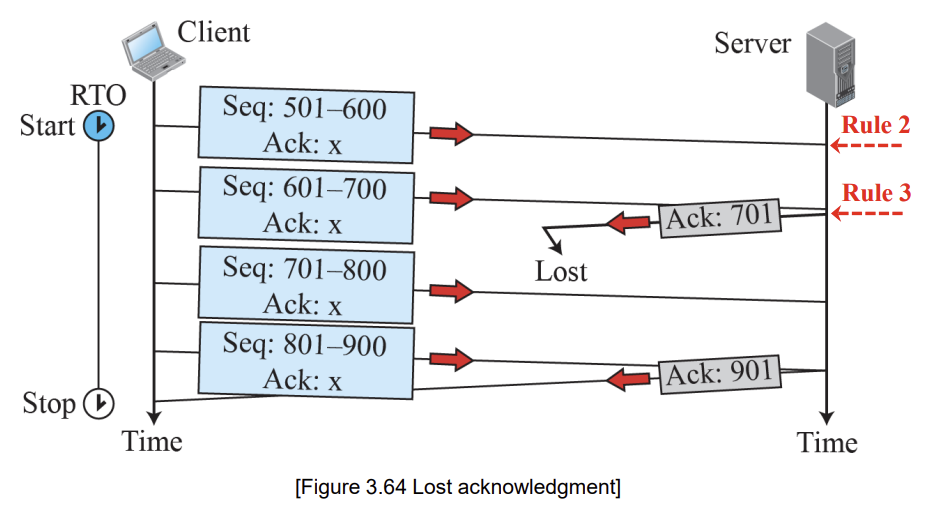
ACK 701을 보냈는데 유실되었는데 그 와중에 701-900이 오면 ACK는 누적값을 보내기 때문에 다시 ACK 701을 보내는 것이 아니라 ACK 901으로 고쳐서 보내서 자동으로 고친다.
ACK 설정하는데 지켜야 하는 rule이 존재한다.
-
Sender는 반드시 ACK을 data segment에 포함해야 한다.
-
Segment가 하나만 왔다면, 바로 ACK을 보내지 않고 delay 한다 (timer). 이로 인해 network 전체적으로 존재하는 ACK segment을 최대한 줄인다
-
이미 받은 segment가 하나 있는데 더 받았다면 그때는 바로 ACK을 보낸다
-
받아야 하는 segment보다 나중 순서 segment가 왔을 때는 받아야 하는 segment가 유실되었다고 가정하고 바로 ACK을 다시 보내서 유실된 것을 다시 보내달라고 요청
-
유실되었던 segment가 왔을 때 바로 새로운 누적 ACK을 보내서 sender가 보내는 정보를 줄인다.
-
중복 segment가 왔다면 이전에 receiver가 보냈던 ACK가 유실되었다는 것이기에 다시 ACK을 보내서 중복 segment을 다시 보내지 않도록 막는다.
Retransmission
RTO
Sender는 보낸 segment가 유실되었는지 판단하기 위해서 timer을 사용한다. 한 segment을 보낸 뒤에 timer가 끝날 때까지 ACK을 받지 못했다면 해당 segment을 다시 보내는 것을 retranmission time out (RTO)라고 한다. RTO는 round trip time을 바탕으로 update 된다.
Three duplicate ACK segments = fast retransmission
한 Segment에 대해 three duplicate acknowledgement가 온다면 다음 segment가 유실되었다고 가정하고 다음 segment을 timeout까지 안 기다리고 바로 다시 보낸다.
Error control 과정을 시나리오 별로 이해해보자
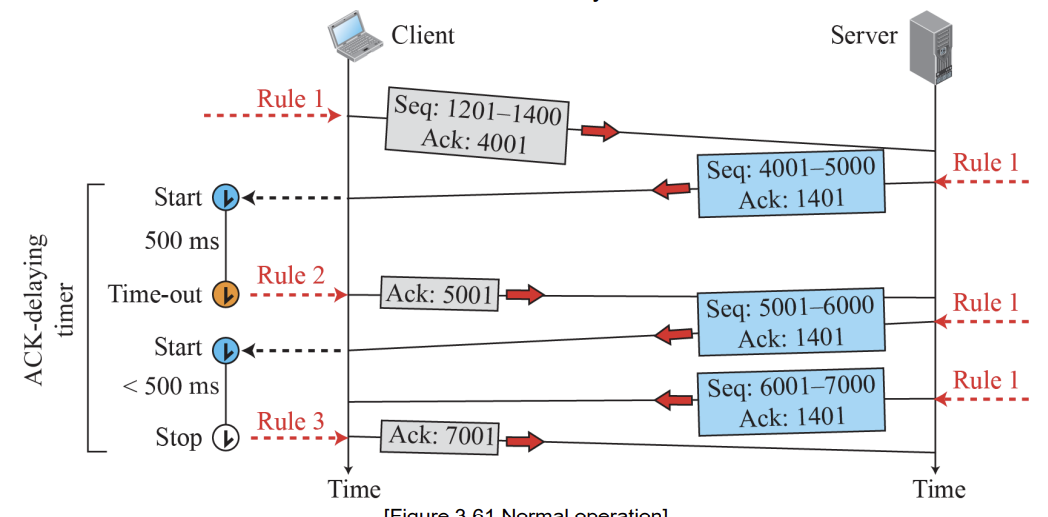
Client을 중심으로 보자. Client는 하나의 segment을 받았을 때 rule 2에 의해 바로 ACK을 보내지 않고 timer동안 delay을 한다. 그 시간동안 추가적인 segment가 오지 않았기에 이 segment에 대한 ACK을 보낸다.
다음에는 segment을 timer 안에 두개를 받아서 이때는 rule 3에 의해 바로 ACK을 보낸다.
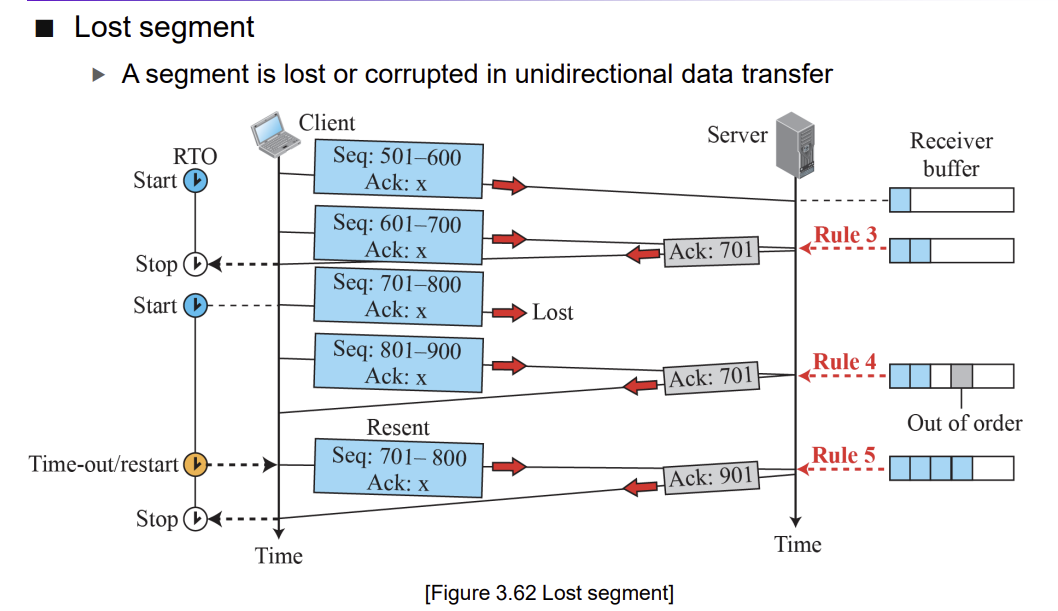
Server을 중심으로 보자. Segment가 두 개 연속으로 왔을 때 rule 3에 의해 바로 ACK을 보낸다.
그 다음에 701을 요청했는데 801-900을 받았을 때 server는 out of order segment을 받았기에 rule 4에 의해 바로 ACK 701을 보내서 오류를 고치도록 한다. 또, 701-800을 받았을 때, rule 5에 의해 이전에 out of order segment을 받은 적이 있기에 ACK 801을 보내는 것이 아니라 그 이후 segment인 901을 요구한다.
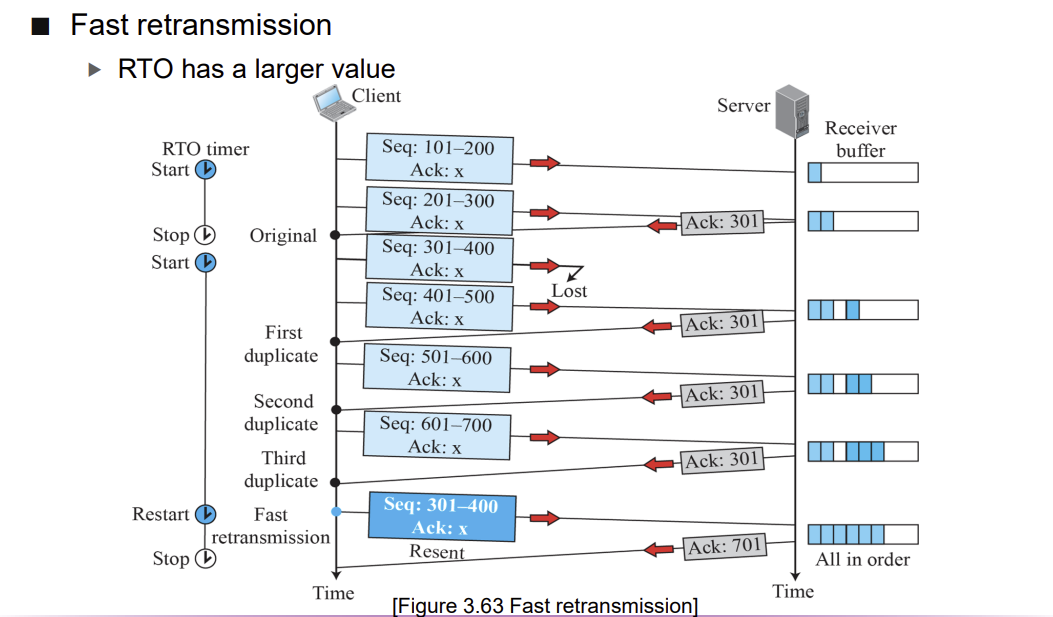
Client 입장에서 보자. Client을 보면 301-400을 보냈는데 유실되어 server는 401-500, 501-600, 601-700을 보냈음에도 ACK 301을 세번 연속 받았다. 그래서 fast retransmission을 발동시켜서 301-400을 바로 다시 보냈다.
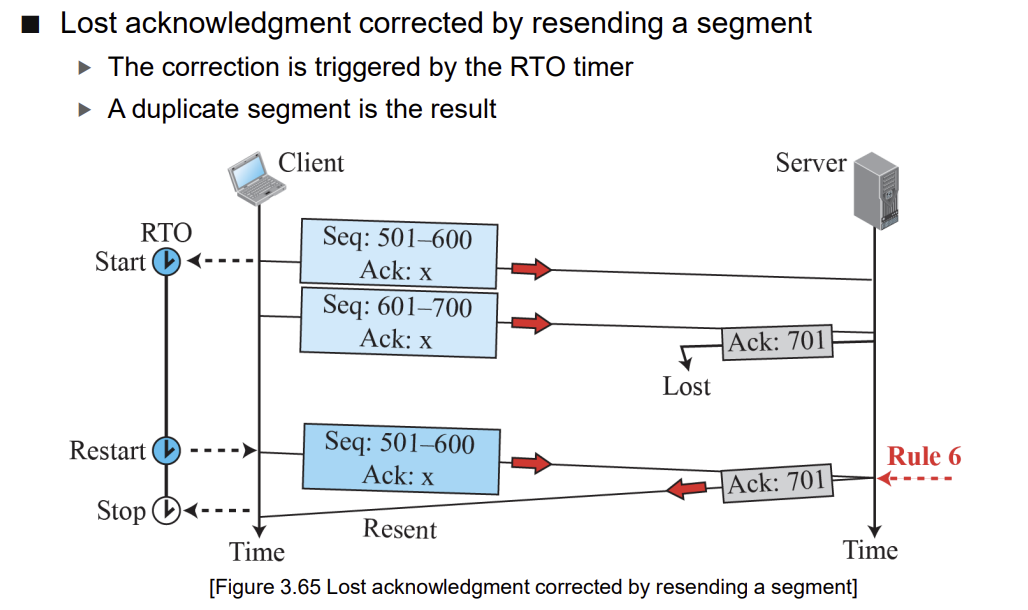
501-600, 601-700 두 개를 받아서 바로 ACK 701을 보냈는데 유실되었다. Sender 측은 보낸 segment에 대한 ACK을 timer가 끝날 때까지 받지 못해서 다시 retransmission을 하는데 receiver 측에서는 이미 받은 segment이기에 rule 6에 의해 바로 ACK을 보내서 중복 segment 전송을 막는다.
Congestion Window
각 TCP host에는 congestion이 없지만 그 중간에는 congestion이 존재할 수 있다. TCP가 보내는 rwnd 값은 오직 자기가 받을 수 있는 용량을 알려주는 것이고 전체적인 network에 보낼 수 있는 용량을 알려주는 것이 아니기 때문이다.
TCP는 이런 congestion 정보를 얻기 위해 congestion window cwnd을 사용한다. 이 크기는 network에 존재하는 congestion에 따라서 결정된다.
TCP는 더 효과적인 flow control을 위해 send window의 크기를 더 세밀하게 조절하기 위해서 cwnd 값까지 활용해서 send window 크기를 결정한다.
\[\text{min (rwnd, cwnd)}\]TCP는 congestion 정보를 간접적으로 얻기 위해서 timeout과 three duplicate ACK 정보를 통해서 알아낸다. TCP는 timeout은 congestion이 존재한다는 확실한 증거이고 three duplicate ACK는 network가 살짝 congest 되어서 보냈던 segment가 유실되었거나 이제 막 congestion에서 회복한 상태라고 본다.
Slow start
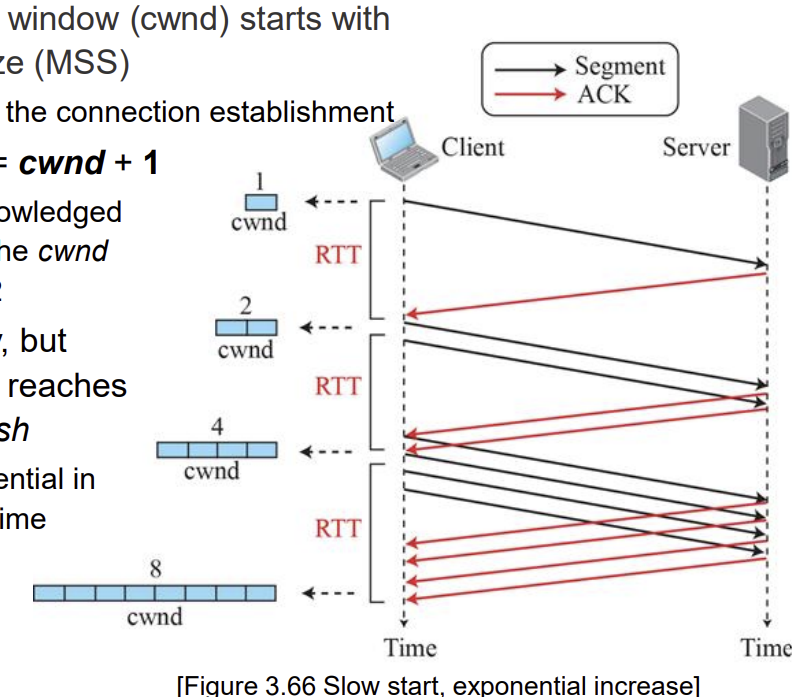
우선 TCP가 connection에 연결되었을 때 네트워크에 보낼 수 있는 데이터양을 가늠하는 방법을 알아보자. 이 방법을 slow start이라고 한다. 처음에는 network의 혼잡도를 알지 못하기에 얼만큼의 data를 보낼 수 있는지 실험해보는 단계라고 보면 된다. cwnd = 1에서 시작해서 하나의 segment을 보냈을 때 이에 대한 ACK가 제대로 왔을 때는 보내는 양을 2배씩 늘려간다.이때, ACK가 누적 ACK라서 1,2를 보냈는데 ACK 3만 왔다면, cwnd는 1만 증가해야 한다.
Congestion Avoidance
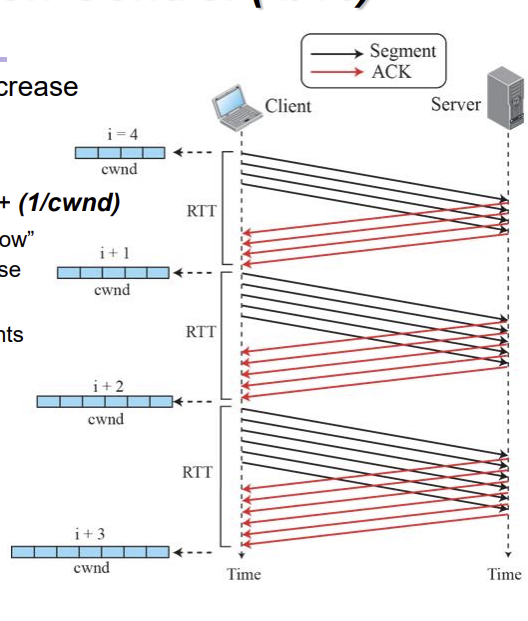
이처럼 2배씩 늘려가면서 실험을 하는 것은 cwnd값이 ssthresh라는 임계치에 도달했을 때까지이다. cwnd가 ssthresh보다 커지면 그때부터는 congestion 위험이 생길 수도 있어서 exponential 실험을 줄이고 additive으로 cwnd 값을 늘린다.
ACK가 들어올 때마다 $\text{cwnd} = \text{cwnd} + \frac{1} {\text{cwnd}}$ 만큼만 증가하게 하는 것이다. 즉, 보낸 만큼의 ACK을 RTT동안 다 받아야지 cwnd 값을 1씩 올리는 것이라고 볼 수 있다. 이 과정을 congestion이 실제로 탐지될 때까지 반복한다.
Congestion Policies
이렇게 cwnd 값을 늘리다가 congestion이 실제로 발생했을 때, cwnd 값을 상황에 맞게 다르게 설정해야 한다. 이 설정을 결정하는 것이 policy transition이다.
-
Taho TCP
Taho TCP에서는 timeout, three duplicate ACK가 발생했을 때 모두 cwnd 값을 1로 설정한다. 그리고 그때마다 ssthresh 값은 $\frac {\text{cwnd}} {2}$ 로 설정한다.
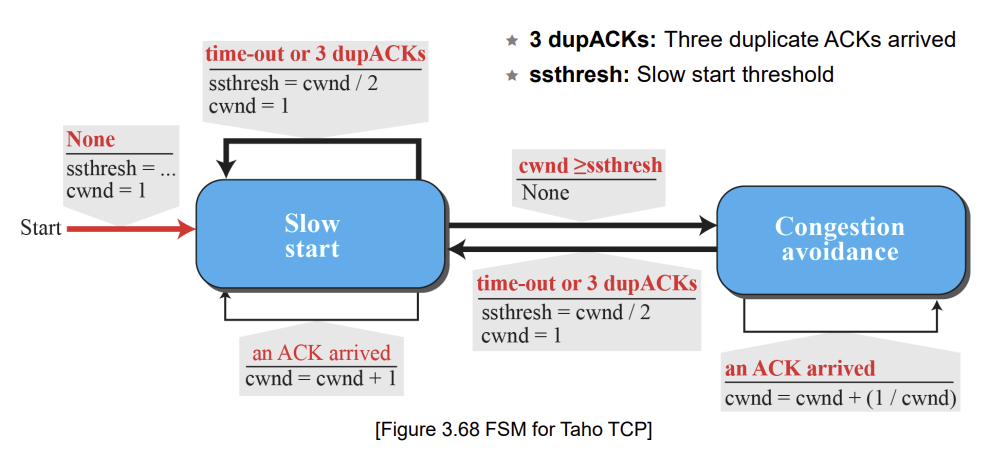
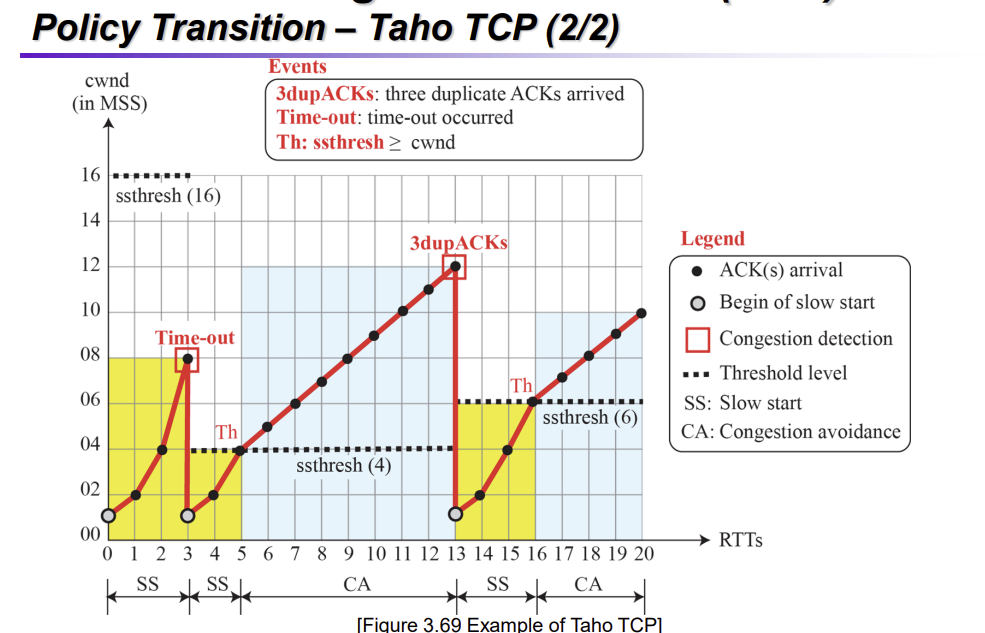
처음에는 slow start을 하다가 t=3, cwnd = 8 일 때 timeout이 나자 ssthresh = 4, cwnd = 1이 된다. 이때 cwnd 값이 ssthresh보다 낮기 때문에 다시 slow start가 되다가 ssthresh보다 커지게 되어 t=5에서 congestion avoidance가 시작되는 것을 볼 수 있다. t=13에서 3dupACKS가 발생했을 때에도 똑같이 ssthresh은 그때의 값의 절반인 12/2=6이 되고 cwnd은 1이 된다.
-
Reno TCP
Reno TCP는 three duplicates ACK가 발생할 때 fast recovery가 수행된다는 점에서 Taho와 다르다. 사실 three duplicates ACK는 timeout처럼 강한 congestion을 의미하는 것이 아니기 때문에 cwnd을 극단적으로 1로 낮출 필요가 없고 오히려 비효율적이다. Reno TCP는 이것을 고려하여 three duplicates ACK일 때는 cwnd = 1로 바꾸지 않고 fast recovery을 수행한다.
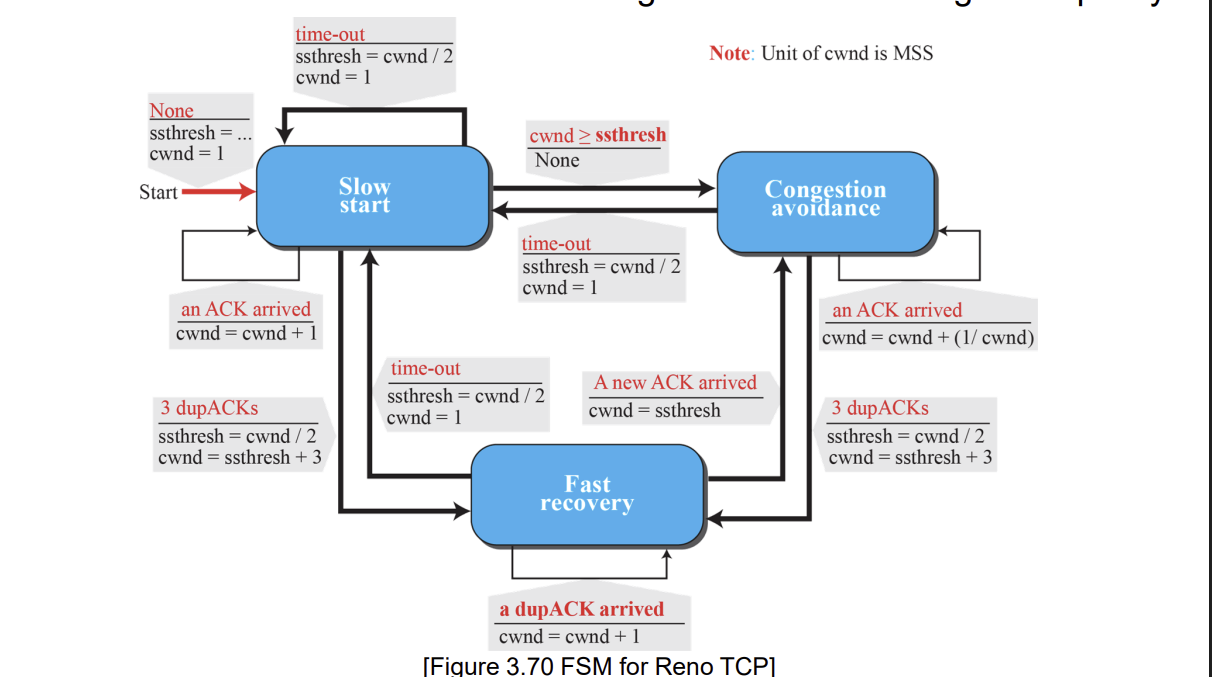
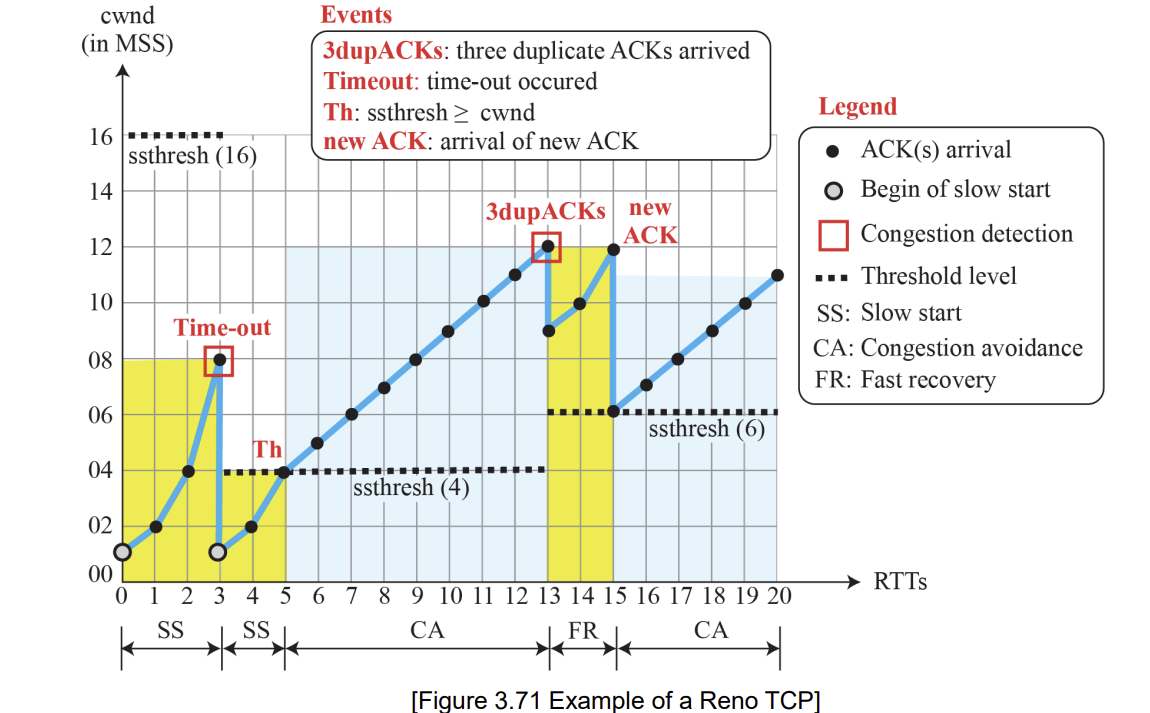
t=3일 때 timeout이 날 때는 Taho처럼 cwnd = 1, ssthresh을 8/2 = 4로 두는 것은 동일하다. 하지만 3dupACKs 일 때는 fast recovery로 인해 ssthresh = 12/2 = 6 이 되고 cwnd = ssthresh(6) + 3 = 9로 바뀌어 cwnd을 극단적으로 줄이지 않는다. 또, fast recovery 도중에 새로운 ACK가 도착한다면, cwnd = ssthresh으로 설정하고 congestion avoidance 단계로 간다는 것이 다르다.
-
NewReno TCP
이 RenoTCP을 더 보완한 것이 NewReno TCP이다. Reno TCP fast recovery 과정에서 새로운 ACK가 들어오면 이제 fast recovery을 할 필요없고 다시 congestion avoidance 단계로 넘어간다. 하지만 생각해보면 이건 하나의 segment만 유실되었을 때 효과적이다. 예를 들어, sender가 1,2,3,4,5을 보냈는데 1과 3이 유실되었다고 하자. Receiver는 1을 받지 못했기에 바로 ACK 1을 계속 보냈을 것이다. 그럼 결국 1에 대해 three duplicate ACK가 와서 Reno TCP는 바로 fast recovery을 수행한다. 그럼 이제 receiver는 1이 다시 왔기에 이제 유실되었던 3을 받기 위해 ACK 3을 보냈다고 하자. 이 상황에서 Reno TCP는 새로운 ACK가 왔기에 문제가 해결되었다고 보고 fast recovery을 끝내고 이제 receiver가 3,4,5 을 잘 처리 중이겠지 라고 착각하게 된다. 이 착각으로 인해 3에 대해서 또 three duplicate ACK을 기다리거나 sender의 timer로 인해 timeout이 되어 성능 저하가 발생한다.
이런 문제를 해결하기 위해 New Reno TCP는 three duplicate ACK가 오고나서 새로운 ACK가 오자마자 바로 fast recovery을 끝내는 것이 아니라 더 lost가 된 segment가 있는지 한번 더 확인한다. 새로 들어온 ACK가 재전송한 segment 번호와 send window 끝 번호 사이라면, 새로 들어온 ACK 번호를 가진 segment도 유실되었다고 판단하여 바로 재전송한다. 이런 방법을 사용하면 timeout이 생길 가능성이 줄어들어 성능 저하를 막을 수 있는 것이다.
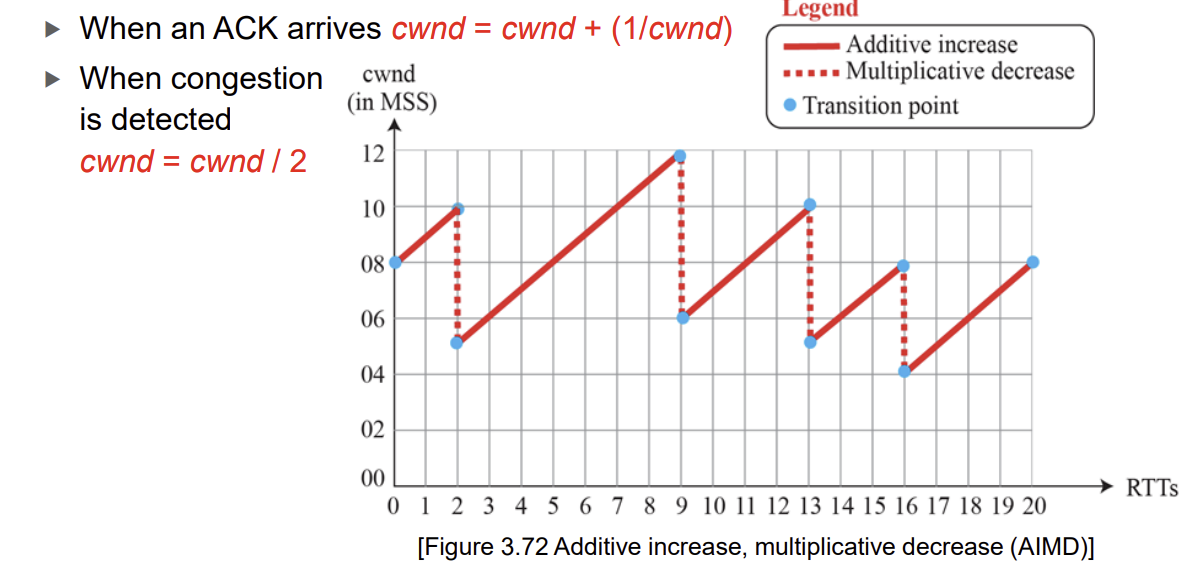
TCP Congestion avoidance 단계, 즉 slow start가 끝나고 나서부터는 additive increase, multplicative decrease의 구조를 가진다. 이를 AIMD라고 부르며 saw tooth과 비슷하다는 특징을 가진다.
TCP Throughput
TCP의 throughput은 단위 시간당 목적지에 성공적으로 전달된 실제 데이터의 양이라고 보면 된다. 이 값을 계산하는 식은 다음과 같다.
\[\text{Throughput} = (0.75) * \text{W}_{max} / \text{RTT}\]이때, $W_{max}$ 는 congestion이 발생했을 때의 cwnd의 평균값이다.
혼잡이 발생하면 TCP의 cwnd가 대략 $W_{max}$ 에서 절반으로 줄었다가 다시 증가하므로, 실제 평균 전송량은 최대 윈도우의 평균값보다 작아져 대략 0.75 × $W_{max}$ 만큼의 데이터를 RTT마다 성공적으로 보낸다고 이해하면 된다.
위 그림을 예시로 들면, $W_{max} = \frac{10+12+10+8+8} {5} = 9.6 MSS$이다. MSS = 10KB이고 RTT = 100ms일 때 Throughput은 0.75 x 9.6 x 10 / 100 = 720KBps = 5.625Mbps이다.
TCP Cubic
AIMD을 보면 congestion avoidance 단계에서 sending rate는 linear하게 증가하는데 줄어드는 것은 계속 multiplicative하게 줄어든다. 요즘 network의 성능은 좋기 때문에 굳이 linear하게 증가시키지 않아도 된다는 아이디어를 사용한 것이 TCP cubic 방법이다.
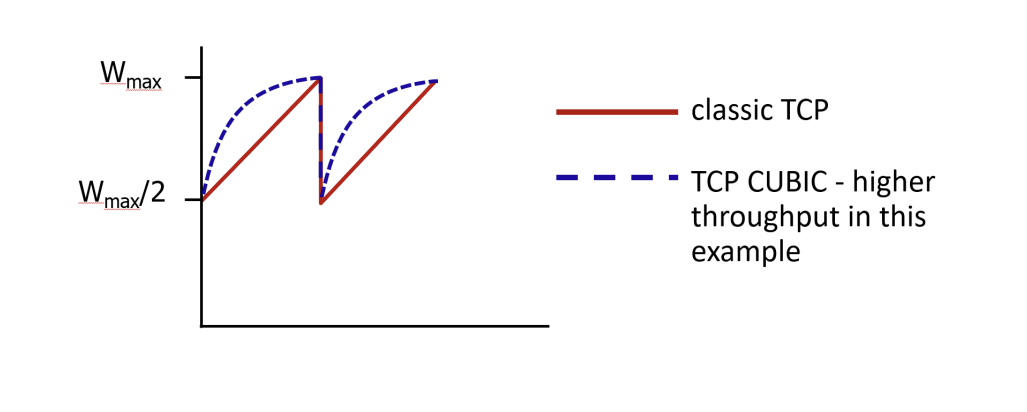
cubic 함수를 사용해서 $W_{max}$까지 초반에 빠르게 증가하고 나중에는 천천히 가까워지는 것이다.
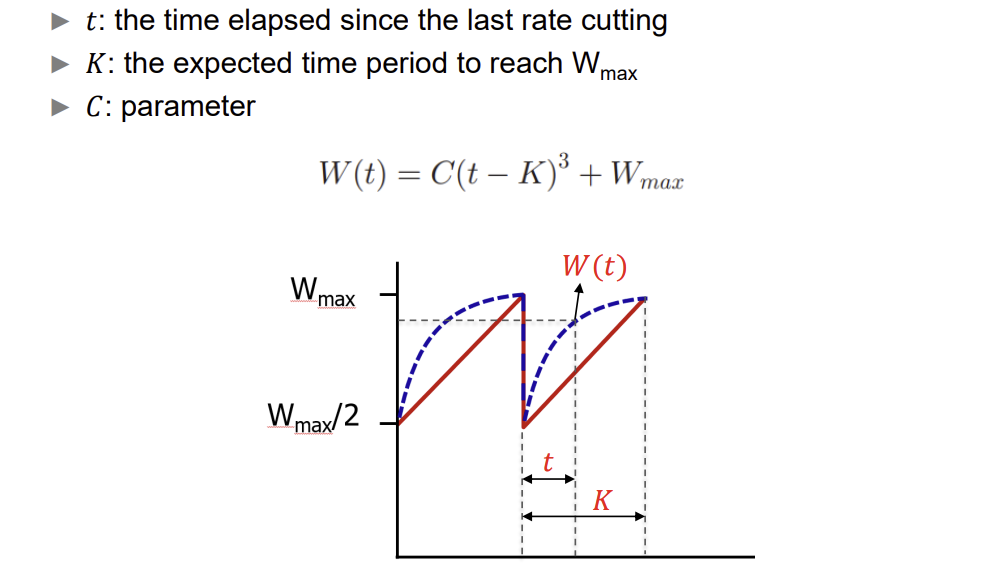
Network의 성능은 이미 좋기 때문에 바로 $W_{max}$까지 빠르게 올려도 congestion이 발생할 확률이 낮다는 가정 하에 설계된 것이다.
QUIC: Quick UDP Internet Connection
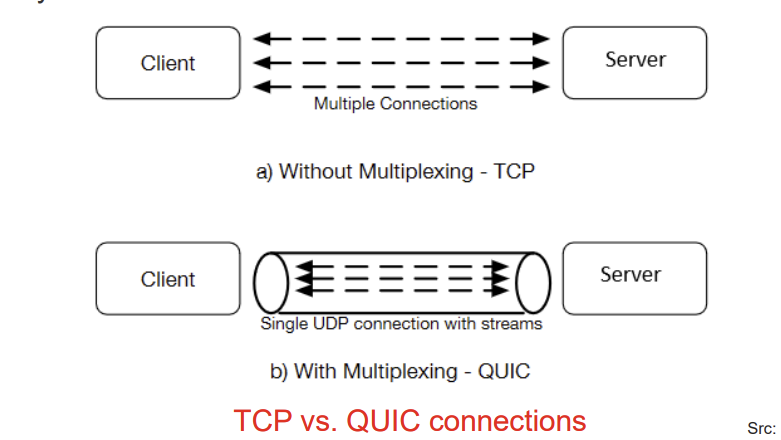
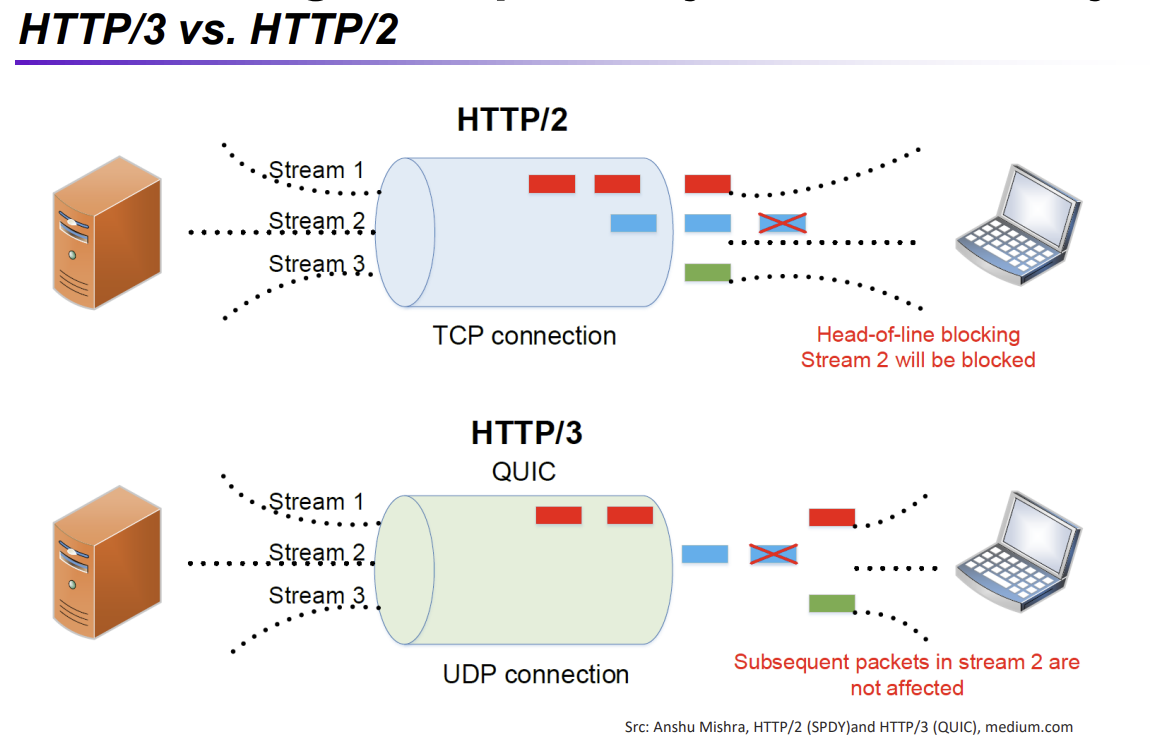
TCP는 connection establishment 등의 과정에서 지연과 overhead가 발생한다 (two round trips). 또, application이 여러 TCP 연결을 해야하는 경우에는 이 overhead가 크게 증가한다. 또, TCP는 ordering 과정을 거치기 때문에 앞의 segment가 유실되었다면 뒤 segment들의 처리까지 늦어진다는 점 (head of line blocking)에서 단점을 갖고 있다. 유실이 자주 나타나는 무선 네트워크에서 이 문제는 더 빈번히 발생한다.
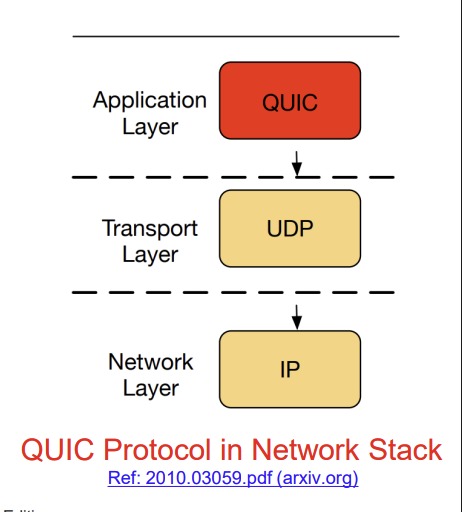
이런 TCP의 단점을 해결하기 위해 QUIC은 UDP 위에 설계된 application layer protocol이다. QUIC의 장점은 다음과 같다.
-
Connection establishment latency 감소
QUIC은 connection establishment을 위한 handshake 과정에 authentication과 encryption handshake까지 같이 한다. 이 authentication과 encryption handshake을 TLS(Transport Layer Security) handshake이라고 부르는데 보안을 위해서 필요한 과정이다. 기존의 TCP에서는 2번 연속의 handshake가 필요하지만 QUIC은 한 번의 handshake으로 이 과정을 단순화하여 latency을 줄였다.
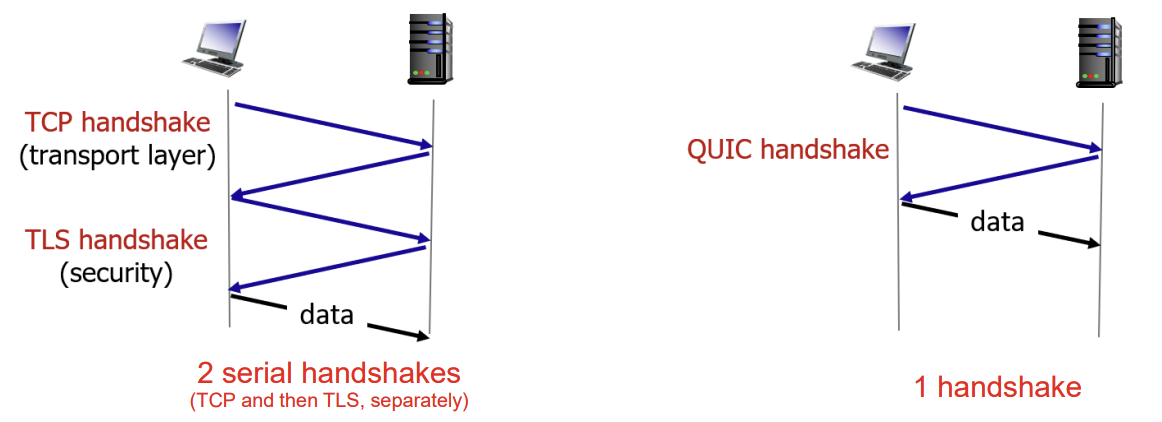
-
head of line blocking 문제가 없는 multiplexing 가능
TCP에서는 client가 server와 여러개의 TCP connection을 해야 한다. 이로 인해 head of line blocking 문제와 latency 문제가 증가한다. 하지만 QUIC은 하나의 UDP connection 안에 multple streams을 사용해서 이 단점을 해결하였다.
-
Connection migration
TCP는 연결을 하기 위해 tuple (src IP, dst IP, src port #, dst port #, protocol)을 정의해야 하며 이 tuple 값 중에서 하나라도 바뀌면 connection establishment 과정을 다시 해야 했다. 즉, 이동하다가 예를 들어 IP가 바뀌면 앱이 멈추고 다시 connection establishment까지 기다리고 process을 이어갈 수 있게 되는 불편함을 초래한다.
하지만 QUIC은 IP을 사용하지 않고 connection ID라는 새로운 값을 data packet에 추가하여 이동하다가 IP가 바뀌어도 connection ID을 통해서 정보를 교환하기 때문에 문제가 없다. 즉, re-establishment 과정이 필요가 없어진다.
HTTP3
HTTP3은 QUIC을 통해 TCP을 사용해서 생겼던 head of line blocking 문제를 해결하게 되었다 (multiple streams을 사용하기에)
Example questions
-
Eve, the intruder, sends a user datagram to Bob, the server, using Alice’s IP address. Can Eve, pretending to be Alice, receive the response from Bob?
Eve cannot receive the response from Bob, because Bob, the server, sends the response to Alice’s IP address. The destination IP address is the source IP address in the request message. Since Alice has not requested this response, the response is dropped and lost. Eve can receive the response only if she can intercept the message.