Chatper 4 Network Layer 정리
Network Layer
Network layer services
-
Encapsulation and Decapsulation
-
Encapsulation: Source에서 Upper layer의 data을 처리하고 lower layer에 보내는 것
-
Decapsulation: 전송 과정에서 분해되었던 packet들을 destination에서 reassembling하고 upper layer에 보내는 것
-
-
Routing
실제 physical network는 LAN,WAN들의 조합이기에 source -> destination으로 가는 길은 여러 가지가 있다. Routing은 여러 길 중에서 최선의 길을 선택하는 것이다.
-
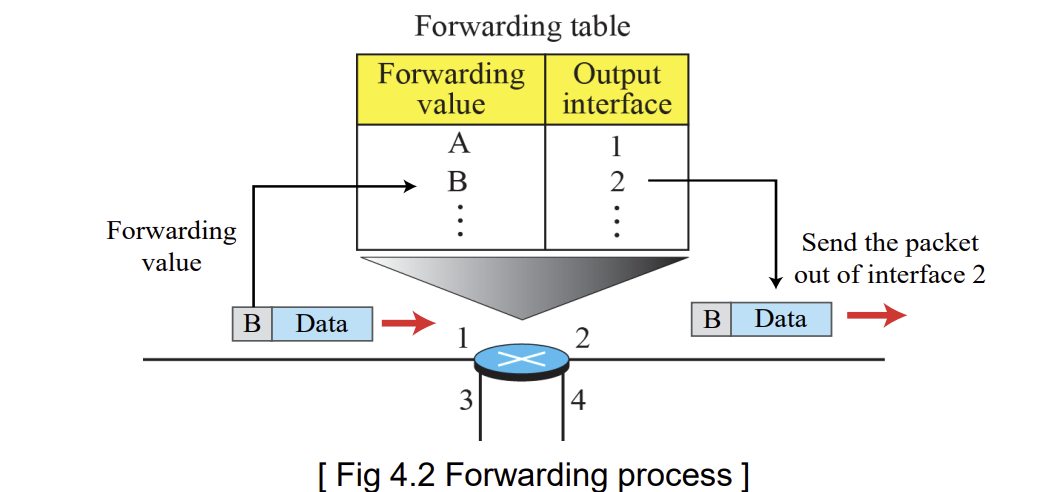
Forwarding
Router의 input에서 output으로 Router 안에서 packet을 이동시키는 것
-
Error control
Packet이 fragment되어 오기 때문에 error check을 딱히 할 수 없다. 하지만 checksum field으로 corruption 확인은 가능하다
-
Flow control
Flow control은 upper layer가 다 할 수 있기 때문에 network layer에서 제공하지 않는다.
-
Congestion control
Network layer에서 수행하지 않는다.
-
Security
Network layer에서 수행하지 않는다.
-
Congestion Control
수행한다.
Packet Switching
Packet switching은 Upper layer의 message을 packet 단위로 나눠서 network에 보내는 방법으로 network layer에서만 사용된다.
Packet switching을 사용하는 방법은 datagram approach와 virtual circuit approach가 있다.
Datagram Approach
Connectionless service으로 packet들이 서로 독립적인 것이다.
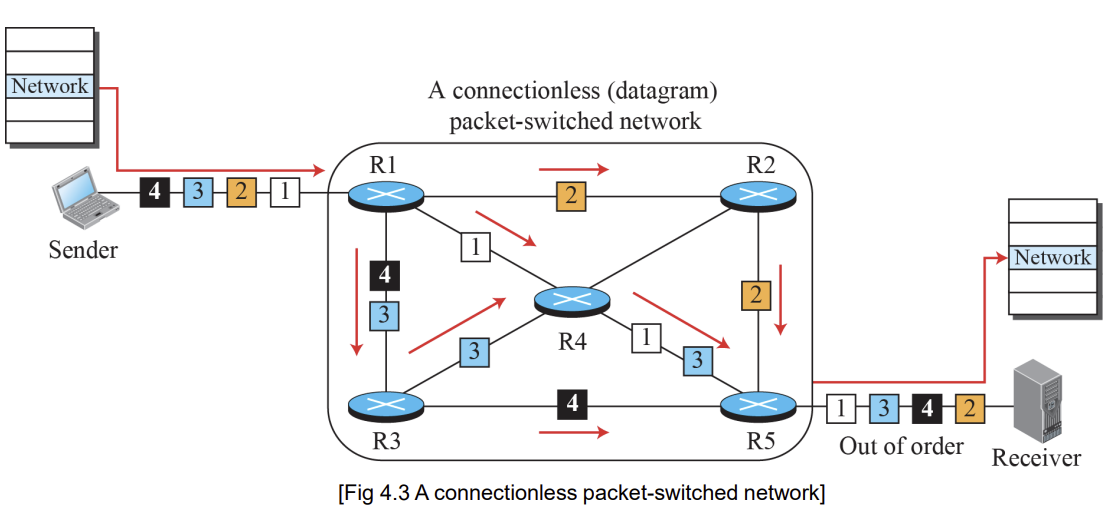
Packet은 header에 존재하는 정보를 바탕으로 routing이 된다.
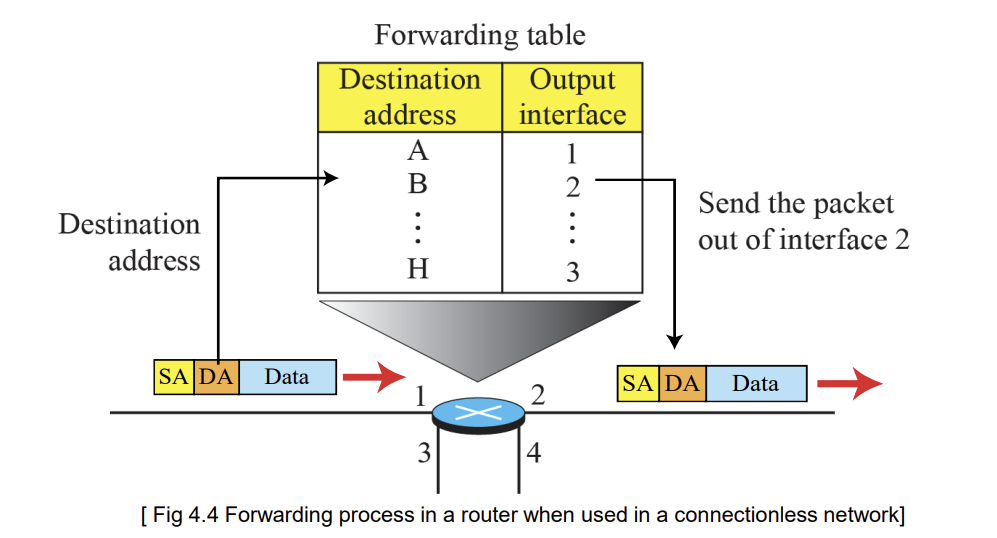
이 forwarding table은 이전에 이미 정의되어 있고 packet은 목적지에 따라서 forwarding이 된다.
Virtual Circuit Approach
Connection oriented service으로 보내기 전에 sender와 receiver 간의 경로 (virtual circuit)를 미리 정하고 보내는 방법이다.
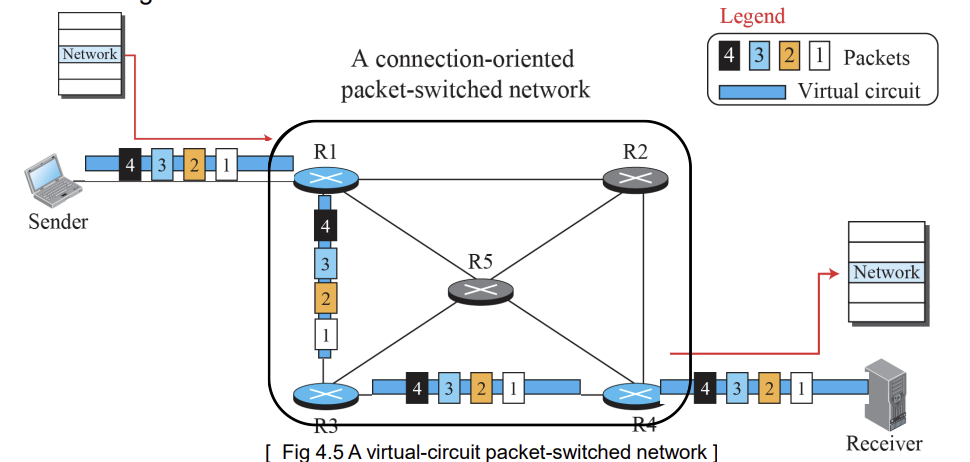
Virtual circuit에서는 destination address가 아니라 label을 바탕으로 forwarding이 된다.
이 label은 network의 setup phase에 정해진다
Set up Phase
Set up phase은 label을 결정하기 위해서 destination과 source가 request packet, acknowledge packet을 주고 받는 것이다.
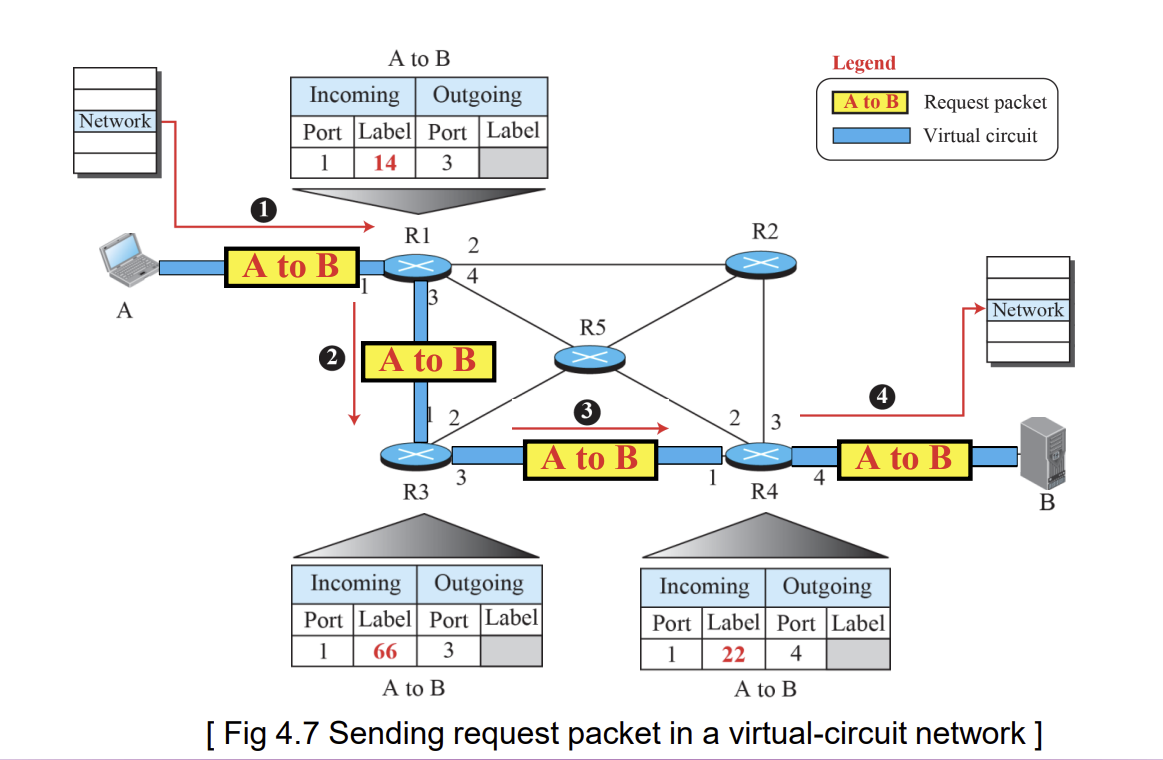
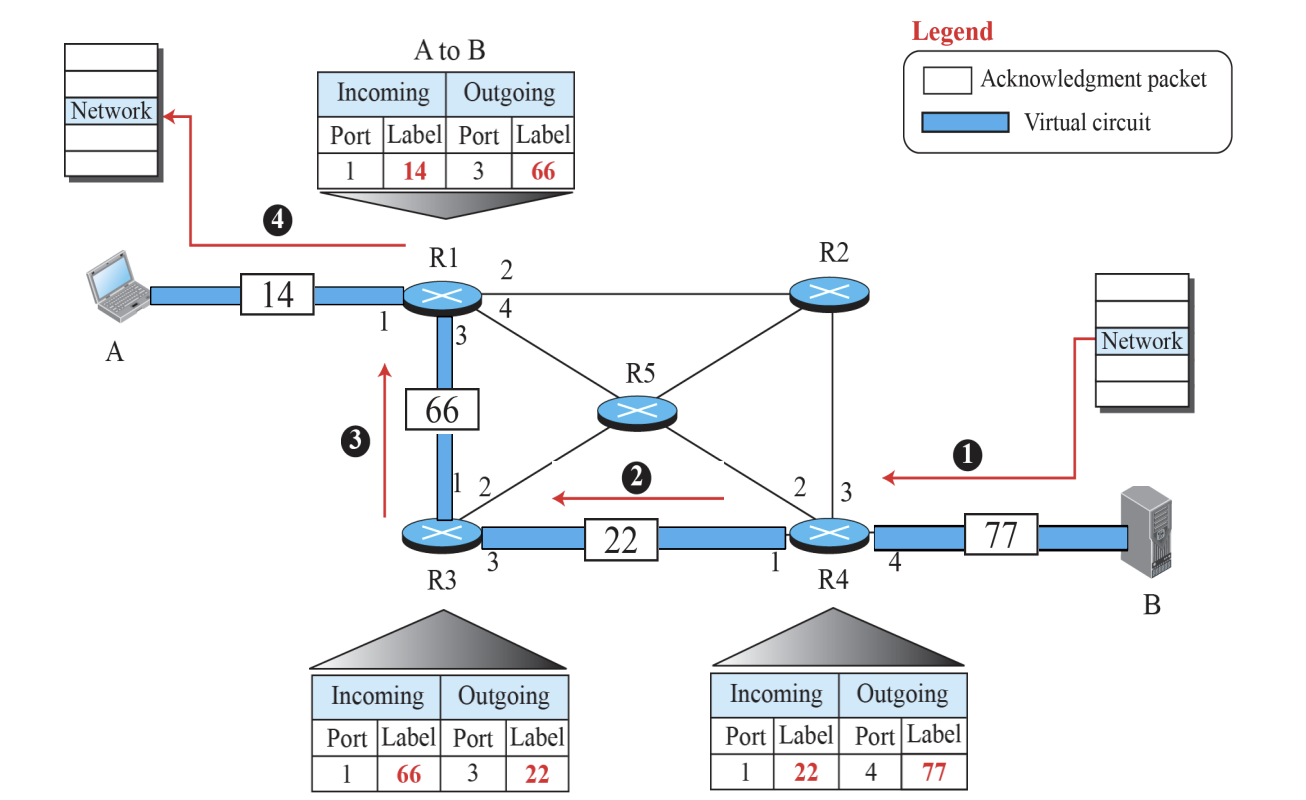
이 과정을 통해서 label이 path의 guide가 된다고 생각하면 된다. 이 label을 바탕으로 data는 다음과 같이 이동한다.
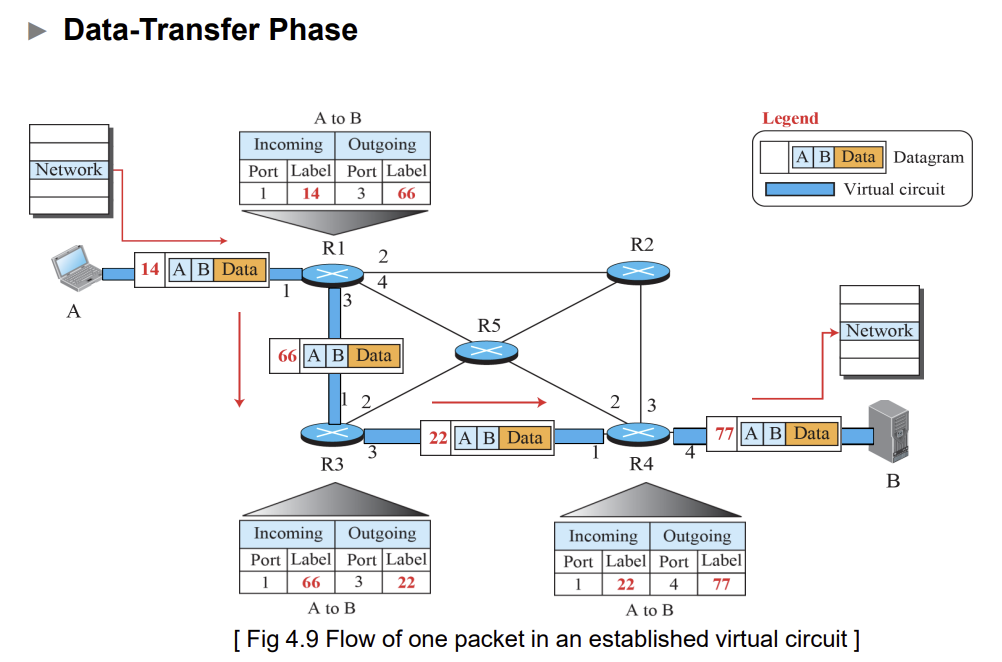
Network Layer Performance
Network layer의 성능은 delay, throughput, packet loss로 측정한다.
Delay
-
Transmission delay
device에서 cable까지 가는 시간이다.
$\frac{packet length} {transmission rate}$
-
Propagation delay
cable에서의 이동 시간이다.
$\frac{distance} {propagation speed}$
-
Processing delay
router와 destination에서 packet을 처리하는데 걸리는 시간
-
Queuing delay
Router 내에서 queue에서 packet이 자기 차례가 올 때까지 기다리는 시간
-
Total delay
n: two end host 간의 router 수라고 할 때, total delay는 (n+1) x (Transmission delay + Propagation delay + Processing delay) + (n) x (Queuing delay)
Throughput
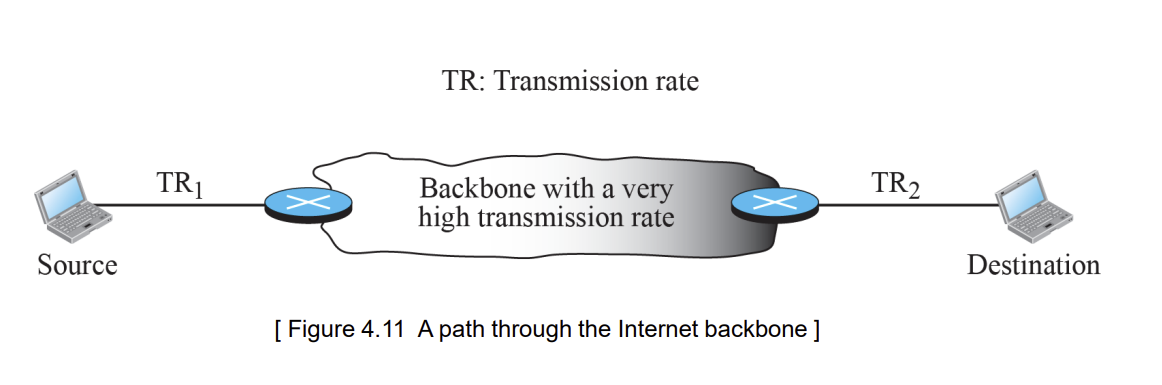
Network 임의의 지점에서 1초당 흐르고 있는 bit의 수를 transmission rate라고 한다. 이때, network을 구성하는 모든 지점에서 transmission rate의 최솟값을 throughput이라고 한다.
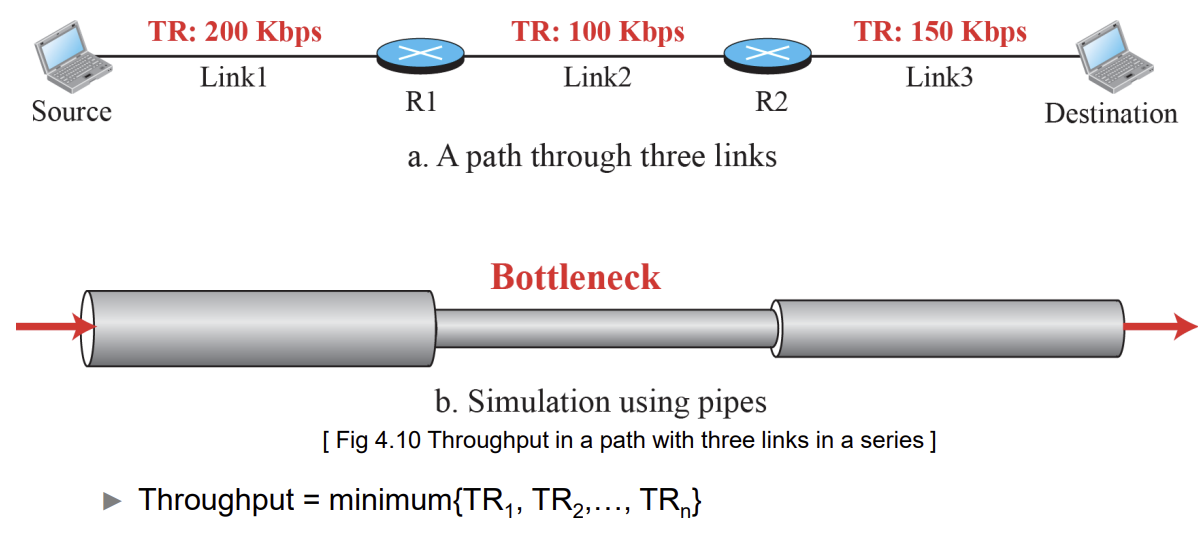
요즘 network은 워낙 빠르기에 그냥 source와 destination을 internet과 이어주는 각 access link의 transmission rate의 최솟값으로 throughput을 계산한다.
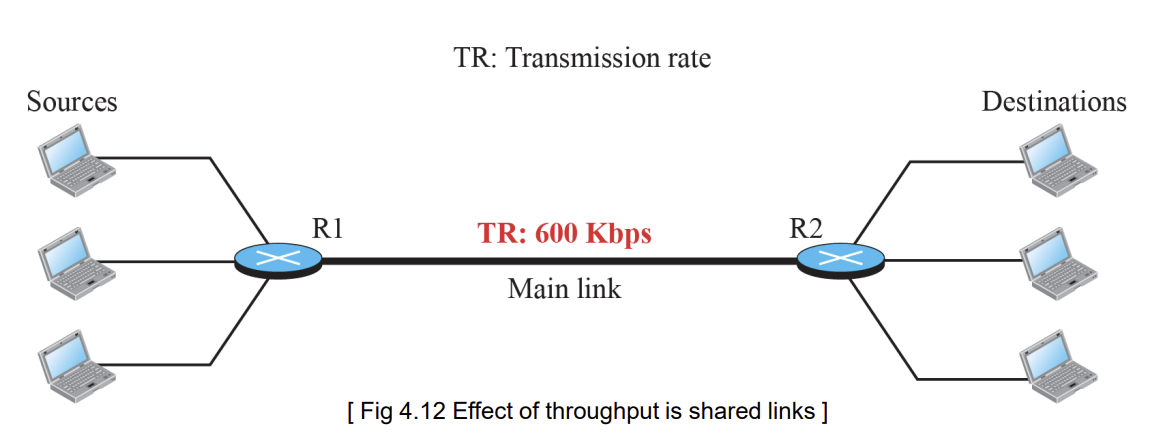
추가로, 두 router 간의 link는 항상 하나의 flow만 구성하지 않기에 이렇게 여러 source가 존재할 경우, transmission rate은 공유된다.
Packet loss
Router가 packet을 받고 처리하기 위해서는 이 packet이 input buffer에 저장되어 있어야 한다. 하지만 input buffer는 제한된 크기를 가진다. 그래서 input buffer가 꽉 차게 된다면 그 이후에 들어오는 packet들은 drop 되어서 결국 loss가 된다. Lost된 packet은 결국 다시 resend 되어야 하기 때문에 더 많은 loss을 초래할 수 있게 된다.
Network Layer Congestion
Network layer에서의 congestion은 packet delay와 throughput을 통해 관찰할 수 있다.
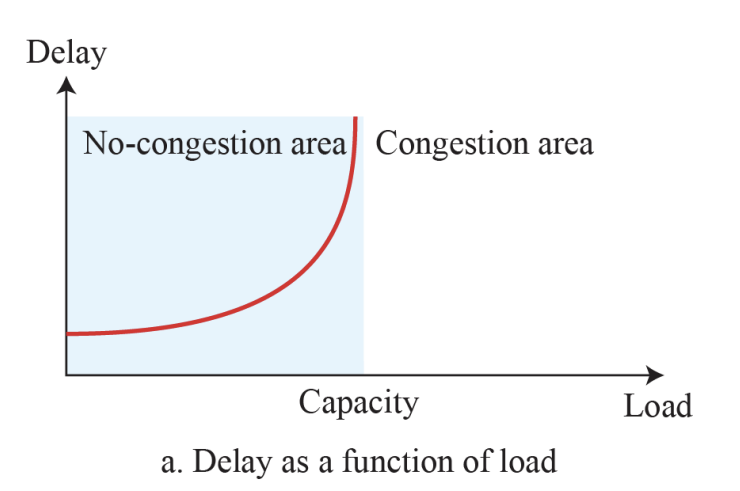
congestion에 다가가면서 load는 queue에서 기다려야 하는 시간이 기하급수적으로 늘어서 결국 delay가 무한대로 커진다.
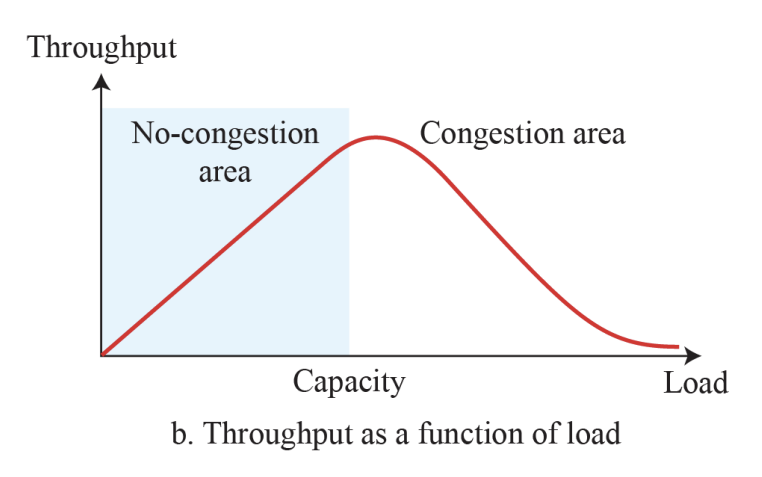
보내지는 data가 많아지면 throughput이 커진다. 그러다가 congestion이 발생하면 buffer에 안전히 들어간 data들은 계속 처리되지만 나머지는 loss되기 때문에 재전송량이 많아지고 이 재전송은 throughput에 관여하지 못하기에 실제 유효 처리량인 throughput은 감소한다.
Congestion Control
Network layer는 이 문제를 해결하기 위해 두 방법을 사용한다.
-
Open loop congestion control
Congestion이 발생하기 전에 예방하는 것이다.
-
Retransmission policy
Congestion을 늘리지 않도록 retransmission을 결정하는 기준을 세운다
-
Window policy
Sender의 window type (Go back N, Selective Repeat 등)도 congestion에 큰 영향을 준다. Go back N은 time out이 발생하면 이미 잘 보내진 packet들도 다시 재전송될 수 있다. 하지만 selective repeat에서는 lost/corrupted된 packet만 선택적으로 재전송하여 congestion을 줄일 수 있다.
-
Acknowledgement policy
Receiver가 packet을 받을 때마다 ACK을 보내지 않는다면 sender도 send window을 update해서 새로운 packet을 보내지 못하기 때문에 sender가 전송하는 속도를 늦출 수 있어서 congestion을 줄일 수 있다.
-
Discard policy
Router가 discard하는 packet을 결정하는 기준.
-
Admission policy
Virtual circuit network에 사용할 수 있는 방법으로 ack/req packet을 받으면 그냥 거절하는 방법이다.
-
-
Closed loop congestion control
Congestion을 완화하는 것이다.
-
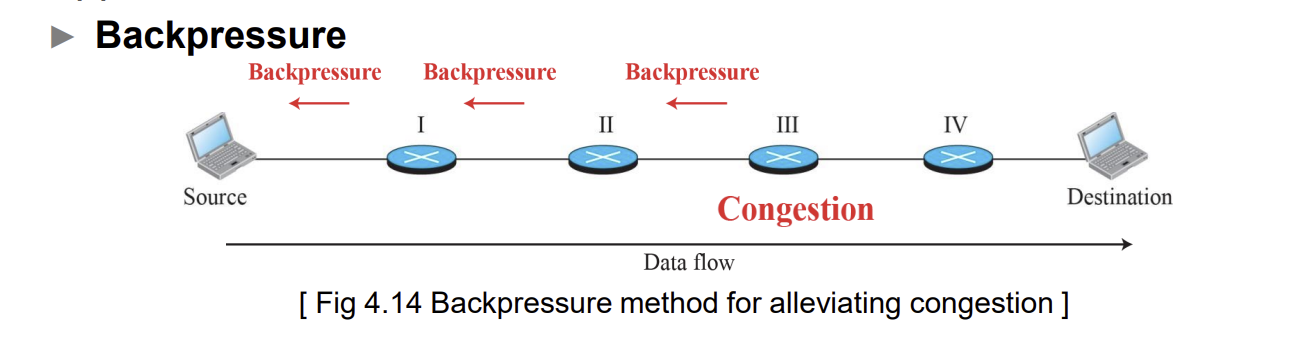
Back pressure
Congestion 발생한 곳에서 Data을 보낸 곳으로 data를 천천히 보내라는 신호를 보낸다.
-
Choke packet
Source에 바로 back pressure 신호를 보낸다.
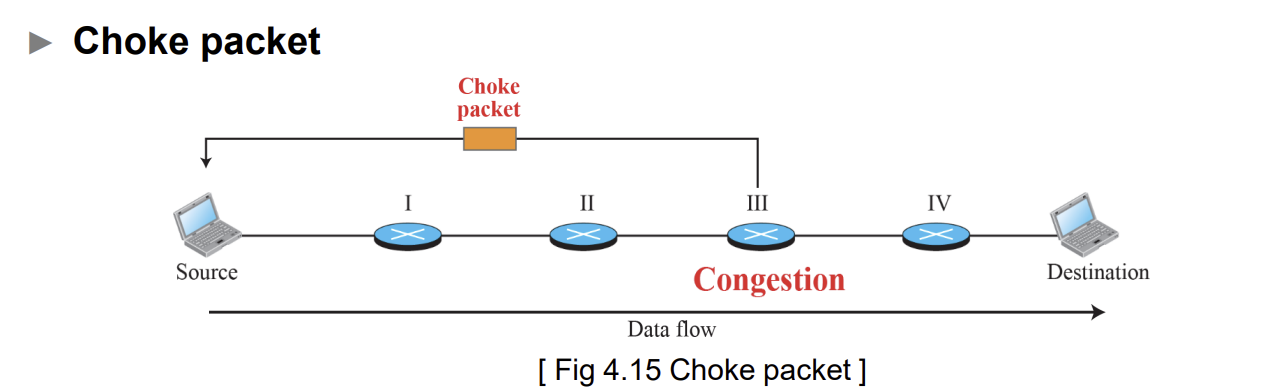
그렇다면 이런 signal을 어떻게 보낼까? Close loop congestion control은 다음 두 방법을 사용한다.
-
Implicit Signaling
Congested node와 source 간의 직접적인 통신은 없고 source는 다른 징후들을 통해 congestion이 발생했음을 예측하는 것이다.
-
Explicit Signaling
Congestion signal을 직접 보내는 것이다.
-
Network Layer Protocol
Network layer protocol은 하나의 main protocol과 보조적인 3개의 protocol으로 나뉜다.
Main
- IPv4은 packet의 packetizing, forwarding, delivery을 담당한다.
Auxiliary
-
Internet Control Message Protocol (ICMPv4)은 error 처리 담당
-
Internet Group Management Protocol (IGMP)은 multicasting 담당
-
Address Resolution Protocol (ARP)은 network와 data link layer을 연결하는 담당
IP Datagram Format
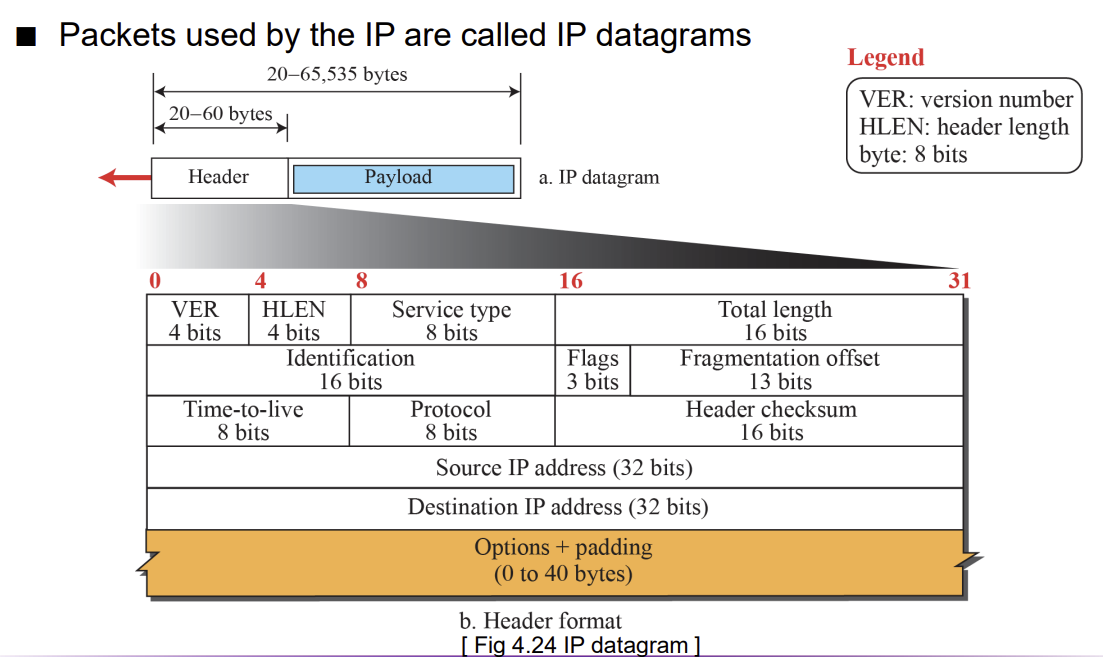
IP packet header는 20~60 bytes으로 고정된 값이 아니다.
-
VER: 4 bit으로 IP protocol의 version을 의미한다. 다른 IP version을 사용하는 machine을 만나게 되면 discard 된다.
-
HLEN: 4 bit으로 Header 크기를 의미한다. 0111(7) -> 7 words long -> 28 bytes long header (1 word는 4 byte)
-
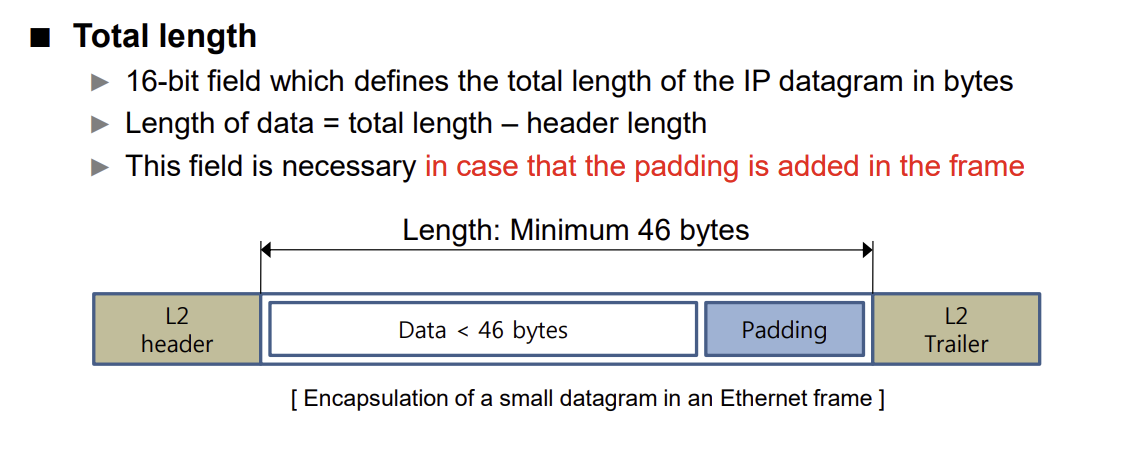
Total length: 16 bits으로 datagram 전체의 길이 (header + 실제 data)를 표현한다. 따라서 packet 안에 든 data의 실제 길이는 total length - header length으로 구하면 된다.
- Time to live: Router가 잘못 routing하면 packet이 계속 network에서 존재해서 traffic을 늘릴 수 있기에 각 packet마다 유효기간을 설정해둔다. 그래서 router을 방문할 때마다 1씩 줄어들다가 0이 되면 자동으로 discard된다.
Maximum Transfer Unit: Datagram이 encapsulate 될 때 전체 크기는 MTU보다 작아야 한다. (Header + IP Header + Payload + Trailer < MTU)
Fragmentation과 관련된 fields
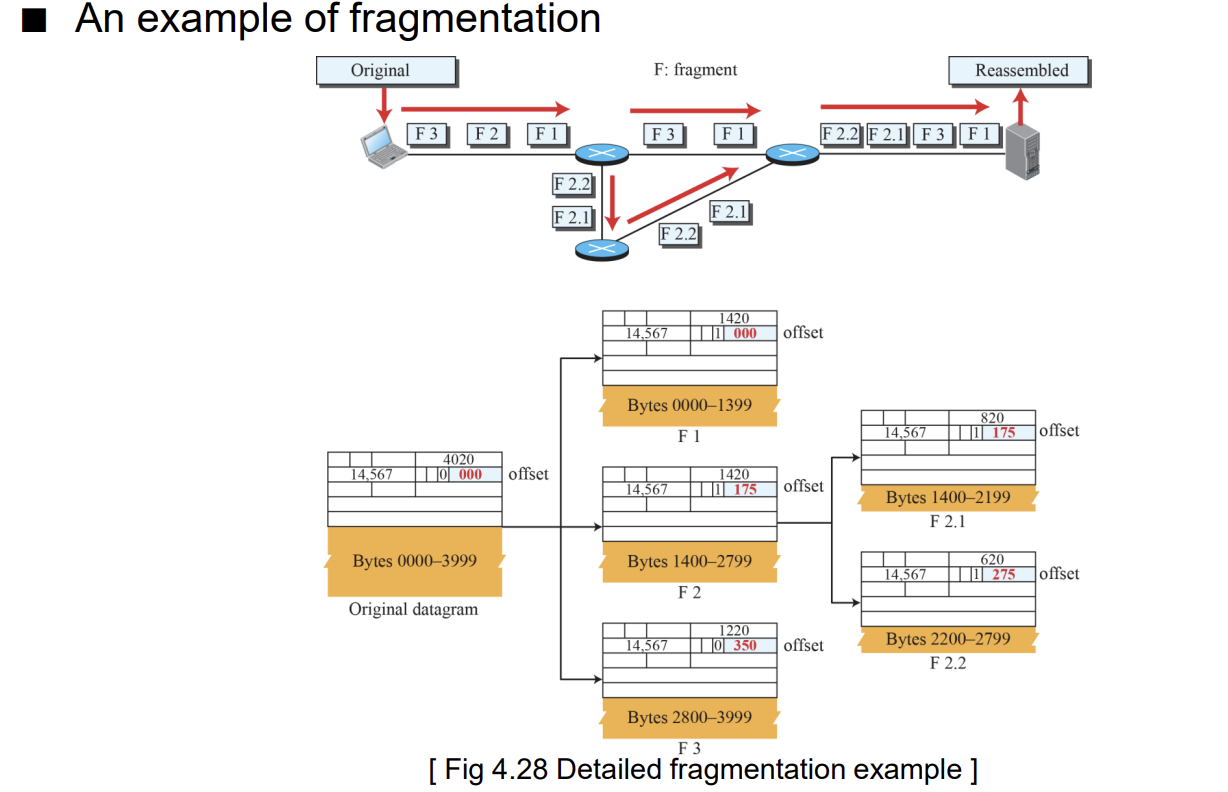
Datagram을 나누기 위해서 fragmentation을 사용한다. Source에서는 보통 fragmentation을 하지 않고 router에서 수행한다. Datagram이 fragment되면 각 fragment는 각자의 header을 가지고 있고 대부분의 field들은 반복된다.
Fragmented된 datagram들은 destination에서 reassemble 된다.
-
Identification: 16 bit으로 하나의 datagram이 fragment되면 fragment된 애들은 동일한 identification bits을 갖게 된다. source IP address와 함께 조합되어야 destination에서 각 packet이 어떤 datagram에 속하는지 정보를 알려주어 datagram의 reassembly을 할 수 있게 된다.
-
Flags: 3 bit으로 첫 bit은 아무 의미가 없고 두번째 bit는 활성화 되어있으면 fragment을 하면 안되는 것이고 세번째 bit는 활성화 되어있으면 fragment가 더 남았음을 의미한다.
-
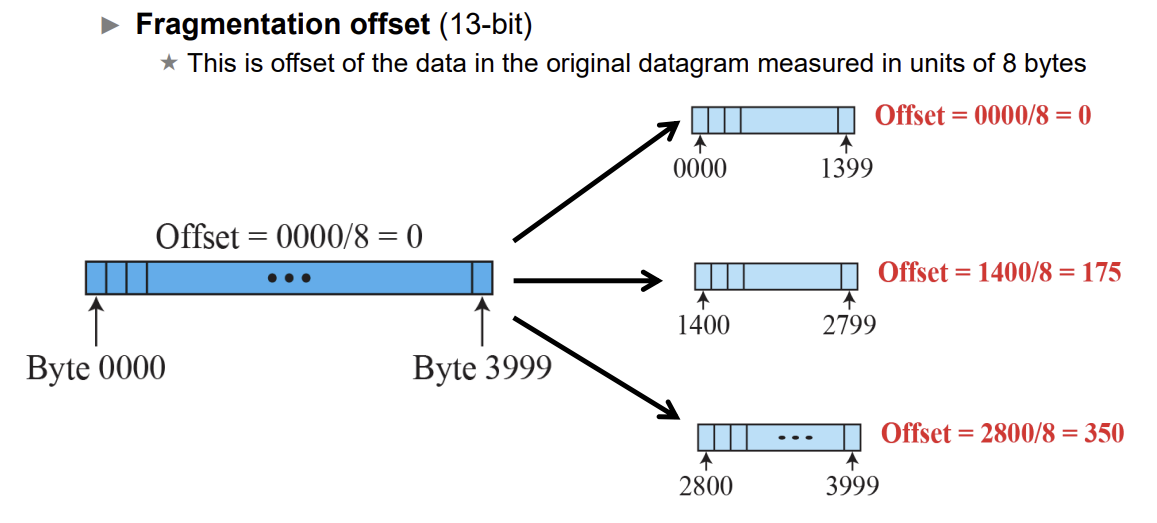
Fragment offset: 13 bit으로 실제 datagram에서의 byte 위치의 1/8 값이라고 이해하면 된다. 예를 들어 4000 byte 짜리가 fragment되었다고 하자. 그럼 각 fragment의 offset은 다음과 같다.
Fragmentation의 전체 과정은 다음과 같다.
IPv4
IPv4 address
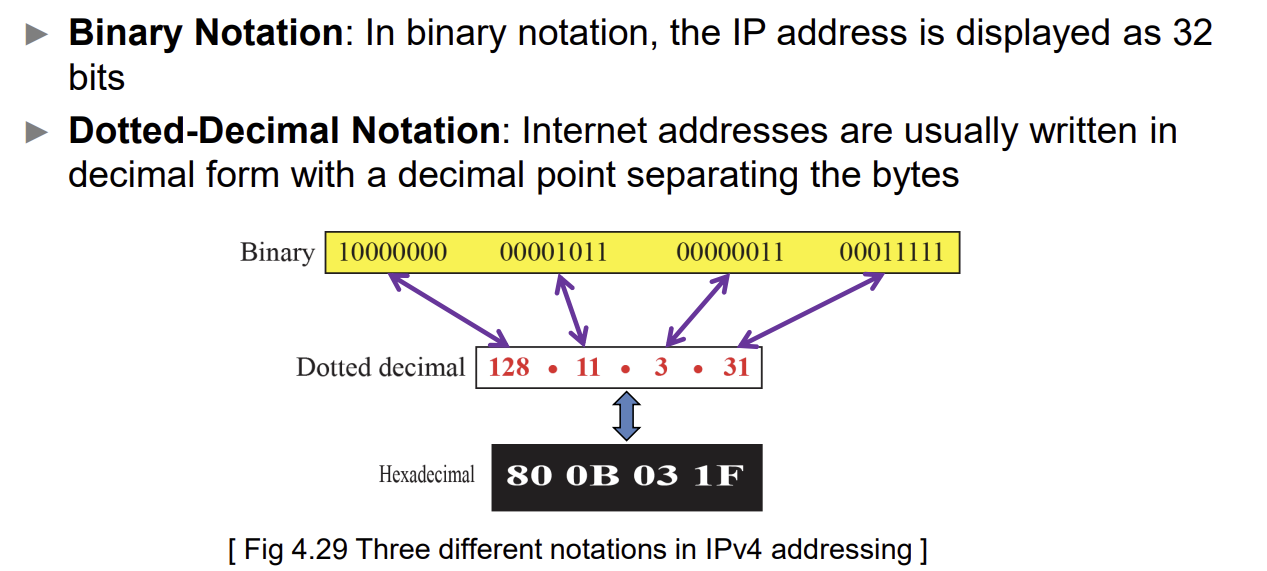
IP address는 32 bit으로 되어있으며 unique하다.
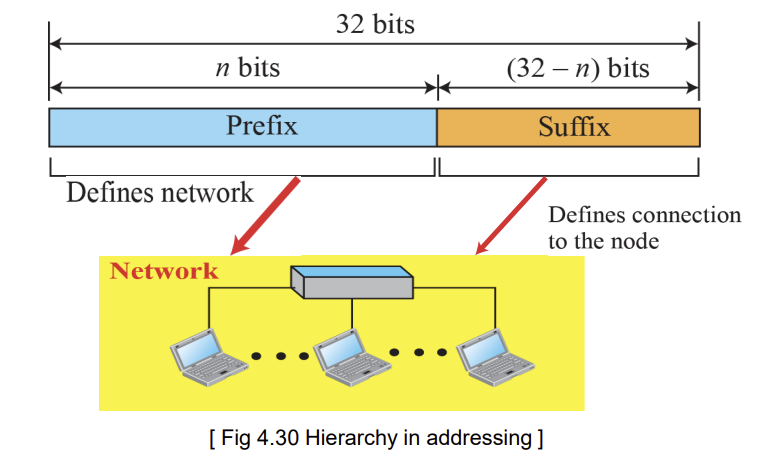
IP address는 두 부분으로 나뉘어져있다. 첫 부분인 prefix는 network을 정의하고 두 번째 부분 suffix는 node을 정의한다.
Addressing
IPv4의 address에는 두 종류가 있다.
-
Classful Addressing
Classful Addressing에서는 IP address space을 A,B,C,D,E로 나누고 각 class마다 prefix의 길이가 다르다
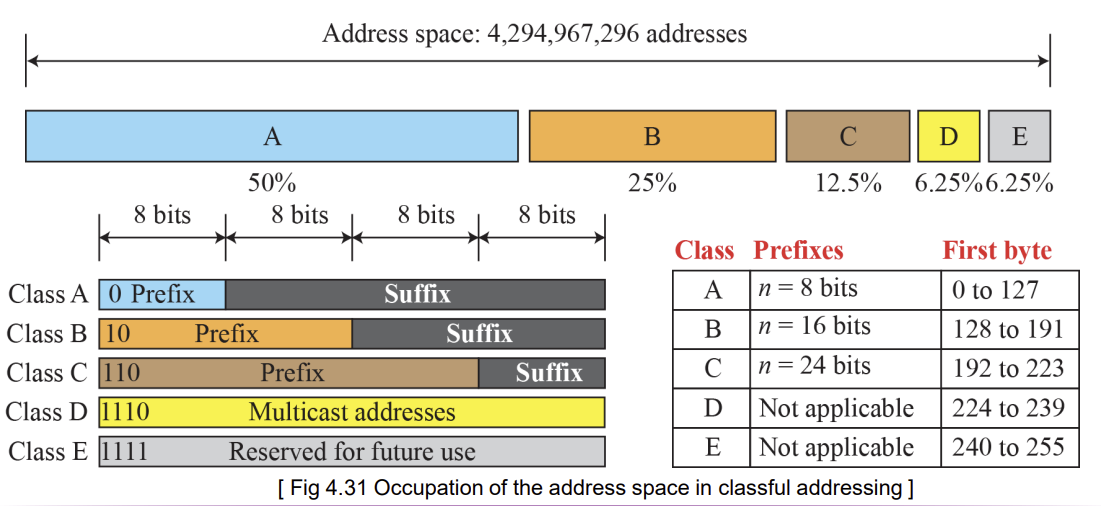
하지만 classful addressing의 단점은 우선 class A을 관찰하면 알 수 있다. Class A는 prefix의 길이가 짧기 때문에 Class A는 IP 주소가 $2^{32 - 8} = 16,777,216$ 개가 존재한다. 하지만 이렇게 큰 IP 주소를 사용할 수 있는 기관들은 수가 적기 때문에 대부분의 IP address들이 낭비가 된다. 즉, classful addressing을 사용하면 IP 주소 부족 현상이 발생한다.
이 문제를 해결하기 위해 subnetting과 supernetting 개념이 사용되었다.
Subnetting은 Class A,B을 더 세분화된 subnet으로 나누고 각 subnet은 원래 속하던 class보다 더 큰 prefix length을 가지게 된다. 이런 방법으로 사용 안되는 subnet은 다른 기관에 줄 수 있게 된다. ( 하지만 생각해보면 Class A을 할당받은 기관이 굳이 자기의 IP address을 나눠줄 필요가 없음)
Supernetting은 하나의 기관이 500개의 IP 주소가 필요해서 Class B을 요구한다고 할 때, (Class C는 $2^8 = 256$ 개) B를 주는 것이 아니라 class C을 여러개 주는 방법이다. 하지만 이렇게 하면 routing이 어려워지게 되어 문제를 더 유발하였다.
-
Classless Addressing
이 문제를 해결하기 위해 classless addressing이 제시되었다. 그냥 class별로 prefix 길이을 고정시키는 것이 아니라 필요한 IP 주소만큼 prefix length을 알아서 설정하는 것이다. 따라서 prefix length가 짧을수록 IP 주소 개수는 많아지는 것이다.
이때 제약 사항이 존재한다.
- Block마다 address 수는 $2^n$ 이어야 하고
- 각 block의 첫 주소는 block의 address 수로 나뉘어져야 하고
- prefix, suffix을 구분하기 위한 mask 값이 정의되어야 한다. Mask는 classless interdomain routing 또는 CIDR 표기법으로 주어진다.
- 구조는 X.Y.Z.t/n으로 n이 prefix의 길이이다.
Mask는 prefix라고 보면 된다. Mask을 제외하고 나머지 bit을 0으로 하면 그것이 바로 block의 첫 address이고 나머지 bit을 1로 하면 block의 alst address가 된다.
ex) Classless address가 167.199.170.82/27 이라고 할 때, prefix의 길이는 그럼 27 bits이므로 총 IP address 수는 $2^{32-27} = 2^5 = 32$ 이다.
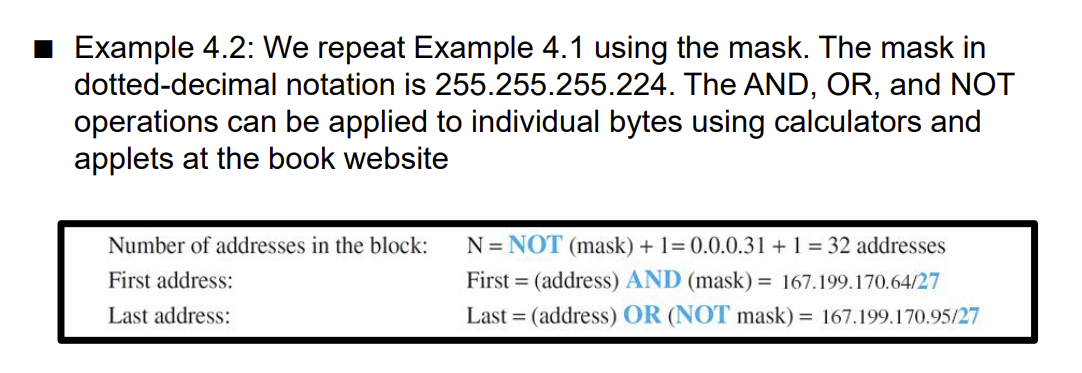
Dotted Decimal notation을 써서 mask가 255.255.255.224 (11111111.11111111.11111111.11100000) 라는 것을 알 수 있다.
- 이 값이 주어졌을 때 block의 총 address 개수는 NOT(Mask) + 1
- 해당 block의 first address는 (그 block의 아무 address) AND (mask)
- 해당 block의 last address는 (그 block의 아무 address) OR (NOT mask)
Classless addressing에서는 block의 first address는 network address으로 routing에 중요한 역할을 한다.
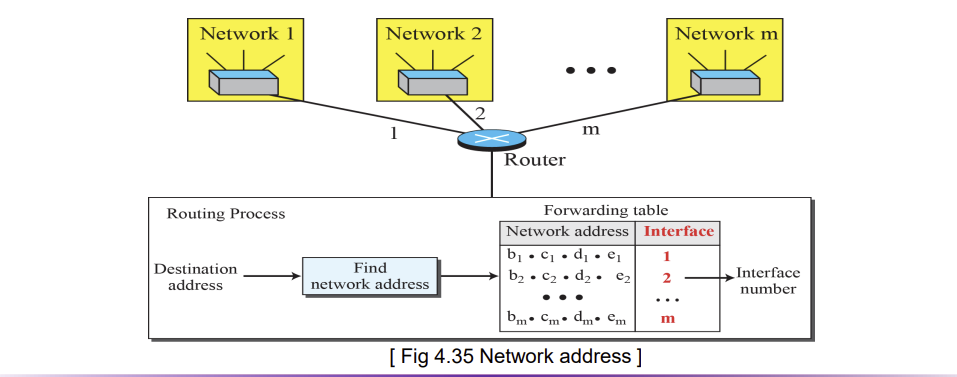
ex) ISP가 1000개의 address을 요청했다고 할 때 총 1024의 address을 할당해야 한다. 그렇다면 prefix의 길이는 32 - 10 = 22이므로 할당해주는 block는 18.14.12.0/22이다.
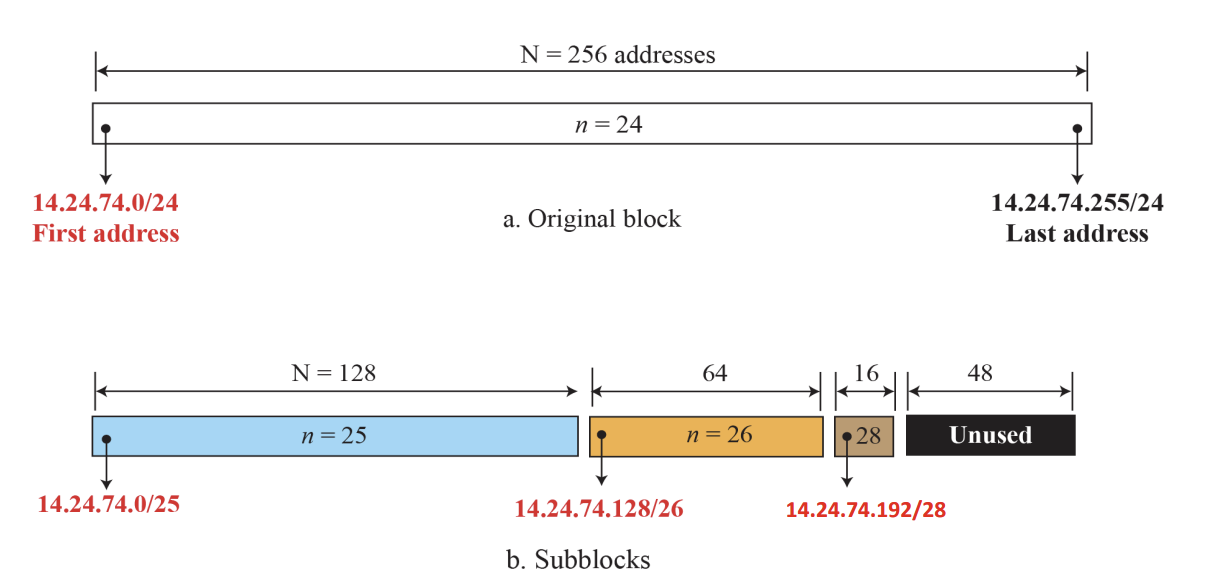
ex) An organization is granted a block of addresses with the beginning address 14.24.74.0/24. The organization needs to have 3 subblocks of addresses to use in its three subnets: one subblock of 10 addresses, one subblock of 60 addresses, and one subblock of 120 addresses. Design the subblocks
prefix가 24 bits long이기에 block의 address는 총 $2^{32-24} = 256$ 개이다. Sublocks을 요구하는 주소 수가 많은 것부터 할당해준다고 할 때,
-
120은 64보단 크고 128보단 작기에 128개의 address, 즉 7 bit의 suffix가 필요하므로 prefix = 25 bits, suffix = 7 bits가 된다. 따라서, 14.24.74.0/25 ~ 14.24.74.127/25을 가진다.
-
60은 32보단 크고 64보단 작기에 64개의 address, 즉 6 bit의 suffix가 필요하므로 prefix = 26 bits, suffix = 6 bits가 된다. 따라서 14.24.74.128/26 ~ 14.24.74.191/26 을 가진다.
-
10은 8보단 크고 16보단 작기에 16개의 address, 즉 4 bit의 suffix가 필요하므로 prefix = 28 bits, suffix = 4 bits가 된다. 따라서 14.24.74.192/28 ~ 14.24.74.207/28을 가진다.
총 208개의 address을 할당해줬으며 48개의 address가 남겨진다.
Address Aggregation
CIDR 표기법의 장점 중 하나는 address aggregation의 편리성이다.
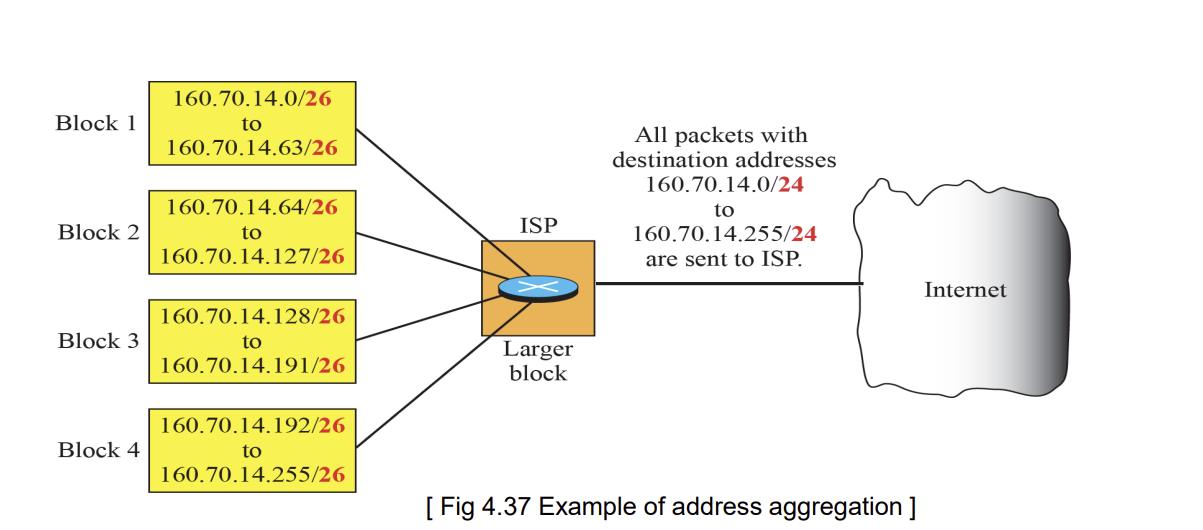
Block 1,2,3,4을 합친 160.70.14.0/26 ~ 160.70.14.255/26(256개의 주소)는 160.70.14.0/24 (8개의 prefix bit = 256개의 주소)의 block과 동일하기에 원래는 router table에 entry을 4개 차지해야 하는데 address aggregation으로 인해 Internet 입장에서는 160.70.14.x/24 이면 그냥 ISP로 바로 보낼 수 있게 해서 routing이 간단해진다. ISP 내부에서만 이 큰 block을 다시 block 1,2,3,4 로 쪼개면 되는 것이다.
Special addresses
-
This-host: 자기의 IP 주소를 모를 때 사용 0.0.0.0/32
-
Limited Broadcast: 모든 device에게 메세지를 보내고 싶을 때 사용 255.255.255.255/32
-
Loopback: 항상 destination address인 것 127.0.0.0/8
-
Private address
-
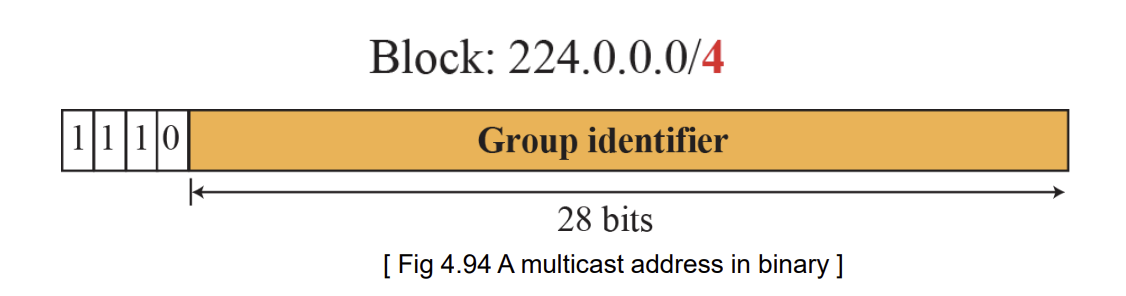
Multicast Address 224.0.0.0/4
ex) IP address가 109.190.10.164/16 일 때
-
first address: 마지막 16 bit을 0으로 –> 109.190.0.0
-
braodcast address (last address) : 마지막 16 bit을 1으로 –> 109.190.255.255
-
last usable address : broadcast address에서 1을 뺀 것.
IP address block에서 IP address는 $2^m$ 개를 할당받지만 첫번째 (000)이랑 마지막(111)은 실제 사용은 불가능하다. 첫 번째는 그 네트워크를 대표하는 address이고 마지막은 broadcast 용이기 때문이다.
DHCP: Dynamic Host Configuration Protocol
DHCP는 자동으로 host에게 주소를 할당해주는 protocol이다. ISP/Org는 ICANN으로부터 blocks of addresses을 직접 받는다. 이때, 이 ISP/Org의 구성원들이 network에 들어갈 때 DHCP으로 인해 자동으로 IP 주소를 배정받게 되는 것이다.
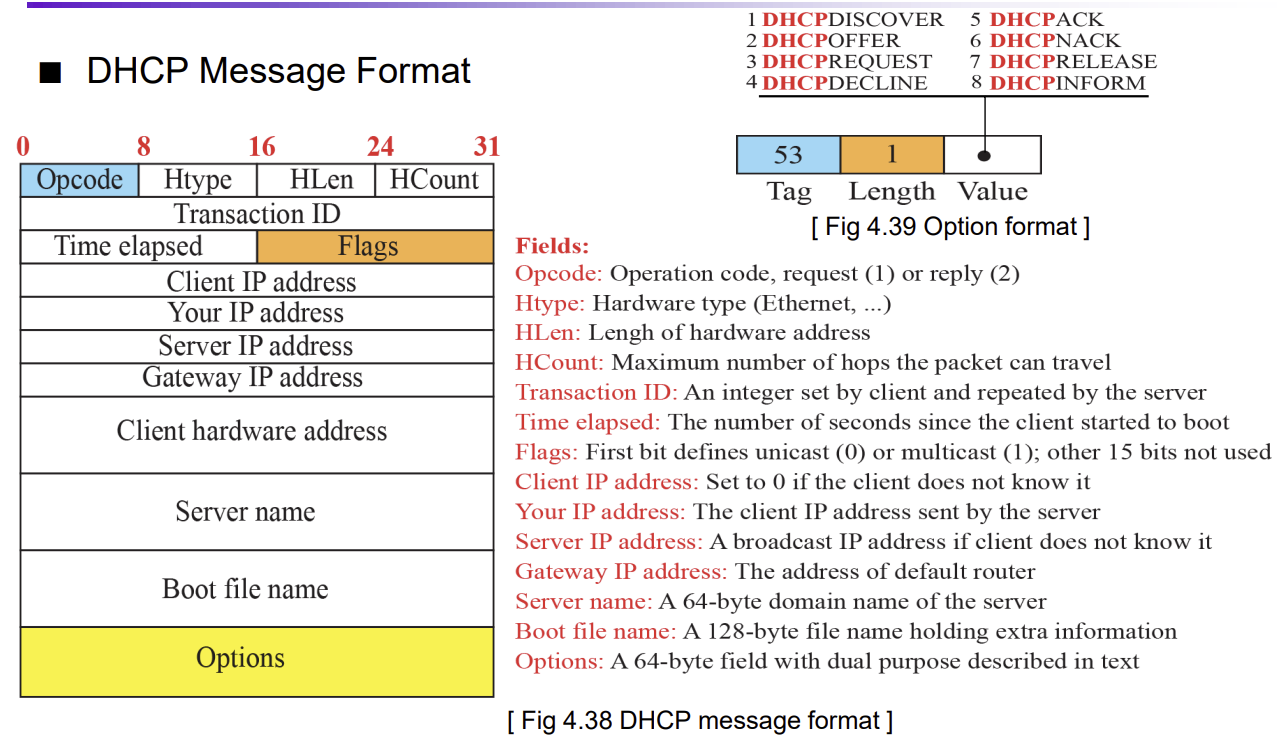
- Network에 들어오는 host는 DHCPDISCOVER message을 보낸다.
- DHCP server는 “your-IP-address” field에 제공해줄 IP address을 넣고 DHCPOFFER message으로 답장을 한다.
- Host는 여러 offer들을 받는데 이들중에서 최선의 offer만 받고 그 offer을 준 server에게 DHCPREQUEST을 보낸다.
- 서버는 DHCPACK으로 답장을 한다
NAT: Network Address Translation
Router의 기능 중 하나로 내부 네트워크에서 사용하는 Private address와 Internet의 universal address 간의 번역을 해준다.
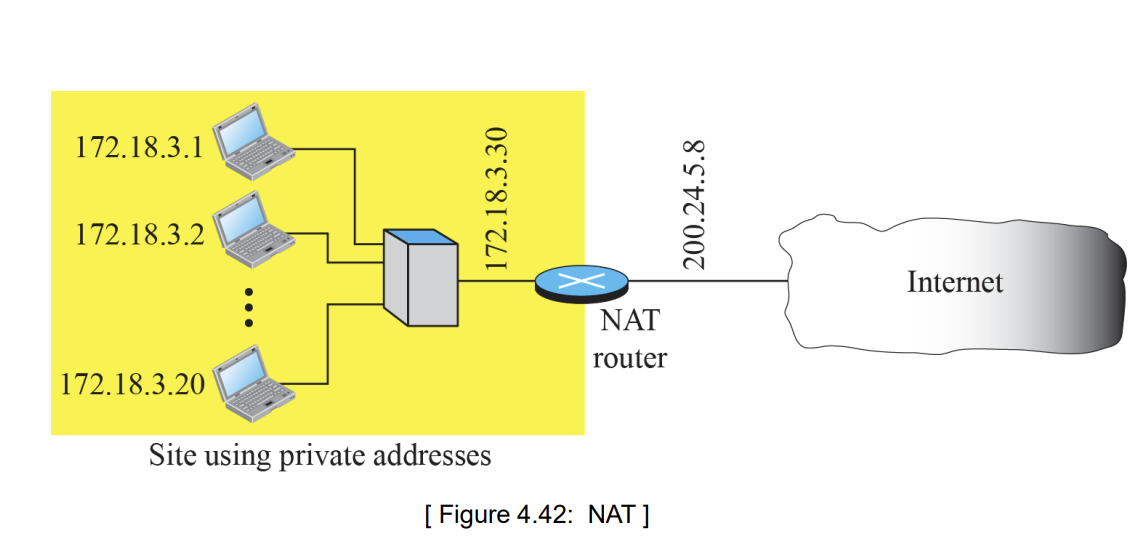
예를 들어, 172.18.3.1에서 Internet에 request을 보내도 NAT에 의해서 200.24.5.8으로 번역이 되고 Internet도 response을 보낼 때 200.24.5.8으로 보낸다. 이건 다시 NAT에 의해 172.18.3.1으로 번역된다.
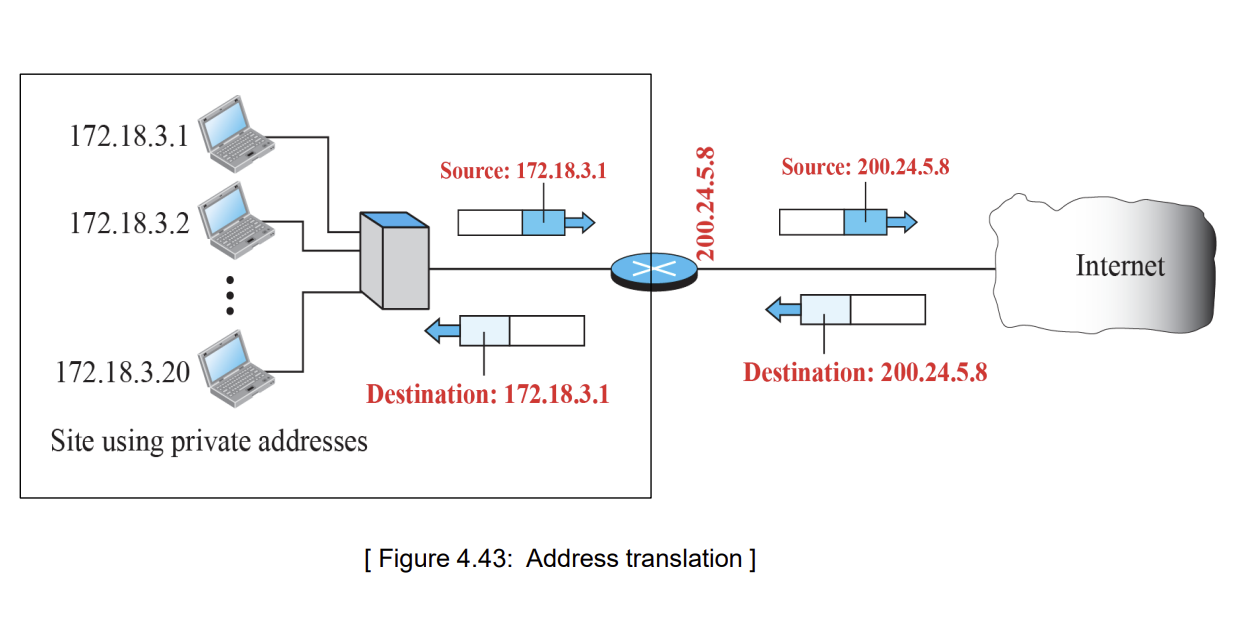
이 번역 정보를 기억하기 위해서는 이 mapping 정보를 translation table에 저장한다.
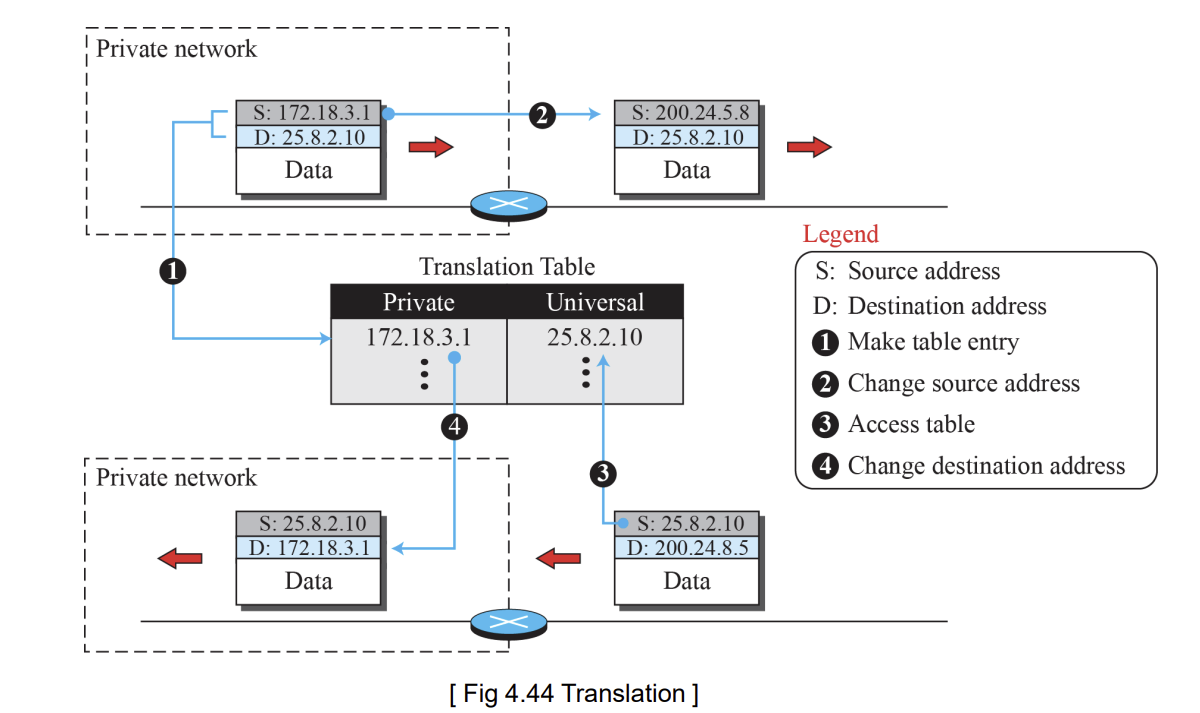
NAT는 IP 주소와 Port 주소까지 사용해서 many to many relationship을 가능하게 한다. 또, NAT는 source,destination IP, port address, 그리고 protocol 명까지 translation table에 저장한다.
Forwarding Methods
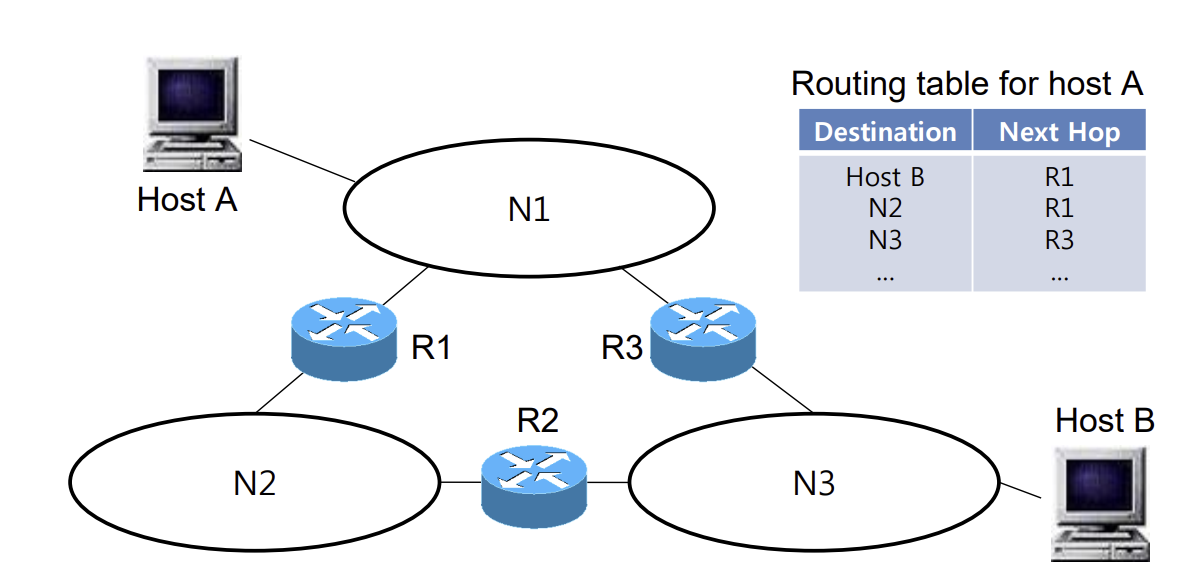
Forwarding은 router 안에서 input port으로 입력이 들어올 때 packet의 목적지를 분석해서 어떤 output port으로 이동시킬지를 결정하는 방법이다. 이 방법에는 총 4가지의 종류가 존재한다.
-
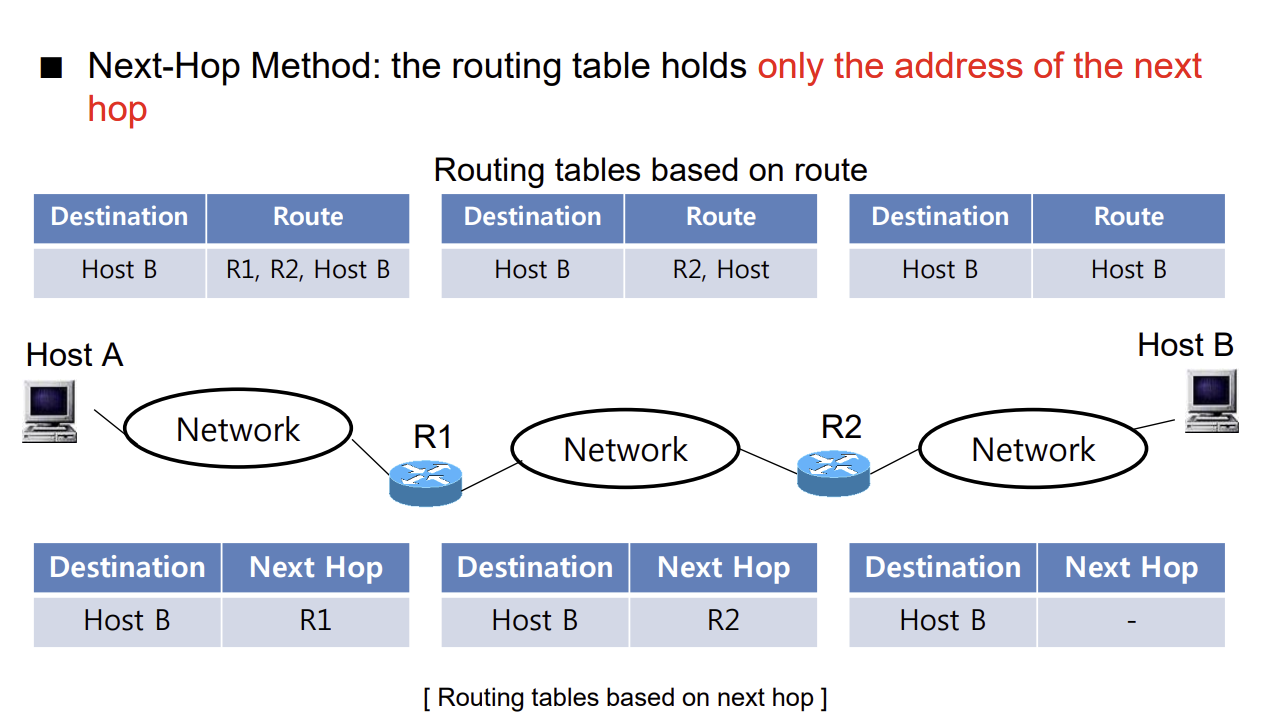
Next Hop Method
Next hop은 routing table에서 최종 목적지를 가기 위한 바로 다음의 라우터 주소만 저장한다
-
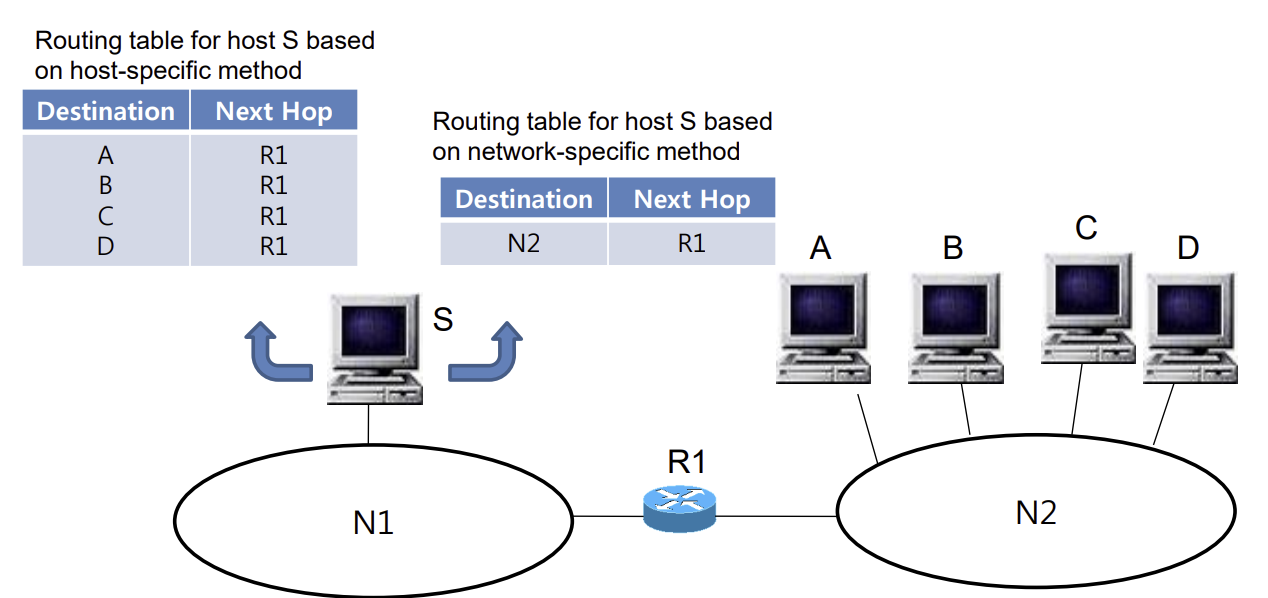
Network Specific Method
Destination이 속해있는 network의 주소만 저장한다.
-
Host Specific Method
Routing table에서 destination에 특정 host address을 저장하는 방법이다.
-
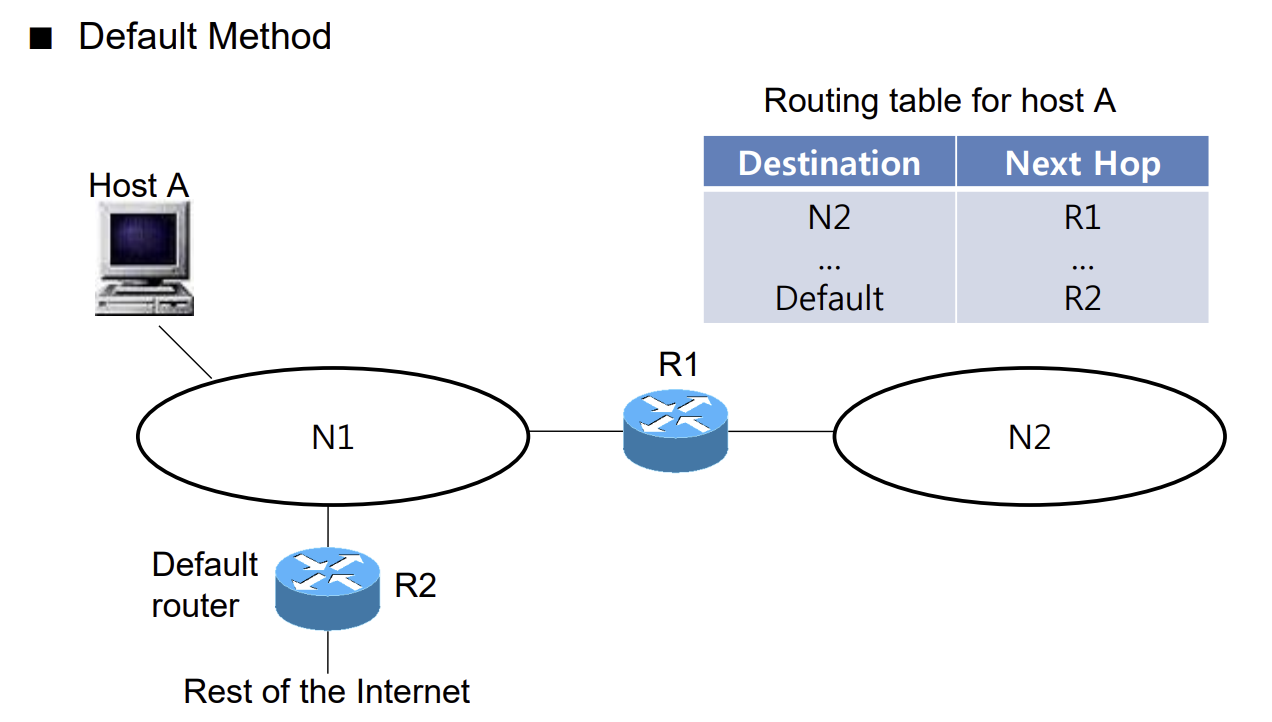
Default Method
그냥 나머지 destination들은 default으로 묶어서 처리하는 방법
Forwarding with Classless Addressing
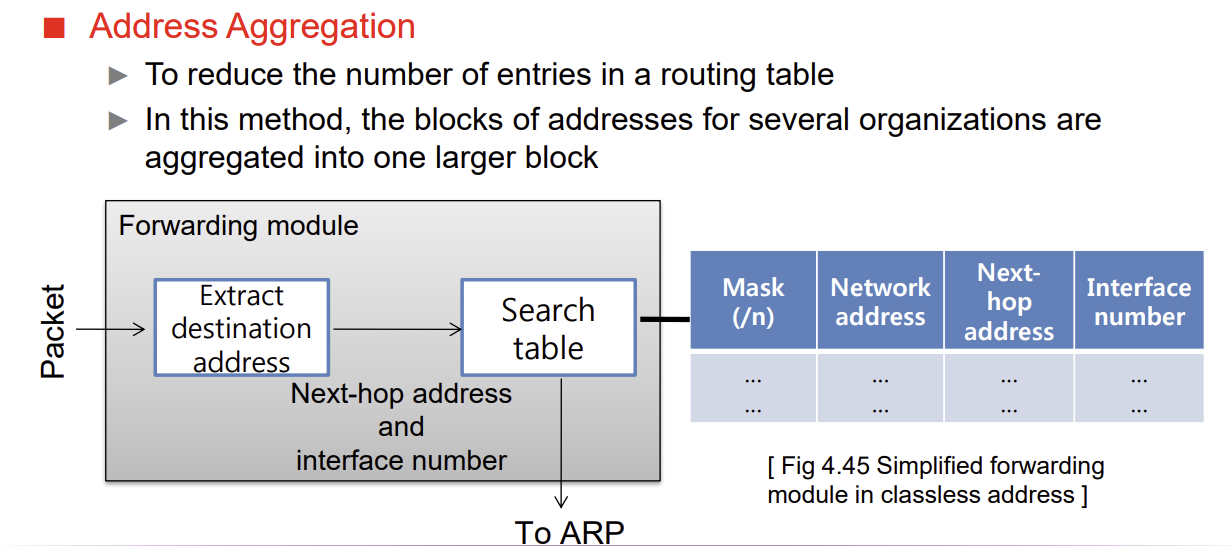
Classless Addressing에서는 network을 정의하기 위해 routing table에 mask 정보가 필수이다. 따라서 최소 4개의 column이 요구된다. (mask, network address, next hop address, interface number)
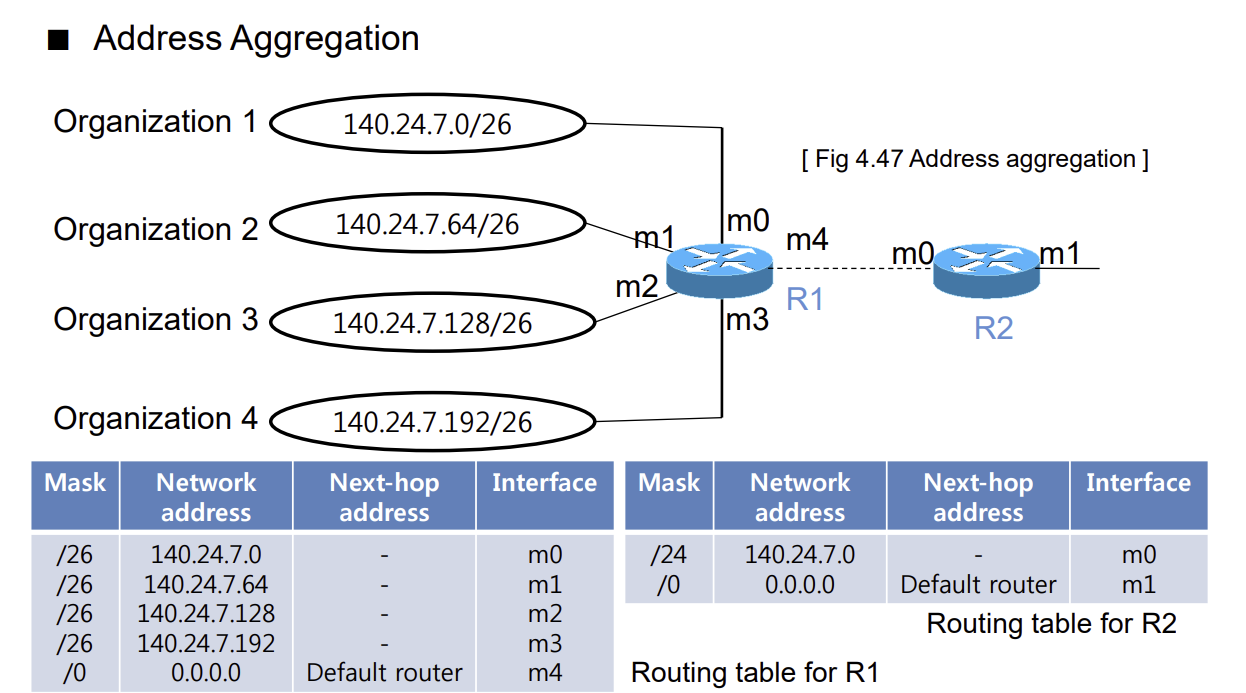
이러면 routing table을 저장하기 위한 메모리 요구량이 커진다. 이를 줄이기 위해서 address aggregation을 사용하는 것이다. 여러 organization을 위한 address blocks가 하나의 큰 block으로 대체되어 entry 양을 줄일 수 있다.
R2의 routing table에서 aggreagation이 일어나 entry 수가 줄어든 것을 볼 수 있다.
Forwarding based on Label
Classless address 기반 forwarding은 계산을 해야 하기에 forwarding 속도가 느려진다.
따라서 메모리 요구량을 줄이면서 속도까지 줄인 방법이 label 기반 forwarding이다. Connection oriented network에서는 switch가 packet에 붙은 label 정보로 forwarding을 한다.
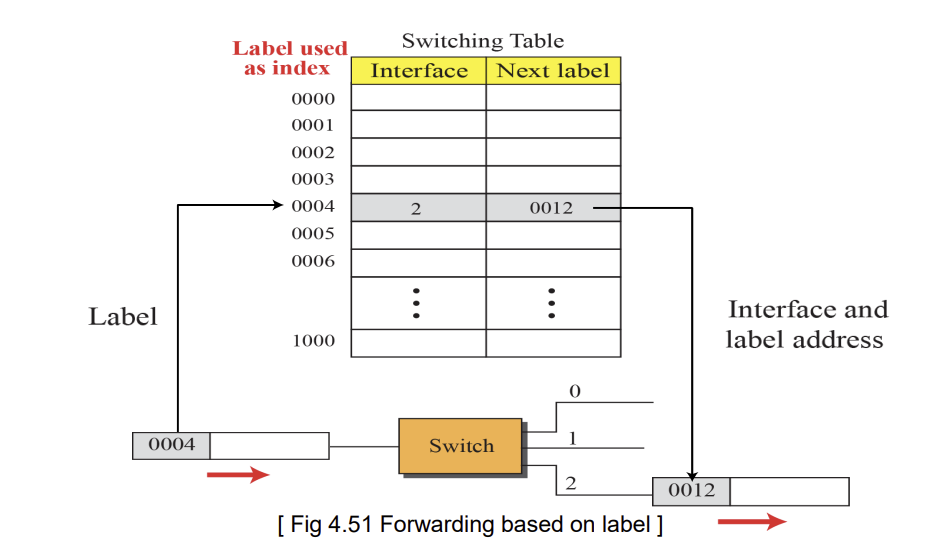
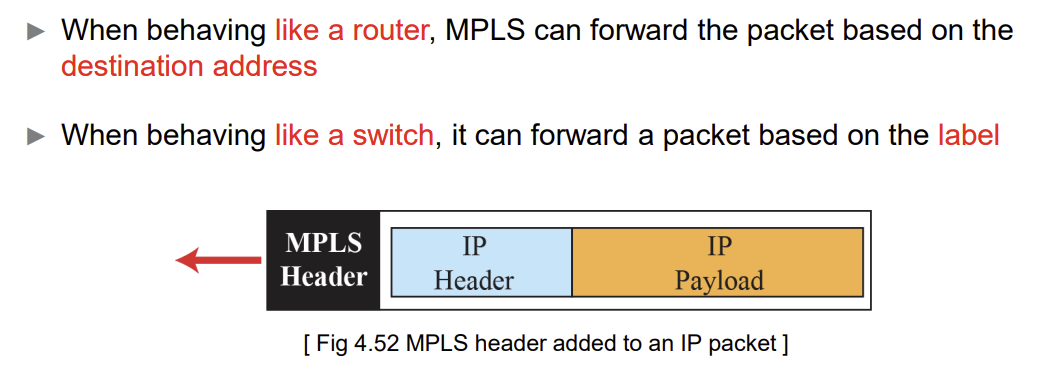
Label forwarding의 방법 중 대표적인 방법이 Multi Protocol Label Switching (MPLS) 이다. MLPS에서는 packet에 MPLS header을 기존 packet 구조 앞에 붙여서 전체 header을 읽지 않고도 label에 따른 forwarding / destination address에 따른 forwarding 모두 가능하다.
ICMPv4
Internet Control Message Protocol은 IP control에 없는 error reporting / correcting 기능과 error를 host에게 보고하는 기능을 추가해준다.
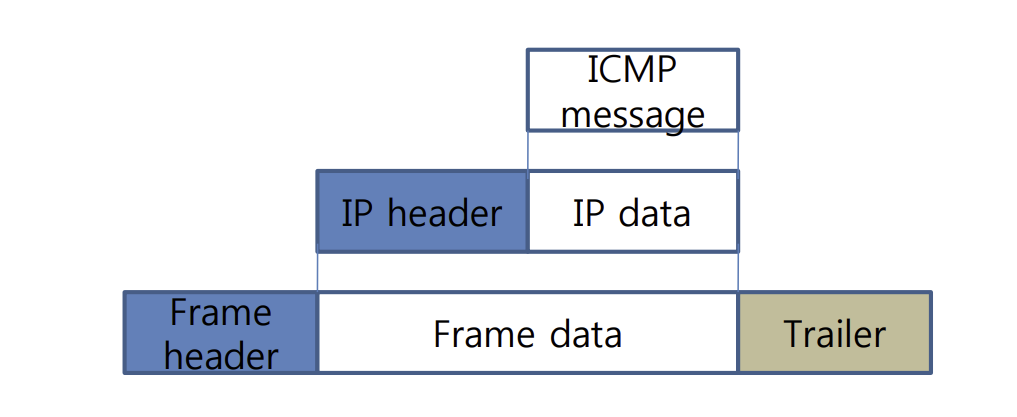
ICMPv4의 message는 IP data 안에 존재한다. 이 message의 종류는 두 가지로 나뉜다.
-
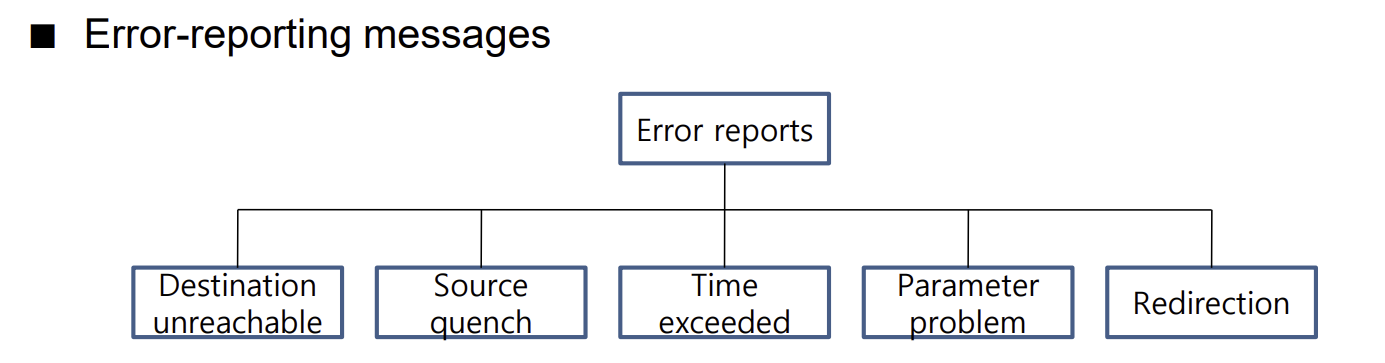
Error reporting
IP packet을 처리하면서 Router나 Host가 겪을 문제들을 알려준다.
-
Query
특정 router나 다른 host의 정보를 얻게 해준다.
ICMPv4의 message는 고정된 8 byte의 header와 varaible 크기 data을 가진다.
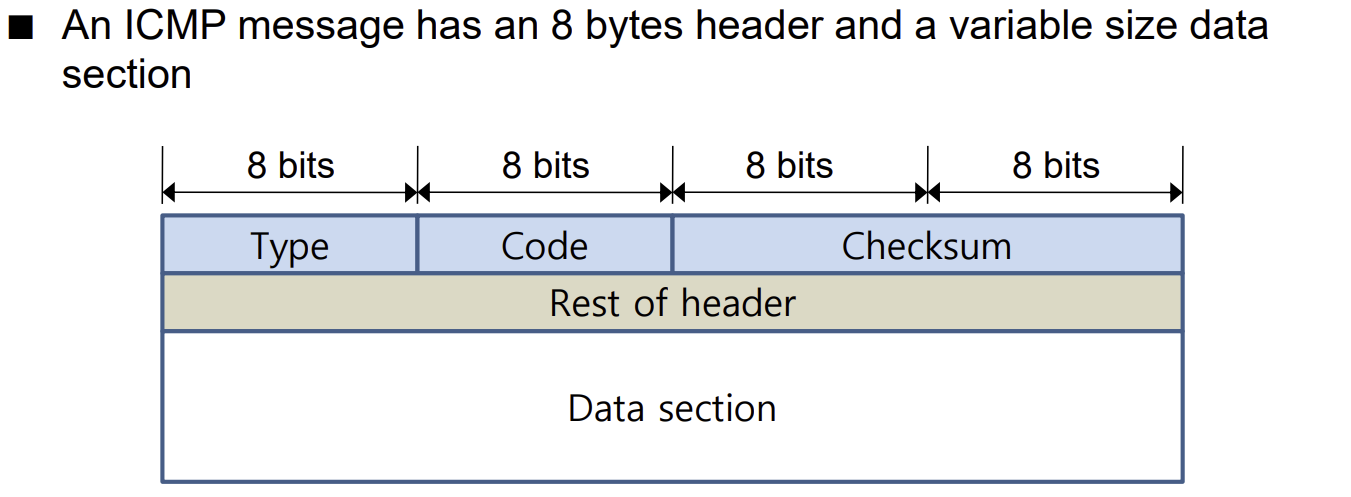
Data section에서 error난 packet의 정보와 query type에 따른 추가 정보가 들어있는 것이다.
-
ICMP 에러 메시지는 항상 최초 송신자에게만 전송된다.
-
ICMP 에러 메시지를 담고 있는 패킷에 대해서는 또 다른 ICMP 에러 메시지를 생성하지 않는다.
-
쪼개진 데이터그램의 경우, 첫 번째 조각이 아닌 나머지 조각들에 대해서는 에러 메시지를 생성하지 않는다.
-
멀티캐스트 주소를 가진 데이터그램에 대해서는 에러 메시지를 생성하지 않는다.
-
127.0.0.0이나 0.0.0.0과 같은 특수 주소를 가진 데이터그램에 대해서는 에러 메시지를 생성하지 않는다.
host에게 datagram이 전달이 아예 안 된 경우 / routing이 실패한 경우에는 datagram이 discard 되고 destination unreachable message가 source host에게 보내진다.
Program for ICMPv4
-
traceroute: packet의 source부터 destination까지의 route을 기록한다. route을 얻기 위해서 ICMP message와 TTL field을 사용한다.
-
ping: Host의 상태를 확인하기 위한 프로그램이다.
Routing Methods
데이터를 보낼 때 대상을 어떻게 지정하느냐에 따라 종류가 나뉜다.
Unicast Routing
One to one 전송일 때, 즉 출발지와 목적지가 1:1 대응일 때 unicast routing을 사용한다.
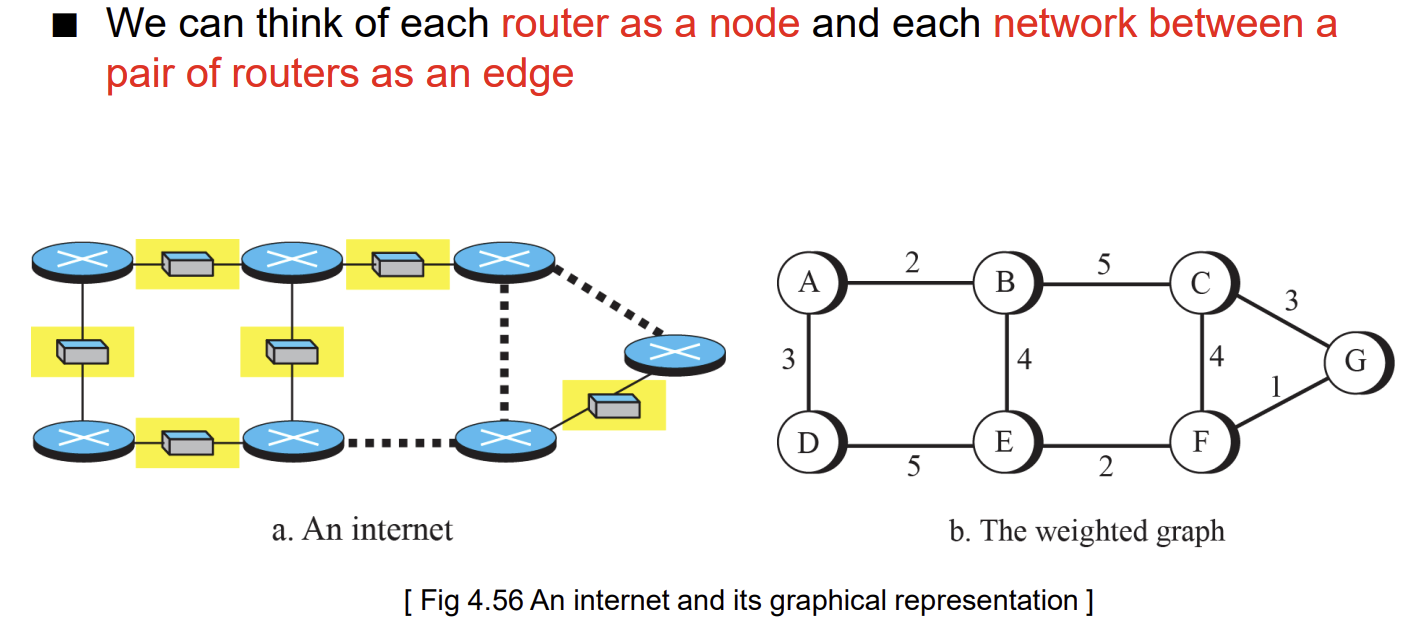
최적의 route을 찾기 위해서는 internet을 graph처럼 생각해서 router을 node으로, router들을 연결하는 부분을 edge라고 생각할 수 있다.
-
Least cost Routing
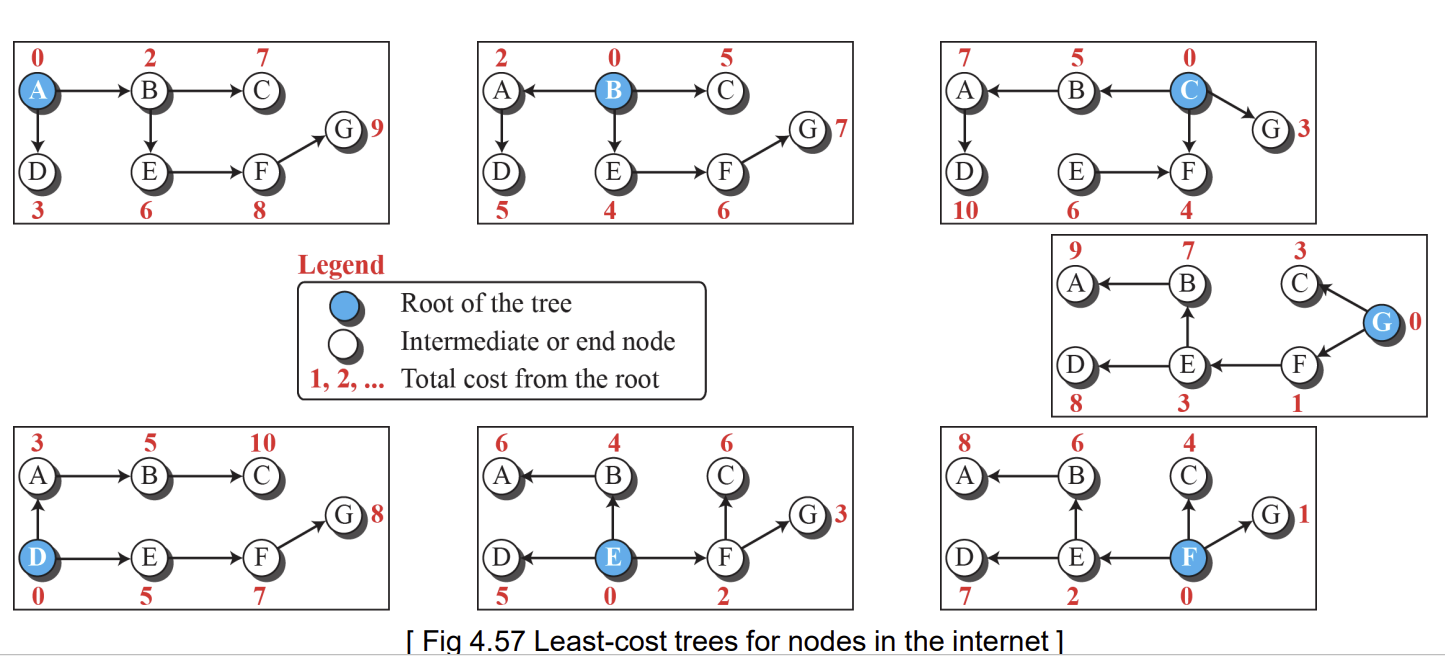
총 N개의 router가 있을 때, 임의의 router까지의 least cost path는 N-1 개이다. 그럼 Internet을 정의하기 위해서는 총 N(N-1) 개의 least cost path들을 얻어서 비교해야 한다.
최종적으로 각 source에 대해서 least cost tree을 얻는게 핵심이다.
-
Distance Vector Routing
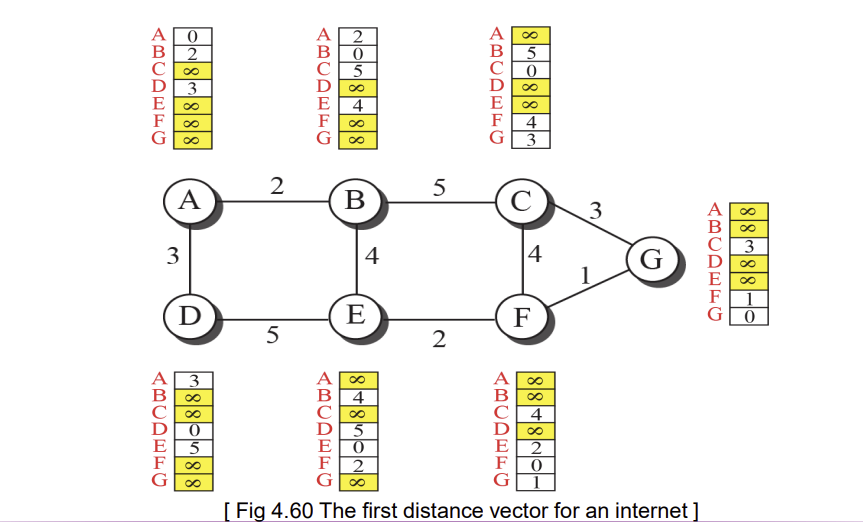
각 노드는 전체적인 거리 정보는 알지 못하고 이웃이 가진 정보만 안다.
각 노드마다 다른 노드까지 가는데 필요한 cost을 distance vector로 표시한 뒤에
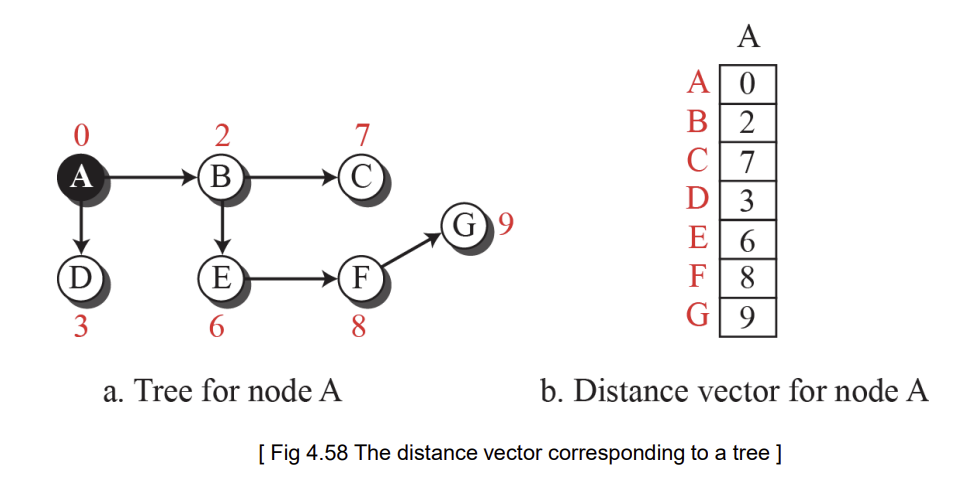
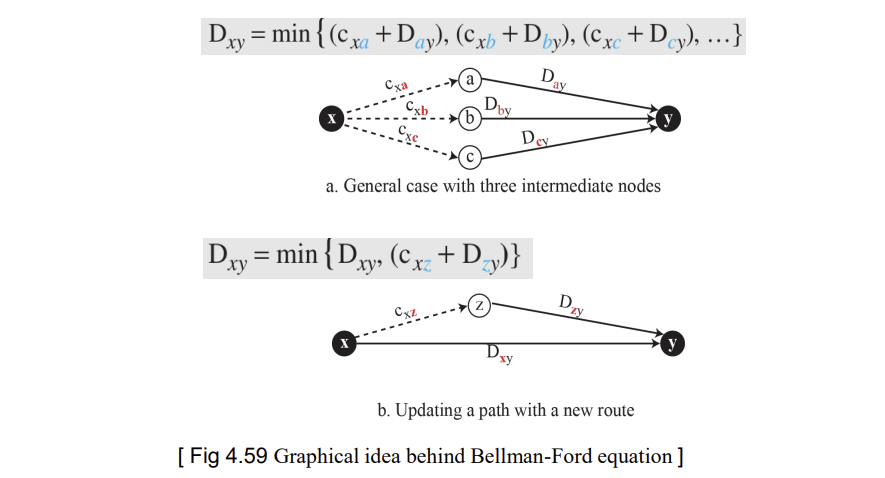
Bellman ford 알고리즘으로 z을 거쳐서 y까지 가는데 필요한 cost의 합 vs y로 직접 가는데 필요한 cost의 합을 계속 비교해가면서 shortest path을 알아내는 방법이다.
첫 시작은 다음과 같이 한다.
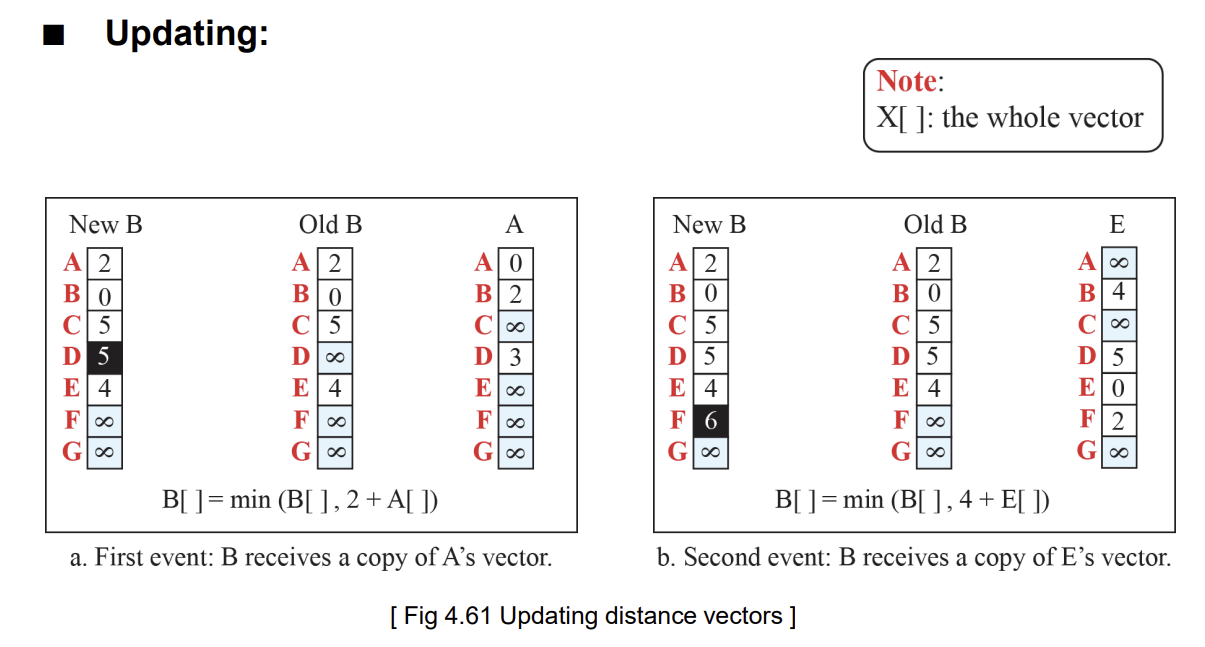
이때, 노드들끼리 각 노드에 가기 위해 필요한 cost 정보를 공유해야 distance vector들이 update 될 수 있다. 따라서 distance vector routing에서는 주기적으로 또는 변화가 있을 때 자기의 routing table을 인접한 node들과 공유하여 update한다.
Distance vector routing은 two node loop instability 문제가 있다. 두 node끼리만 계속 distance vector가 update 되면서 거리가 무한이 되는 문제이다.
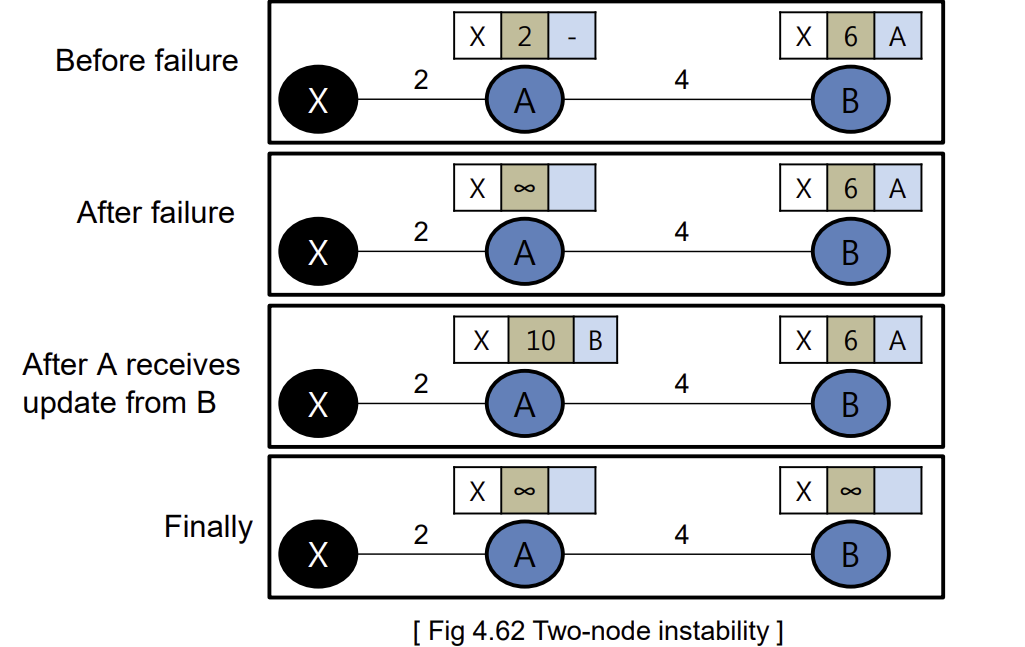
A에서 X로 가는 것이 fail하여 distance가 무한대로 update되었다고 하자. 그 다음 A에서 B을 거쳐서 X를 가는 방법과 A에서 X로 직접 가는 방법을 비교해서 distance을 6+4=10으로 update했다고 하자. 이 과정을 계속 반복하게 되면 계속 cost가 높아져서 결국 두 node 모두 무한대가 될 수 있다.
-
Link state Routing
Link state routing은 이웃의 정보만 가지고 거리를 update하는 방법의 infinite loop 문제를 해결한다. 이 방법은 차라리 모든 노드가 network 전체의 거리 정보를 갖게 한다.
Link state routing에서는 Link state databse LSDB을 만드는 것이 중요하다. Least cost tree을 생성하기 위해서는 각 노드는 network의 완전한 map을 가지고 있어서 각 link의 상태를 알고 있어야 한다. 따라서, 작은 network에서 효과적이다.
LSDB는 그냥 distance vector을 다 concatenate한 것과 같다.
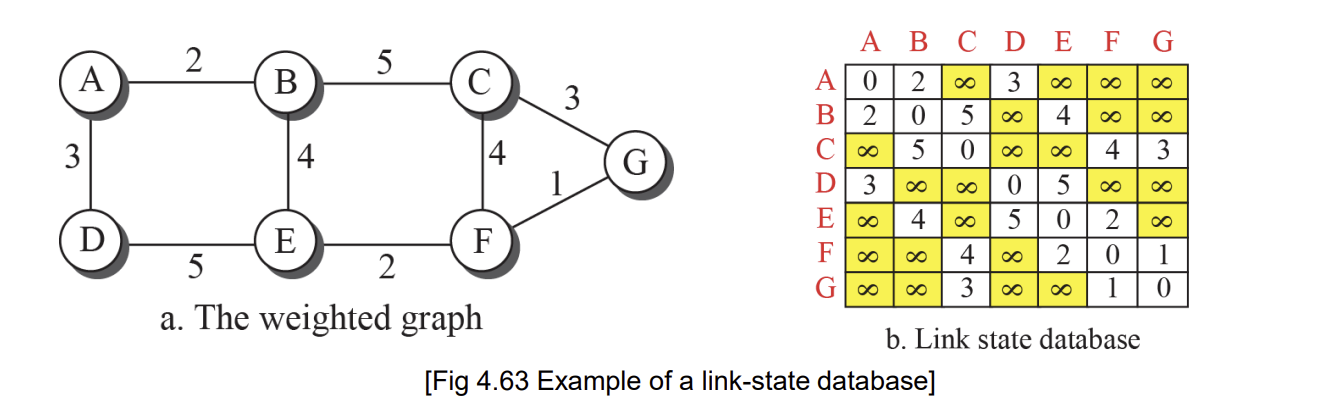
LSDB을 어떻게 구성할까? $\rightarrow$ Flooding을 통해 할 수 있다.
-
각 노드는 인접한 노드에게 자기가 몇 번 노드인지와 연결 link의 weight이 얼마인지를 알려준다. 이 두 정보를 LSP (LS packet)이라고 한다. 이 LSP는 sequence number를 갖고 있고 새로운 LSP가 생길 때마다 sequence number는 증가한다.
-
LSP을 받게 되면 기존의 LSP와 비교한 뒤, 새로운 LSP라면 기존 LSP을 버리고 새로운 LSP을 다시 자기의 인접 노드들에게 보낸다.
-
모든 새로운 LSP을 받게 되면, 각 노드에서 LSDB가 생성된다.
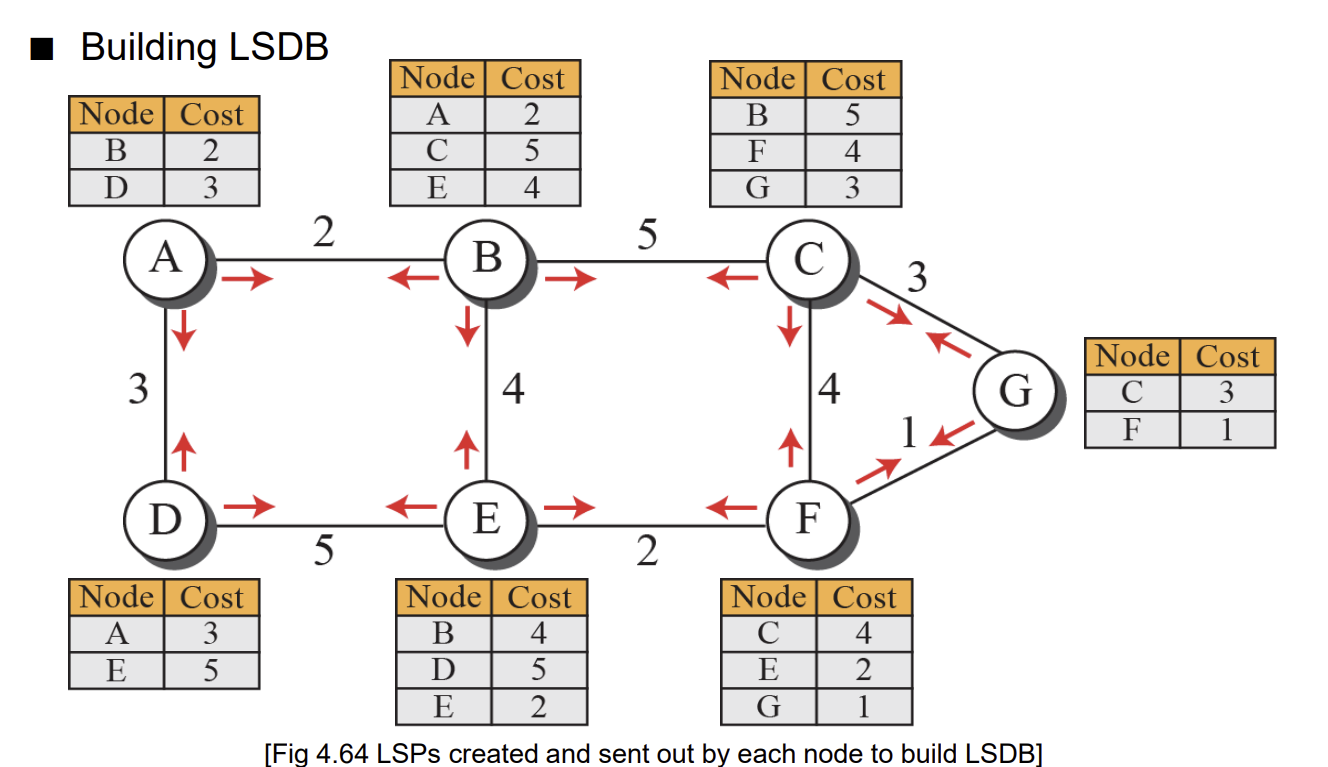
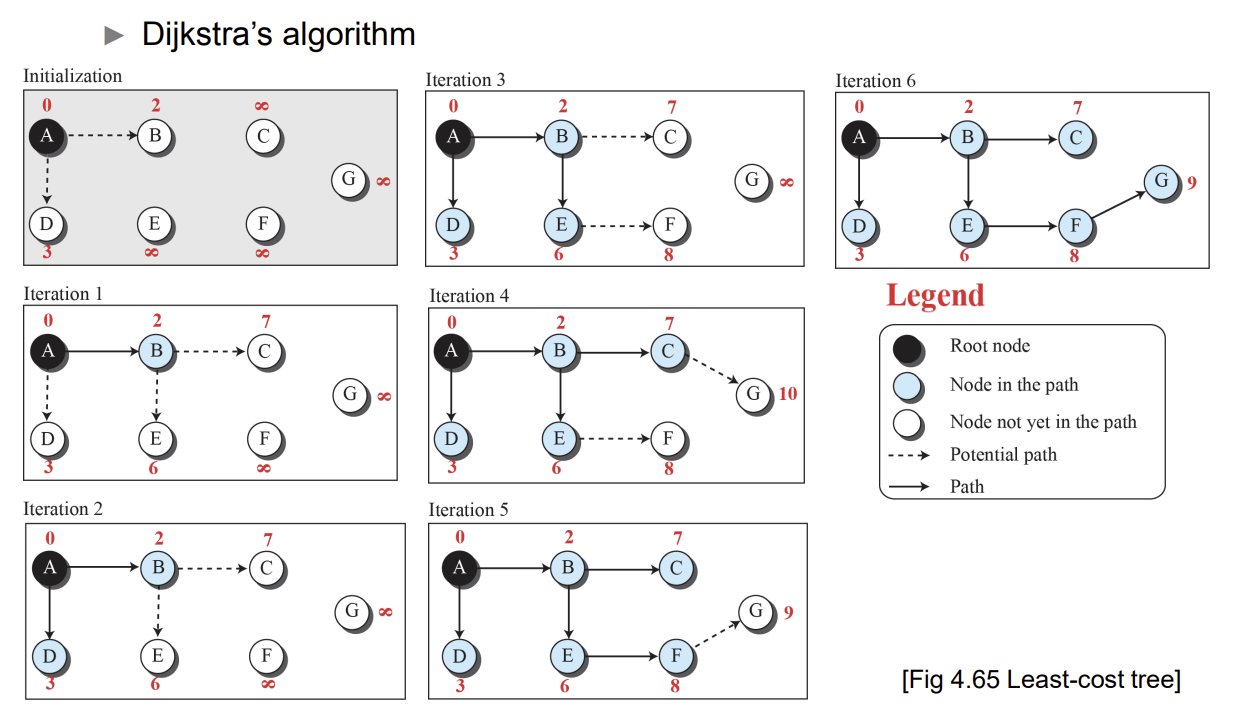
이 단계에서 dijkstra 알고리즘을 적용하여 shortest path tree을 얻을 수 있다.
Dijkstra는 다음 두 과정을 반복한다고 보면 된다.
-
연결된 노드들을 queue에 넣고 cost가 적은 애들부터 pop한다.
-
pop한 애들과의 거리를 update하고 queue에 넣는다
-
-
Path Vector Routing
Path vector는 least cost routing 기반이 아니고 ISP끼리의 packet route을 위해서 설계되었다. 단순히 가장 빠른 길을 찾는 것이 아니라, 특정 ISP는 거치지 않는다, 최소한의 노드만 거친다와 같은 관리자의 규칙에 따라 목적지까지의 경로를 결정하는 방법이다.
각 라우터(노드)는 오직 자신의 정책만을 만족하는 자신만의 경로 트리(Spanning tree)를 개별적으로 만드는데 다음 그림은 목적지에 도착하기 위해 최소한의 node 방문 policy을 만족하는 spanning tree의 예시이다.
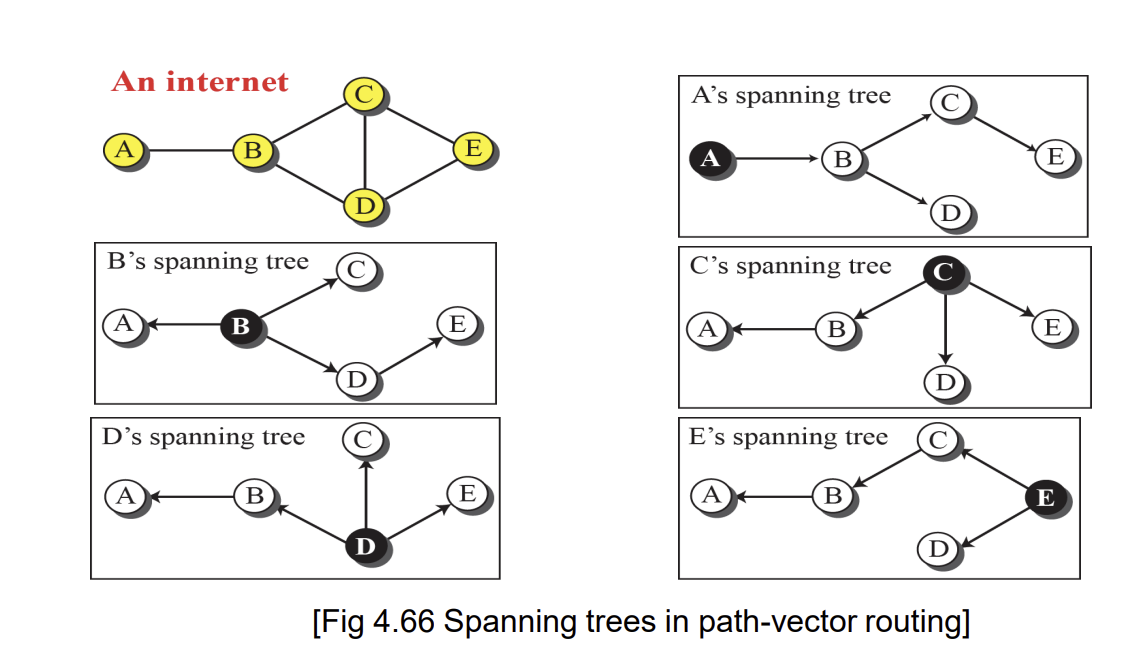
라우터가 처음 켜지면, 인사 메시지를 보내 이웃 노드들의 정보를 수집하고 자기 자신과 직접 연결된 이웃들의 정보만으로 초기 Path vector를 만든다. 그 다음, 만들어진 초기 벡터를 다시 모든 이웃에게 전송해서 path vector을 update한다.
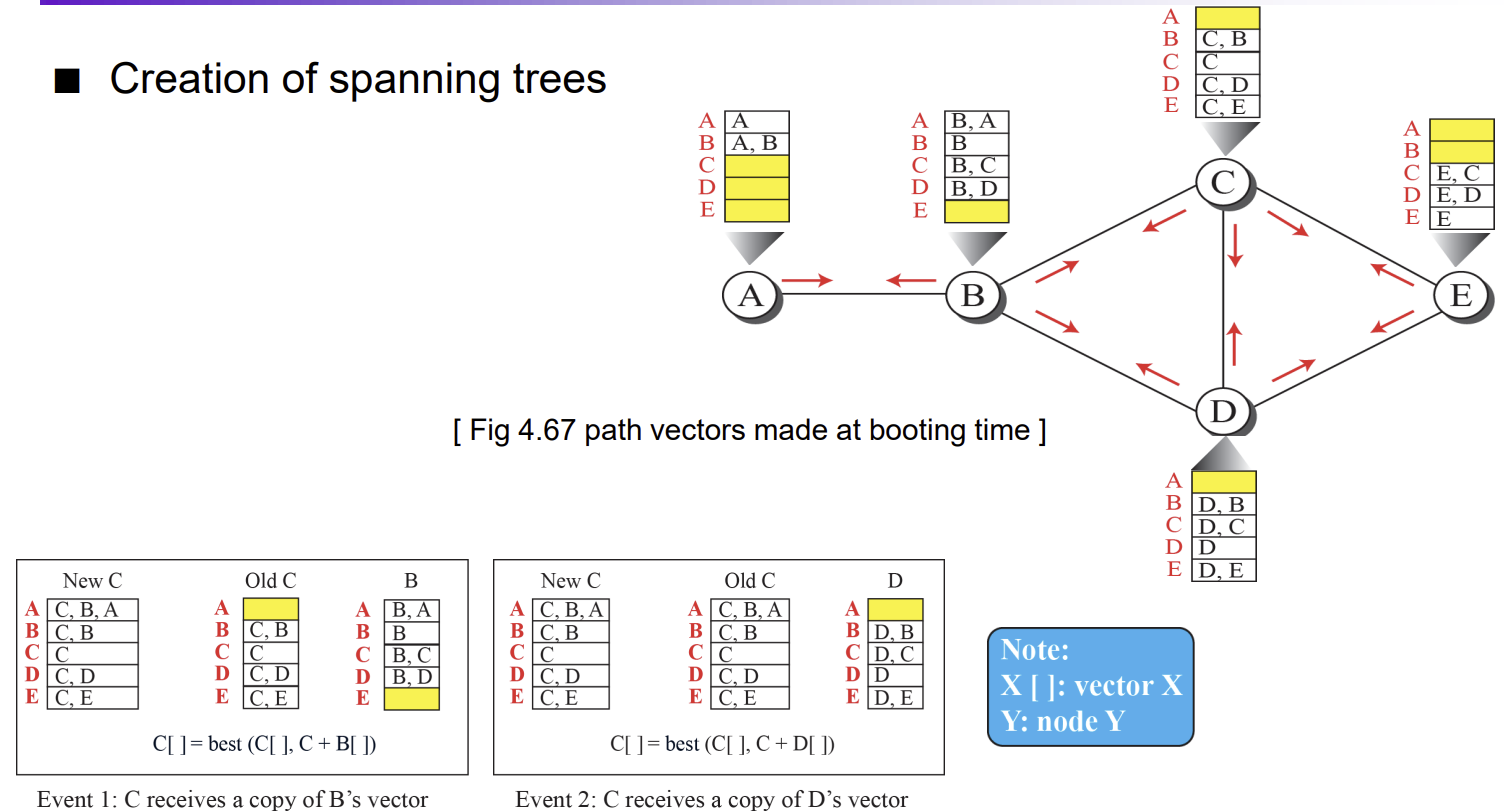
Unicast Protocols
Internet의 구조
-
Backbones: Global connectivity
-
Provider Network: lower level에서 customer network에 connectivity 제공
-
Customer Network: Provider network가 주는 service을 사용하는 주체
이들은 모두 ISP라고 불릴 수 있지만 level이 다를 뿐이다.
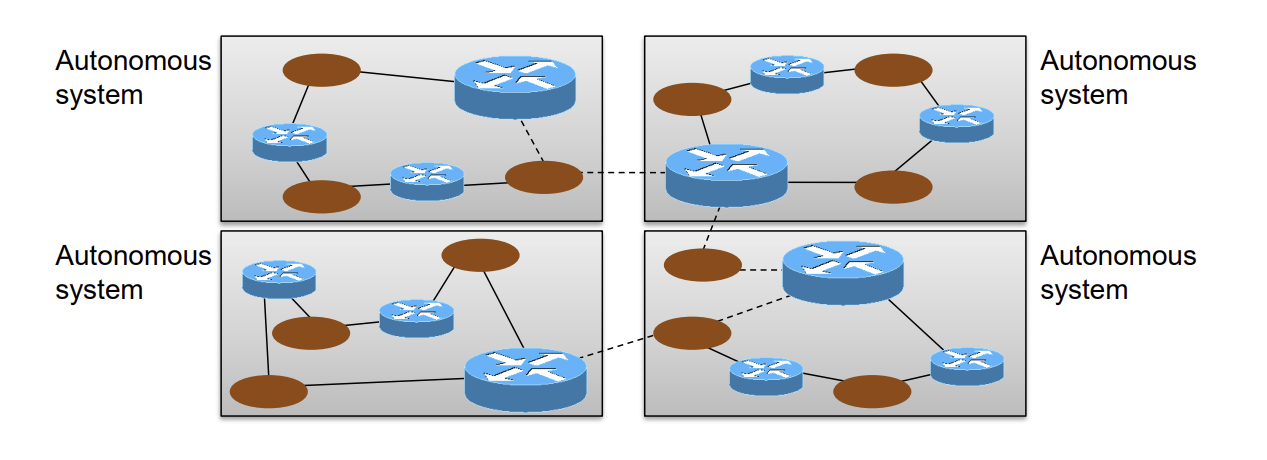
Internet은 routing을 효율적으로 하기 위해서 관리 구역 (Autonomous system AS = ISP)을 기준으로 나누고 hierarchical 하게 routing을 수행한다.
AS 내부에서 routing을 intradomain routing이라고 하고 AS끼리의 routing은 Interdomain routing 이라고 한다.
-
Routing Information Protocol (RIP)
Intradomain routing으로 distance vector 기반이다.
이때 cost을 number of hops, 즉 거쳐야 하는 network (router) 수로 둔다. Cost의 최대값은 16으로 infinity와 동일하다고 간주한다.
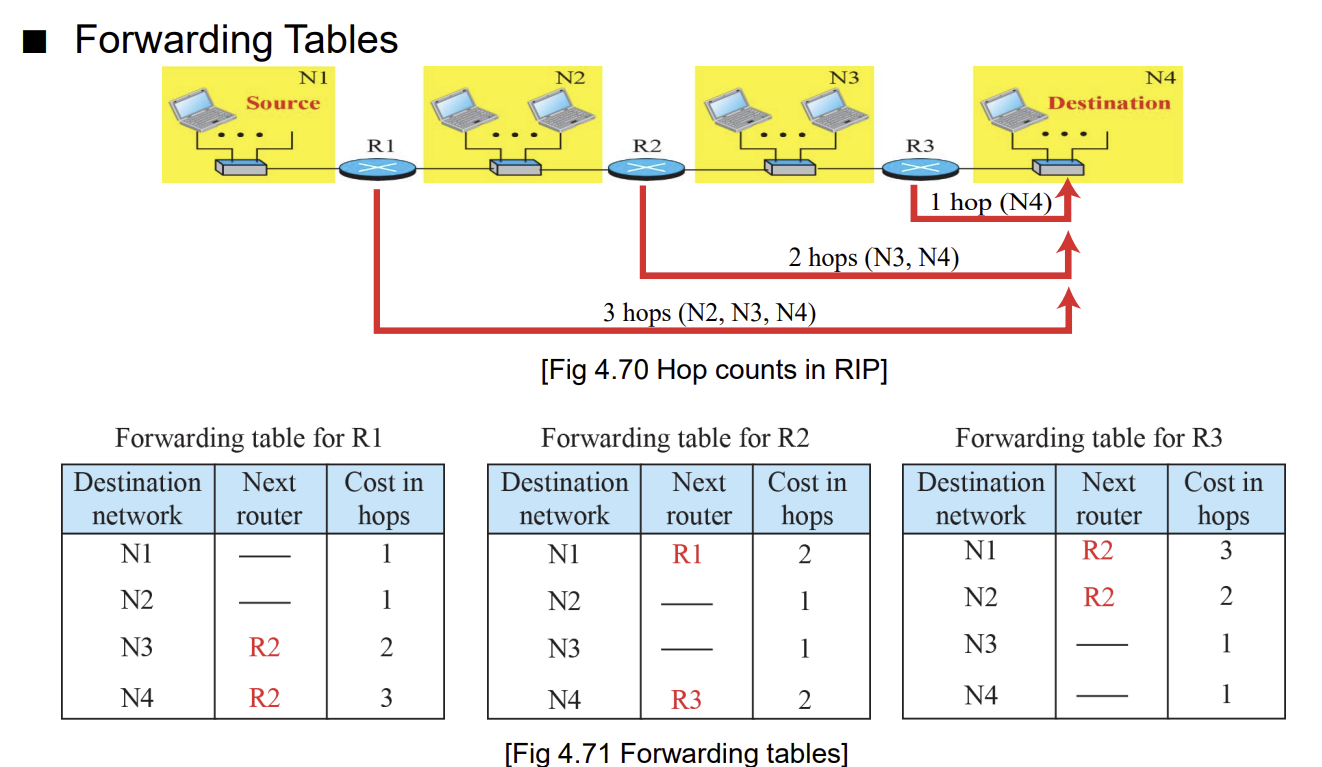
R1을 기준으로 보면, R1에서 N1과 N2와는 직접 연결되어 있기에 cost가 1이지만 N3에 도달하기 위해서는 R2을 거쳐야 하기 때문에 cost가 2가 된다.
RIP는 application layer에서 실행되지만 forwarding table은 network layer에서 생성한다.
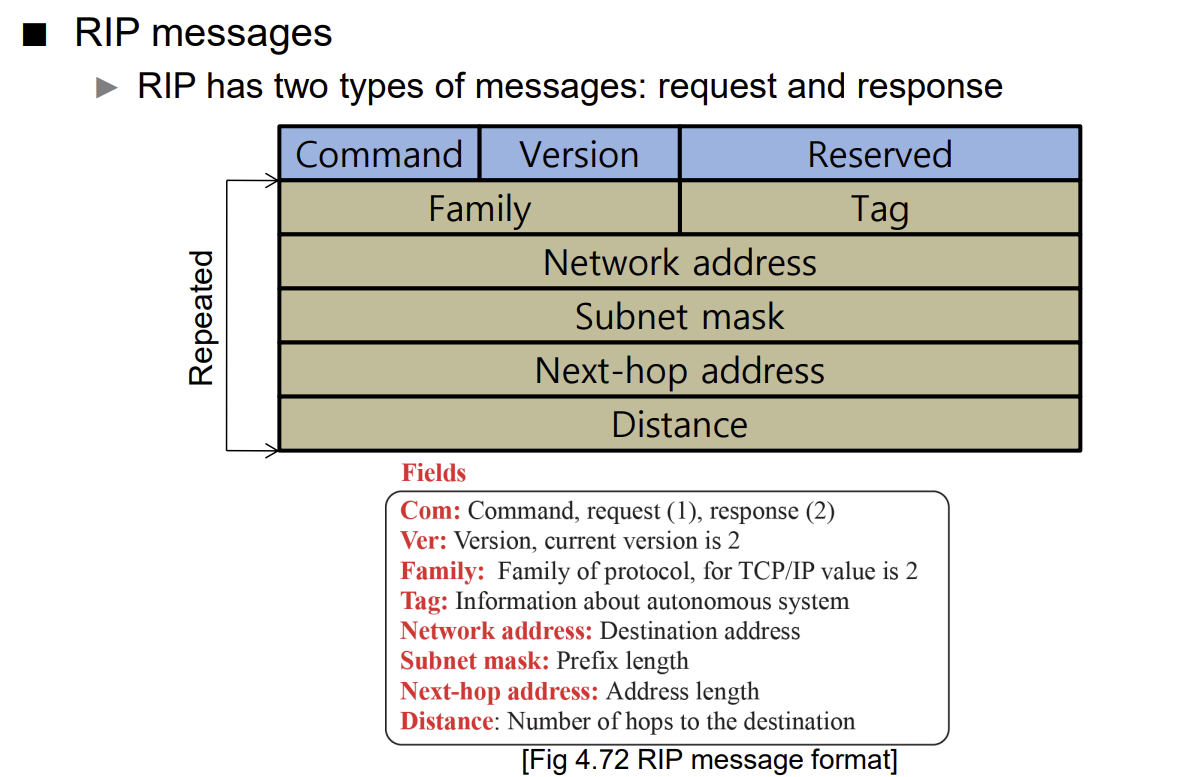
RIP messsage에는 두 종류가 있다.
-
Request: Routing 정보를 요구하는 message으로 주로 방금 켜진 router나 timeout entries가 많은 router에 의해 생성되고 보내진다.
-
Response: 라우팅 테이블을 남에게 전달하는 메시지으로 Request에 답변만 하는 solicited와 주기적으로 또는 변화가 있을 때마다 답변을 보내는 unsolicited으로 나뉜다.
RIP의 알고리즘은 다음처럼 작동한다고 이해하면 된다.
-
B는 A에게 자기의 routing table 전체를 준다
-
A는 B가 X까지 n칸(Hop) 걸린다는 정보를 바탕으로 자기의 routing table을 update한다 ex) 일단 B한테 한 칸 이동해야 하니까, 나는 X까지 총 n+1 걸리겠다.
-
A는 routing table에 X로 가려면 거쳐야 할 다음 router는 B라고 저장한다.
즉, 전달받은 이웃의 forwarding table을 보고 더 최적의 길을 발견하면 그 table 값에 cost에 다 1을 더한 것을 자기의 table로 만든다고 보면 된다. (그 이웃을 거쳐야 하므로)
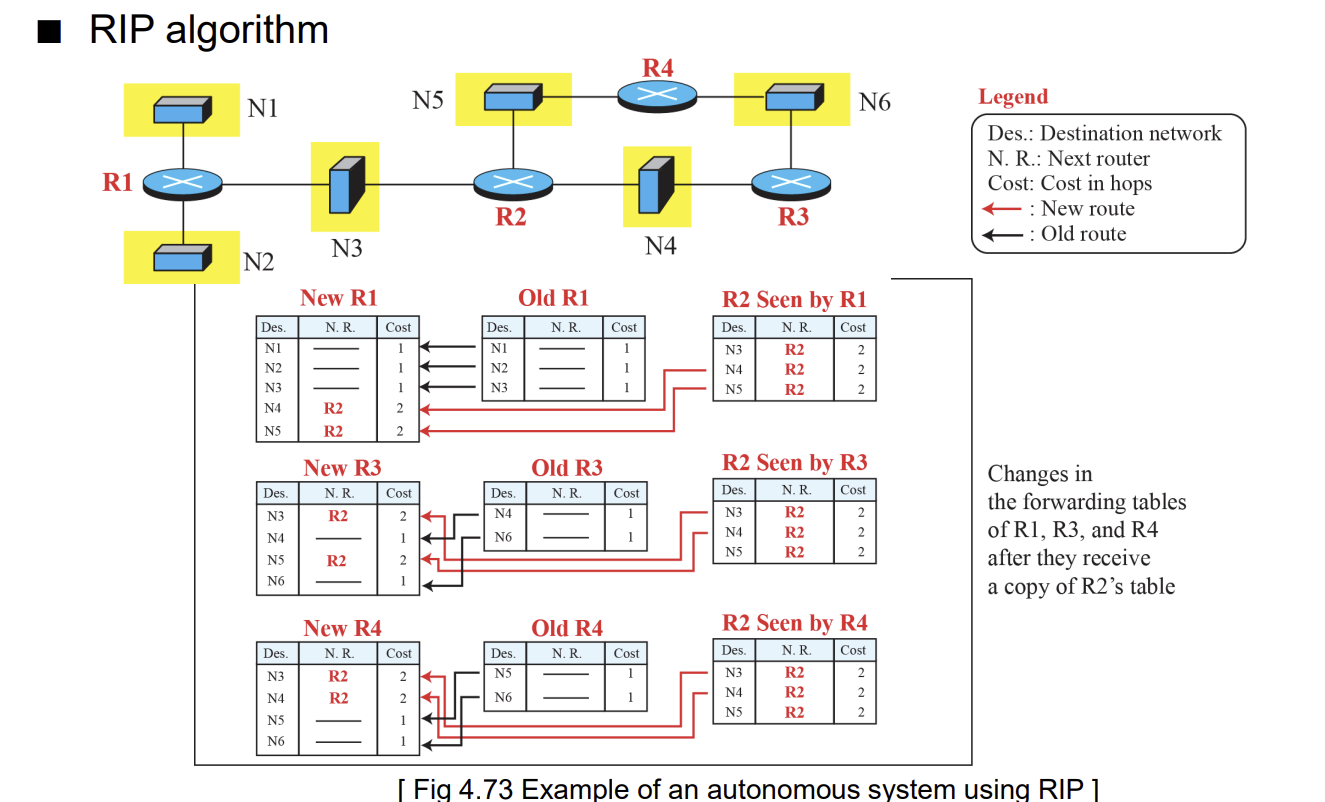
Update의 정확한 rule은 다음과 같다.
-
새로운 길이 발견되면 바로 update한다.
-
더 빠른 길이 발견되면 바로 update한다.
-
가지고 있던 길보다 cost가 높더라도 가지고 있던 route가 그 이웃을 지나야 하는 route라면 cost가 높은 길로 update한다.
-
-
Open Shortest Path First (OSPF)
Intradomain routing protocol이며 link state routing protocol을 사용한다.
각 link의 weight는 throughput, RTT, hop count 등 다양하게 고려한다.
각 라우터는 네트워크 전체의 상태를 파악한 뒤, 다익스트라 알고리즘을 돌려 자신을 기준으로 목적지까지의 Shortest-path tree를 얻는다.
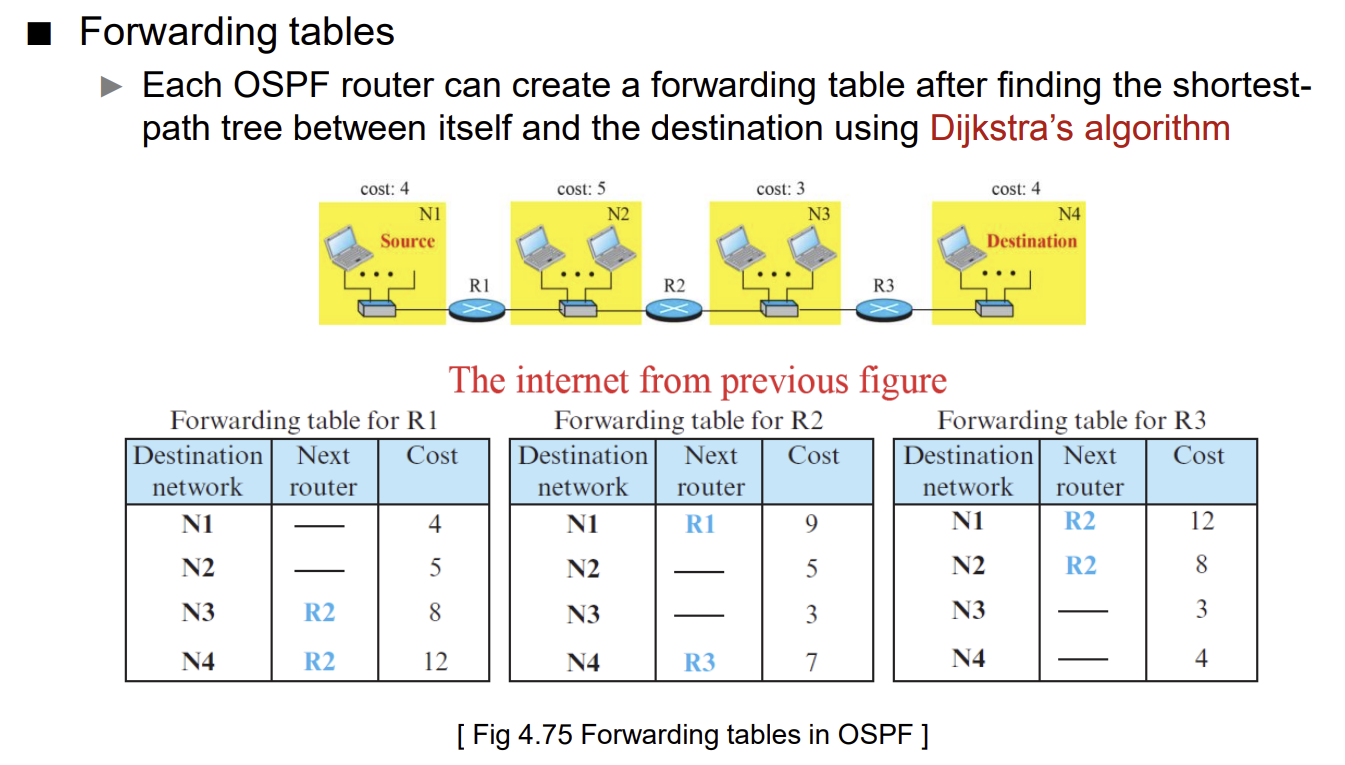
OSPF는 Autonomous system (AS)을 여러 Area 단위로 나눠서 routing 복잡도를 줄인다.
-
Area 0 (Backbone): 모든 area는 backbone과 연결되어 있어야 한다.
-
Area border router: Area의 정보들을 요약해서 다른 Area로 전달하는 역할을 한다.
-
AS boundary router: 현재 AS와 외부 AS을 이어주는 역할을 한다.
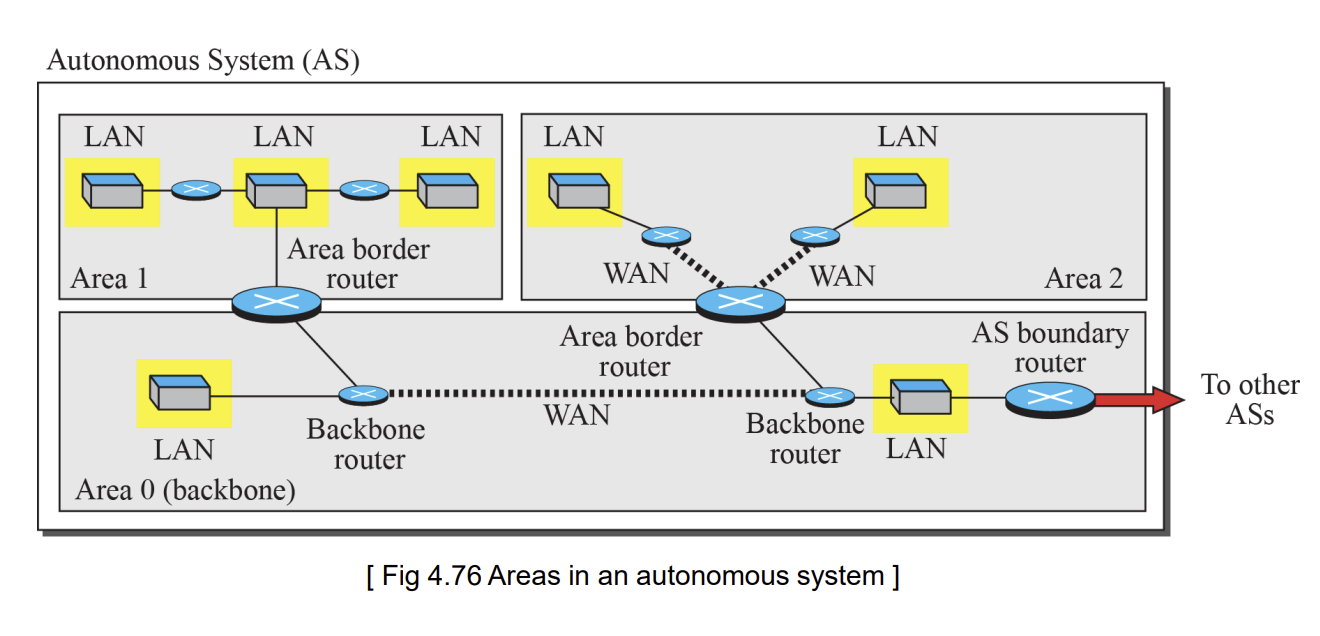
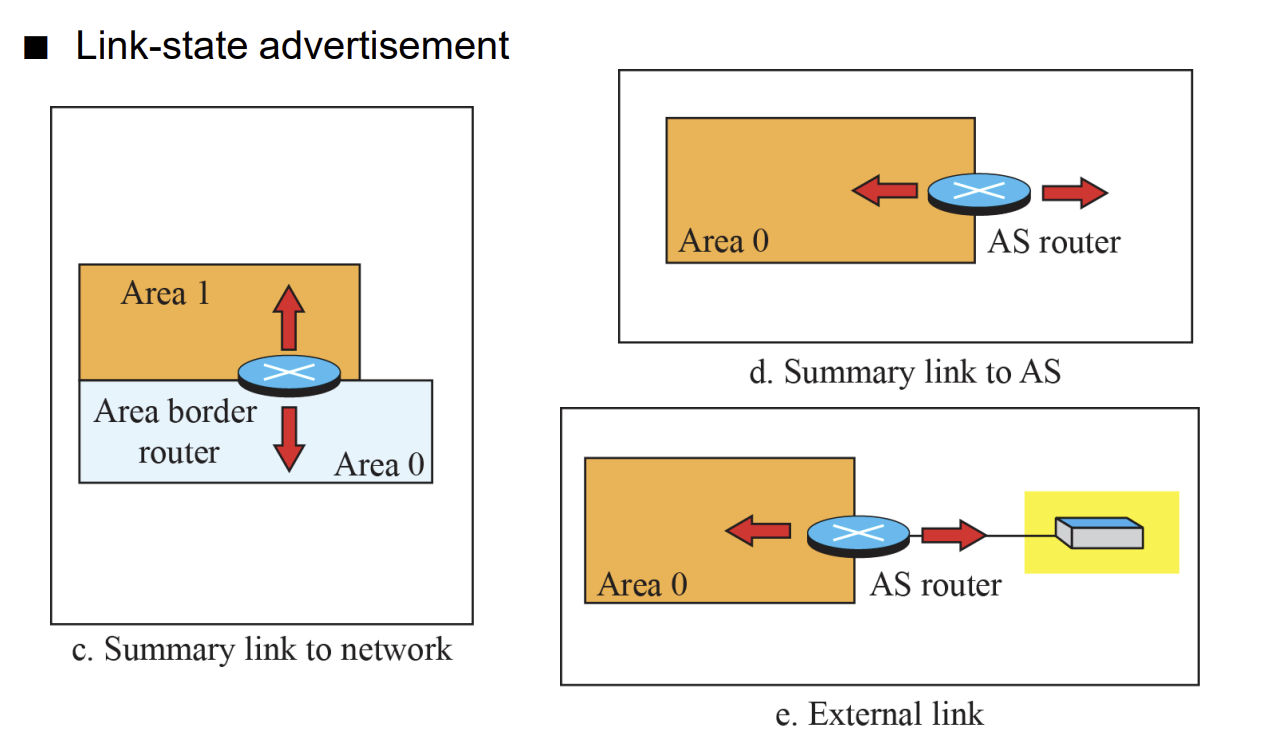
이웃에게 link state을 알려주기 위해서 5가지의 link을 사용한다.
-
Router link: Existence을 알려주는 link
-
Network link: 네트워크 자체를 하나의 노드로 취급하여 알리는데, 네트워크 스스로는 말을 할 수 없으므로 Designated router가 대신 알려준다.
-
Summary link to network: Area border router가 자기 area의 정보를 backbone에 전달하거나, 반대로 backbone의 정보를 자기 area으로 가져올 때 사용된다.
-
Summary link to AS: AS boundary router가 외부 시스템에서 가져온 요약 정보를 backbone에 전달할 때 사용된다.
-
External link: AS boundary 라우터가 AS 외부에 있는 단일 네트워크의 존재를 알릴 때 사용된다.
OSFPF는 network layer에서의 program이다.
OSPF messages
-
Hello message: 이웃들에게 존재 알리기
-
Database description message: hello message의 답장으로 이웃들이 전체 지도(LSDB)를 넘겨줄 때 사용
-
Link-state request message: 특정 링크의 상태 정보가 필요할 때
-
Link-state update message: LSB build을 위한 정보 보내기
-
Link-state acknowledgment: 잘 받았다고 확인 메세지
-
Multicasting Routing
Source는 하나고 destination이 여러개일 때
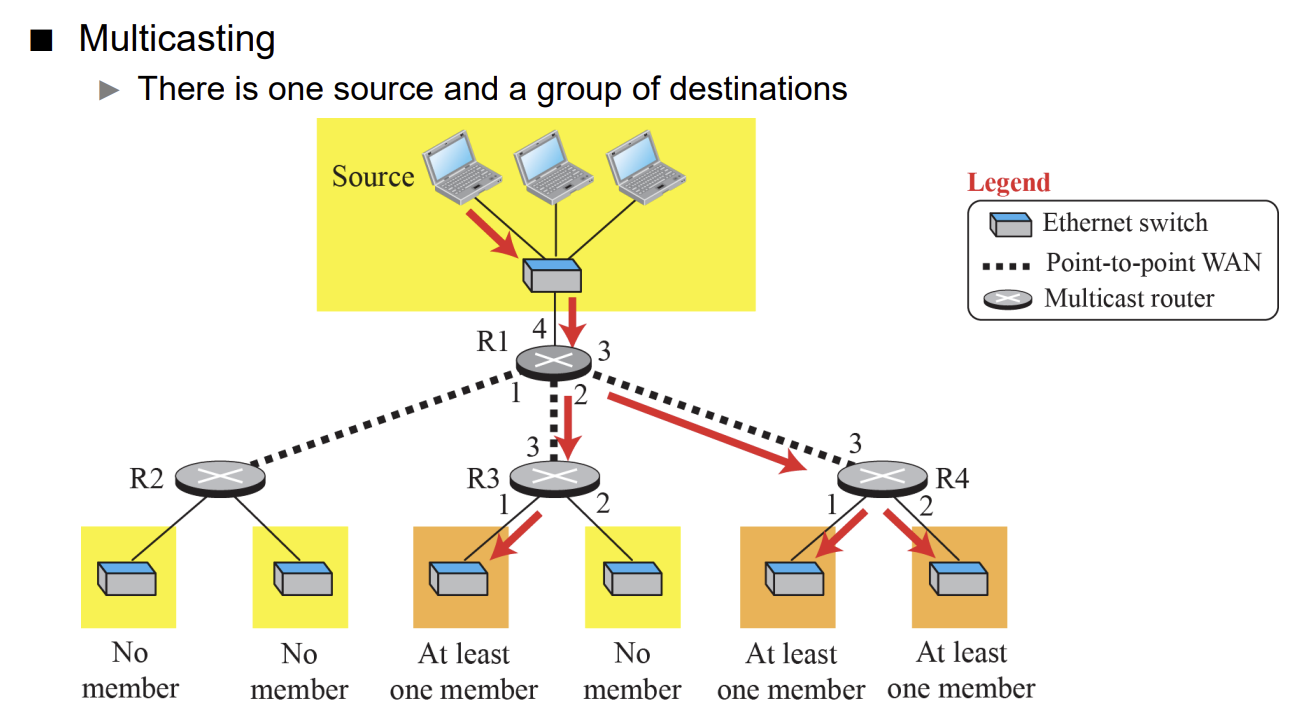
Multicasting은 한 packet이 router에 의해 복사되어 보내지고 multiple unicasting은 그냥 source가 여러 packet을 보내는 것
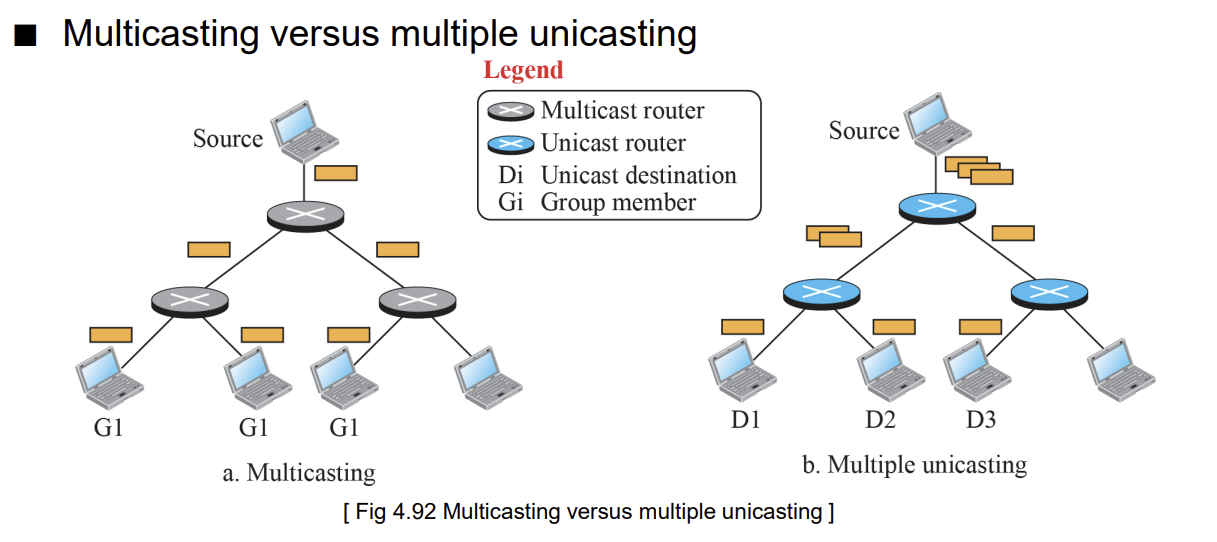
Broadcast는 네트워크 전체에 보내는 것이고 multicast는 여러 receiver가 있지만 특정해서 보내는 것이다. Broadcast는 internet level에서 주는 것이 아니다.
그렇다면 하나의 packet이 복사되는데 어떻게 여러 host에게 보내질 수 있을까? $\rightarrow$ multicast address field을 사용하면 가능하다.
Multicast address는 packet을 보낼 group을 정의해주기 때문이다. Multicast address도 32 bit으로 다음과 같이 구성된다.
Internet Group Management Protocol : IGMP
이런 multicasting과 group에 대한 network layer protocol이 바로 IGMP이다.
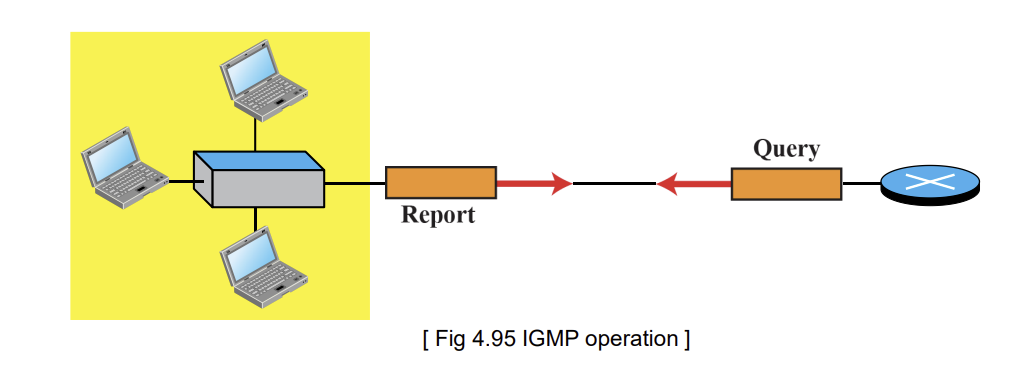
Group membership에 대한 정보를 모으는 protocol이라고 생각하자. 2번째 auxiliary network layer protocol이다. IGMP message도 IP datagram에 encapsulate 된다.
IGMP message에는 두 종류만 존재한다: Report, Query
-
Query
연결된 모든 host들에게 multicast group에 들어올 생각이 있는지를 물어보는 역할읋 하는 message이다.
세 종류로 나뉜다.
-
General query: 아무 group에 대한 membership에 참여할 의향이 있는지 묻는 것이다.
-
Group specific query: 특정 group에 대한 membership에 참여할 의향이 있는지 묻는 것이다.
-
source and group specific query: 특정 source에서 오는 message을 받을 특정 group에 대한 memebership에 참여할 의향이 있는지 묻는 것이다.
-
-
Report
Query에 대한 답장 message으로 host가 소속되고 싶은 group의 정보들을 담고있다.
Multicast forwarding에서는 destination address가 group을 의미하지만 그 group 내에는 여러 member들이 있기에 unicast와 다르다. Multicasting에서 forwarding이 잘 되기 위해서는 destination과 source address을 모두 고려해서 forwarding을 해야 한다.
IPV6
IPV6는 IPV4의 address 부족 문제를 해결하기 위해 새로 제안된 version이다. Address는 128 bit으로 IPv4와 비교했을 때 $2^{96}$ 배 더 큰 address space을 가진다.
IPv6에서의 차별점을 요약하면
- 큰 address space
- Header에서 필수인 부분과 option들을 분리해서 routing 과정을 더 빠르게 하였다. (Routing에 필요한 부분만 읽고 처리할 수 있게 함)
- 더 많은 option 추가
- Extension 고려
- support for resource allocation
- support for more security: encryption and authentication optons
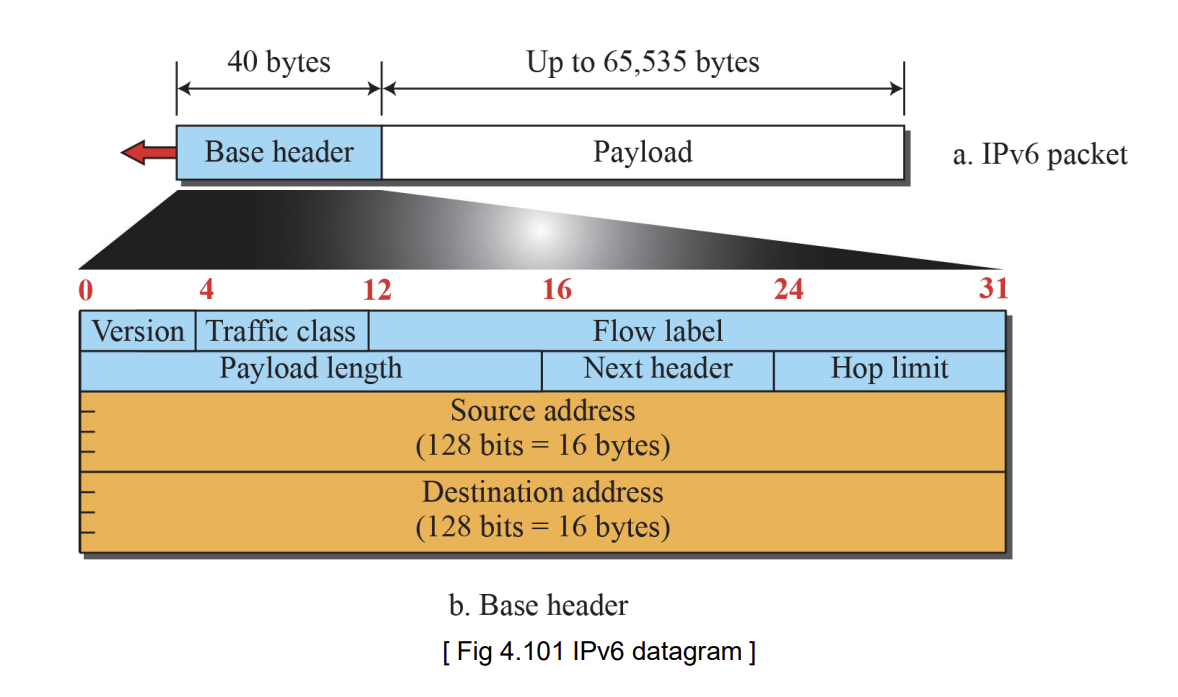
- Traffic class: Datagram의 우선순위
- Payload length: header을 제외한 IP datagram의 길이
- Next header: Upper layer protocol 정의
IPv6에서 flow label은 IPv6을 connection oriented (virtual circuit)으로 사용되도록 추가된 것이다.
IPv6는 IPv4와 달리 오직 source에서만 fragment 가능하고 router에서 불가능하다. 또 extension headers가 추가된 것이 중요하다.
IPv6의 address visual도 다르다.
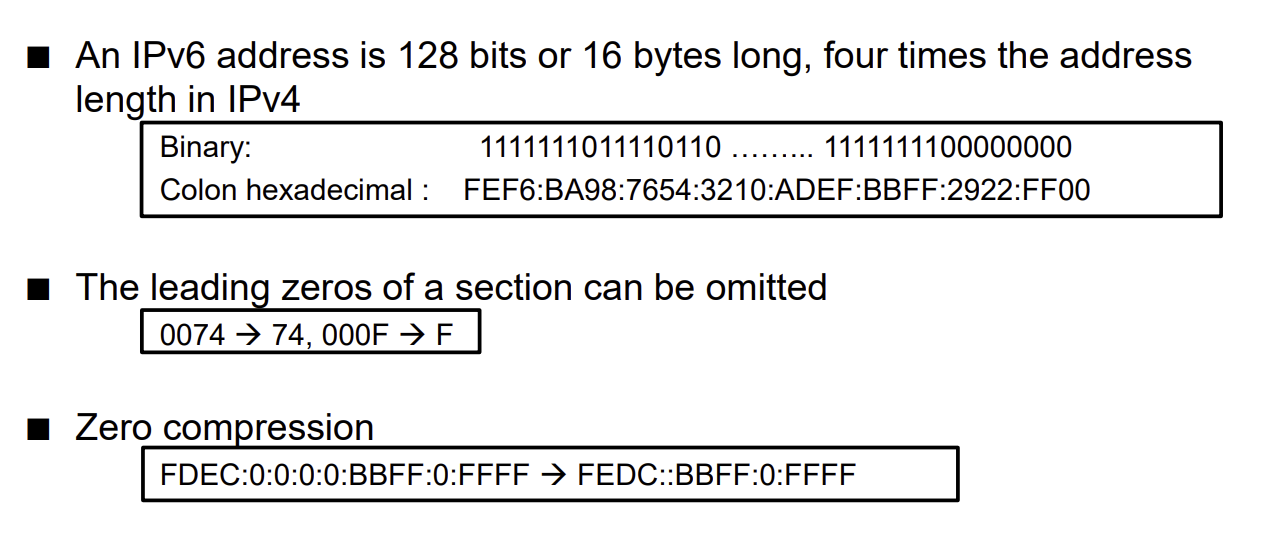
IPv6는 address type으로 unicast, anycast, multicast을 지원하며 hierarchical addressing을 사용한다.
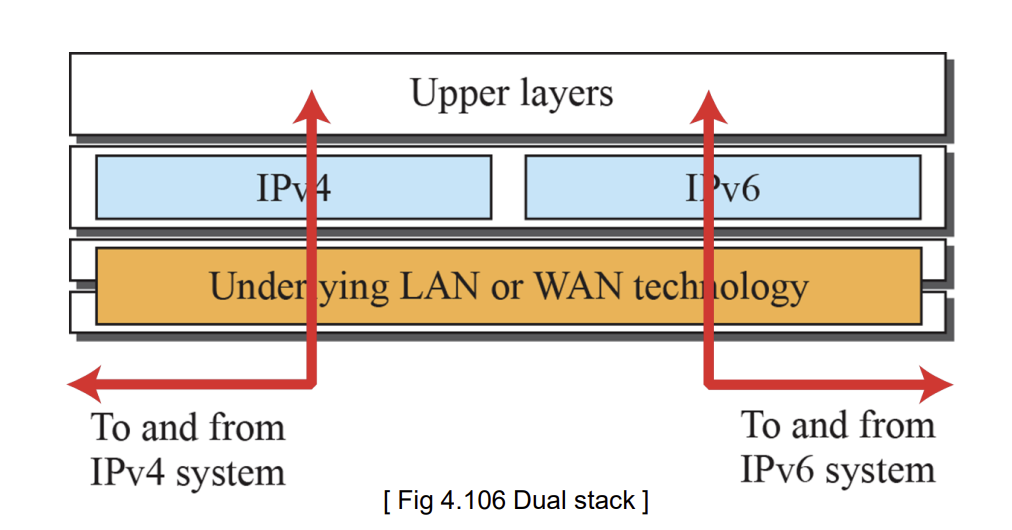
Dual stack
IPv4을 사용하다가 바로 IPv6을 적용시키는 것보다는 두 version이 coexist할 수 있도록 dual stack이라는 것을 설계하였다.
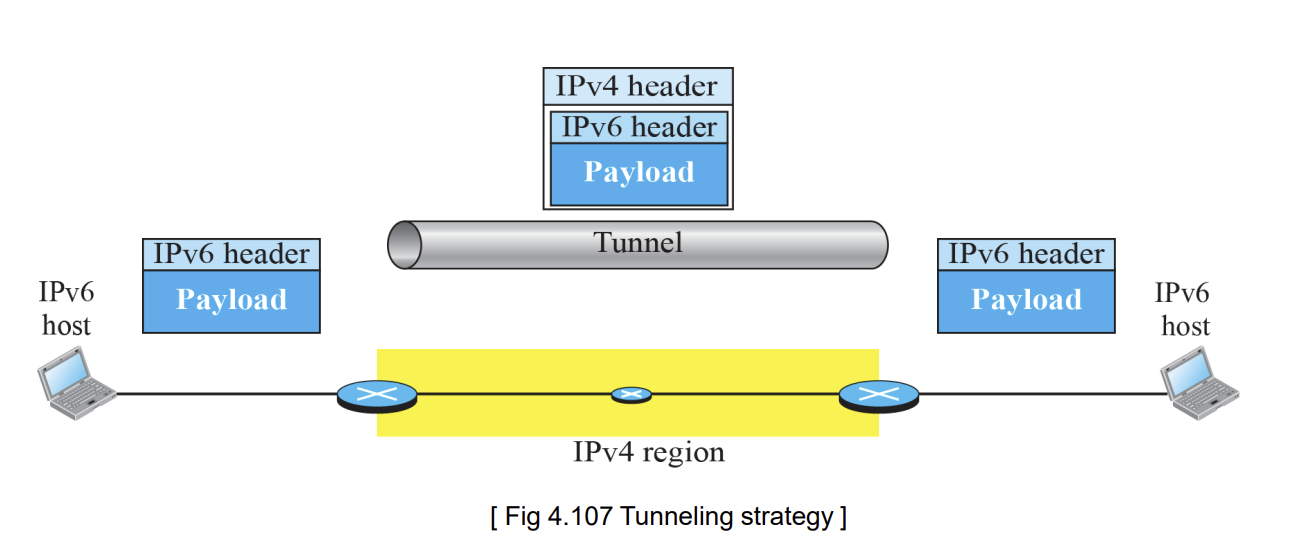
Tunneling
IPv6을 사용하는 두 host가 통신하고 싶은데 IPv4을 사용하는 지역을 지나야 할 때 tunneling이라는 기능을 사용하면 된다.
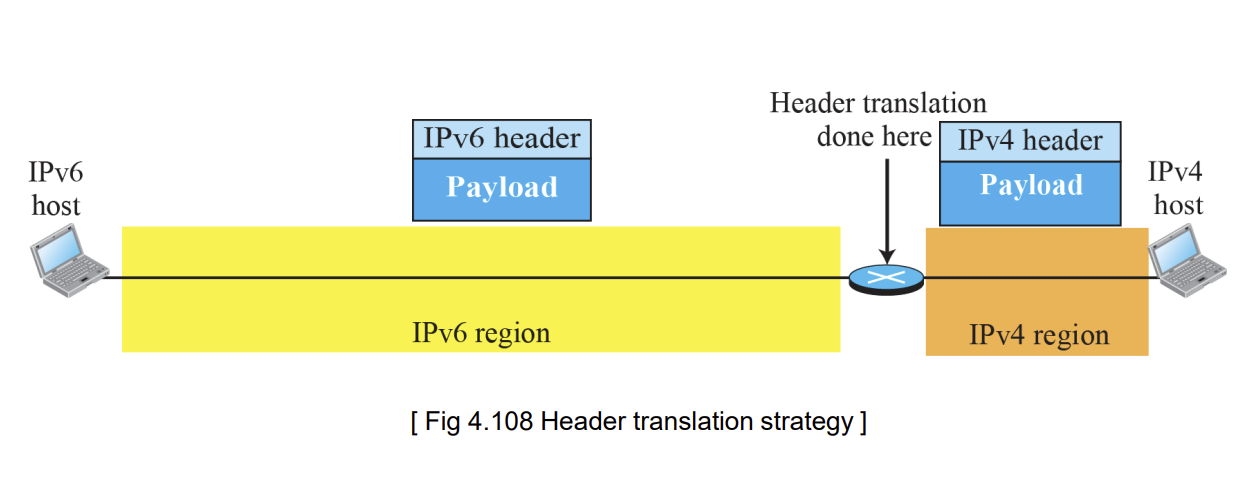
Header Translation
IPV6 host에서 IPv4 host에게 보내고 싶을 때, IPv6 header을 IPv4 header으로 translation하여 보내는 기능이다.
Middleboxes
Source에서 destination으로 가는 경로에서 router 기능 외에 추가적인 기능을 수행하는 중간 장비를 의미한다. 일반적인 router와의 차이점은 stateful이라 데이터를 기억하고 업데이트 한다는 것과 복잡한 작업도 수행 가능하다.
예시로는 NAT (네트워크 주소 변환기), Firewalls, Caches, Load balancers 등이 있다.
Example problem
-
Consider the following network path with 3 links and two store and forward packet switches. Note that each switch has 1.5 MB of memory for storing and forwarding. Assume that the processing delay at switches is 0 sec. The transmission rate and the propagation delays of the links are as indicated in the picture
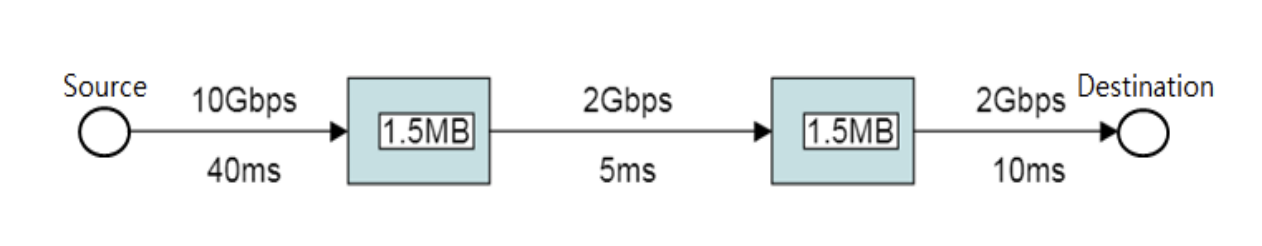
What’s the maximum size of data this network path can carry at any moment?
$\rightarrow$ Link들이 최대로 옮길 수 있는 bit의 합이다. 10 Gbps * 40 ms + 2 Gbps * 5 ms + 2 Gbps * 10 = 400 Mb + 10 Mb + 20 Mb + 3 MB = 430 Mb + 3 MB = (430/8) MB + 3 MB = 53.75 MB + 3 MB = 56.75 MB
A MP3 file is roughly 4MB, how many MP3 files the path can carry at any moment?
$\rightarrow$ 옮길 수 있는 최대 데이터 크기 / MP3 파일 크기 = 56.75 / 4 = 14.2 files
Calculate the total time required to transfer a 1.5 MB file in the following case, assuming RTT (Round Trip Time) of 80 ms, and an initial handshaking before the file is sent
-
An IP message 12,000 bytes wide (including the 20-byte IP header) that needs to be sent over a link with an MTU of 3,300 bytes
Find out the actual size of data
- Actual data size = 12,000 (message size) – 20 (IP header size) = 11,980 bytes
How much of an actual data in an IP packet can be sent over the link excluding the IP header
- Data can be sent over the link = MTU size – IP header size = 3300 – 20 = 3280 bytes
How many fragments are required to send the entire data
- Number of fragments = ⌈ Actual data size / Data can be sent over the link ⌉ = ⌈ 11,980 / 3280 ⌉ = ⌈ 3.65 ⌉ = 4
- How many DHCP packets are exchanged between a client and a server before the client receives an IP address?
4 DHCP packets are exchanged between the client and the server in the following sequence
- DHCP Discover
- DHCP Offer
- DHCP Request
- DHCP Ack.
-
What is the significance of name “Distance vector routing”
-
Distance vector routing is so named because it involves two factors: the distance, or metric, of a destination, and the vector, or direction to take to get there
-
Routing information is only exchanged between directly connected neighbors
-
This means a router knows from which neighbor a route was learned, but it does not know where that neighbor learned the route; a router can’t see beyond its own neighbors
-
-
What is the difference between OSPF and RIP?
-
The main difference between OSPF and RIP is that RIP only keeps track of the closest router for each destination address, while the OSPF keeps track of a complete topological database of all connections in the local network
-
While RIP using hop counts to calculate metric value, OSPF uses SPF (Shortest Path First) algorithm to select the best path
-
RIP uses lots of bandwidth as it sends periodic updates, but OSPF advertise only changes in a network
-
RIP can be reached hop count of 15 routers, but OSPF can reach unlimited hop counts. Therefore, RIP can be used in smaller networks and OSPF can be used in larger networks
-
-
Difference between multicast and unicast forwarding
$\rightarrow$ A Unicast transmission/stream sends IP packets to a single recipient on a network
If some device needs to send a message to multiple devices, it will have to send multiple unicast messages, each message addressed to a specific device
So, the sender has to send a separate message to each destination device, and to do that it has to know the exact IP address of each destination device
$\rightarrow$ A Multicast transmission sends IP packets to a group of hosts on a network.
Each host on the network can belong to multiple multicast groups.
Each group is assigned it’s own address
-
Why we are moving to IPv6 The most obvious answer is that IPv4 is out of IP addresses
IPv4 has only 4.3 billion addresses.
The first thing about IPv6 is that the number of addresses is enormous. IPv6 uses 128-bit addresses and is capable of 340 undecillion addresses which is 340 trillion trillion trillion.
Networks must be configured manually or with DHCP. IPv4 has had many overlays to handle Internet growth, which demands increasing maintenance efforts. 새로운 컴퓨터나 기기를 네트워크에 연결하려면 관리자가 직접 IP를 수동으로 입력하거나, IP를 자동으로 대여해 주는 ‘DHCP 서버’를 별도로 운영해야 했다.
IPv6 networks provide autoconfiguration capabilities. They are simpler, flatter, and more manageable, especially for large installations Widespread use of NAT devices means that a single NAT address can mask thousands of non-routable addresses, making end-to-end integrity unachievable Direct addressing is possible due to vast address space - the need for network address translation devices is effectively eliminated. 기기가 라우터의 정보와 자신의 고유 MAC 주소를 조합해 알아서 IP를 만들어내기 때문에, 네트워크 구조가 훨씬 단순(flatter)해지고 관리가 아주 쉽다.
NAT 기술은 주소 부족을 해결하기 위한 훌륭한 아이디어였지만, 근본적으로는 ‘임시방편’입니다. 하나의 공인 IP 뒤에 수천 대의 사설 IP를 숨겨 쓰다 보니, 외부 인터넷망에서 내부의 특정 기기로 직접 통신을 걸기가 어려워졌습니다. 즉, 인터넷의 기본 철학인 End-to-End integrity이 깨진 것입니다. IPv6는 주소가 워낙 넉넉해서 사설 IP나 NAT 라우터라는 중간 번역기를 거칠 필요가 완전히 사라집니다. 세상의 모든 기기가 각자의 고유한 공인 IP 주소를 가질 수 있습니다. 주소 변환 과정 없이 기기 대 기기가 직접(Direct addressing) 소통하게 되어 통신이 훨씬 효율적이고 직관적으로 변합니다.