Feeling the Unexpected: ResTacVLA for Contact-Rich Manipulation via Residual Tactile Representation 리뷰
Background
VLA는 context 정보를 VLM으로부터 얻도록 설계가 되어있기 때문에 context 자체가 vision-language에 집중되어있다. Vision 기반 manipulation은 이미 해결되었지만 surface wiping, insertion와 같은 contact rich manipulation task에서는 아직 어려움을 보인다.
VLA에 tactile 정보를 도입하기 위한 naiive한 방법은 그냥 tactile을 추가적인 modality로 다루는 것이다. 하지만 이런 경우에는 Modality Collapse 가 일어난다. Visual으로 얻는 정보량이 훨씬 많기 때문에 sparse한 tactile signal들이 묻히는 문제이다.
따라서 본 논문은 모든 modality을 동일하게 처리하는 것이 아니라 Predictive Coding (생명체들이 예측하지 못한 modality에 더 반응을 잘한다는 neuroscience 연구 결과) 를 바탕으로 tactile 정보를 VLA에 도입하고자 한다.
Methodology
Problem Formulation
Tactile aware policy $\pi$ 는 visual, tactile, language 정보를 low level action에 mapping하는 것이다.
Timestep t에서 policy는 observation $O_t$ 와 language L을 통해서 low level action sequence $A_t = {a_t, a_{t+1}, \dots, a_{t+H-1}}$ 을 생성한다.
이때 observation의 modality는 base, side, 그리고 wrist에서 오는 visual input들인 $V_t^{\text{base}}, \quad V_t^{\text{side}}, \quad V_t^{\text{wrist}}$, tactile modality인 $I_t^{\text{tac}}$ , proprioceptive state인 $s_t \in \mathbb{R}^7$ 으로 구성된다.
Methods Overview
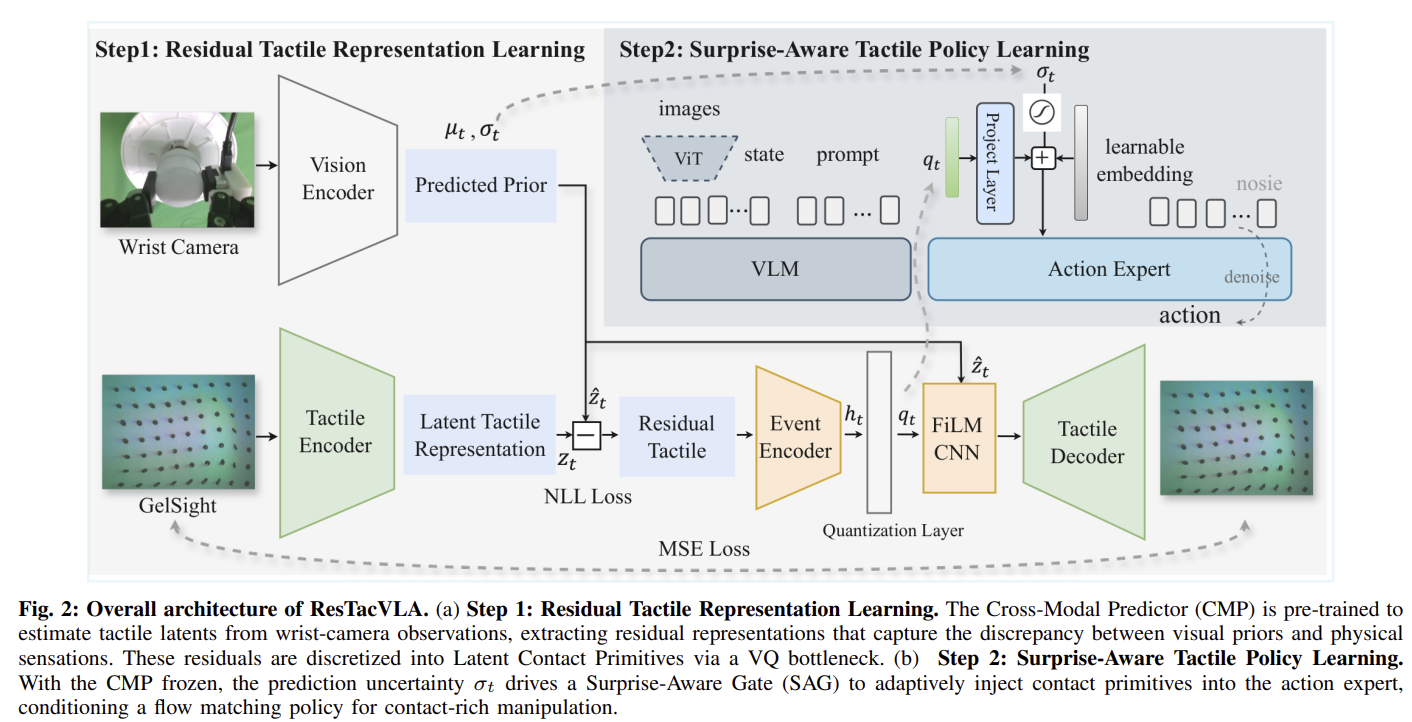
Residual Tactile Representation Learning
Cross Modal Predictor (CMP)는 wrist camera 정보를 통해 latent tactile representation estimate $\hat z_t$을 얻는다. 즉, wrist camera을 통해서 얻을 수 있는 tactile latent 정보를 얻는다. $V_{t}^{\text{wrist}}$ 는 ResNet + MLP head을 통해서 predicted mean $\mu_t \in \mathbb{R}^{3 \times H’ \times W’}$ 와 standard deviation $\sigma_t \in \mathbb{R}$ 값을 얻는다.
동시에 UniT 기반 tactile encoder으로 실제 tactile image $I_t^{\text{tac}}$ 을 동일한 latent space에 투영하여 $\z_t \in \mathbb{R}^{3 \times H’ \times W’}$ 을 얻는다.
이를 바탕으로 residual tactile $r_t = z_t - \hat z_t$, 즉 vision 정보로는 얻을 수 없는 tactile 정보를 추출한다.
CMP는 Negative log likelihood objective을 바탕으로 aleatoric uncertainty을 modeling 하면서 학습을 한다.
\[\mathcal{L}_{\text{pred}} = \lambda_\sigma \log \sigma_t^2 + \frac{\|z_t - \mu_t\|^2}{\sigma_t^2}\]예측을 하면서 예측이 얼마나 불확실한지 알 수 있도록 학습을 한다고 보면 된다.
이때 예측이 어려운 sample일수록 $\sigma_t$ 가 커지기 때문에 prediction error을 담당하는 두 번째 항이 작아진다. 하지만 두 번째 항으로만 학습을 할 경우, $\sigma_t$ 가 무한으로 커질 수 있기 때문에 variance penalty인 첫 번째 항을 추가한 것이다.
단순하게 $e_t^2 = |z_t - \mu_t|^2$ 라고 하고 $s = \sigma_t^2$$ 라고 하면, $L = \lambda_\sigma \log s + \frac{e_t^2}{s}.$ 이다. $s$에 대해 최소화해보면 $\frac{\partial L}{\partial s} = \frac{\lambda_\sigma}{s} - \frac{e_t^2}{s^2} = 0$ 이므로 $\boxed{\sigma_t^2 = \frac{|z_t - \mu_t|^2}{\lambda_\sigma}}$
예측이 어려운 sample일 때 일반적으로 $\sigma_t$ 가 높아지는데 이것이 의미하는게 Predictive Coding에서 말하던 surprise으로 해석할 수 있다. 즉, 하나의 modality(wrist camera)으로 다른 modality(tactile) 을 예측할 때의 불확실성이 클수록 시각 정보로 얻을 수 있는 tactile 정보가 실제 tactile 정보 간의 괴리가 크다는 것이다. 따라서 $\sigma_t$ 값이 높을 때 Predictive Coding에서 주장한 예측하지 못한 modality가 생겼다고 볼 수 있는 것이다.
Latent Contact Primitives via VQ
Event encoder $f_\phi$ 는 convolutional residual block과 global max pooling을 통해 residual $r_t$ 값을 하나의 벡터 $h_t$으로 압축을 한다.
\[h_t = f_\phi(r_t) \in \mathbb{R}^D\]이 $h_t$는 convolution block으로 인해서 강한 특징들만 모인 하나의 event vector라고 보면 된다.
그 다음에 Vector Quantization (VQ) 을 사용해서 연속적인 벡터 $h_t$ 을 그대로 사용하지 않고 미리 학습된 codebook $\mathcal{C} = {c_k}_{k=1}^K$ 의 벡터로 변환한다.
Codebook에는 대략적으로 정상 접촉, 미끄러짐, 강한 압축, 충돌 등을 나타내는 vector들이 존재한다고 보면 된다.
Codebook을 통해서 latent contact primitive인 $q_t$ 을 얻는다. 그래서 $\hat z_t$ 을 컵을 잡고있을 때의 일반적인 tactile 이라고 생각하고 $q_t$를 컵을 잡고있을 때 생길법한 tactile과 다른 suprise tactile 정보라고 생각하면 된다. 이 정보를 최종 tactile 예측에 반영하기 위해서 FiLM conditioning을 사용한다.
\[\tilde{z}_t = \gamma(q_t) \odot \hat{z}_t + \beta(q_t)\]따라서 최종 tactile 예측에는 컵을 잡고 있긴 하지만 미끄러지고 있는 tactile 상태라는 정보가 담기게 된다.
이 $\tilde{z}_t$ 값은 다시 tactile image으로 reconstruct하여 예측 tactile image $\hat I_t$ 이 된다.
최종적으로 CMP는 다음 loss function으로 학습이 된다.
\[\mathcal{L}_{\text{CMP}} = \mathcal{L}_{\text{rec}} + \lambda_p \mathcal{L}_{\text{pred}} + \mathcal{L}_{\text{vq}}\]이때 $\mathcal{L}_{\text{rec}} = |\hat{I}_t - I_t^{\text{tac}}|_2^2$ 이다.
Surprise-Aware Tactile Policy Learning
$\sigma_t$ 값을 통해 Surprise-Aware Gate (SAG)는 cross modality로는 얻을 수 없는 tactile 정보가 얼만큼인지 추정하여 tactile 정보를 action expert에 반영 여부를 결정한다.
SAG는 다음 식을 통해 결정된다.
\[g_t = \text{Sigmoid}(\text{MLP}(\sigma_t))\]그 다음 adaptive modality fusion을 위해서 $q_t$ 는 linear layer으로 인해 action expert에 들어가는 token dimension으로 투영된다. $\rightarrow$ $p_t \in \mathbb{R}^d$
동시에 contact가 존재 여부를 알려주는 학습 가능한 embedding $e_0 \in \mathbb{R}^d$ 을 사용해서 최종 tactile token을 구성한다. 이 tactile token이 최종적으로 action policy에 들어가게 되는 tactile 정보가 되는 것이다.
\[e_t = g_t \cdot p_t + (1 - g_t) \cdot e_0\]그래서 $g_t \rightarrow 0$ , 즉 visual 정보로 tactile 정보를 다 얻을 수 있다는 confidence가 높다면 최종 output은 $e_0$ 으로 수렴할 것이기 때문에 추가 tactile 정보는 제한한다. 반면 $g_t \rightarrow 1$ 으로 contact primitive $p_t$ 가 주도적인 역할을 하게 된다면 policy에 추가 tactile 정보를 추가하게 되는 것이다.
이때 action 생성이 tactile 정보를 바탕으로 되도록 하기 위해서 $e_t$를 action expert input의 noise token에 concatenate한다.