Hi Robot: Open-Ended Instruction Following with Hierarchical Vision-Language-Action Models 리뷰
Background
로봇이 그저 여러 정해진 단계로만 수행하는 것보다 dynamic한 환경 및 지시에 따라 다르게 수행하는 것이 더 똑똑하다.
로봇이 현재 이런 지능을 갖지 못하는 대표적인 이유로는 학습 데이터나 imitation learning을 하는 방법이 모두 “pick up the can” 등 엄청 단순한 language instruction을 사용하기 때문이다. 따라서, “Could you make me a vegetarian sandwich? I’d prefer it without tomatoes. Also, if you have ham or roast beef, could you make a separate sandwich with one of those for my friend?” 처럼 긴 task에 대해서는 잘 수행하지 못한다. 이런 task을 수행하기 위해서는 언어를 이해하는 것 뿐만 아니라 existing skill들을 dynamic한 context에서 조합하고 실행해야 한다. 여기에 지적사항들이 들어와도 이를 모두 반영을 해야 한다.
따라서 본 논문은 로봇이 다양한 지시사항, 피드백, 지적사항들에 대응할 수 있도록 로봇의 intelligence을 높이고자 한다. 이를 달성하기 위해 Kahneman의 System 1, System 2 인지 과정 아이디어를 차용한다. System 1은 이미 배운 skill / 단순한 지시사항을 수행하는 과정이라고 이해하면 되고 System 2는 복잡한 task를 나눠서 생각할 줄 알고 feedback을 반영하고 적절한 skill composition을 수행하는 과정이라고 이해하면 된다.
이를 VLA에 도입하기 위해서 VLM과 VLA을 사용하여 hierarchical 추론 system을 만들었다. VLM가 system 2가 되어서 복잡한 prompt와 language feedback을 이해하고 이를 system 1이 이해할 수 있는 단순한 prompt으로 바꿔주는 역할을 하게 하였다. VLA는 system 1이 되어서 system 2가 내려준 단순한 prompt들을 현재 observation을 바탕으로 수행해주는 역할을 한다.
VLM을 robotic control에 사용하는 방법으로는 첫 번재로는 VLM을 robotic control을 위해 바로 학습을 시키는 것이고 두 번째 방법은 VLM이 robot에 미리 정의된 스킬들을 출력하도록 학습시키는 것이다.
첫 번째 방법은 효과적이긴 하지만 간단한 instruction에 대해서만 학습이 되기에 현재 목적과 맞지 않는다.
두 번째 방법에서는 많은 방법론들이 LLM과 VLM을 도입하여 robot의 observation과 instruction을 input으로 받아 여러 skill들로 분해하고 각 skill에 맞는 low level controller에게 전달한다. 이 방법은 복잡한 instruction을 처리하는데에 용이하지만 dexterity와 real time 처리가 부족하다.
따라서 본 논문은 VLM을 high level reasoning (System 2)와 low level control (System 1)에 둘 다 사용한다. High level reasoning (System 2)은 feedback, 수정사항, 전체 instruction을 처리하고 atomic instructions으로 분해하여 low level control (System 1)에 전달하는 방법론을 사용한다.
Problem Statement
Action policy는 여러 camera input $I_t^1, \dots, I_t^n$ 와 robot의 state $q_t$ 와 language prompt $\ell_t$으로 구성된 observation $o_t = [I_t^1, \dots, I_t^n, \ell_t, q_t]$ 가 있을 때 H개의 timestep의 actions $A_t = [a_t, a_{t+1}, \dots, a_{t+H-1}]$ 을 예측하도록 학습이 된다. 따라서 일반적인 action policy는 $p(A_t \mid o_t)$ 분포를 학습하는 것과 같다.
VLM은 image-text data에 대해서 autoregressive 방법으로 pretrain을 하기 때문에 VLM이 학습하는 분포는 $p(\ell’ \mid I, \ell)$ 이다. image와 question이 주어졌을 때 대답을 작성하는 objective으로 학습하기 때문이다
일반적인 VLA는 이런 VLM과 action policy을 사용하여 $\ell’$ 을 바탕으로 action $A_t$ 을 예측하도록 학습된다.
Hi Robot
본 논문은 System 1과 System 2을 같이 도입하기 위해서 분포 $(A_t \mid o_t)$ 을 low level policy와 high level policy으로 나눈다.
Low level policy는 하나의 VLA으로 high level로부터 atomic한 command을 받았을 때 $A_t$ 을 생성하는 역할을 한다. 반면 high level policy는 하나의 VLM으로 전체 instructions을 받았을 때 observation을 바탕으로 low level command들을 생성하는 역할을 한다.
Low level policy는 high frequency로 작동을 하고 high level polocy는 low frequency로 특정 시간 이후나 feedback/수정사항을 받았을 때만 호출이 된다. 따라서, high level policy는 어떻게 보면 low level policy에게 무엇을 해야 하는지 전달해주는 역할을 한다고 보면 된다.
Hierarchical Inference with VLAs
이 구조를 어떻게 보면 High level policy $\rightarrow$ Low level policy로 가는 hierarchical 구조를 가진 inference을 한다고 보면 된다.
$p_{\text{hi}}\left(\hat{\ell}t \mid I_t^1, \dots, I_t^n, \ell_t\right)$ 는 image observations과 전체 task instruction을 받고 atomic instruction $\hat \ell_t$ 을 생성하고 $p{\text{lo}}\left(A_t \mid I_t^1, \dots, I_t^n, \hat{\ell}_t, q_t\right)$ 은 이 atomic instruction과 robot state와 image observation만 받고 action을 출력하는 구조인 것이다.
이런 구조를 통해서 low level policy는 학습된 action만 출력하면 되는 것이라서 하나의 VLA가 복잡한 문제를 직접 해결해야 하는 부담을 줄인 것이다.
이때 high level policy의 추론 속도는 느리고 환경 변화에 덜 민감하기 때문에 low frequency에서 실행된다. $\ell_t$ 가 끝났을 때를 외부 system을 통해서 판단해서 이 high level policy을 다시 호출할 수 있지만 본 논문은 1초가 지나거나 지적사항이 들어왔을 때 다시 호출하는 간단한 방법을 사용한다.
Data Collection and Training Hi Robot
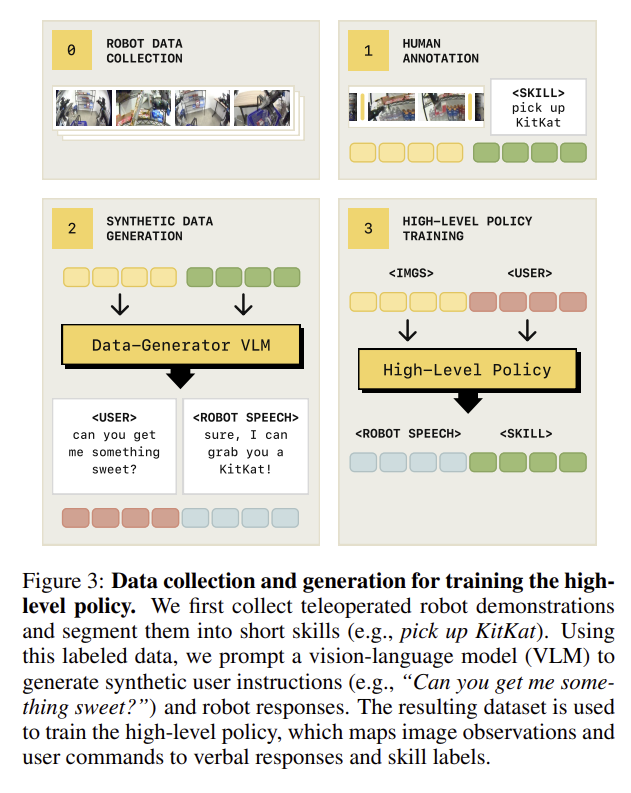
여기서 문제가 그럼 $\ell_t$ 을 어떻게 얻어야 할까. High level policy을 학습할 때, 긴 task가 존재하면 중간중간에 $\ell_t$ label이 있어야 전체적인 system을 학습할 수 있을 것이다. 하지만 일반적으로 존재하는 로봇 데이터들은 text instruction이 예를 들어 간단한 task: “pick up the cube” 으로 고정시칸 다양한 action data을 모으기 때문에 이 system을 위한 데이터를 얻기 어렵다.
따라서 본 논문은 우선 robot demonstration data $D_{demo}$ 을 teleoperation을 통해서 모으고 전체 episode을 짧은 skills $\hat \ell_t$ 로 분해하였다. 예를 들어 전체 task가 “make a sandwich” 였다면 분해를 할 때 lettuce을 집는 부분은 “pick up one piece of lettuce” 라고 labeling을 한 것이다. 이때 이런 semantic한 skill들로만 나눈 것이 아니라 “move the right arm to the left” 와 같은 movement primitives으로도 나눴다.
따라서 최종 labeled dataset $D_{labeled}$ 는 $\left( \hat{\ell}_t, I_t^1, \dots, I_t^n \right)$ 으로 구성된다.
여기에 사용자가 로봇에게 특정 요청을 할 때 이 요청에 대한 반응을 하기 위해서는 VLM과 VLA가 사용자의 부탁의 분포/형태를 이해할 수 있어야 한다. 따라서 Large VLM $p^{\text{gen}}$ 에 $D_{labeled}$ 의 $\left( \hat{\ell}_t, I_t^1, \dots, I_t^n \right)$ 을 입력해서 그 상황에서 사용자가 할 만한 요청 데이터 $\ell_t$ 를 만들었다.
ex) Atomic command가 pick up the lettuce라면 사용자 요청은 아마도 Can you add some lettuce for me? 라고 추정할 수 있다.
이 $\ell_t$ 정보까지 합쳐서 $D_{\text{syn}}$ 을 만들었다.
최종적으로 high level policy $p_{\text{hi}}\left(\hat{\ell}t \mid I_t^1, \dots, I_t^n, \ell_t\right)$ 는 $D{\text{syn}} \union D_{labeled}$ 의 데이터로 cross entropy loss으로 학습을 하고 $p_{\text{lo}}\left(A_t \mid I_t^1, \dots, I_t^n, \hat{\ell}t, q_t\right)$ 은 $D{\text{demo}} \union D_{labeled}$ 을 flow matching objective으로 학습을 하였다.