Qwen3 Embedding Advancing Text Embedding and Reranking Through Foundation Models 리뷰
Backgroumd
기존에는 text embedding과 re-ranking model을 학습하기 위해 encoder-only 구조의 pre-trained language model (ex: BERT)을 사용했다. 하지만 LLM의 언어 이해 능력이 급격히 상승하면서 LLM을 도입하는 추세이다. LLM을 그대로 embedding/reranking 모델로 사용하거나 LLM이 생성한 데이터로 학습 데이터를 구성하거나 데이터를 필터링을 하는 것이 예시이다.
Qwen3 Embedding
본 논문은 Embedding과 reranking 분야에서 LLM의 이점을 사용하기 하기 Qwen3로 embedding과 reranking model을 구축하였다.
Model Architecture
Embedding과 reranking의 핵심은 주어진 task 방향 내에서 text 간의 연관성을 정확하게 평가하는 것이다.
수학적으로 표현하자면, query $q$와 document $d$가 있을 때, 이 모델들은 instruction $I$가 제시한 방향성으로 $q$와 $d$의 연관성을 계산하는 것이다. 따라서, 학습 data instance는 보통 ${ I_i, q_i, d_i^+, d_{\text{i,1}}^-, … d_{\text{i,n}}^- }$의 형태로 구성한다. $d_i^+$은 $q_i$와 연관된 document, $d_i^-$은 연관되지 않은 document이다.
이런 text pair data를 다양하게 (언어, 형태, task 등) 학습해야 많은 downstream task에 general하게 적용할 수 있게 된다.
Architecture
Qwen3 Embedding / reranking 모델은 모두 Qwen3 (0.6B, 4B, 8B)을 토대로 만들었다.
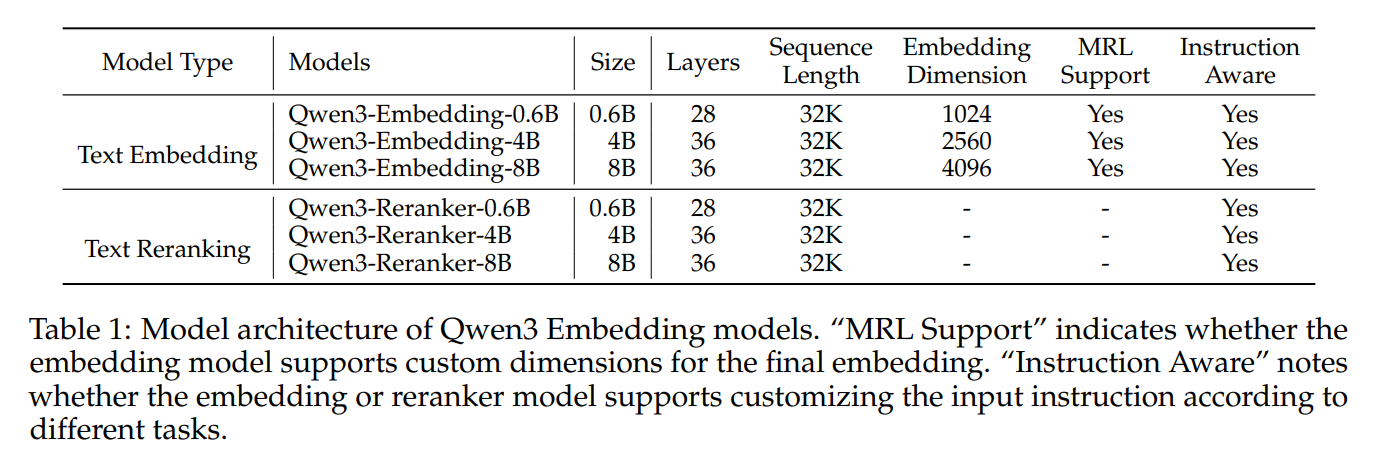
Qwen3 (LLM)의 text 이해력과 instruction following 능력이 embedding/reranking 성능 향상에 큰 역할을 할 것이라고 가정한 것이다.
Embedding Models
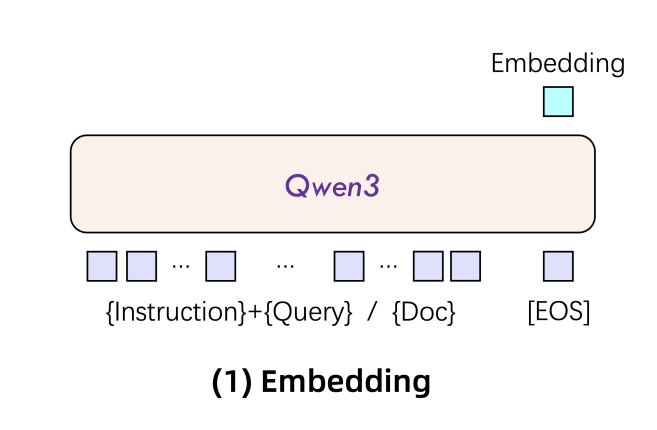
Qwen3는 causal attention을 사용하는 decoder-only model이기에 모든 context 내용을 담는 text embedding을 계산하기 위해서는 [EOS] token을 input sequence 끝에 붙였다. 이렇게 하면 causal attention을 처음부터 차례대로 하면서 결국 전체 context 내용이 [EOS]에 담기기 때문이다. 즉, 최종 text embedding을 마지막 layer에서 [EOS] token의 hidden state으로 정의하였다.
Embedding이 instruction의 방향성대로 정보를 담을 수 있게 하기 위해 instruction을 query 앞에 붙였다.

Reranking Models
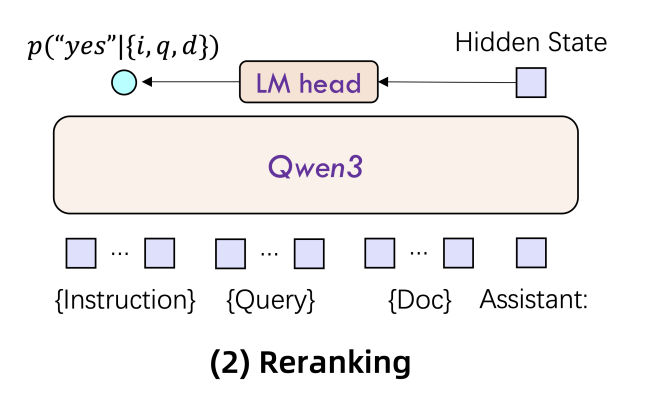
Reranking model이 텍스트 유사도를 더 정밀하게 측정하기 위해, LLM을 활용하여 하나의 query에 대해서 각 문서를 개별적으로 점수 매기는 방식을 사용했다. (point-wise reranking within a single context)
Embedding model처럼 reranking model이 instruction의 의도대로 reranking하게 만들기 위해서 input context에 instruction을 추가하였다.
이때, 텍스트 유사도 검사를 binary classification task으로 정의하여 연관성 유무에 따라 “yes” or “no”로만 답하도록 하였다.
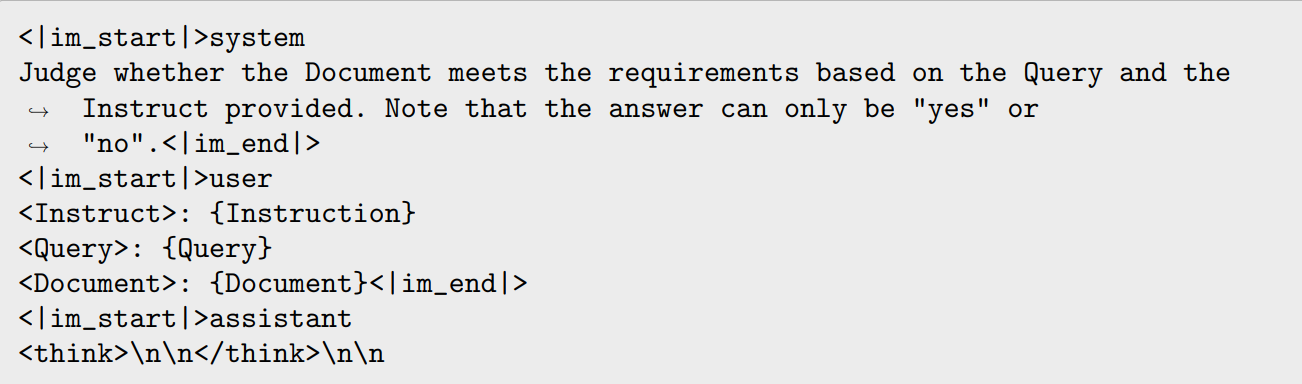
Instruction과 query가 주어졌을 때 document의 최종 relevance 점수는 “yes”와 “no”으로 대답할 likelihood을 토대로 계산하였다.
\[\text{score(q,d)} = \frac {e^{P(yes \mid I,q,d)}} {e^{P(\text{yes} \mid I,q,d)} + e^{P(\text{no} \mid I,q,d)}}\]Models Training
Training Objective
Embedding Model
Embedding model의 학습 objective는 InfoNCE의 contrastive learning objective의 normalization factor $Z_i$을 변형시켜 사용하였다.
\[L_{\text{embedding}} = - \frac {1} {N} \sum_{i}^{N} \log \frac {e^(s(q_i, d_i^+) / \tau)} {Z_i}\]$s(\cdot, \cdot)$은 similarity function으로, 본 논문은 cosine similarity을 사용하였다.
$\tau$는 temperature parameter
변형된 normalization factor는 다음과 같다.
\[Z_i = \frac{e^{s(q_i, d^+_i) / \tau}} {e^{s(q_i, d^+_i) / \tau} + \sum_{k=1}^K m_{ik} e^{s(q_i, d^-_{i,k}) / \tau} + \sum_{j \neq i} m_{ij} e^{s(q_i, q_j) / \tau} + \sum_{j \neq i} m_{ij} e^{s(d^+_i, d_j) / \tau} + \sum_{j \neq i} m_{ij} e^{s(q_i, d_j) / \tau} }\]- $e^{s(q_i, d^+_i)}$는 현재 query와 positive document 간의 similarity score
- $e^{s(q_i, d^-_{i,k})}$는 현재 query와 hard negative document 간의 similiary score
- $e^{s(q_i, q_j)}$는 현재 query와 in-batch negative query 간의 similarity score
- $e^{s(d^+_i, d_j)}$는 positive document와 in-batch negative document 간의 similarity score
- $e^{s(q_i, d_j)}$는 현재 query와 in-batch negative document 간의 similarity score
Normalization factor를 변형시킨 이유 $\rightarrow$ 한 batch 내에서 negative example들을 늘리려는 목적이라고 생각한다.
이때, $m_{ij}$는 mask 역할을 하는 값으로 false negatives의 영향력을 줄이기 위해 사용되었다.
\[m_{ij} = \begin{cases} 0 & \text{if } s_{ij} > s(q_i, d^+_i) + 0.1 \text{ or } d_j = d^+_i \\ 1 & \text{otherwise} \end{cases}\]여기서 지칭하는 false negative란 다음과 같다.
1) Negative doc가 positive doc와 같은 경우
2) query와 negative doc / negative query가 positive doc보다 similarity score가 높은 경우
이런 data는 embedding 모델이 positive document를 다른 examples들에서 구별하면서 학습하는 과정에 악영향을 주기에 masking으로 제거한 것이다.
Reranking Model
Pointwise ranking loss를 Negative log likelihood 형태로 정의하였다.
\[L_{\text{reranking}} = - \log p(l \mid P(q,d))\]이때, $p(\cdot \mid *)$은 LLM의 next token 확률 (“yes” 또는 “no” 라고 할 확률)이다. Positive documents는 label l = “yes”이며 negative documents는 label l = “no”이다.
즉, $q$와 $d$가 주어졌을 때, “yes”을 예측하는 확률을 높이도록 loss function을 design하였다.
Multi-stage Training
본 논문은 multi-stage pipeline으로 학습 과정을 구성하였다. 처음에는 large scale unsupervised pre-training을 시킨 후, high quality dataset으로 supervised fine-tuning을 하였다. 많은 embedding model / reranking model들이 이런 학습 과정을 따른다.
Large-scale unsupervised pre-training은 모델의 범용성 (generalization)에 큰 영향을 주고 fine-tuning은 모델의 성능 향상에 영향을 준다.
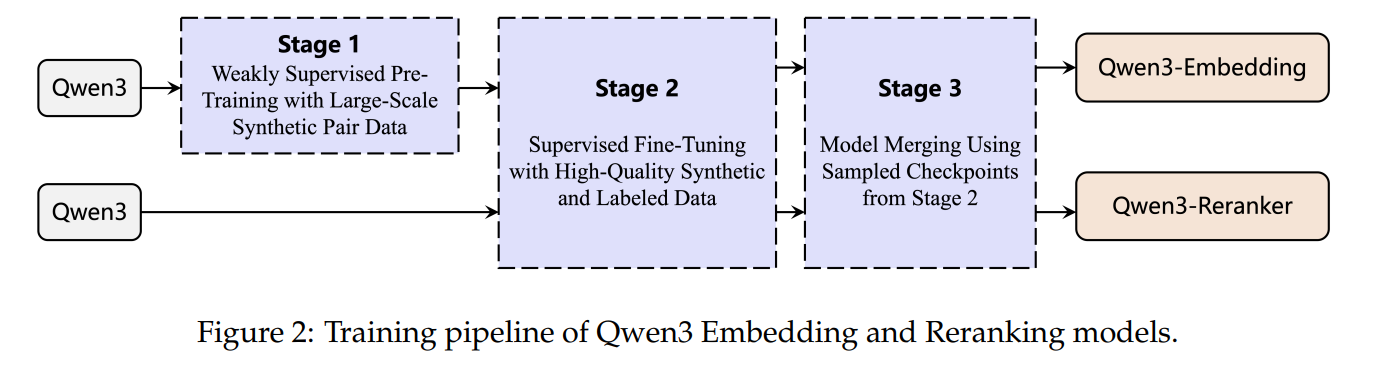
이때, Qwen3 Embedding은 두 stage에서 모두 동일한 objective function을 사용한다.
Qwen3 Embedding은 기존의 연구들과 다른 학습 data를 구축한다.
- Unsupervised training을 위해서 보통 open-source communities (QA forum / academic paper)으로 text pair dataset을 구성한다. 하지만 본 논문은 LLM (Qwen3)의 text 이해력을 토대로 data를 형성한다. 이 방법을 사용하면 dataset의 다양성 (task, language, length) 등을 원하는 대로 조절할 수 있고 심지어 low resource data (많이 없는 시나리오 데이터나 언어) 도 얻을 수 있게 되기 때문이다.
- SFT data도 Qwen3가 생성한 text pair 데이터들을 선별하여 구성하였다.
또, 모델의 generalization 향상과 catastrophic forgetting (Fine-tuning을 하면서 본래의 기능이 일부 소실되는 현상)을 예방하기 위해 model merging 방법을 사용한다.
- Model Merging은 model들의 parameter들을 직접 합해서 GPU cost 없이도 모델의 성능에 변화를 주는 방법이다. 보통 generalization이나 능력을 합치기 위해서도 사용되지만 catastrophic forgetting을 막기 위해서 사용되기도 한다. 이때, 본 논문은 Spherical Linear Interpolation을 기반으로 한 model merging을 하였다.
High dimension space에서 정보는 보통 구의 표면에 존재한다고 증명되었다. 이때, 두 parameter (vector)를 더한다고 하면 결과 parameter(vector)는 구의 표면이 아니라 구의 중심에 위치하게 된다. 하지만, 구의 중심 벡터들은 LLM이 알지 못하는 정보이기 때문에 merge 결과는 기능을 잃은 model이 된다. 따라서, Spherical Linear Interpolation (SLERP) 을 사용한다. Spherical Linear Interpolation을 기반으로 merging을 한다면 parameters(vector)의 sphere의 중심이 아니라 표면 vector가 되기 때문에 기능을 최대한 잃지 않고 merge 할 수 있다. 또, normalization을 적용하기 때문에 magnitude가 보존된다. \(\text{SLERP}(v_0, v_1; t) = \frac{\sin((1-t)\theta)}{\sin\theta}v_0 + \frac{\sin(t\theta)}{\sin\theta}v_1\)
Synthetic Dataset
다양한 similarity task들을 포함한 synthetic data를 만들기 위해서 Qwen3 32B을 사용하여 넓은 범위의 task 형태로 된 text pairs dataset을 구축하였다.
이때, 그냥 만든 것이 아니라 LLM의 instruction following 능력을 사용하여 다양한 prompting 방법을 통해 data의 다양성을 보장하였다.
- 문서마다 역할을 부여하여 Dataset의 다양성을 높였다. 미리 정의된 역할 library에서 retrieval model을 통해 각 문서에 어울릴 상위 5개의 역할을 가져와서 이 역할들을 document와 함께 prompt로 LLM에게 input하였다. 이를 통해서 이 문서를 찾을 만한 user들의 의도를 바탕으로 한, 문서에 어울리는 query를 생성하여 text pair dataset을 구성하였다.
- 이에 더해 prompt을 통해 query에서 요구할 task, 길이, 언어 등을 다양하게 하였다. 이런 data synthesis 결과로 150 million pairs의 unsupervised training data를 구성하였다.
이 data로 unsupervised training을 한 결과, 기존의 supervised model들보다 MTEB에서 좋은 성능을 보였다. 이를 통해 구축한 synthetic dataset의 우수성을 엿볼 수 있다. 이런 dataset에서 또 제일 high quality pairs을 추출하여 second stage에서 SFT에 사용될 dataset을 구축하였다. 이는 총 12 million pairs이다. Query와 positive document similarity 점수가 0.7 이상인 ‘강력한 positive example’들만 남겼다.
Evaluation
Text embedding model evaluation Text embedding model을 평가하기 위해서 MMTEB (Massive Multilingual Text Embedding Benchmark)을 사용하였다. 이 benchmark는 large-scale일 뿐만 아니라 250개 이상의 언어로 되어 있으며 500개 이상의 task으로 평가를 할 수 있다.
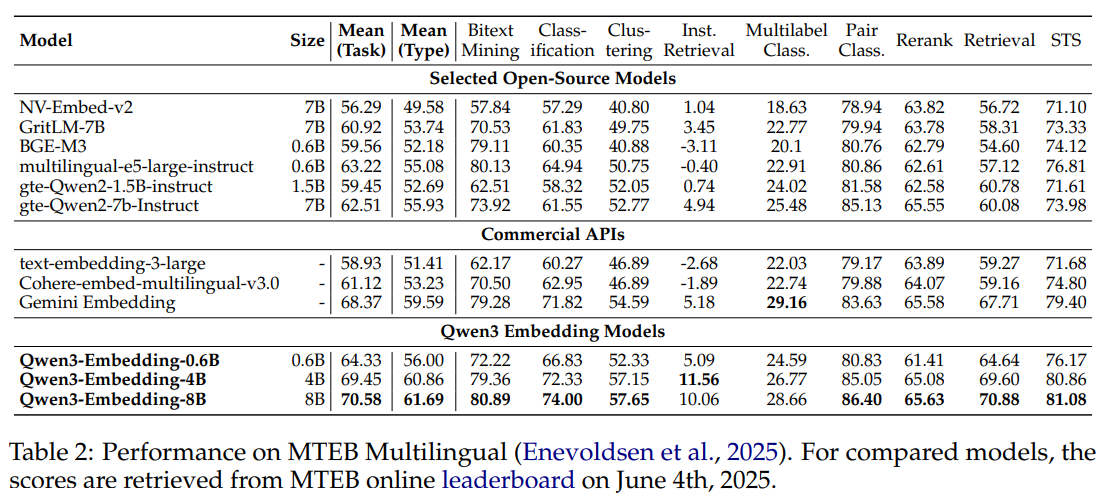
Qwen3 embedding 4B, 8B는 SoTA 성능을 보였고 제일 작은 0.6B 모델 또한 제일 좋은 성능의 baseline보다 살짝 뒤쳐진다.
MTEB으로도 평가를 하였다.
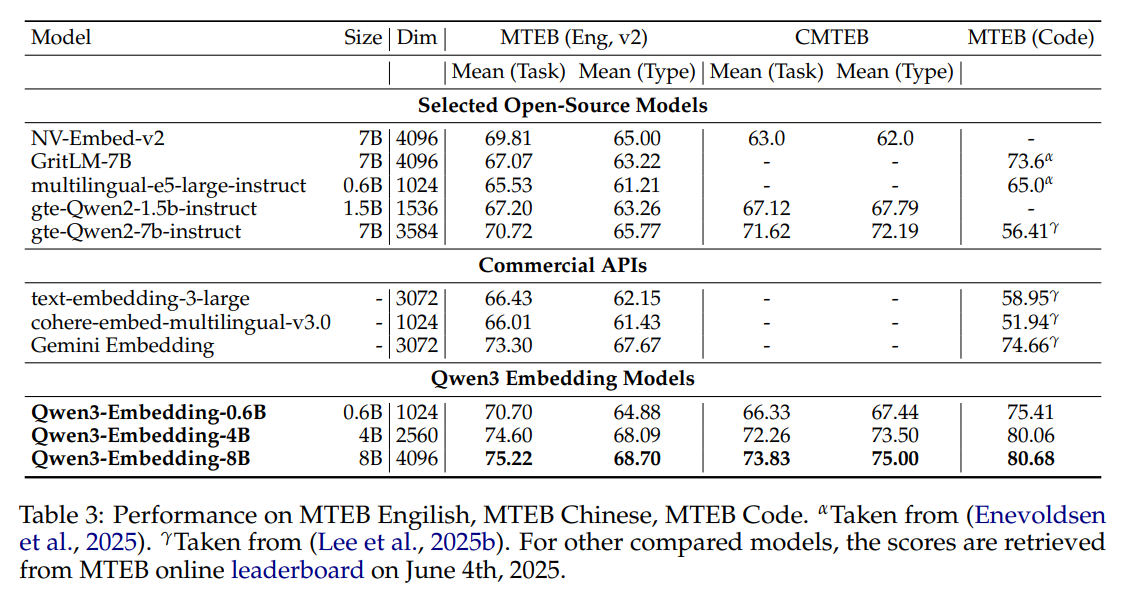
이 benchmark에서도 비슷한 양상을 보였다.
Reranking model evaluation
Reranking model을 평가하기 위해서는 text retrieval tasks 중 몇 개를 선별하였다: (1) Basic Relevance Retrieval, (2) Code Retrieval, (3) Complex Instruction Retrieval.
이때, 통제 변인으로 Reranking을 적용하는 pool을 동일하도록 하였다. Qwen embedding 0.6B가 retrieve한 100개의 relevant document pool 안에서 reranking을 적용하도록 하였다.
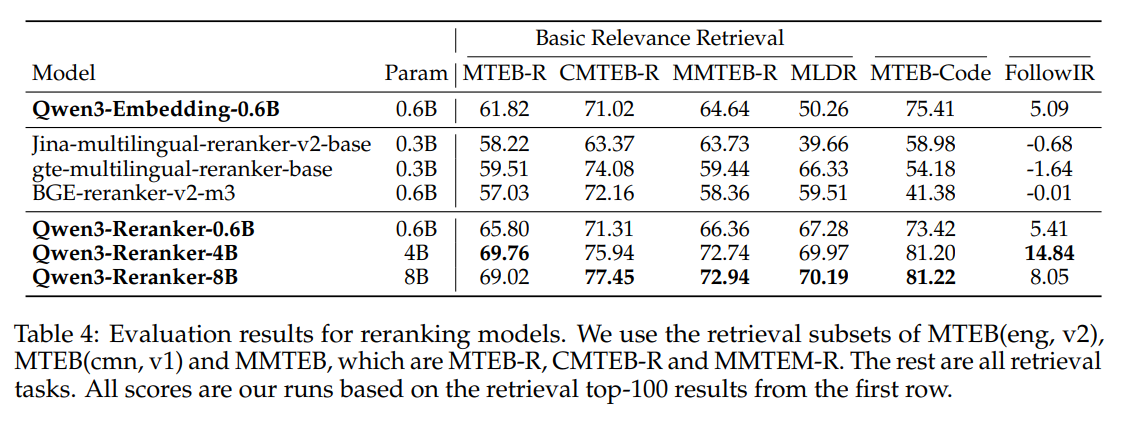
모든 Qwen3 reranking 모델들이 다른 baseline을 능가하는 결과를 보여준다.
Analysis
Effectiveness of Large-Scale Weakly Supervised Pre-Training
Large-scale unsupervised 학습 과정의 효과를 탐구하였다. 그러기 위해서 Qwen3-Embedding 0.6B 모델을 unsupervised training만 거치게 한 것 (w/ only synthetic data), unsupervised training을 하지 않은 것 (w/o synthetic data), 그리고 논문에서 제시한 pipeline을 그대로 따른 모델들끼리 비교하였다.
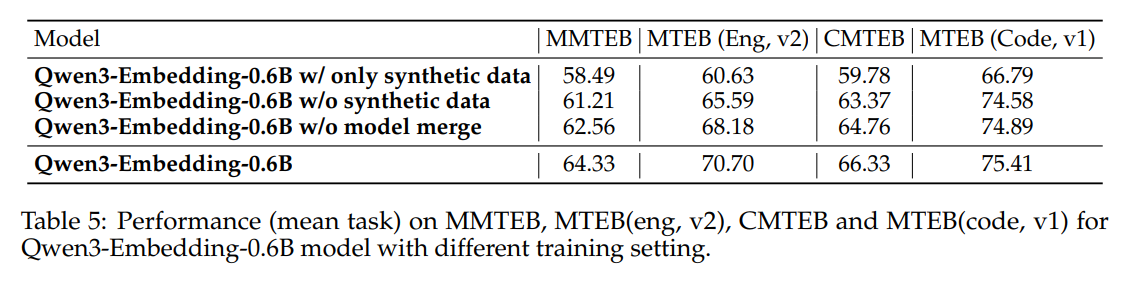
그 결과, unsupervised training만 거치더라도 (1st row) 원래대로 학습한 모델과 비슷한 성능을 보인다. 하지만 이 과정을 빼먹은 2nd row는 원래의 학습 pipeline을 거친 모델 (4th row)와 비교했을 때, 성능 저하가 뚜렷해진다. 이를 통해 Large-scale unsupervised 학습 과정의 효과가 컸음을 볼 수 있다.
Effectiveness of Model Merging
Table 5을 보면 model merging을 한 것이 안 한 것보다 성능이 많이 차이 난다는 것을 관찰할 수 있다. 따라서 model merging이 성능 강화에 효과적이라고 볼 수 있다.