ACT-SQL: In-Context Learning for Text-to-SQL with Automatically-Generated Chain-of-Thought 리뷰
Background
Text to SQL task는 자연어 질문을 주어진 DB 구조에 적합한 SQL query로 변환하는 task이다. 최근 연구들은 cross domain analysis을 기반으로 semantic parser의 발전에 집중하였다.
Semantic parser: 자연어 질문의 의미를 파악해서 SQL로 바꾸는 모델
Cross domain analysis: 본 적 없는 DB여도 구조만 알면 이해하는 능력
즉, 새로운 종류의 DB가 주어지더라도 자연어 질문의 의도를 파악하고 SQL query로 바꾸는 모델의 학습 및 구조 최적화에 집중하였다. 하지만 이런 모델들의 fine-tuning cost (학습 data 생성 등)이 많이 높다.
따라서 최근 연구들은 모델을 학습 시키는 것이 아니라 in context learning 방법을 사용하여 text to SQL task의 성능을 높이는 추세이다. 하지만 in context learning을 활용하는 기존 연구들 모두 하나의 SQL query을 생성하기 위해 여러 번의 API 호출이 요구되어 비용이 높으며, multi-turn으로 확장이 불가능하다는 것이 단점이다.
ACT-SQL
본 논문도 in context learning을 활용한 chain of thought (CoT) prompt을 통해 LLM의 text to SQL 성능을 최대로 끌어내었다.
Chain of thought (CoT)는 사람의 사고 과정을 따라한 prompting 방법으로 LLM이 단계별 사고를 하도록 유도하는 역할을 한다.
이때, CoT를 사용하기 위해서는 보통 사람이 섬세하게 작성한 우수한 CoT 예시들이 필요하다. 하지만 이런 예시를 얻는 과정도 cost가 높다. 따라서 본 논문은 사용자의 의도에 맞는 우수한 text to SQL CoT 예시들을 자동으로 생성하는 in context learning prompting 방법 ACT-SQL을 제시한다.
Methodology
In context learning을 적용한 SQL query 생성 과정은 $I$를 instruction, $D$를 DB 스키마, $P_i$ = 정답 SQL이 든 prompt, $\mathcal{E} = \left[ (D_1, Q_1, P_1), … (D_n, Q_n, P_n) \right]$을 few shot prompting을 위한 exemplar 리스트, $S$를 정답 SQL이라고 할 때 다음과 같다.
\[S = LLM(I, D, Q, \mathcal{E})\]따라서, In context learning을 Text to SQL task에 적용할 때, DB의 구조를 어떻게 설명할 것인지, Few shot prompting에 어떤 예시를 사용할 것인지, 그리고 이 예시들로 prompt을 어떻게 구성할 것인지가 중요하다.
DB Prompt Style
요구되는 DB 구조에 알맞는 SQL query을 생성하기 위해서는 DB의 구조를 잘 이해해야 한다. 따라서 LLM에게 DB 구조를 잘 이해시키는 것이 중요하다.
본 논문은 DB 스키마 정보를 어떻게 LLM에게 전달해야 효과적인지 분석하기 위해 zero shot setting에서 LLM이 DB 스키마 정보를 어떤 input 형식으로 전달받았을 때 제일 잘 이해하는지를 실험하였다.
구체적으로, zero shot setting에서 DB 스키마와 질문을 input으로 받았을 때, SQL을 잘 이해하는지를 알아보았다.
$\rightarrow$ Text to SQL 성능이 DB 스키마의 input 형식에 의존적이도록 설계하였다.
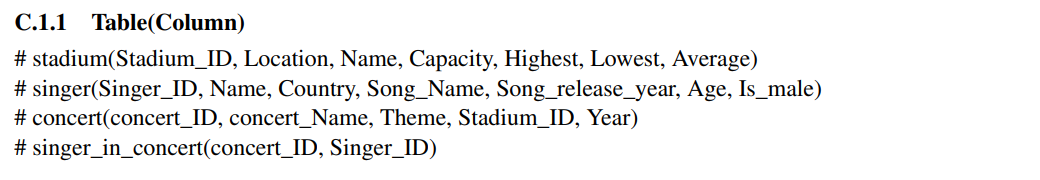
사용한 DB 스키마 input 형식은 다음과 같다.
Table(Column): 각 table 명칭과 column 이름들을 나열
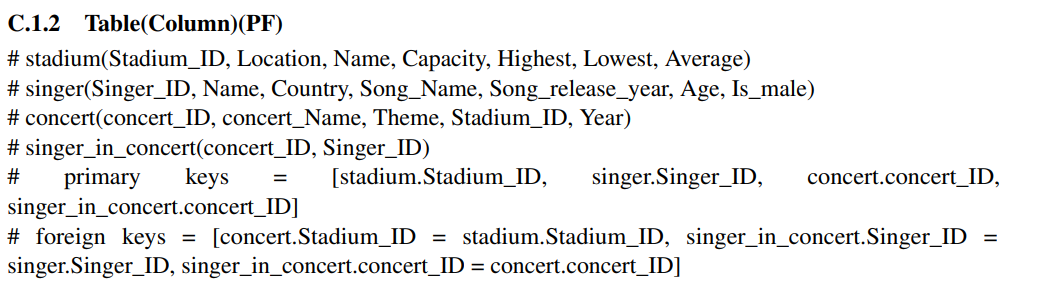
Table(Column)(PF): 각 table 명칭과 column 이름들과 각 table 끝에 Primary key와 foreign key들까지 전달
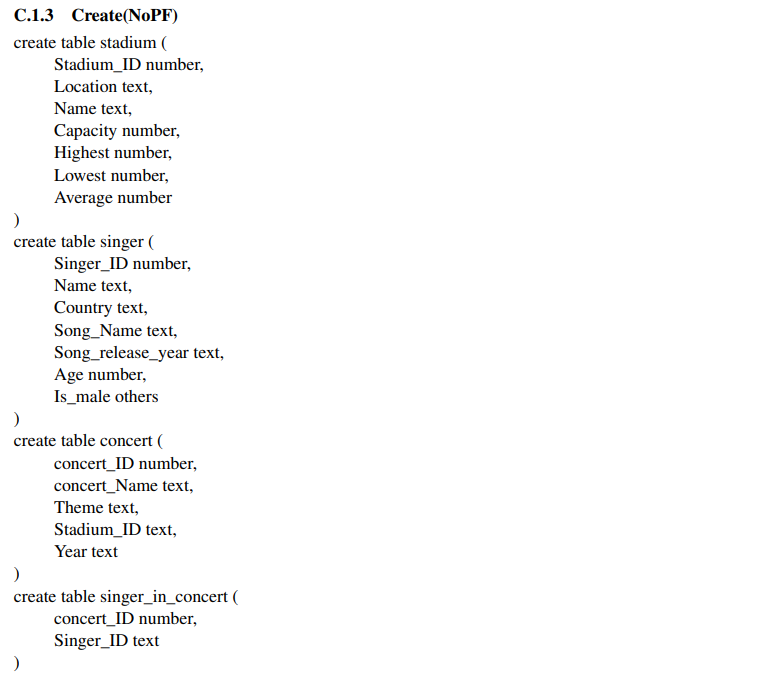
Create(NoPF): Table과 column 명들을 SQL 문법으로 전달
Create(EoC): Create(NoPF)에 이어서 각 column 끝에 primary key인지 foreign key인지 정보 전달
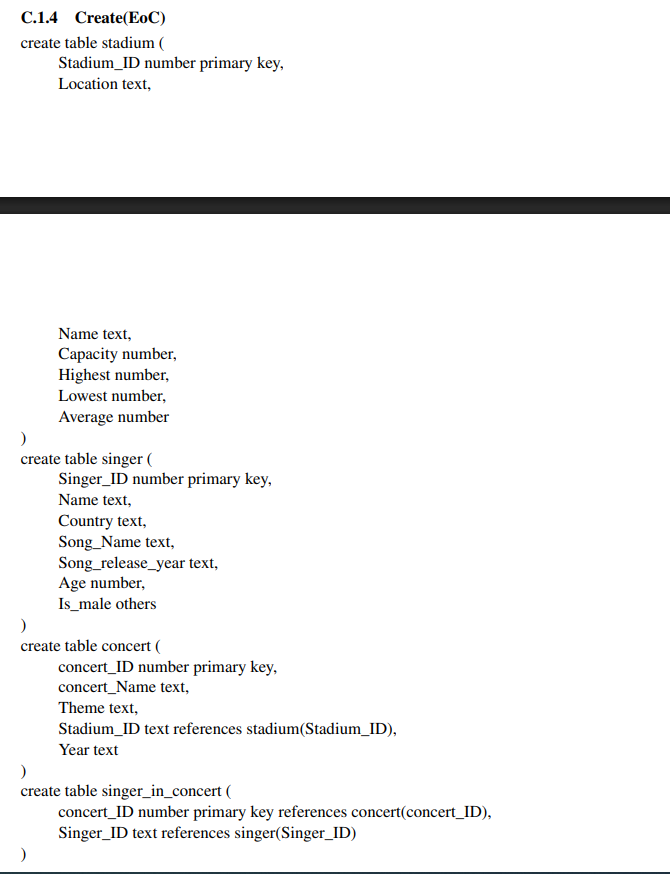
Create(EoT): Create(NoPF)에서 각 table 끝에 primary key와 foreign key 정보 추가
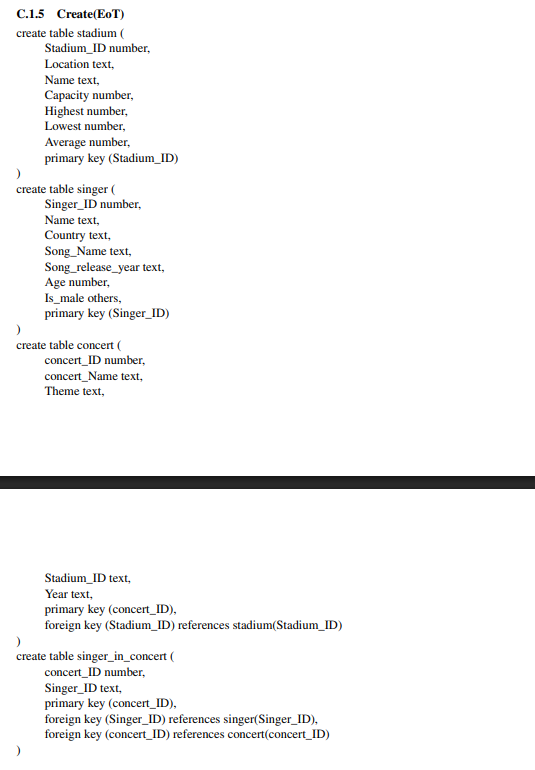
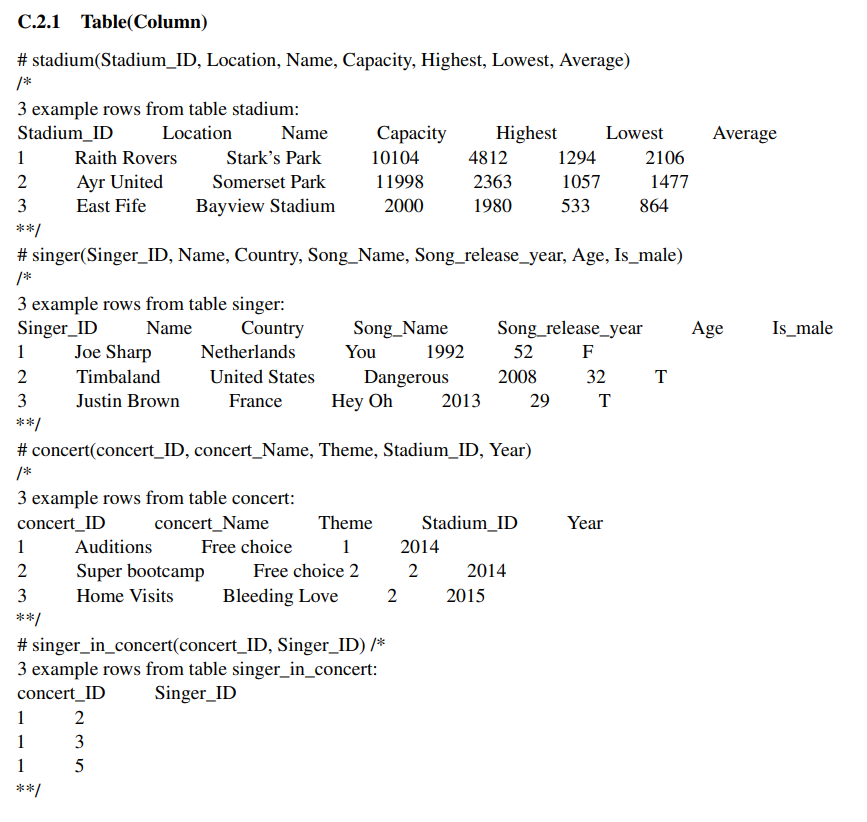
이에 더해서 DB 내부 내용 예시까지 c개를 추가해서 prompt을 구성하였다.
최종 prompt는 다음과 같다.
Exemplar Selection
Few shot prompting처럼 Task 정답 예시들을 몇 개 주면 더 정형화된, 정확한 SQL query 생성을 돕는다. 따라서, 어떤 예시들을 사용하는지가 매우 중요하다.
본 논문은 어떤 예시를 얼만큼 사용해야 하는지 알아내기 위해 few shot setting에서 exemplar의 종류 및 수의 영향력을 조사하였다.
어떤 종류의 exemplar가 효과적인지 보기 위해서 hybrid strategy를 사용하였다.
Static exemplars
학습 데이터셋에서 $n_s$개의 example들을 랜덤하게 추출하였다. 모든 test case에서 context으로 쓰이며 general한 답변 형식을 알려주는 역할을 하는 example이다.
Dynamic exemplars
학습 데이터셋에서 Test case의 질문과 가장 유사한 (similarity score by pretrained model) top $n_d$개의 data를 exemplars으로 사용하여 현재 test case domain에 적절한 힌트를 주는 example이다.
결론적으로 각 test case에 총 $n_s + n_d$개의 exemplars을 사용한다.
Chain of Thought Prompt Design
이전 연구들은 Schema linking을 통해 사용자의 질문과 가장 연관있는 DB 스키마 (Table 명, Column 명)에 대한 정보를 주어 task to SQL 성능을 높였다.
Schema Linking: 질문 token과 schema item 이름의 일치율을 바탕으로 DB 스키마와 질문을 연결시키는 방법
Schema linking을 사용자의 질문과 연관이 높을 DB의 스키마를 알려주기 때문에 정확한 SQL query 생성에 큰 도움을 준다.
따라서 본 논문도 Schema Linking의 아이디어를 사용하여 CoT prompt을 디자인하였다. 다음은 Text to SQL에 사용되는 일반적인 manually written CoT prompt이다.
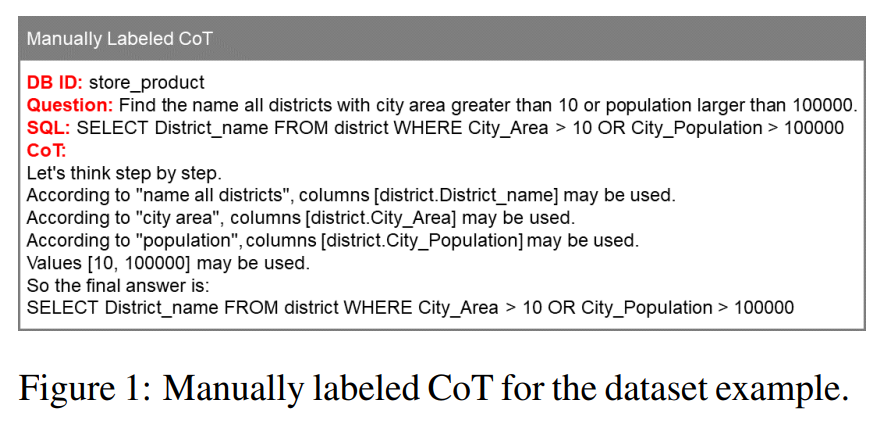
효과적인 CoT prompt을 작성하기 위해서는 사람이 직접 작성하는 것이 좋지만, cost가 높다. 또, 얻는데 오래 걸리기 때문에 dynamic exemplar처럼 매번 test case에 적합한 examples으로 few shot prompt를 구성할 수 없다.
$\rightarrow$ 따라서, 본 논문은 자동으로 효과적인 CoT prompt을 얻을 수 있는 방법을 제시한다.
Auto-CoT
사용자의 질문을 $q = (q_1, q_2, \cdot \cdot \cdot , q_{\mid q \mid})$라고 하고 SQL query를 s, $q_i$를 질문의 i번째 token이라고 할 때, $q_{\text{i,j}} = (q_i , q_{\text{i+1}}, q_{\text{i+2}}, \cdot \cdot \cdot q_j)$을 질문의 slice라고 정의하였다.
이때, 정답 SQL query에 나오는 모든 column들을 [table 명].[column 명]으로 나열하였다. 그 다음, Pretrained model을 사용하여 각 column마다 사용자 질문의 slice들 간의 유사도 점수를 계산하였다. 그 다음 가장 유사한 slice을 찾아 그 slice와 column을 연결하여 CoT prompt에 추가하였다.
\[\argmax_{q_{i,j}} Sim([tab].[col],q_{i,j})\]이때, 사용자 질문에 직접 GROUP BY를 하라는 내용이 나오지 않기 때문에 GROUP BY 문에 나오는 column들은 무시한다.
각 Table 명에도 동일한 작업을 하였다. 이때, column 명과 동일한 table 이름들은 제외하였다. 즉, From 문에 나오는 table 명들만 동일한 작업을 했다고 보면 된다.
\[\argmax_{q_{i,j}} Sim([tab], q_{i,j})\]추가로 정답 SQL query에 나오는 value들도 prompt에 추가하였다.
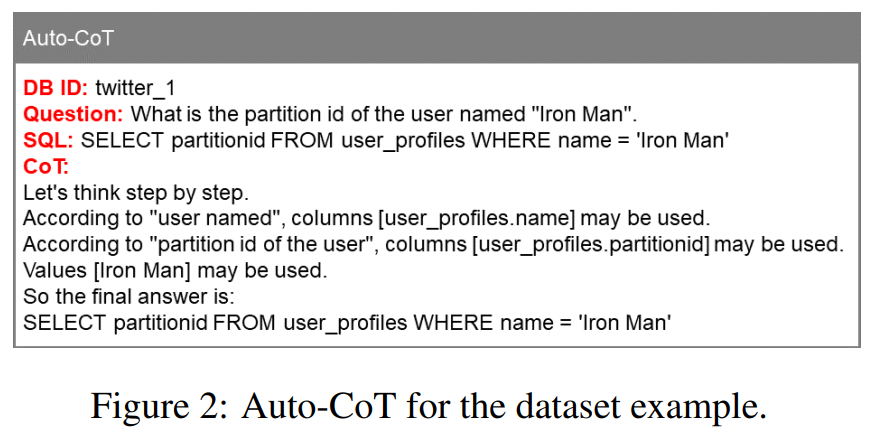
Auto-CoT로 생성한 prompt 예시는 다음과 같다.
Extension for Multi-turn Text-to-SQL
이전 연구들은 모두 single turn에만 집중하였다. 지금까지 설명된 ACT-SQL 또한 single turn에만 적합하다.
질문 slice을 바탕으로 CoT를 만들지만 multi-turn에 적용하는 순간 이전 context까지 어떻게 보면 질문을 구성하게 되므로 기존의 ACT-SQL은 multi-turn에 적용하기에는 한계가 존재한다.
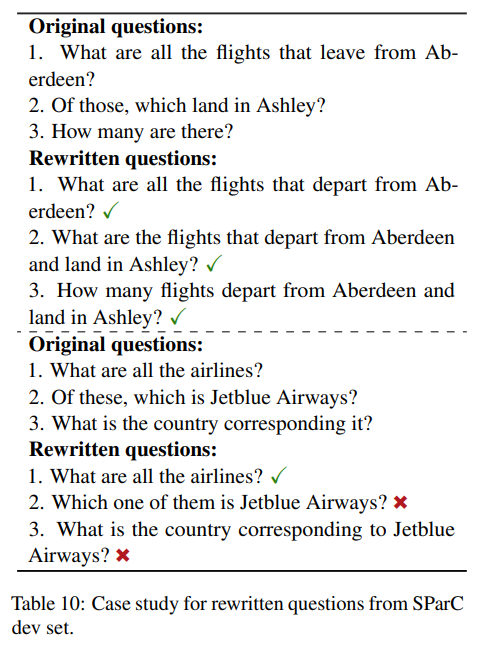
따라서, 추가적으로 Multi-turn에도 적용할 수 있는 방법론을 제시한다. 본 논문은 LLM을 사용하여 multi-turn text to SQL을 single turn text to SQL으로 바꾸기로 한다. 즉, 다음 turn에 사용자가 입력한 질문과 이전 context을 고려하여 하나의 일반적인 질문으로 재작성하는 방법을 제시한다. 이 재작성된 질문을 다시 ACT-SQL의 흐름으로 single turn이라고 가정하여 다시 입력하는 것이다.
이때, LLM의 재작성 능력이 매우 중요하기 때문에 multi-turn의 경우에는 few shot prompt의 examples을 사람이 직접 작성한 rewriting exemplars으로 구성하였다.
Experiments
Models
-
ACT-SQL을 평가하기 위해 사용한 모델은 GPT-3.5 turbo이다.
-
Spider 데이터셋에서 auto-CoT가 얼마나 잘 작성된 CoT인지 평가하기 위해서 기존의 연구들과 비교할 때는 GPT-4도 사용하였다.
-
Dynamic exemplars을 찾는 과정이나 유사도 점수를 계산하는 과정에는 text2vec-base-chinese PLM을 사용하였다.
Hyperparameters
LLM의 temperature가 높다면 사용자 질문의 의도와 맞지 않는 SQL query을 작성할 가능성이 높기 때문에 temperature는 0으로 고정하였다. (문법에 맞게 query을 작성해야 하기 때문에 굳이 생성물에 다양성을 부여할 필요는 없다)
Datasets
ACT-SQL의 성능을 평가하는 데이터셋
- Spider: 사람이 label한 cross domain text to SQL dataset이며 138개의 domain에 대한 200개의 DB를 기반으로 한다.
In context learning 실험을 하는 데이터셋
-
Spider-Syn: DB의 스키마와 관련있는 질문에 있는 token들의 일부를 유의어로 대체시킨 Spider dataset이다. 이는 모델이 사용자의 질문과 관련성이 높은 데이터셋 item들을 단순한 string-matching 알고리즘으로 찾아내는 것이라 사용자의 의도를 진짜 이해하는지를 평가할 수 있다.
-
Spider-DK: 도메인 지식을 사용하지 않으면 이해하기 어려운 질문들을 추가하였다. 학습 데이터셋에는 나오지 않는 도메인에 대한 내용을 물어봐서 모델의 일반화 능력을 평가할 수 있다.
-
Spider-Realistic: Column의 직접적인 언급을 다 제거하여 모델이 text와 table을 의미를 파악하여 잘 연결하는지 평가할 수 있다.
Multi-turn text to SQL 평가 데이터셋
-
SParC: 꼬리를 무는 질문의 흐름으로 이루어진 데이터셋이다.
-
CoSQL: 일반적인 사람이 데이터베이스에 대해 묻는 질문과 전문가가 SQL을 통해 질문에 대한 답을 하는 대화로 구성된 데이터셋이다.
Evaluation metrics
text to SQL 성능을 평가(생성한 query와 정답 query 비교 방법) 하기 위해서는 세 가지 지표를 사용한다.
- Exact Match (EM): 생성 SQL와 정답 SQL의 1대1 일치율
- Execution Accuracy (EX): 생성 SQL의 실행 결과와 정답 SQL의 실행 결과 일치율
- Test-suite Accuracy (TS): EX와 비슷하게 실행 결과를 비교하지만 여러 DB 환경에서도 비교한다.
Multi-turn text to SQL에서는 두 가지 지표를 사용한다.
-
Question Match Accuracy (QM): 각 turn마다 모델이 생성한 SQL이 맞았는지 평가한다. Multi-turn이 총 3개의 질문으로 구성되었고 그 중 2번을 맞춘다면 QM 점수는 $\frac {2} {3}$이다.
-
Interaction Match Accuracy (IM): 하나의 turn을 하나의 test 단위로 보고 turn을 구성하는 모든 turn들에 대해 정답 SQL을 맞추면 1점, 하나라도 틀리면 0점이다.
Zero-shot Results
우선, DB 스키마 정보 전달 prompt에 몇 개의 실제 DB 내용 예시들을 추가해야 효과적인지 알아보았다.
Table(Column) 스키마 prompt을 기준으로 실제 DB 내용 예시들의 개수만 다르게 하면서 EM, EX, TS을 측정하였다.
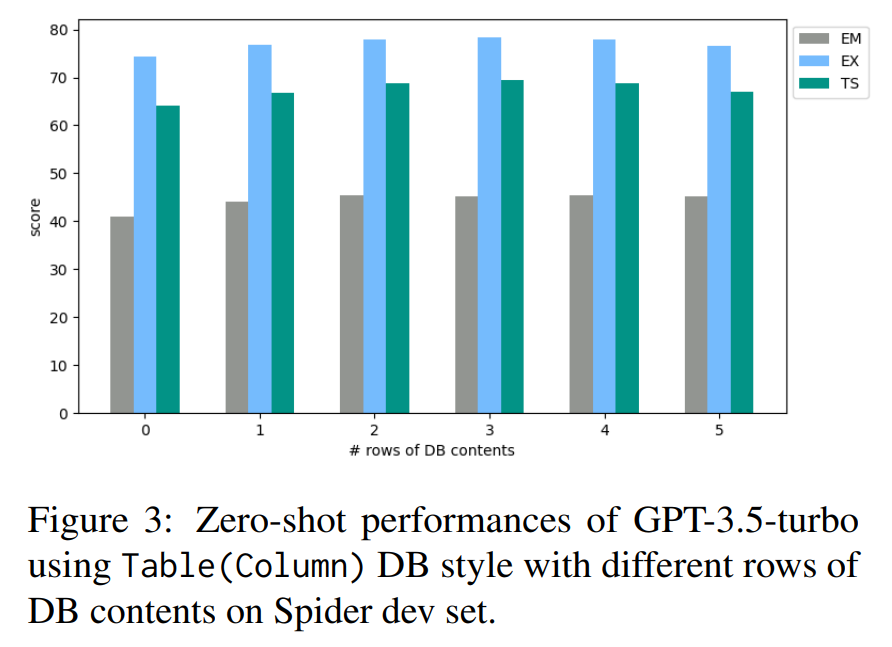
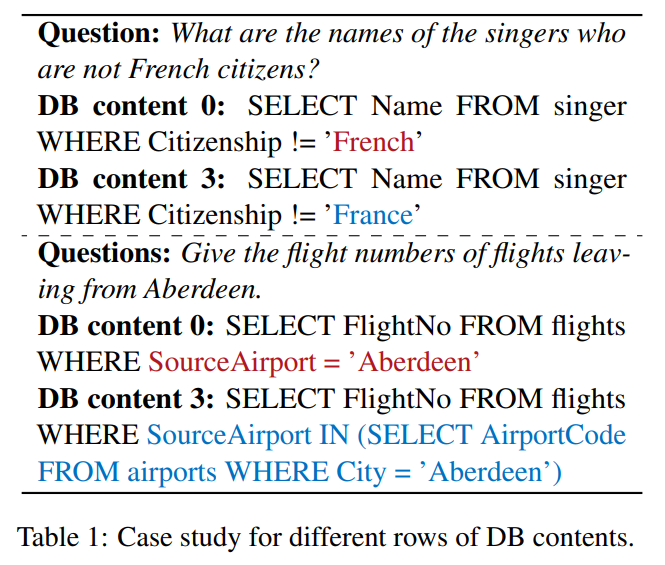
- 아무런 예시를 주지 않았을 때 (0)가 결과가 가장 안 좋았다. 이를 통해 실제 DB 내용을 추가하는 것이 DB 도메인이나 구조 이해에 도움을 준다는 것을 알 수 있다.
실제로, test case가 value 값에 예민할 때 도움이 된다. 예를 들어 질문이 “What are the names of the singers who are not French citizens” 일 때, DB 내용 예시가 없을 때는 SQL query “SELECT Name FROM singer WHERE Citizenship != ’French’“을 출력하는데 실제 DB는 Citizenship의 프랑스인 value 값을 ‘France’으로 하여서 틀리는 경우가 있었다.
- 예시 개수가 3개일 때 결과가 가장 좋았다.
다음으로 어떤 방법으로 DB 스키마 정보를 전달해야 효과적인지 알아보았다.
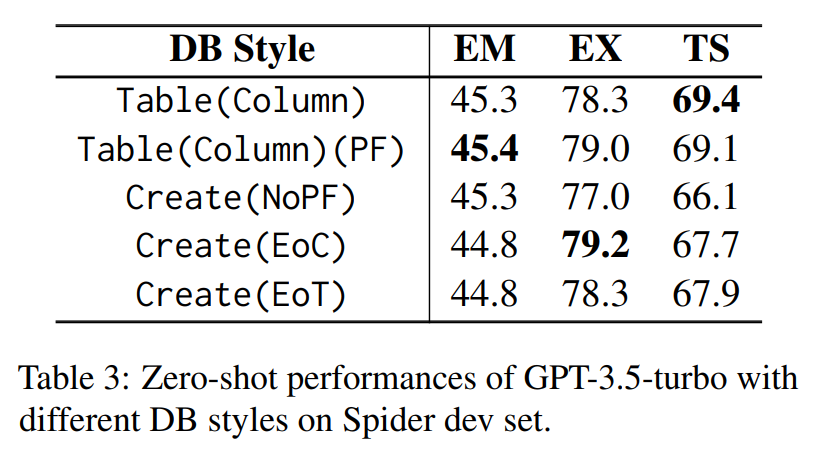
- Table(Column)과 Table(Column)(PF)가 zero-shot에서 가장 성능이 좋았다. 이는 ACT-SQL의 성능 평가를 할 때 GPT 모델을 사용하는데 이 두 prompt가 GPT가 공식적으로 제시한 prompt style과 일치하기 때문이다.
- 이에 더해 PF, 즉 Foreign key와 Primary key 정보가 주어졌을 때, EX와 TS 점수가 더 높아진다는 것을 볼 수 있다. $\rightarrow$ Table(Column)과 Table(Column)(PF)을 비교했을 때와, Create(EoC), Create(EoT), 그리고 Create(NoPF)을 비교했을 때 모두 PF 정보를 준 것이 점수가 더 높았다.
Few-shot Results
어떤 예시를 few shot prompt에 추가해야 하는지 알아내기 위해 Static과 dynamic exemplars의 개수들을 다르게 하여 Spider dev set으로 평가를 하였다.
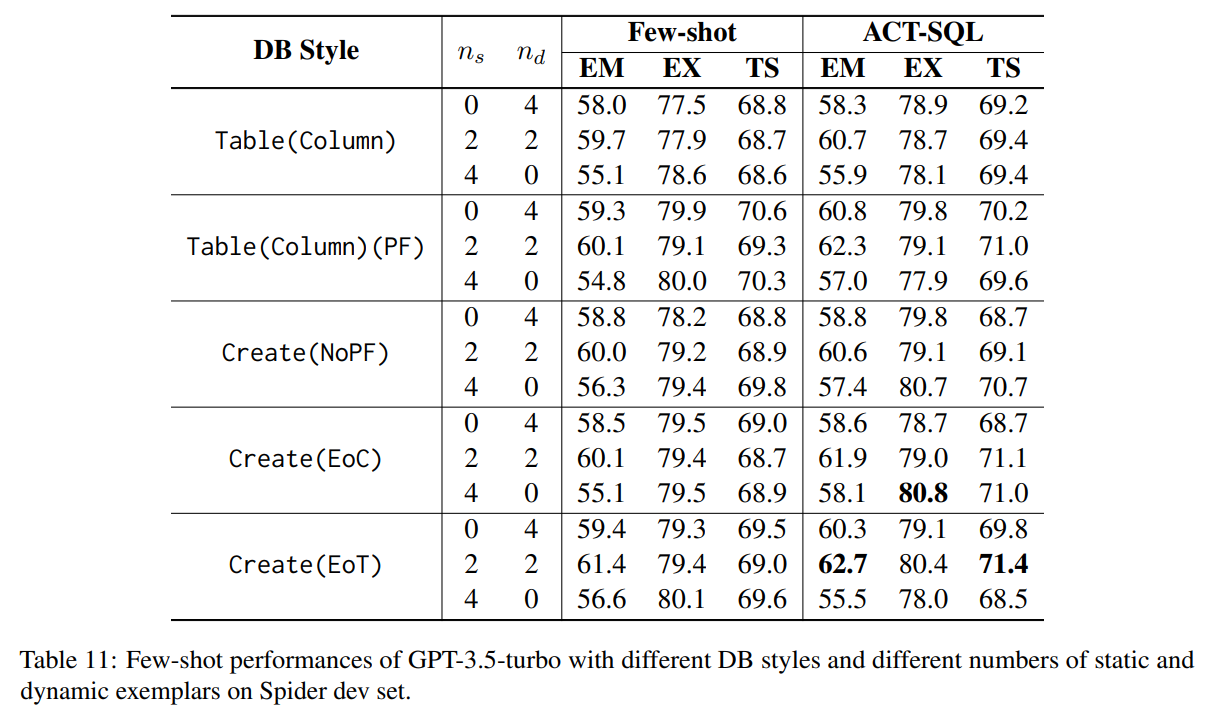
- 전체적인 EM 점수가 높아진 것을 관찰할 수 있는데 이는 exemplars을 통해 test case와 동일한 데이터셋 사용되는 SQL query들의 구조를 학습할 수 있기 때문이다.
- Few shot setting에서도 PF 정보를 전달하는 것이 더 우수한 효과를 보인다.
- Few shot setting은 in context learning을 하기 때문에 어떤 prompt가 월등히 우수한 경우는 없지만 대체적으로 Create(EoT)의 EM과 TS가 제일 우수하다. 또, 이 결과는 $n_s=2, n_d=2$일 때 나왔으므로 $n_s=2, n_d=2$이 최적의 setting임을 알 수 있다.
기존의 in context learning을 적용한 방법론들과 비교하였다. 이때, ACT-SQL은 성능이 제일 좋았던 Create(EoT) DB prompt, 그리고 $n_s=2, n_d=2$ setting으로 하였다.
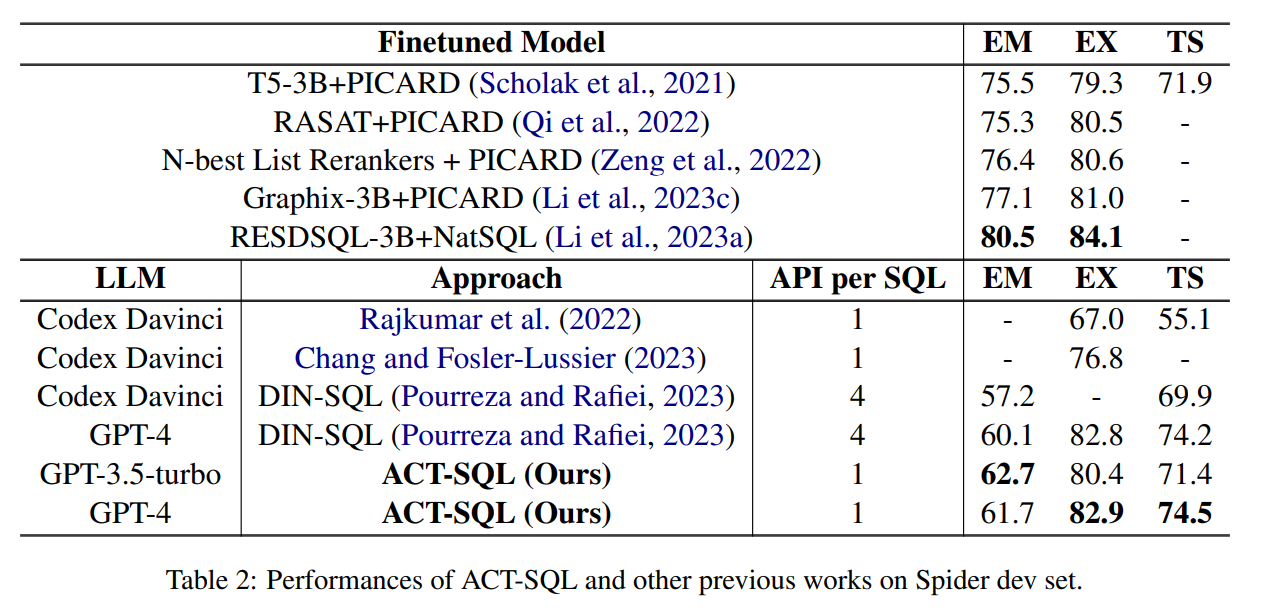
- ACT-SQL은 API 호출을 한번만 하면서도 EM, EX, TS에서 모두 SoTA 성능을 보인다.
In-Context learning vs Finetune
ACT-SQL은 fine-tuned 모델과도 맞먹는 성능을 보인다. 하지만 ACT-SQL은 더 general하게 성능이 좋다. 다음은 dev set와 test set에서 in context learning과 finetuned 모델들을 비교한 결과이다.
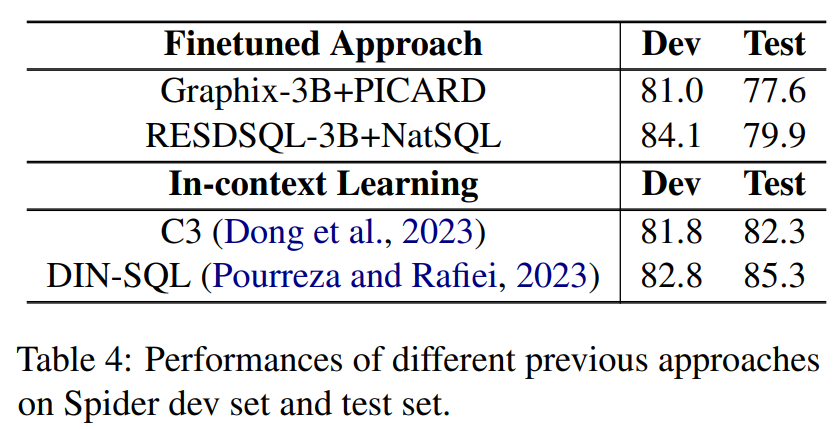
Finetuned model들은 dev set보다 test set에서 성능이 현저히 저하되는 현상이 관찰된다. 왜냐하면 finetuned model들은 보통 dev set에서의 성능을 기준으로 checkpoint가 선택되기 때문이다. 하지만, in context learning을 적용하는 방법들은 prompt 구성 방식과 dataset의 특징에 의존적이기 때문에 dev 와 test set 간의 성능 차이가 크지 않다. 이 결과를 통해 in-context learning을 적용한 방법론들의 장점을 볼 수 있다.
ACT-SQL과 finetune 모델들을 Spider-Syn, SpiderDK, 그리고 Spider-Realistic dev set에서도 비교해보았다.
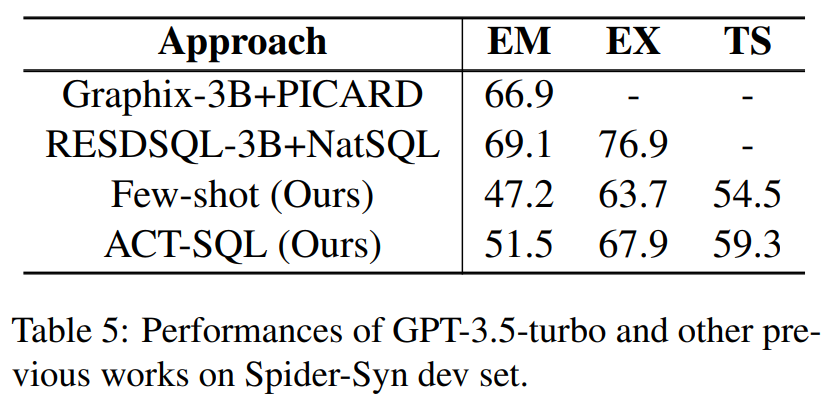
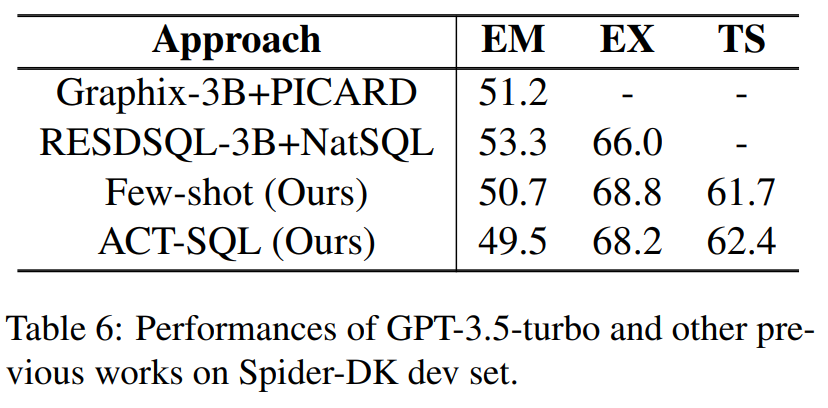
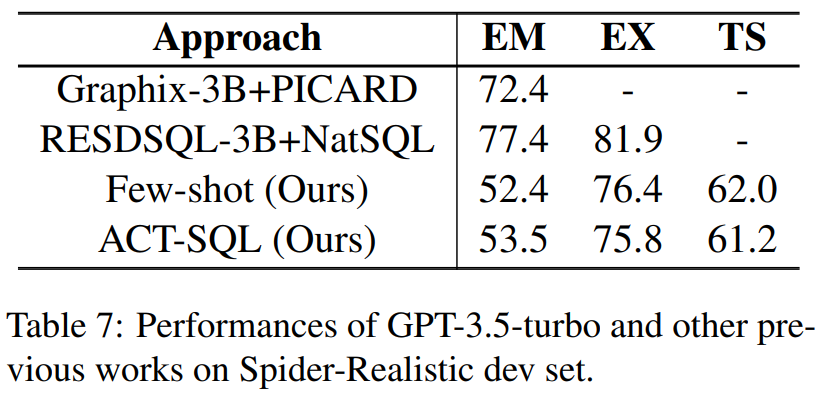
ACT-SQL과 finetune 모델의 EM, EX, TS 점수가 비슷하다는 것을 관찰할 수 있으며 Spider-DK에서는 EX 점수가 finetune 모델을 뛰어넘을 때도 있음을 볼 수 있다.
추가로, ACT-SQL은 CoT를 사용하여 일반적인 few shot prompting보다 더 우수한 정확성을 보인다.
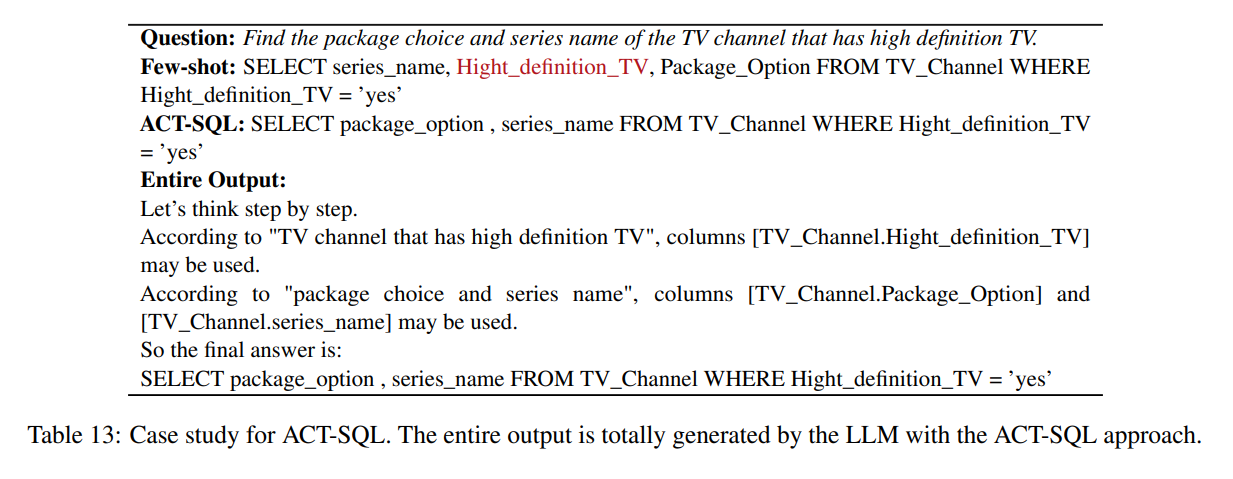
$\rightarrow$동일한 exemplars을 사용해도 일반적인 few shot prompting에서는 SELECT 문에서 불필요한 column까지 선택하지만 ACT-SQL은 그러지 않았다.
Multi-turn Datasets Results
Create(EoT) DB prompt, 그리고 $n_s=2, n_d=2$ setting으로 SParC와 CoSQL에서 multi turn text to SQL 성능을 평가하였다.
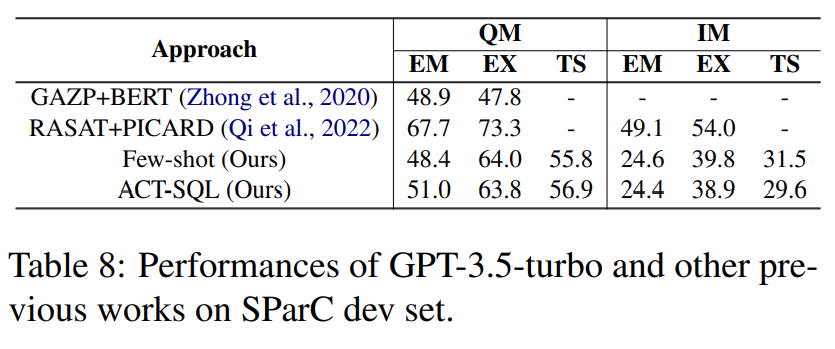
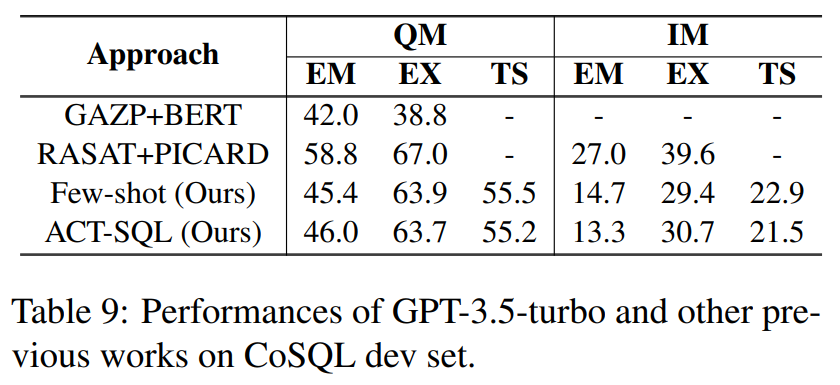
- 실험 결과 ACT-SQL은 Multi-turn에는 좋지 않은 성능을 보였다. LLM으로 이전 context까지 고려하여 재작성을 하는 과정에 오류가 생기는 현상이 빈번하게 발생하였다.
오류 예시는 다음과 같다.