M3-Embedding Multi-Linguality, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation 리뷰
Background
Embedding 모델은 text의 데이터를 latent space에 mapping하여 output embedding으로 표현시키는 역할을 한다. Text embedding은 Information retrieval (IR) system의 필수적인 요소인데 embedding의 quality에 따라서 IR system의 성능이 달라진다.
IR의 가장 흔한 형태는 dense retrieval, multi-vector retrieval, 그리고 lexical retrieval이 있다.
- Dense retrieval: Query embedding과 유사도가 제일 높은 document를 가져오는 것
- Multi-Vector retrieval: Query와 document를 각각 여러 embedding vector로 표현하여 query와 유사도가 가장 높은 document를 가져오는 것
- Lexical Retrieval: Query와 document를 구성하는 단어들의 중요도를 estimate하여 구한 embedding을 바탕으로 retrieval 하는 것
이때, 기존의 text embedding 방법들은 여러 문제점이 있다.
1) 표현할 수 있는 언어가 한정적
2) Embedding model은 하나의 retrieval functionality에 최적화되도록 학습됨. 하지만 실제 IR system은 여러 retrieval functionalities를 복합적으로 사용한다.
3) Embedding model들은 긴 input을 처리하지 못하기 때문에 long document retreiver를 학습하는데 어려움이 있다.
M3-Embedding
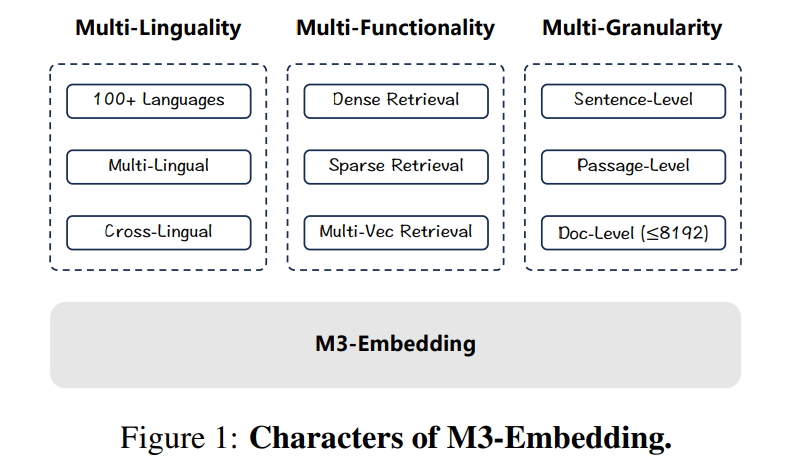
본 논문은 기존 text embedding 문제점을 모두 해결하는 embedding 학습 방법을 제시한다. M3-embedding은 Multi-Linguality, Multi-Functionality, and Multi-Granularity에 다재다능하다.
Multi-Linguality
M3-embedding은 다양한 언어를 하나의 공통된 semantic space에서 학습하여 다양한 언어 간 (single, cross lingual) retrieval이 가능한다.
Multi-Functionality
하나의 retrieval functionality에 제한되어 있지 않고 dense, lexical, multi-vector retrieval 모두 가능하다.
Multi-Granularity
다양한 input 크기를 처리할 수 있으며 긴 document (8192 input tokens)까지 가능하다.
M3-embedding을 통해 임의의 언어 $x$로 된 query $q$가 있을 때, corpus $D$로부터 언어 $y$로 된 document $d$를 retrieve 할 수 있다.
\[D^y : d^y \leftarrow \text{fn}^{*} (q^x, D^y)\]이때, $\text{fn}$은 dense, lexical, multi-vector retrieval 중에 아무 retrieval 함수가 될 수 있다.*
Hybrid Retrieval
M3-embedding은 다양한 retrieval functionalities를 하나로 통합한다. 이때, M3-embedding은 BERT 기반 모델을 사용하기 때문에 dense retrieval을 위해서 [CLS] embedding을 사용하고 다른 functionalities을 위해서는 다른 token들의 embedding을 사용한다.
Formulation
Dense Retrieval
Encoder로부터 Input query/passage $q/p$의 hidden states를 $H_q, H_p$라고 할 때, [CLS] token만 추출하여 text의 representation을 구한다.
$e_q = norm(H_q\left [0 \right ])$
$e_p = norm(H_p\left [0 \right ])$
두 representation 간의 유사도 점수는 inner product을 통해 계산한다.
\[s_{\text{dense}} \leftarrow <e_p, e_q>\]Lexical Retrieval
Query/Passage의 각 term (토큰) t의 term weight를 다음과 같이 계산한다.
\[w_{q_t} \leftarrow \text{Relu} (W^T_{\text{lex}} H_q \left [ i \right ])\]이때, $W_{\text{lex}} \in R^{\text{dx1}}$는 hidden state을 실수로 mapping하는 matrix이다. Term t가 query/Passage에서 여러 번 나타난다면, 최대 weight로 최종 weight를 결정한다.
모든 term들의 estimation term weight들을 계산하였다면, query와 passage 모두에 존재하는 term weight들의 곱들의 합을 계산한다.
\[s_{\text{lex}} \leftarrow \sum_{t \in q \cap p } (w_{q_t} * w_{p_{t}})\]Multi-Vector Retrieval
Dense retrieval과 다르게 query와 passage의 전체 embedding을 사용하는 방법이다.
$E_q = \text{norm}(W^T_{\text{mul}} H_q)$
$E_p = \text{norm}(W^T_{\text{mul}} H_p)$
이때 $W_{\text{mul}} \in R^{d \times d}$은 학습이 가능한 투영 matrix이다.
\[s_{mul} \leftarrow \frac{1}{N} \sum_{i=1}^{N} \max_{j=1}^{M} (E_q[i] \cdot E_p^T[j])\]ColBert의 late interaction 방법론에 따라 Cross encoder처럼 query와 passage을 같이 encoding하는 것이 아니라 따로 encoding을 한 뒤, 각 token의 output embedding들끼리 relevance score을 계산하여 text pair의 전체적인 relevance score을 계산하였다.
이때, N과 M은 query와 passage의 길이이다.
M3 embedding은 다양한 retrieval functionalities를 지원하기 때문에, retrieval 과정을 hybrid 하게 설정할 수 있다. 우선 각 retrieval functionality로 각자 retrieve한 결과들에서 multi-vector retrieval의 relevance score까지 포함된 integrated relevance score을 바탕으로 re-ranking을 하였다.
\[s_{\text{rank}} \leftarrow w_1 \cdot s_{\text{dense}} + w_2 \cdot s_{\text{lex}} + w_3 \cdot s_{\text{mul}}\]M3-Embedding 학습
이런 M3-embedding을 학습하기 위해서 본 논문은 self knowledge distillation, 새로운 batching strategy, 그리고 추가적인 data curation 작업을 수행한다.
Data Curation
M3-embedding은 크고 다양한 언어 dataset이 요구된다. 이때, 모으는 data 종류는 unsupervised data from unlabeled corpora, fine-tuning data from labeled corpora, 그리고 합성을 통한 fine-tuning data이다. 세 dataset 모두 서로 다른 성격을 지니고 있고 서로 다른 training stage에 사용된다.
Unsupervised data
구조화가 잘 되어 있는 데이터인 Wikipedia, S2ORC, CC-News, xP3, mC4, MTP에서 unsupervised data를 추출하였다. 또, 다양한 언어를 하나의 semantic space로 학습하기 위해서 parallel 문장들을 번역 데이터셋 NLLB, CCMatric으로부터 추출하였다.
이 과정을 통해 194개의 언어로 구성된 1.2 billion text pairs dataset을 구축하였다.
Fine-tuning data
Fine-tuning을 위해서 Labeled corpora로부터 작지만 다양한 data를 추출하였다. 영어 data로는 Hotpot QA, TriviaQA, NQ, COLIEE, PubMedQA, SQuAD, NLI, 중국어 data로는 DuReader, mMARCO-ZH, T2 -Ranking, LawGPT, CMedQAv2, NLI-zh, LeCaRDv2을 사용하였다. 다른 언어로 된 data들은 Mr.Tydi와 MIRACL dataset을 사용하였다.
Long document retrieval task를 학습시키기 위한 dataset이 부족하기 때문에 합성 dataset을 사용한다. Wikipedia, Wudao, mC4 dataset에서 긴 article들에서 임의의 문단들을 추출하여 LLM에게 각 문단에 어울리는 질문을 생성하도록 하였다. 이 방법을 통해 text pair dataset을 구축하였다.
Self-Knowledge Distillation
Embedding model 학습에는 contrastive learning을 적용하여 negative sample들로부터 positive sample을 잘 구별하도록 하였다.
\[L_{s(\cdot)} = - \log \frac {exp(s(q, p^{*})) / r} {\sum_{p \in \{p^*, P'\}} \exp ( \frac{s(q, p)}{\tau})}\]$p^{*}$와 $P’$는 각각 positive과 negative sample이고 $s(\cdot)$은 아무 retrieval function {$s_{\text{dense}}, s_{\text{lex}}, s_{\text{mul}}$} 이 될 수 있다.
이때, 고려할 것은 다양한 retrieval 방법들의 training objective들이 서로 대립될 수 있다는 것이다. 따라서, 모든 retrieval 방법들의 학습 과정을 self-knowledge distillation으로 통일시켰다. Self-knowledge distillation은 ensemble learning처럼 다양한 retrieval 방법들의 prediction들을 하나로 합하여 하나의 학습 signal로 만드는 과정이다. 하나로 합치는 방법 중 가장 간단한 것은 weighted sum을 사용하는 것이다.
\[s_{\text{inter}} \leftarrow w_1 \cdot s_{\text{dense}} + w_2 \cdot s_{\text{lex}} + w_3 \cdot s_{\text{mul}}\]이 weighted sum은 ensemble learning 관점으로 보았을 때, 하나의 retrieval 방법에서 도출한 relevance 점수보다 더 신뢰성이 높은 점수이기에 이 값을 teacher의 prediction이라고 간주하고 knowledge distillation을 할 수 있다. 따라서 각 retrieval 방법의 loss function을 다음과 같이 정의할 수 있다.
\[L'_{*} \leftarrow -p(s_{\text{inter}}) * \log p(s_{*})\]$p(\cdot)$은 softmax activation이며 $s_{*}$는 $s_{\text{dense}}, s_{\text{lex}},s_{\text{mul}}$ 중 하나다.
Teacher prediction 분포인 $p(s_{\text{inter}})$과 최대한 유사하게 되도록 loss function을 정의하였다.
이를 바탕으로 한 self-knowledge distillation 기반 loss function은 다음과 같다.
\[L' = ( \lambda_1 \cdot L'_{\text{dense}} + \lambda_2 \cdot L'_{\text{lex}} + \lambda_3 \cdot L'_{\text{mul}})\]정리하면
\[L' \leftarrow -p(s_{\text{inter}}) \cdot (\lambda_1\cdot \log p(s_{\text{dense}}) + \lambda_2\cdot \log p(s_{\text{lex}}) \lambda_3\cdot \log p(s_{\text{mul}}))\]즉, retrieval 방법들이 전체적으로 teacher의 prediction 분포와 유사하게 되도록 loss function을 설계하였다.
최종 loss function은 InfoNCE loss $L$과 self-knowledge distillation 기반 loss $L’$의 선형 조합이다.
\[L_{\text{final}} \leftarrow (L + L') / 2\]이때, $L \leftarrow ( \frac {\lambda_1 \cdot L_{\text{dense}} + \lambda_2 \cdot L_{\text{lex}} + \lambda_3 \cdot L_{\text{mul}} + L_{\text{inter}}} {4})$이다.
학습 과정은 multi-stage으로 구성하였다.
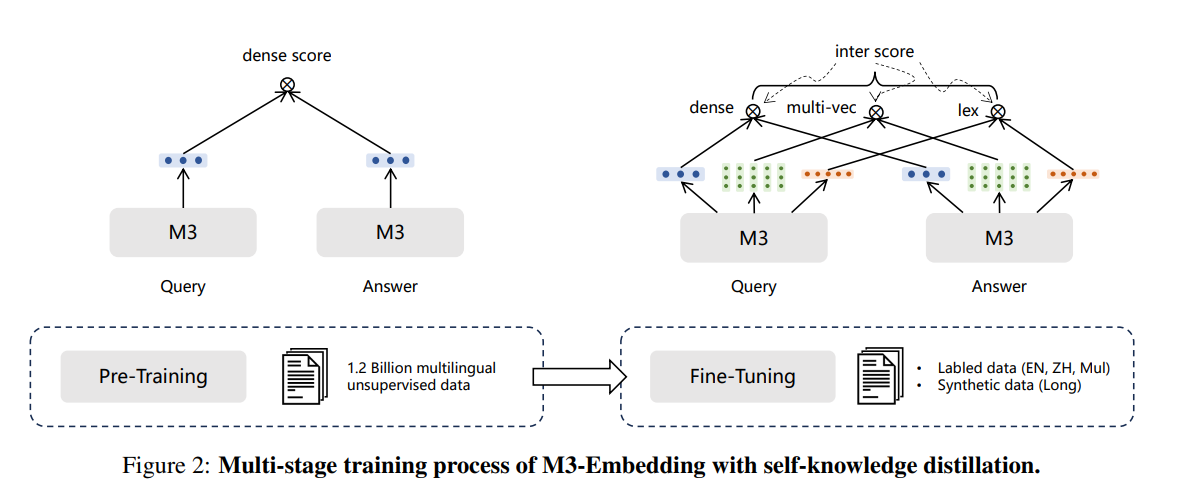
첫 stage에서는 우선 text encoder XLM-RoBERTa를 RetroMAE로 adapt시켰고 unsupervised data로 pre-train하였다. 이때, dense retrieval만 contrastive learning으로 학습되었다.
두 번째 stage에서 self-knowledge distillation을 적용하였다. 이 과정에서 Embedding model은 세 가지의 retrieval functionality 모두 잘 하도록 fine-tune되었다. Fine-tune에 사용된 데이터는 labeled와 synthetic data로 hard negatives는 ANCE method을 통해 구해졌다.
보통 contrastive learning을 위한 negative samples은 in-batch negative나 BM25 negative을 사용한다. 하지만, fine-tuning 과정 후반부에는 이런 negative들은 너무 쉬워져 학습 효과가 떨어진다. 따라서, ANCE는 현재 모델이 제일 헷갈려 할 만한 negative example들을 얻어서 hard negative sample을 구성하는 방법이다.
Efficient Batching
Embedding model이 다양한 언어의 general한 의미를 완전히 학습하기 위해서는 다양하면서 많은 multi-lingual data가 필요하다. 또, pre-train 과정에는 in-batch negative으로 negative samples을 구성하기 대문에 batch size을 최대한 키워야 한다.
Batch size을 키울수록 더 많은 negative samples을 가지고 학습할 수 있다. 또, negative samples가 많아질수록 더 큰 negative pool에서 positive sample을 판별하는 능력이 강해진다.
하지만, batch을 크게 하면서 모든 text를 GPU에 load하면 메모리 부족과 computational cost가 높아지는 문제가 존재한다. 따라서, 보통 input data의 길이를 truncate하여 문제를 해결하였다. 하지만 M3-embedding의 목표는 다양한 길이의 input (multi-granularity)도 처리할 수 있도록 하는 것이기에 이런 방법을 적용하면 긴 document들을 처리할 수 없게 된다.
따라서 본 논문은 batching 방법을 최적화하여 input 길이를 줄이지 않고서도 batch size을 크게 유지할 수 있게 하였다.
#1 우선, batch 내에 다양한 길이의 data들이 존재한다면, 짧은 data들을 가장 긴 data의 길이에 맞추기 위해서 padding을 수행해야 한다. 하지만 padding을 수행하게 된다면 padding한만큼 GPU에 loading 해야 하며 계산량이 늘어난다.
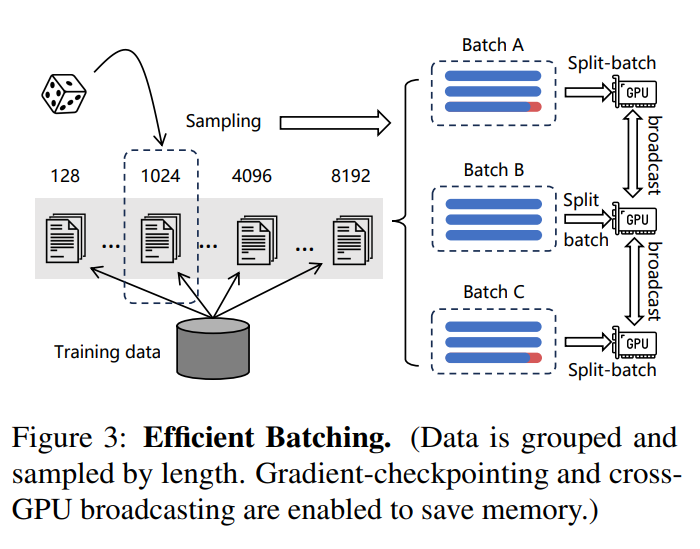
$\rightarrow$ 이를 해결하기 위해 길이 별로 데이터들을 grouping하여 비슷한 길이를 가진 데이터들끼리 batch를 구성하도록 하였다. 이 방법으로 padding의 빈도를 줄였다.
#2
여러 GPU를 통해 학습을 할 때, 각 GPU가 계산하는 data의 길이가 다르다면, 짧은 data를 받은 GPU는 긴 data를 받은 GPU의 계산이 끝날 때까지 기다려야 한다. $\rightarrow$ 이런 GPU 낭비를 방지하기 위해 모든 GPU가 data를 sampling 할 때 동일한 random seed를 사용하게 하여 모든 GPU가 비슷한 길이의 data를 처리하도록 하였다. 이를 load balancing이라고 한다.
#3
큰 size의 batch를 GPU에 한번에 올린다면, 메모리 초과 문제를 겪을 수 있다. 또, batch가 크다면 그만큼 각 data에서의 gradient를 다 저장해야 하고 back propagation을 해야 해서 메모리 부족 문제를 겪을 수 있다.
$\rightarrow$ 큰 size의 batch를 효율적으로 처리하기 위해서 batch들을 sub-batch로 나누었고 gradient checkpointing을 사용하여 checkpoint에 도달할 때만 gradient을 저장하였다. 이를 통해 batch size를 기존보다 20배 이상 키울 수 있게 되었다.
#4
여러 GPU로 학습을 할 때, GPU가 data를 볼 때마다 embedding을 계산하게 된다면, 그 data의 embedding이 이미 다른 GPU로 계산되었어도 다시 계산하게 되어 computation cost가 낭비된다.
$\rightarrow$ 이를 해결하기 위해 이미 계산된 embedding vector 값들은 공유할 수 있게 하여 학습 효율을 높였다.
Experiment
M3 embedding의 multi-lingual retrieval, cross-lingual retrieval, 그리고 long doc retrieval 성능을 평가하였다.
Multi-lingual Retrieval
Multi-lingual retrieval은 MIRACL benchmark으로 평가하였다. MIRACL은 총 18개의 언어로 구성되어 있으며 query와 passage가 동일한 언어로 되어있다.
평가 지표는 nDCG@10을 사용하였다. nDCG는 정답을 얼마나 상위권에 배치하였는지를 측정한다.
Dense와 sparse method는 passage corpus의 embedding을 계산한 뒤, top 1000개의 passage들을 retrieve하였다. 반면, Multi-vec method는 computational cost가 높기 때문에 dense method의 top-200개의 passage들을 re-rank하도록 하였다.
Hybrid retrieval method 성능 평가를 위해서 dense+sparse는 $w_1=1, w_2=0.3, w_3=0$을 사용하였고 All는 $w_1=1, w_2=0.3, w_3=1$으ㅡㄹ 사용하였다. Re-rank는 $s_{\text{rank}} \leftarrow w_1 \cdot s_{\text{dense}} + w_2 \cdot s_{\text{lex}} + w_3 \cdot s_{\text{mul}}$ 을 기반으로 하였다.
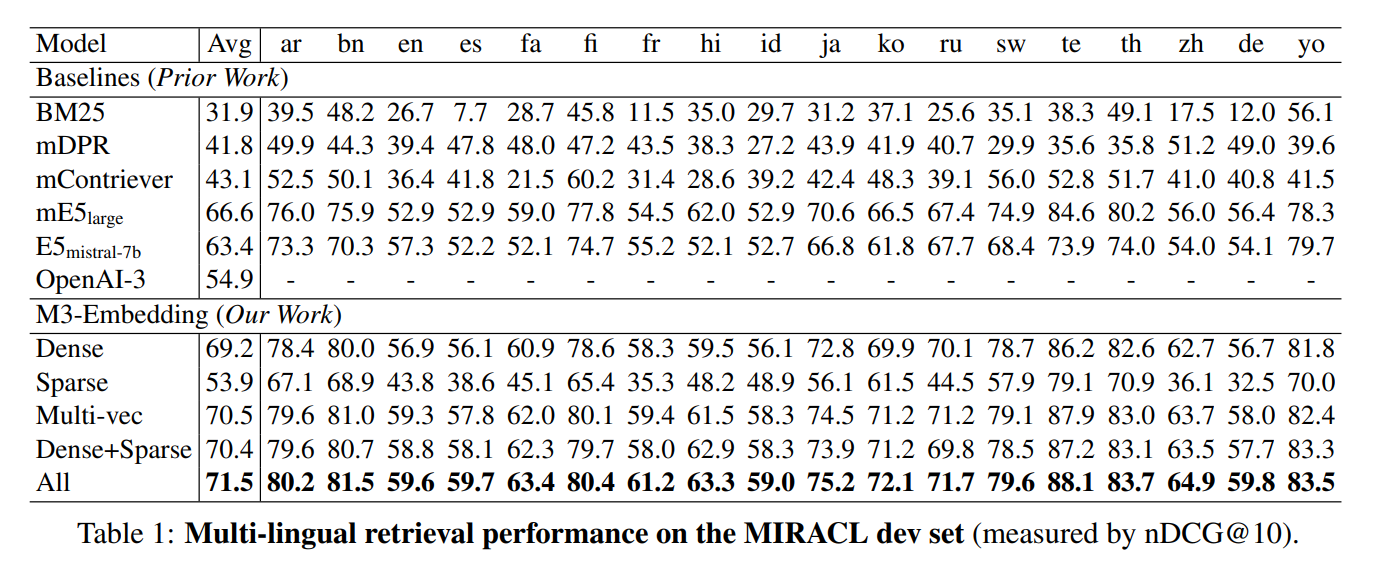
- M3-embedding이 dense method으로만 사용되었음에도 불구하고 평균 점수가 모든 baseline을 능가하며 대부분의 언어에서 일관되게 성능이 좋다.
- $\text{E5}_{\text{mistral 7b}}$는 더 큰 text encoder를 사용하고 영어에만 집중함에도 불구하고 M3-embedding은 영어에 비슷한 성능을 보이면서도 다른 언어들에서는 월등히 능가한다.
- Sparse method으로 사용되었을 때도 BM25을 능가한다.
- Multi-vector retrieval method을 적용했을 때도 우수한 성능을 보인다는 것을 통해 M3의 multi-functionality을 엿볼 수 있다.
- Hybrid retrieval method에 적용했을 대 성능이 더 향상된다는 것 또한 관찰할 수 있다.
Cross-Lingual Retrieval
Cross-lingual retrieval 평가는 MKQA benchmark으로 한다. 이 benchmark는 query가 영어가 아닌 25개의 언어로 되어있고 passage들은 영어로 된 wikipedia corpus이다.
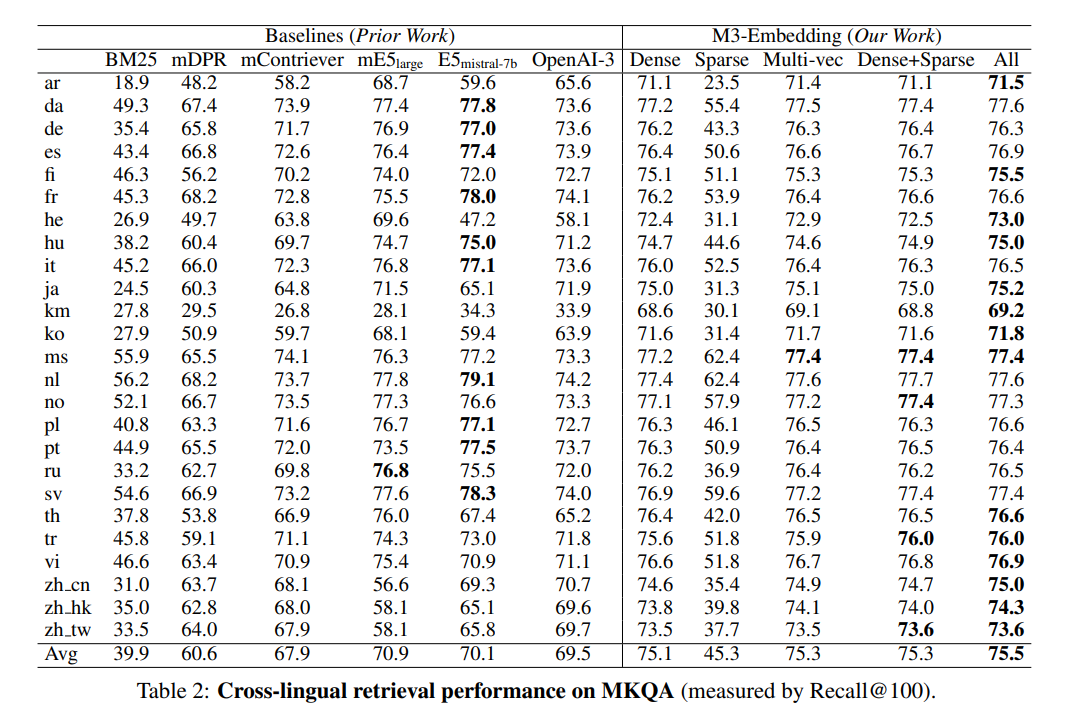
- M3 embedding으로 dense retrieval만 하더라도 baseline보다 성능이 우수하다.
- Hybrid retrieval을 적용했을 때 여전히 좋은 성능을 보인다.
이때, Multi-lingual retrieval처럼 성능 폭이 크지 않다는 것을 관찰할 수 있다. 예를 들어, $\text{E5}_{\text{mistral 7b}}$는 MKQA에서 일부 언어에서 더 좋은 성능을 보여준다. 하지만, baseline들은 언어에 따라 성능이 들쭉날쭉한 반면에 M3-embedding은 언어와 상관없이 일관된 성능을 보여준다는 점에서 차별점을 갖는다.
Multilingual Long-Doc Retrieval
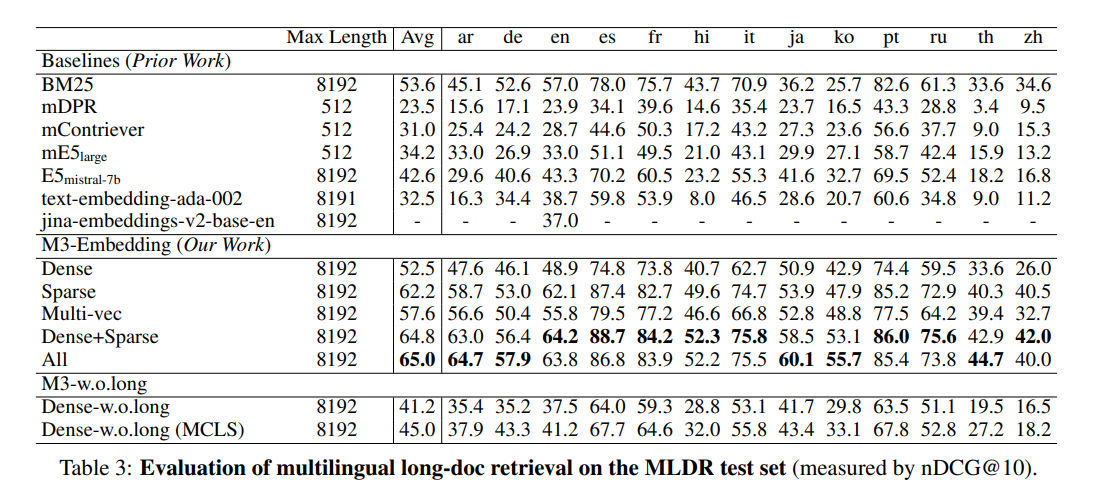
더 긴 document retrieval에서도 성능을 평가하기 위해 MLDR (Multilingual Long-Doc Retrieval) benchmark을 사용하였다.
Hybrid retrieval method에서 Dense+Sparse method은 $w_1=0.2, w_2=0.8, w_3=0$을 사용하고 All에서는 $w_1=0.15, w_2=0.5, w_3=0.35$을 사용하였다.
-
실험 결과, 이 benchmark에서도 dense retrieval에 적용한 것만으로도 기존 baseline들을 모두 능가한다.
-
신기하게도 M3 sparse는 dense보다 긴 document retrieval에 더 효과적이라는 것을 관찰할 수 있다.
-
또, multi-vector retrieval 방법에 적용했을 때 점수가 dense보다 5.1 point만큼 향상되었다.
M3-embedding이 long document retrieval에 왜 우수한지에 대해 알아내기 위해 fine-tuning 단계에서 long document data를 제거하고 fine-tuning했다. 이 모델을 w.o long이라고 지칭한다.
이런 변경을 했음에도 불구하고 Dense-w.o long은 여전히 대부분의 baseline을 능가한다는 것을 통해 pre-training stage에서 다양한 unsupervised dataset을 사용한 덕분에 long document retrieval에서 성능이 좋다는 것을 유추할 수 있다.
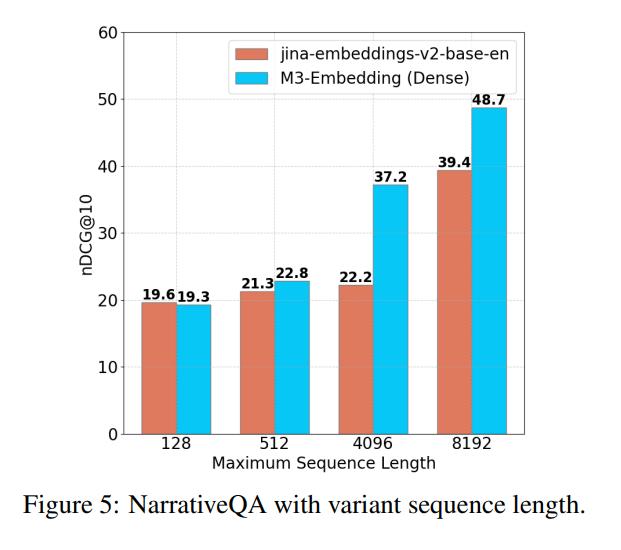
NarrativeQA benchmark에서도 일관된 결과를 보인다.
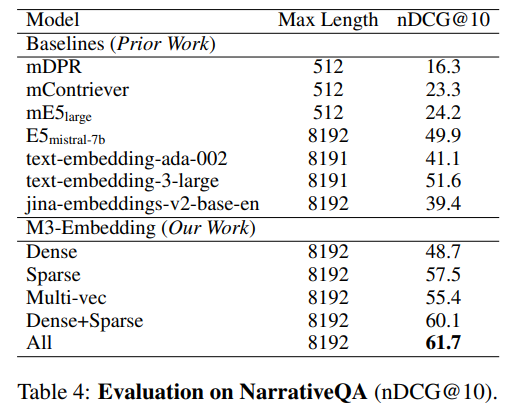
또, sequence 길이가 길수록 baseline에 비해 성능 향상 폭이 커진다는 것을 통해 M3-embedding이 long input들의 의미도 잘 capture할 수 있음을 알 수 있다.